 WEBサイト
Anthropicが、AI学習に使わせない意思を示す機械が読める信号の認識を始めた。ClaudeBotを名指しした規則はパスごとに優先される ── robots.txtの名指し行を数えて確かめる13項目(2026年11月時点)
Anthropicが、AI学習に使わせない意思を示す機械が読める信号の認識を始めた。ClaudeBotを名指しした規則はパスごとに優先される ── robots.txtの名指し行を数えて確かめる13項目(2026年11月時点)
目次
- 01 何が書かれたか — Anthropicは、AI学習に使わせない意思を伝える機械が読める信号の認識を、10月30日に始めたと書いた
- 02 なぜ・背景 — 事業者が読み始めたことと、標準になったことは、別である
- 03 用語 — 出てくる言葉を、先にそろえる
- 04 型別 — 適用範囲、この記事が確かめていないこと、確かめる手順
- 05 明日、担当サイトで確認できること
- 06 代替・他の選択肢 — 希望を伝える方法を、並べて比べる
- 07 当サイトで確かめたこと — 当サイトのrobots.txtに、Anthropicの名乗りを名指しした行は、今のところ無かった
- 08 このテーマは、ここまで — 「決める」から「読み始めた」へ、どう積み上げてきたか
- 09 この記事のまとめ
01 何が書かれたか — Anthropicは、AI学習に使わせない意思を伝える機械が読める信号の認識を、10月30日に始めたと書いた
引用について
この記事は、Anthropicのヘルプ記事「Does Anthropic crawl data from the web, and how can site owners block the crawler?」と、RFC 9309、Googleのrobots.txtの文書、IETFのAIPREF作業部会のページ、OpenAIのクローラーの概要を、2026年11月7日に開いて確かめた内容を書いている。英文を引くときは原文のまま引き、日本語訳を添える。それ以外は、筆者が日本語に直した要旨で書く。原文に書かれていない筆者の読みは「筆者の読み」と書いて分ける。05章のチェックリストは、筆者が整理したものである。
Anthropicのヘルプ記事には、2026年10月30日付の新しい段落が入っている。ページには「Updated this week」とだけ表示され、更新の日付そのものは書かれていない。段落の中の日付は10月30日である。書かれた内容は、AIの学習に自分のコンテンツを使ってよいかという希望を、サイトの運営者が機械で読める形で伝えられる信号を、Anthropicが認識し始めたというものである。
"As of October 30, 2026, Anthropic has begun recognizing a machine-readable signal"
(日本語訳: 2026年10月30日の時点で、Anthropicは機械が読める信号の認識を始めた。)
当サイトでは、同じ話題を2本の記事で扱っている。Googleが共通の書き方に対応する予定であることはGoogleは、robots.txtでAI学習を断る共通の書き方(__usage_ai-training)に2027年の初めに対応する予定で、仕様はまだドラフト ── 担当サイトのrobots.txtでAI学習に触れる行を数えて確かめる13項目(2026年11月時点)に、草案の状態の読み方はAI学習の信号をめぐる草案は、作業部会の草案が第08版、個人の草案が第00版で、どちらもまだ標準ではない。草案の状態は名前・種別・有効期限・置き換えの4か所で読める ── 話題になった草案をdatatrackerで確かめる13項目(2026年11月時点)に書いた。この記事で新しいのは、事業者が実際に読み始めたという1点と、そのとき名指しの規則がどう扱われるかである。
原文が書いた、名指しの規則と全体の設定の関係
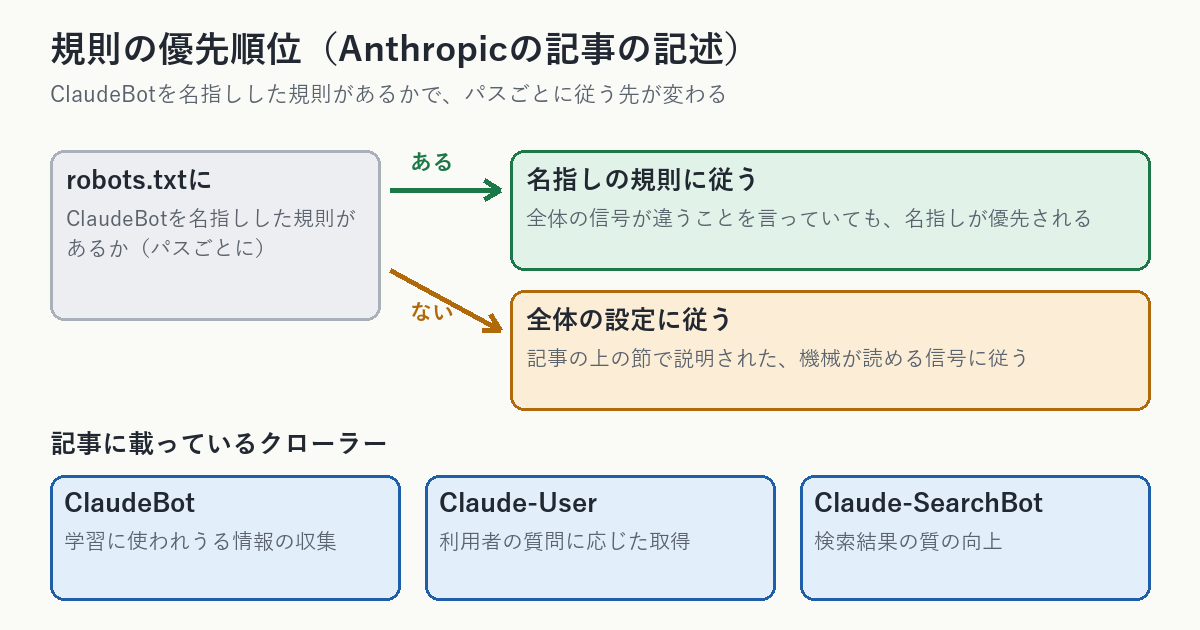
ヘルプ記事は、robots.txtにClaudeBotを名指しした規則があるときの扱いを書いている。原文は、ClaudeBotを名指しした規則を、全体の信号より特定のものとして扱う、と書く。原文の見出しは「How ClaudeBot rules take priority」で、「In practice, for a given path:」(日本語訳: 実際には、あるパスについては)と続く。つまり、パスごとに、ClaudeBotを名指しした規則があれば、Anthropicはその規則に従う。
"even if your general setting says something different"
(日本語訳: たとえ、全体の設定が違うことを言っていても。)
名指しの規則がなければ、全体の設定に従う、と記事は書く。原文は「we follow the general setting described above」(日本語訳: 上で説明した全体の設定に従う)と書き、別の文では「the general signal」(日本語訳: 全体の信号)とも書く。つまり、全体の設定は、記事の上の節で説明された、機械が読める信号を指すと読める。この読みは、原文の言葉づかいからの筆者の読みである。なお、この優先の規則はClaudeBotについてのもので、Claude-UserとClaude-SearchBotを名指しした場合の扱いは、記事に書かれていない。
原文が挙げたクローラー3つ
ヘルプ記事は、3つのクローラーを挙げている。名前と目的、無効にしたときの影響を、記事の文に沿って次の表に並べた。影響の欄は、記事の記述の範囲に限る。
| 名乗り | 目的(記事の記述) | 止めたときの影響(記事の記述) |
|---|---|---|
| ClaudeBot | 生成AIのモデルの有用性と安全性を高めるため、学習に役立ちうるウェブのコンテンツを集める | サイトがClaudeBotのアクセスを制限すると、そのサイトの今後の素材を、AIのモデルの学習データから除く意思を示すことになる |
| Claude-User | 利用者がClaudeに質問したときに、利用者のためにサイトへアクセスすることがある | 無効にすると、利用者の質問に応じてコンテンツを取得できなくなり、利用者が求めたウェブ検索での、サイトの見え方が下がるおそれがある |
| Claude-SearchBot | 利用者向けの検索結果の質を上げるため、ウェブを巡る | 無効にすると、検索の最適化のための索引づけができなくなり、検索結果での見え方と正確さが下がるおそれがある |
Claude-Agent(Anthropicが運営するブラウザ)は、この記事では別の記事に触れるだけで、説明されていない。
原文が、IETFの草案に従うと書いたこと
"The signal follows a draft based on work done by the IETF,"
(日本語訳: この信号は、IETFで行われた作業に基づく草案に従う。)
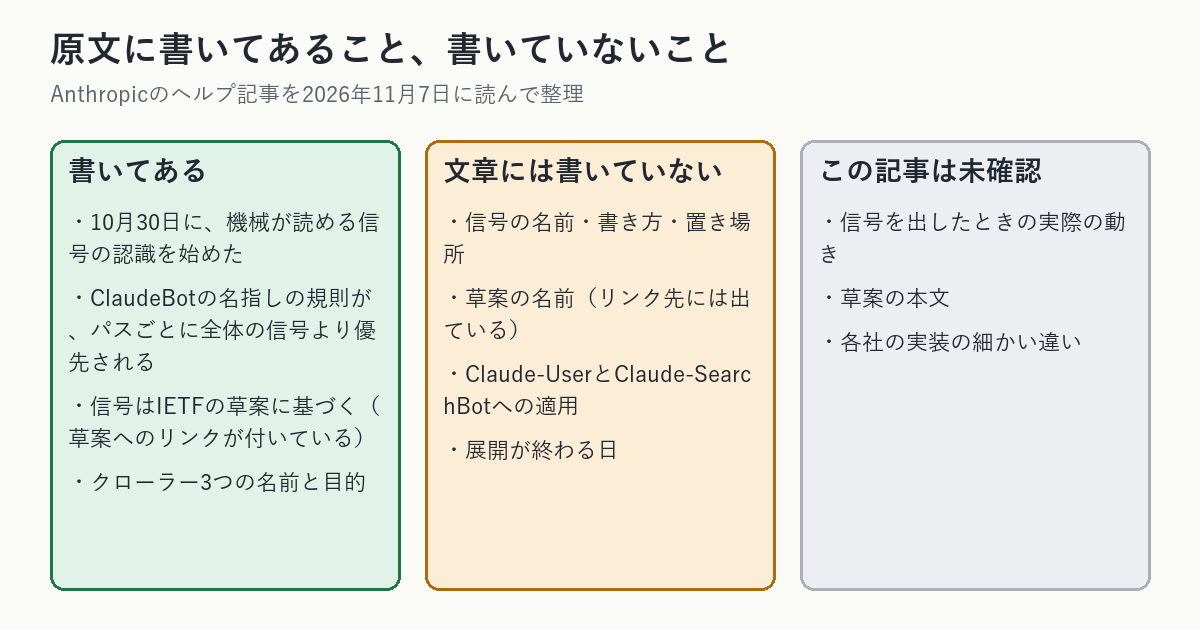
この引用の文の中の「a draft based on work done by the IETF」は、原文ではリンクになっていて、リンク先は、IETFのdatatrackerにある個人の草案「Machine-Readable Training Preference Signal」(draft-kelley-aipref-training-preference-signal)である。原文は、この草案を、IETFの「aipref working group」(日本語訳: aipref作業部会)での作業に基づくもの、と説明している。筆者が2026年11月7日にdatatrackerのページを開いて確かめたところ、最新は第00版で、2026年10月30日の日付があり、状態は「Active Internet-Draft」(個人の草案で、作業部会の草案ではない)、有効期限は2027年5月3日と表示されていた。記事の文章には、草案の名前は出てこない。草案へのリンクが付いている、という形である。記事はさらに、この分野の標準はまだ変わっているので、Anthropicがこれらの設定を読む方法や適用する方法も変わりうる、と書く。信号の構文や置き場所は、記事の文章の中には書かれていない。草案の本文は、この記事では開いていない。
原文に書かれていないこと
- 記事の文章の中の、信号の名前、書き方、置く場所、取りうる値(草案へのリンクは付いている)
- 草案の名前や版(文章には出ず、リンク先のdatatrackerで読める)
- Claude-UserとClaude-SearchBotに、信号が適用されるかどうか
- 世界の各サービスへの展開が、いつ終わるか
- 他社の対応の状況、草案が標準になる見込み
02 なぜ・背景 — 事業者が読み始めたことと、標準になったことは、別である
「読み始めた」は、標準になったという意味ではない
ヘルプ記事自身が、草案に従うと書き、標準が変わるので読み方も変わりうる、と書いている。つまり、読み始めたという事実は、決まった書き方に、すべての事業者が従う段階にはまだ来ていないことと両立する。これは筆者の読みである。ヘルプ記事がリンクした草案は個人の草案で、作業部会の草案ではない。別に、IETFのAIPREF作業部会のページには、作業の目標として「語彙」と「付ける仕組み」の2つの標準案を作ることが書かれ、2つの文書について、IESG(IETFの運営組織)へ提出する予定日が2026年8月31日と書かれていた。筆者が11月7日に開いた時点で、その日は過ぎている。作業部会の文書の一覧では、語彙の草案が第08版、付ける仕組みの草案が第05版で、どちらも「Active Internet-Draft」だった。RFCにはなっていない。
robots.txtの読み方の土台は、名乗りでグループを選ぶこと
robots.txtの規則は、「User-agent」の行で始まるグループに分かれている。RFC 9309は、クローラーが使うグループの選び方を、次のように書く。
"If no matching group exists, crawlers MUST obey the group with a user-agent line with the "*" value, if present."
(日本語訳: 合うグループが無ければ、クローラーは、「*」の値のUser-agent行を持つグループがあれば、それに従わなければならない。)
Googleの文書も、「Only one group is valid for a particular crawler.」(日本語訳: 特定のクローラーに有効なグループは、1つだけである。)と書く。「*」がAdsBotを除くすべてのクローラーに当たり、AdsBotは名指しが必要だという点は、別のページ「Create and Submit a robots.txt File」に、「Using an asterisk (*) matches all crawlers except the various AdsBot crawlers, which must be named explicitly.」(日本語訳: アスタリスク(*)は、AdsBotの各種クローラーを除くすべてのクローラーに当たり、AdsBotは名指しで書かなければならない。)と書かれている。
名指しのグループを足すと、「*」のグループは読まれなくなる
ここから、実務で大事なことが読める。RFC 9309の文は、名乗りに合うグループがあれば、「*」のグループを使うのは「合うグループが無いとき」だと書く。したがって、ClaudeBotを名指しした行を足すと、ClaudeBotにとっては、「*」のグループに書いた規則が読まれなくなる可能性がある。たとえば、「*」のグループに管理画面などのDisallowを書いていて、ClaudeBotのグループにAllowだけを書くと、管理画面のDisallowはClaudeBotには効かない、という形である。これはRFCの文からの筆者の読みで、各社の実装は確かめていない。名指しを足すときは、「*」にあるDisallowを、名指しのグループにも写すかを決める必要がある。
OpenAIも、目的別に名乗りを分けている
OpenAIのクローラーの概要も、目的ごとに名乗りを分けている。OAI-SearchBotは検索の回答のための索引づけ、GPTBotは基盤モデルの学習に使われうる情報の収集、ChatGPT-Userは利用者の依頼に応じたページの取得である。事業者が3つに分けて名乗りを出し、サイトの運営者がそれぞれを通すか止めるかを選ぶ形は、Anthropicの3つと同じ型になっている。名乗りを分けて書く考え方は、AIクローラーは1つではない ── robots.txt・llms.txtで「通す」「止める」を切り分ける(2026年9月時点)に書いた。
03 用語 — 出てくる言葉を、先にそろえる
用語: 機械が読める信号(machine-readable signal)
サイトの運営者が、コンテンツをAIの学習に使ってよいかという希望を、人ではなく機械が読める形で示すもの。Anthropicの記事の文章は、その形の名前や書き方を書いていない。IETFの草案へのリンクが付いている。
名指しの規則
robots.txtのUser-agent行に、クローラーの名前を書いて、その名前だけに向けた規則を書くこと。「*」ですべてのクローラーに向ける書き方と区別される。Anthropicの記事は、ClaudeBotを名指しした規則が、パスごとに、全体の信号より優先される、と書く。Claude-UserとClaude-SearchBotを名指しした場合の扱いは、記事に書かれていない。
ClaudeBot・Claude-User・Claude-SearchBot
Anthropicの記事に載る、3つの名乗りである。目的は、学習のためのウェブ収集、利用者の質問に応じた取得、検索結果の質の向上、と分かれている。記事は、Claude-Agent(Anthropicが運営するブラウザ)は別の記事で扱う、と触れるだけである。
グループ
robots.txtの中の、User-agentの行から次のUser-agentの行までのまとまり。クローラーは、自分の名乗りに合うグループを選び、そのグループの規則に従う。
04 型別 — 適用範囲、この記事が確かめていないこと、確かめる手順
適用範囲: robots.txtを持つ、すべての公開サイト
この記事の手順は、robots.txtを持つサイトなら、どのサイトにも当てはまる。ClaudeBotへの対応は、署名や特別な設定の仕組みがなくても、robots.txtを読むことから始められる。確かめる対象は、担当サイトのrobots.txtに、ClaudeBotを名指しした行があるか、Claude-UserとClaude-SearchBotを名指しした行が何本あるかである。ClaudeBotについては、名指しが無いサイトと、あるサイトで、パスごとの読まれ方が変わる。
この記事が確かめていないこと
この記事は、ヘルプ記事の文面を読んで整理したものである。信号を実際に出して、Anthropicのクローラーがどう動くかは、試していない。信号の書き方は、記事の文章に無く、この記事は草案の本文を読んでいないので、書かない。Claude-UserとClaude-SearchBotに信号が適用されるかも、確かめていない。草案の名前と版、状態は、datatrackerのページで確かめたが、本文は開いていない。
確かめる手順1: ヘルプ記事の段落と、3つの名乗りを書き写す
Anthropicのヘルプ記事を開き、10月30日の段落と、3つのクローラーの名前と目的を、自分のノートに書き写す。ページに更新の日付が出ないので、開いた日を一緒に書く。あとで読み直したときに、記事が変わったかを比べる手がかりになる。
確かめる手順2: 信号の書き方が、記事に書かれているかを確認する
記事の全文を上から下まで読み、信号の名前や書き方が書かれているかを確認する。2026年11月7日に読んだ時点では、記事の文章には書かれていなかった。書かれていないなら、「無い」と書く。記事には草案へのリンクが付いているので、書き方を知りたいときは、リンク先の草案を開く。書き方を、草案を読まずに推測して書かない。草案は変わるので、写した書き方は、すぐに古くなる。
確かめる手順3: 担当サイトのrobots.txtを、直接開く
担当サイトのrobots.txtを、ブラウザのアドレス欄に、サイトのトップのURLの後ろに「/robots.txt」を付けて開く。ステータスが200で表示されることを確かめる。表示されない場合は、robots.txtがエラーを返し続けると、最後は「制限なし」に行き着く ── HTTPステータス別の扱いを確認する13項目(2026年9月時点)の手順で、返しているステータスを確かめる。
確かめる手順4: 4つの数を数える
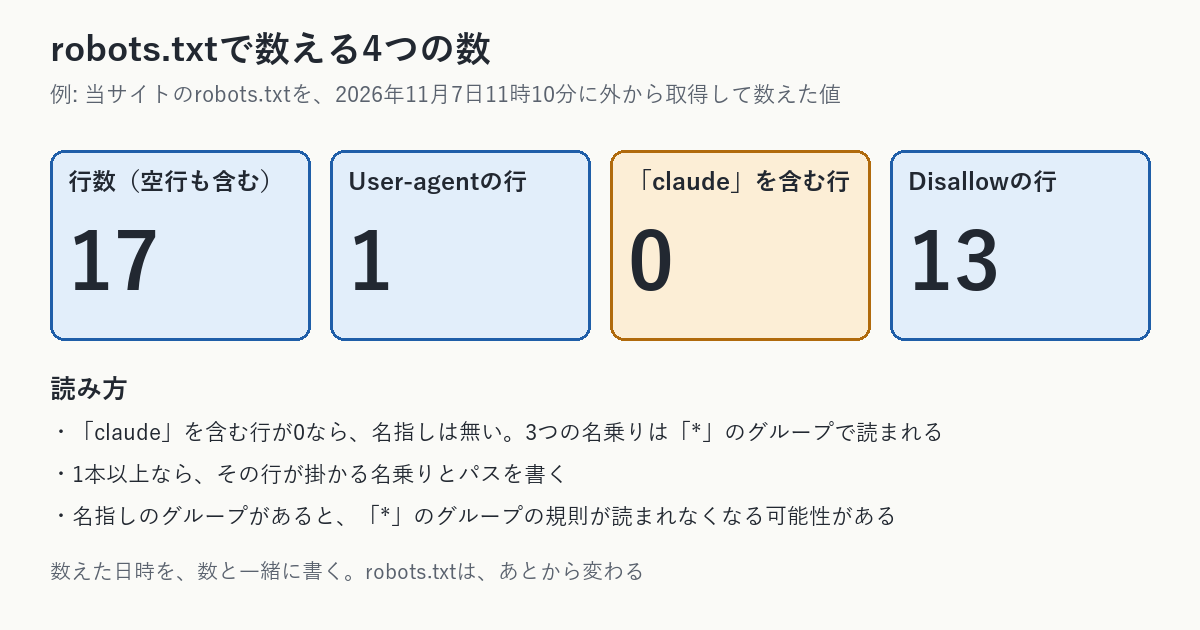
開いたrobots.txtで、次の4つを数える。全体の行数(空行も数える)、User-agentの行の数、「claude」を含む行の数、Disallowの行の数である。数える道具は、ブラウザの検索(Ctrl+F)で足りる。数えた日時を、数と一緒に書く。robots.txtは、あとから変わるからである。
確かめる手順5: 名指しの行があるかで、読み方を分ける
「claude」を含む行が0なら、Anthropicの3つの名乗りは、「*」のグループの規則で読まれる、と記録する。1本以上あるなら、その行が、どの名乗りの、どのパスに掛かっているかを書く。名指しの行がある場合は、前のセクションで書いたとおり、名指しのグループがあると、「*」のグループの規則が読まれなくなる可能性がある。なお、Anthropicの記事の「ClaudeBotを名指しした規則は、全体の信号より優先される」と、RFC 9309の「名乗りに合うグループがあれば、「*」のグループは使われない」は、別の話だと筆者は読む。前者は、名指しの規則と機械が読める信号のどちらに従うかの話で、後者は、robots.txtの中で、どのグループを使うかの話である。ただし、datatrackerの草案の概要には、「by writing ordinary robots.txt groups keyed by a per-purpose policy token in the User-Agent line」(日本語訳: User-agentの行にある、目的ごとの方針を示すトークンを鍵にした、ふつうのrobots.txtのグループを書くことで)とある。そのため、信号そのものも、robots.txtのグループで書く形かもしれない。これは筆者の読みで、草案の本文は開いていない。「*」にあって、名指しのグループにない規則を探し、差があれば書き出す。
実務のヒント
名指しの行を足すときは、「*」のグループのDisallowを、名指しのグループにも写すかを、足す前に決める。写し忘れると、管理画面などに向けたDisallowが、その名乗りには効かなくなる可能性がある。
確かめる手順6: 担当サイトの方針を、1行で書く
学習、検索、利用者の依頼に応じた取得の3つについて、担当サイトが通すか止めるかを、1行ずつ書く。決まっていなければ「未決」と書く。信号を出すかどうかは、方針が決まってから考える。方針が決まらないまま信号だけを出すと、意図と違う希望を伝えることになるおそれがある。ただし、信号を出した場合に何が起きるかは、原文に書かれていないので、この記事は断定しない。
書き方の例: ClaudeBotを名指しするグループを足す手順
ここからは、告知にある話ではなく、robots.txtの一般的な書き方による仮の例である。たとえば、ClaudeBotにだけ、特定のディレクトリを読ませたくない場合を考える。手順は、次の3つである。1つ目は、robots.txtの空いた場所に、User-agentの行を書いて、値にClaudeBotと書く。2つ目は、その下に、読ませたくないパスのDisallowの行を書く。3つ目は、「*」のグループにあるDisallowの行を、ClaudeBotのグループにも、同じだけ書き写す。3つ目を忘れると、「*」のグループに書いていた管理画面などのDisallowが、ClaudeBotには効かなくなる可能性がある。書いたあとは、手順4の4つの数を数え直し、日付と一緒に記録する。
05 明日、担当サイトで確認できること
以下は、担当サイトで、Anthropicの記事を読み、robots.txtを数えるための13項目である。1〜3番目は記事の読み取り、4〜9番目はrobots.txtの確認、10〜13番目は方針と、決めたことの残し方である。1項目は5分以内でできる。チェックの状態は、お使いのブラウザに保存され、サーバーには送られない。
- Anthropicのヘルプ記事を開き、「As of October 30, 2026」の段落を書き写す
- 同じ記事に載っているクローラー3つの名前と目的を、1行ずつ書く
- 記事の全文を読み、文章の中に信号の名前や書き方が書かれているかを確認し、無ければ「無い」と書いて、草案へのリンク先の名前を書き写す
- 担当サイトのrobots.txtを開き、ステータスが200で表示されることを確認する
- robots.txtの全体の行数を、空行も数えて書く
- User-agentの行の数を数えて書く
- 「claude」を含む行の数を数えて書く(大文字小文字は区別しない)
- Disallowの行の数を数えて書く
- 名指しの行が0なら「名指しは無く、*のグループで読まれる」と書き、1本以上なら、その行が掛かるパスを書く
- 名指しの行があるなら、「*」にあって名指しのグループに無いDisallowを探し、あれば書き出す
- 学習・検索・利用者の依頼に応じた取得の3つについて、担当サイトの方針を1行ずつ書く(決まっていなければ「未決」)
- IETFのAIPREF作業部会のページを開き、2つの文書の版と状態を、日付と一緒に書き写す
- 確認した日付と、次にヘルプ記事を開き直す日を決めて、方針の記録に書く
チェックが終わったら、4つの数と方針の1行を、担当サイトの記録に残す。数と日付を残しておくと、robots.txtを変えたとき、どこが変わったかが見える。ヘルプ記事は変わるので、次に開き直す日を決めておく。
06 代替・他の選択肢 — 希望を伝える方法を、並べて比べる
AIへの希望を伝える方法は、1つではない。それぞれの向き不向きを、次の表に整理した。比べ方は筆者の整理で、公式の分類ではない。
| 方法 | 向いている場面 | 注意 |
|---|---|---|
| robots.txtで名乗りを名指しする | 会社ごと、目的ごとに、通す・止めるを分けたい | 名指しのグループを足すと、「*」のグループが読まれなくなる可能性がある。写し忘れに注意 |
| robots.txtの「*」のグループだけで書く | すべてのクローラーに同じ規則でよい | AdsBotなど、「*」が当たらないクローラーがある(Googleの文書) |
| 機械が読める信号(草案に従うもの) | 学習への希望を、決まった書き方で伝えたい | 書き方は記事の文章に無く、草案へのリンクが付いている。草案は変わるので、確定してから決める |
| サーバー側で名乗りや接続元を見て止める | robots.txtを守らない相手に備えたい | 名乗りは自己申告なので、接続元でも確かめる。止めすぎると、本物のクローラーまで止める |
| 何も書かない | 通す方針で、特に伝えることがない | 方針が決まっていることと、書いていないことは別。方針を記録に残す |
当サイトの過去の記事で扱った、近い話題
名乗りだけで通す・止めるを決めない考え方は、Googlebotの名乗りは誰でも書ける。通す・止めるを名乗りだけで決めず、接続元で確かめる ── 自分のサイトの判定を点検する13項目(2026年10月時点)にある。確認済みのボットがrobots.txtを守るかを評価する考え方は、Cloudflareは確認済みボットを、名乗りが本物かに加えて、robots.txtと429を守り続けているかでも評価し続ける仕組みを書いた ── 自分のサイトのrobots.txtと429がボットに読める形かを確認する13項目(2026年10月時点)で扱った。llms.txtについては、llms.txtの仕様で必須なのは先頭の見出し1つだけ。Googleは検索で使わないと書き、3社のクローラーの説明ページには、クローラーがllms.txtを読むという記述が見つからなかった ── 置くかを決め、置いたあとにログで確かめる13項目(2026年10月時点)に書いた。
担当サイトの公開ページの状態をまとめて確かめる手段として、当サイトには🔧 【SEO/UX】WEBサイト総合分析・レポートツール — 公開ページの状態をまとめて診断するがある。アクセスログを読み込んで分析する手伝いには、🔧 【セキュリティ】IPA提供 攻撃兆候検出ツール iLogScanner で簡単ログ分析ツール ★iLogツカウン — 送ったアクセスログは結果の表示・ダウンロード後にすぐ削除される会員限定のツール(利用には無料の会員登録が必要です)がある。どちらも、robots.txtの行を数えるツールではないので、4つの数は、05章の手順で数える。
07 当サイトで確かめたこと — 当サイトのrobots.txtに、Anthropicの名乗りを名指しした行は、今のところ無かった
2026年11月7日に、外から取得して数えた
当サイトのrobots.txtを、2026年11月7日11時10分に外から取得して数えた。ステータスは200で、全体は17行だった。同じ内容を、同じ日の11時49分に取り直して数えたところ、17行のうち空行は1行だった。User-agentの行は1本で、値は「*」だった。「claude」を含む行は0行だった。Disallowの行は13行、Allowの行は1行だった。Anthropicの3つの名乗りを名指しした行は無いので、3つの名乗りは、「*」のグループの規則で読まれることになる。これは、RFC 9309の文からの筆者の読みである。
当サイトの方針は変えていない
当サイトは、検索・学習・エージェントの3つを通す方針で、robots.txtも、この記事のために変えていない。信号も、出していない。方針を決めた経緯は、Cloudflareが9月15日に加えた「AI学習だけを止める」設定 ── 検索に載せたまま止められる範囲と、今週確かめる6つの末尾に書いてある。方針が「通す」なので、名指しの行を足す理由は今のところない。Anthropicの記事が変わったら、この記事に日付つきで追記する。
08 このテーマは、ここまで — 「決める」から「読み始めた」へ、どう積み上げてきたか
これまでの記事
- Googleは、robots.txtでAI学習を断る共通の書き方(__usage_ai-training)に2027年の初めに対応する予定で、仕様はまだドラフト ── 担当サイトのrobots.txtでAI学習に触れる行を数えて確かめる13項目(2026年11月時点) — Googleの対応予定
- AI学習の信号をめぐる草案は、作業部会の草案が第08版、個人の草案が第00版で、どちらもまだ標準ではない。草案の状態は名前・種別・有効期限・置き換えの4か所で読める ── 話題になった草案をdatatrackerで確かめる13項目(2026年11月時点) — 草案の状態の読み方
- AIクローラーは1つではない ── robots.txt・llms.txtで「通す」「止める」を切り分ける(2026年9月時点) — 名乗りを分けて書く考え方
- Cloudflareが9月15日に加えた「AI学習だけを止める」設定 ── 検索に載せたまま止められる範囲と、今週確かめる6つ — 当サイトの方針を決めた記録
- 「AIクローラーが弾かれている」と読みかけた ── 日別に割ったら、正体は数十の名前を名乗る貸しサーバーだった — 名乗りだけで判断しない例
注意
この記事は、2026年11月7日に確かめた内容に基づく。Anthropicのヘルプ記事は更新日の表示が「this week」で、日付が出ない。信号の書き方は草案の進みで変わりうる。担当サイトで使うときは、その日にヘルプ記事とdatatrackerを開き直すこと。
現在の貴方のIPアドレス
このサイトで書いている人
