WEBサイト
llms.txtの仕様で必須なのは先頭の見出し1つだけ。Googleは検索で使わないと書き、3社のクローラーの説明ページには、クローラーがllms.txtを読むという記述が見つからなかった ── 置くかを決め、置いたあとにログで確かめる13項目(2026年10月時点)
llms.txtの仕様で必須なのは先頭の見出し1つだけ。Googleは検索で使わないと書き、3社のクローラーの説明ページには、クローラーがllms.txtを読むという記述が見つからなかった ── 置くかを決め、置いたあとにログで確かめる13項目(2026年10月時点)
目次
- 01 何が書かれているか — llms.txtの仕様で必須なのは先頭の見出し1つだけ。Googleは検索で使わないと書き、3社のクローラーの説明ページには、クローラーがllms.txtを読むという記述が見つからなかった
- 02 なぜ・背景 — 提案が2年でv2になり、「効く」という言葉が指すものは3つに分かれる
- 03 この記事に出てくる用語
- 04 型別 — 適用範囲・公式が書いていないこと・確かめる順番
- 05 明日、自社のサイトで確認できることチェックリスト
- 06 代替・他の選択肢 — llms.txtと、ほかの伝え方の役割
- 07 当サイトの例 — 自分のllms.txtは開けて、リンクは全部200だったが、ファイルの中の記事の数が古かった
- 08 このテーマは、ここまで
- 09 この記事のまとめ
01 何が書かれているか — llms.txtの仕様で必須なのは先頭の見出し1つだけ。Googleは検索で使わないと書き、3社のクローラーの説明ページには、クローラーがllms.txtを読むという記述が見つからなかった
引用について
この記事の「" "」で囲んだ英語の文は、公式の資料からの引用で、日本語訳は記事の筆者が付けたものである。原文は各出典のページで確認できる。各ページは2026年10月17日に開いて確かめた。
提案の出どころと日付
llms.txtは、AIのモデルやエージェントが、サイトの要点を読みやすい形で受け取るためのファイルとして提案された書式である。提案のページ「The /llms.txt file, v2」の著者欄はJeremy Howardで、公開日は2024年9月3日、更新日は2026年8月10日と表示されている。ページの冒頭は、こう書いている。
"A proposal to standardise on using an /llms.txt file to provide information to help agents use a website."
(訳: エージェントがウェブサイトを使うのを助ける情報を提供するために、/llms.txtファイルを使うことを標準にしようという提案。)
ページが自分で使っている言葉は「規格」ではなく「提案」(proposal)である。llms.txtは、提案として広まった書式である。この点を先に押さえておくと、このあとの公式の言い方が読みやすくなる。
仕様が求める形
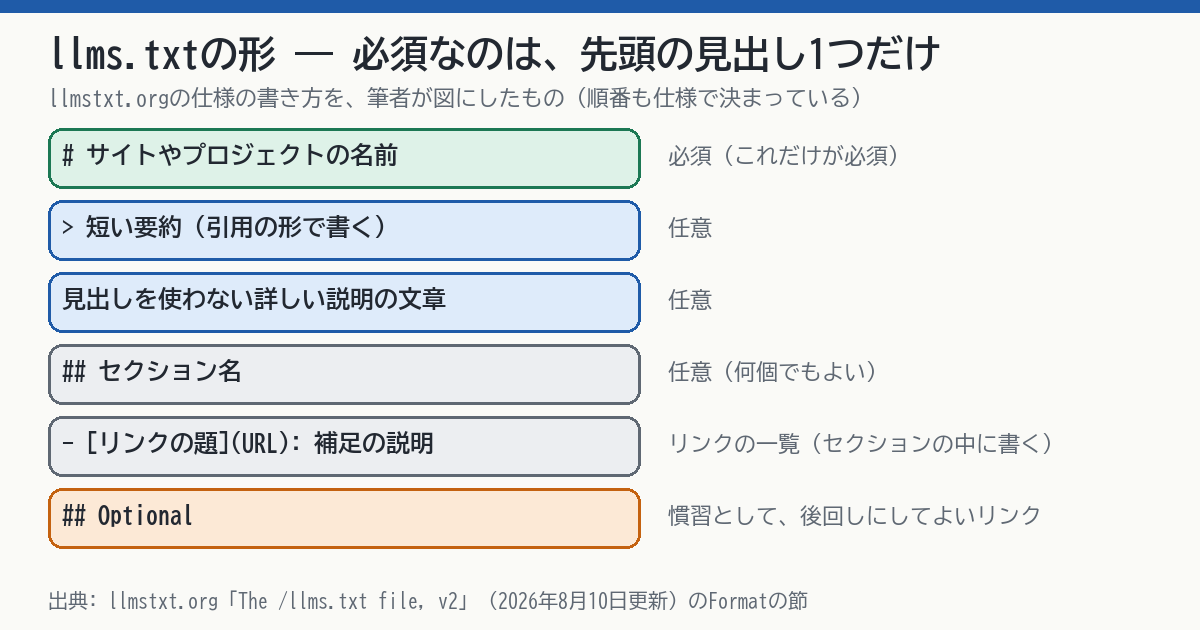
提案のFormatの節は、ファイルを決まった順番で書くよう求めている。必須の部分について、次のように書かれている。
"An H1 with the name of the project or site. This is the only required section"
(訳: プロジェクトまたはサイトの名前を書いたH1。これが唯一の必須の部分である。)
つまり、必須なのは先頭の見出し(Markdownでは「# 名前」の1行)だけである。そのあとに、要約を書く引用ブロック、見出しを使わない詳しい説明、H2見出しで区切ったリンクの一覧が続くが、どれも任意の部分である。リンクの一覧の各行は「[名前](URL)」の形が必須で、その後ろに「: 補足」を付けるかどうかが任意である。
Googleの言い方
Google Search Centralの「Google's Guide to Optimizing for Generative AI Features on Google Search」は、最終更新が2026年7月10日(UTC)と表示されている。この文書の「生成AI検索で、やらなくてよいこと」の項目に、llms.txtが名指しで出てくる。
"You don't need to create new machine readable files, AI text files, markup, or Markdown to appear in Google Search (including its generative AI capabilities), as Google Search itself doesn't use them."
(訳: Google検索(生成AI機能を含む)に表示されるために、新しい機械可読ファイル、AI向けのテキストファイル、マークアップ、Markdownを作る必要はない。Google検索自体がそれらを使わないからである。)
同じ項目の少しあとには、作ってもよい、とも書かれている。
"It's completely fine if you decide to create and maintain LLMS.txt files (or other similar files) for other services or systems that use these files. Doing so will neither harm nor help your site's visibility or rankings in Google Search, as Google Search ignores them."
(訳: これらのファイルを使う別のサービスや仕組みのために、LLMS.txtファイル(や似たファイル)を作って維持することは、まったく問題ない。そうしても、Google検索でのサイトの見え方や順位が損なわれることも助けられることもない。Google検索はそれらを無視するからである。)
Googleの言い方は「禁止でも推奨でもなく、Google検索は無視する」である。ほかの用途に使うかどうかは、Google検索の外の話になる。
他の3社のクローラーの説明ページ
OpenAI・Anthropic・Perplexityは、自社のクローラーの説明ページを公開している。3つのページを開いて「llms」の語を探した。見つかったのは、OpenAIとPerplexityのページが、自社の文書全体の索引としてllms.txtを案内している行だけで、Anthropicのページには見つからなかった。どの会社も、自社のクローラーがサイト運営者のllms.txtを読むとも、読まないとも、このページには書いていない。
3社のページに共通して書かれているのは、robots.txtの扱いである。OpenAIのページは次のように書く。
"OpenAI uses OAI-SearchBot and GPTBot robots.txt tags to enable webmasters to manage how their sites and content work with AI."
(訳: OpenAIは、ウェブ管理者が自分のサイトと内容をAIとどう関わらせるかを管理できるように、OAI-SearchBotとGPTBotのrobots.txtのタグを使う。)
Anthropicのページは、同社のクローラーが「industry standard directives in robots.txt」を守ると説明し(引用は原文の一部)、Perplexityのページも、robots.txtのタグで自社のクローラーとの関わり方を管理できると書く。ここで「見つからなかった」と書くのは、この3ページと、確かめた日についてだけである。3社のほかの文書やヘルプに書かれているかどうかは、この記事では確かめていない。
02 なぜ・背景 — 提案が2年でv2になり、「効く」という言葉が指すものは3つに分かれる
v1とv2の違い
提案のページには、v1からv2への変更をまとめた「Changes」のページが付いている。v2は2026年8月とされ、変わった点が次のように並んでいる。
- ページごとのMarkdown版や、そのページを説明するllms.txtを見つけやすくするために、HTMLのlink要素かHTTPのLinkヘッダーに、rel="alternate"とrel="describedby"を使うことを勧める
- Markdown版のURLは、「page.html.md」の形に加えて、拡張子を置き換えた「page.md」の形も認める
- サブパスに置いたllms.txtは、そのパスの下のページを説明するものと定義し、複数あるときはいちばん具体的なものを使う
- v1にあった補助ツールの話をやめ、読む側の想定を書く。Optionalのセクションは「後回しにしてよい」という慣習にとどまる
Changesのページは、広まりぶりを次のように書いている。
"Thousands of sites now publish an llms.txt file, documentation platforms generate one automatically, and coding agents use them reliably."
(訳: 今では数千のサイトがllms.txtファイルを公開し、文書の作成基盤が自動で生成し、コーディング用のエージェントが確実に使っている。)
これは提案者の記述である。数字の出どころや、どのエージェントが確実に使っているのかは、このページには書かれていない。
置く場所と、読む側の想定
提案のページは、llms.txtをサイトのルートか、それより下の任意のパスに置けると書く。
v2は、読む側がどう使うかを、次のように書いている。
"Agents are expected to view or search llms.txt to find the information they need, then follow the relevant links."
(訳: エージェントは、必要な情報を見つけるためにllms.txtを見るか検索し、そのあと関連するリンクをたどることが期待されている。)
提案のページは、robots.txtとの違いも書いている。robots.txtは、検索の巡回のような自動の道具に対して、どのアクセスが許されるかを知らせるもので、llms.txtは、エージェントが利用者を助けるために話題の情報を必要とするときに、そのつど使うものだ、という整理である。robots.txtとllms.txtの切り分けは、AIクローラーは1つではない ── robots.txt・llms.txtで「通す」「止める」を切り分ける(2026年9月時点)で整理した。この記事では繰り返さない。
「効く」が指すことは3つに分かれる
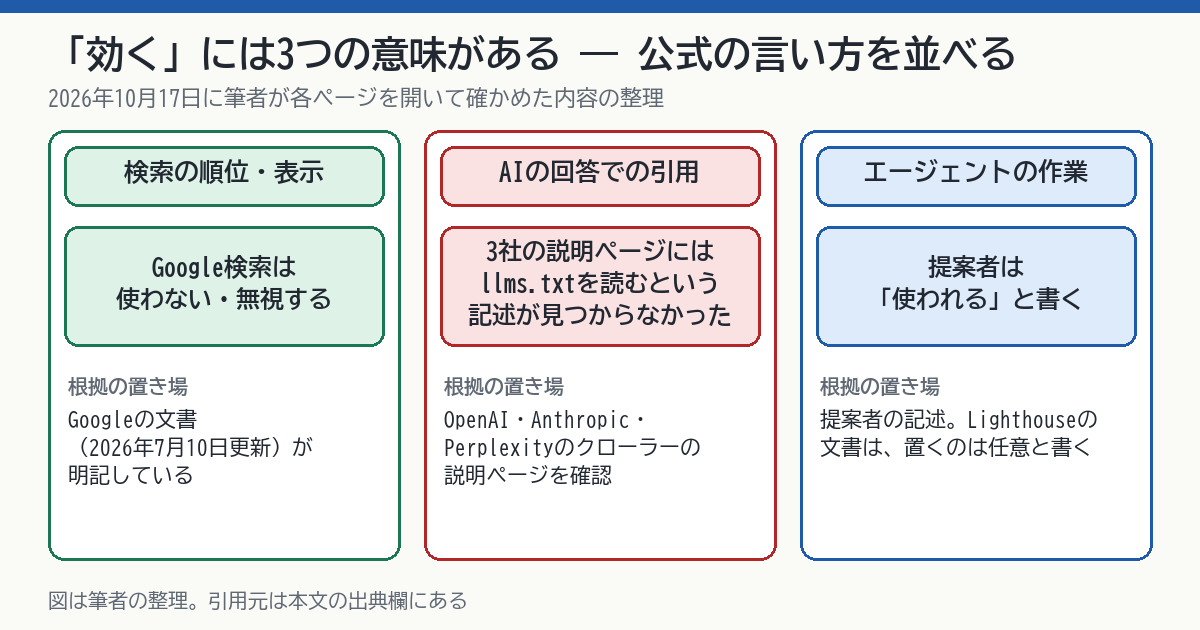
「llms.txtは効くのか」という問いは、3つの別の問いが混ざっている。
- 検索の順位や表示に効くか — Googleは、使わない・無視すると書いている
- AIの回答での引用に効くか — 3社のクローラーの説明ページには、クローラーがllms.txtを読むという記述が見つからなかった
- エージェントの作業を助けるか — 提案者は、特に文書のサイトでは使われていると書き、Lighthouseの文書は、置くのは任意と書く
提案者の記述と、第三者が測った数字は別である
「数千のサイトが公開している」は、置かれているファイルの数の話で、読まれている数の話ではない。当サイト自身のログで数えた結果は、07章に書いた。
03 この記事に出てくる用語
llms.txtとllms-full.txt
用語
llms.txt—サイトの名前・要約・主なページへのリンクを、Markdownの決まった形で書いたテキストファイル。llms-full.txt—文書の中身を1つのファイルにまとめた版につけられる名前。OpenAIとAnthropicの開発者向け文書は、llms.txtに加えて、まとめた版をllms-full.txtという名前で案内している。llms-full.txtは、提案のFormatの節の必須の部分ではない。
この記事で「llms.txt」と書いたときは、サイトに置く、案内用の短いファイルを指す。文書全体をまとめた版は、そう書いたときだけを指す。
クローラーと、利用者の依頼で動く取得
用語
クローラー—自動でサイトを巡回して中身を集めるプログラム(OpenAIのGPTBot、Anthropicのクローラーなど)。利用者の依頼で動く取得—利用者がAIに質問したとき、AIがそのページを取りに行く動き(OpenAIのChatGPT-User、PerplexityのPerplexity-Userなど)。
OpenAIのページはChatGPT-Userについて、自動でウェブを巡回するものではなく、利用者の操作で動くため、robots.txtのルールが当てはまらないことがある、と書いている。Perplexityのページも、Perplexity-Userは利用者が取得を頼んだものなので、一般にrobots.txtを無視する、と書く。ログの名乗りを数えるときは、この2種類を分ける必要がある。
比べる基準を 2 つ置く
用語
必ず読まれるもの—確かに読まれると分かっているもの(robots.txtなど)を同じ条件で数えて、数える仕組み自体が動いていると確かめるための比べる基準。読まれる理由がないもの—存在を誰にも教えていないファイルなどを同じ条件で数えて、「何を置いても起きること」を切り分けるための比較。
Markdown版のページ
提案は、リンクの先に置くものとして、元のページのMarkdown版を挙げる。URLは、末尾に「.md」を足す形(page.html.md)か、拡張子を置き換える形(page.md)である。サイトのページをMarkdownに変えて返す仕組みは、CloudflareのMarkdown for Agentsは、展開後6MiBまでのHTMLを変換するようになった ── 自社のページの大きさと、AIエージェントに読まれる形を確かめる13項目(2026年10月時点)で扱った。llms.txtは「どのページを読むか」の案内で、Markdown版は「読むページそのもの」である。
Lighthouseの「Agentic browsing」の項目
Chrome for Developersには、Lighthouseの「Agentic browsing audits」(エージェントによるブラウジングの監査)という項目群があり、llms.txtの監査はその「Discoverability」の下にある。検索の順位の監査ではない。
04 型別 — 適用範囲・公式が書いていないこと・確かめる順番
🅰 適用範囲 — 提案者は文書のサイトを真っ先に挙げる
提案のページは、llms.txtが最も使われているのは、ソフトウェアの文書のサイトで、コーディング用のエージェントがAPIの説明や手引きを探すのに使う、と書いている。同じ構造は、会社が自分の組織や決まりを説明する場合や、個人のサイトが経歴の質問に答える場合にも使える、とも書く。
一方、OpenAIとAnthropicとPerplexityについて、この記事で開いたllms.txtは、いずれも開発者向けの文書の案内である。会社の情報サイトや、記事を載せるサイトで、AIの回答に影響するかどうかは、公式の文書からは確かめられない。文書のサイトを運営しているかどうかで、読み方が変わる。
🅱 公式が書いていないこと
ここまでの公式の文書に、書かれていないことを3つに分ける。
- 置いたサイトが、AIの回答に取り上げられやすくなるという根拠。3社のクローラーの説明ページには、クローラーがllms.txtを読むという記述が見つからなかった
- どのAIの機能が、どの頻度でllms.txtを取りに来るか。提案は「期待されている」と書く(上の引用の "are expected to" の部分)
- 行数やリンクの本数の具体的な目安。提案はファイルが文脈に収まる小ささであることと、「簡潔な言葉を使う」「リンクには短い説明を付ける」などの書き方の注意を挙げるが、数は書いていない
「置けばAIに引用される」という記事や発言は、公式の文書の裏づけが示されていない限り、そのまま受け取らなくてよい。効くかどうかは、自分のサイトで数えて決めるのが確実である。
🅲 手順 — 確かめる5段
手順は、「あるか確かめる」「形を確かめる」「リンクを確かめる」「置くか決める」「置いたあと数える」の5段である。05章のチェックリストは、この順番に並べてある。
手順1 — あるかどうかを、取得して確かめる
自社のドメインの「/llms.txt」を、ブラウザとcurlの両方で1回ずつ開く。ステータスコードと、Content-Typeを書き留める。プラグインが生成している場合も、外から実際に取れる内容で確かめる。
手順2 — 形を確かめる
先頭の行が「# 」で始まる見出しか、要約が「> 」の引用ブロックか、H2で区切ったリンクの一覧があるかを見る。必須なのは先頭の見出しだけなので、足りない部分を足すより、置く目的に合わない部分を削るほうが先である。
手順3 — リンクの先を確かめる
一覧のリンクを5本開き、200で開くか、404や転送になるものがないかを数える。一覧の中の説明の数字(記事の本数など)が、実際の数と合っているかも見る。07章では、この確認で、当サイトのファイルの中の数字が古くなっていることが見つかった。
手順4 — 置くか置かないかを、目的で決める
置く目的を、1行で書く。「検索の順位のため」は、Googleの言い方と合わない。「エージェントの作業を助けるため」「社内や取引先に、サイトの案内を渡すため」なら、成り立つ。目的が書けないなら、今は置かないという決め方もある。
手順5 — 置いたあとは、ログで数える
置く前に、同じ期間の「robots.txt」のアクセス数を数えて「必ず読まれるもの」の基準にし、存在を教えないファイルを1つ置いて「読まれる理由がないもの」の基準にする。そのうえで、llms.txtのアクセスを名乗り別に数える。数字には、数えた期間と、全体で何件のうちかを添える。
実務のヒント
名乗りは、ログの上では誰でも書ける文字列である。名乗りだけで「AIが読んだ」と数えないほうがよい。公式が公開しているIPアドレスの一覧と照らせる名乗りは、照らす。照らせないものは「名乗りだけで、確認できていない」と別の欄に分ける。
05 明日、自社のサイトで確認できることチェックリスト
以下は、llms.txtを自社のサイトに置くか、置いたなら何を確かめるかを決めるための項目である。1〜5番目はファイルの有無・形・リンク、6〜8番目は目的と中身、9〜13番目は置いたあとのログでの確認である。チェックの状態はブラウザに保存され、サーバーには送られない。
- ブラウザで自社のドメインの「/llms.txt」を開き、表示されるか404になるかを、画面の状態といっしょに書き留める
- curlなどで「/llms.txt」を1回取得し、ステータスコードとContent-Typeを書き留める
- ファイルが開けたら、先頭の行が「# 」で始まる見出しになっているかを確認する
- リンクの行(「- [名前](URL)」の形)の数を数え、一覧のリンクを5本開いて、200で開くものと、404や転送になるものの数を書き留める
- ファイルの中に書いてある記事の本数やページの数を、実際の数と並べて、違うものがあれば書き出す
- 置く目的を、「検索の順位」「エージェントの作業」「取引先への案内」のどれかで、1行で書く
- 置くと決めたら、載せたいページを10本までに絞った一覧を作る
- 自動生成するプラグインを使うなら、生成されたファイルを開き、載せたくないページが入っていないかを10行分確認する
- アクセスログの保管期間を確かめ、置いた日から30日分以上が残るかを書き留める
- 置く前の1週間分の「/robots.txt」のアクセス数を数えて、比べる基準の値として書き留める
- 存在を教えない比較用のファイルを1つ決め、同じ日に置くか、置かない理由を書き留める
- 置いて30日後に、llms.txtへのアクセスを名乗り別に数え、検索エンジン・調査ツール・AIの運営元の名乗り・その他に分けた表を作る
- 数えた期間と、全体で何件のうちかを日付つきで1行にまとめ、次に数え直す日(90日後)をカレンダーに入れる
06 代替・他の選択肢 — llms.txtと、ほかの伝え方の役割
ファイルや仕組みごとに、誰に向けた案内かが違う
サイトの情報を機械に伝える手段は、llms.txtのほかにもある。公式の文書や提案のページが書いている宛先を、表に並べる。
| 手段 | 何を伝えるか | 宛先と、公式の言い方 |
|---|---|---|
| robots.txt | どのアクセスを認めるか | OpenAI・Anthropic・Perplexityが、自社のクローラーの管理の方法として説明している |
| sitemap.xml | 検索エンジン向けに、載せるページの一覧 | 提案のページは、検索エンジン向けの全ページの一覧と、LLM向けに選んだ概要は別のもので、共存するものと書く |
| llms.txt | 主なページへの案内と要約 | 提案者は、エージェントがそのつど使うものと書く。Google検索は無視する |
| Markdown版のページ | 読むページそのものを、読みやすい形で | 提案が、リンク先に置くことを勧める |
| 構造化データ | ページの内容の意味づけ | 提案のページは、llms.txtからも、構造化データを使っていることを参照できると書く |
表の読み方は、「どれが効くか」ではなく、誰に向けた案内かである。検索の順位を気にするなら、Googleの文書が勧める基本の整備が先になる。エージェントの作業を気にするなら、llms.txtやMarkdown版のページが候補になる。ブラウザの中のエージェントがサイトを見つける入口を作る話は、Lighthouse 13.5にAIエージェント向けカタログの検査が入った。探す名前は、仕様が「前身」と呼ぶai-catalogの側だった ── 置くか置かないかを決めて確かめる14項目(2026年10月時点)で扱った。
当サイトの無料ツールとの使い分け
当サイトには、サイトの状態を確かめる無料のツールがある。🔧 sitemap.xmlを作るツール — URLを入れて、検索エンジン向けの一覧を作るは、llms.txtとは別の、検索エンジン向けの一覧を作る。llms.txtの代わりにはならない。
🔧 サイト内のリンク漏れ・アクセスステータスを調べるツール — Excelに出力できるは、サイトのHTMLのリンクや画像のアドレスを調べて、アクセスステータスをまとめる。llms.txtそのものを読むツールではない。ただし、llms.txtの一覧が自社のページを指しているなら、リンク先が200で開くかを確かめる手順3の補助になる。
自動生成のプラグインを使うとき
提案のページは、llms.txtを自動で作る仕組みとして、Yoast SEOとAIOSEOのWordPressプラグイン、Wixなどを挙げている。何が載っているかは、開いて確かめる必要がある。公開したくない下書きや古いページが入っていないかを、05章の8番目で見る。
注意
プラグインの設定画面に「llms.txtを生成する」と表示されても、外から実際に取得できる内容と同じとは限らない。確かめるのは、外から取得した内容である。
置かない選択と、置く選択の決め方
置かない選択は、間違いではない。Googleは、置かなくても検索で不利にならないと書く。置くのは、目的を1行で書けて、数えて確かめる用意があるときである。書けないなら、置かずにほかの基本を整える。
07 当サイトの例 — 自分のllms.txtは開けて、リンクは全部200だったが、ファイルの中の記事の数が古かった
2026年10月17日に、自分のllms.txtを開いた
当サイトにはllms.txtを置いてある。この記事の手順1〜3に当たる確認を、2026年10月17日に、外から取得する形でやった。
| 確かめたこと | 結果 |
|---|---|
| 取得 | ステータス200、Content-Typeはtext/plain |
| 先頭の行 | サイト名の見出し(「# 」で始まる) |
| 全体の形 | 全体で50行。要約の引用ブロック1個、H2見出し5個、リンクの行28本 |
| リンク先 | 28本すべてが、ステータス200で開いた |
| ファイルの中の数字 | ブログの記事について「全132本」と書いてある |
| ブログの一覧 | 一覧のページには「全157本」と表示されている |
形は仕様に合っていた。先頭に見出しがあり、リンクの先はすべて開く。ところが、ファイルの中に書いてある記事の本数が、実際の本数より古かった。05章の5番目の確認で見つかった食い違いである。
見つかった食い違いと、これからのこと
ファイルの中のブログの記事数は「全132本」で、一覧のページは「全157本」と表示している。25本ぶん、ファイルの数字が古いままだった。リンクが200で開くかどうかだけを数えていたら、この食い違いは見えなかった。
同じ日(2026年10月17日)に直した。数字を新しい本数に書き換えるのではなく、「全記事」という言い方に変え、本数を書かないようにした。本数を書くと、記事を1本足すたびにまた古くなるからである。ファイルの行の数と、リンクの形は変えていない。
実務のヒント
リンクが開くことと、ファイルの中の記述が今の状態と合っていることは、別の確認である。数字を書いたら、その数字を数え直す日も決める。書かなくても伝わる数字なら、書かないのがいちばん古くならない。
アクセスログの数字は、公開済みのブログから写した
置いたあとのアクセスログの数字は、当サイトの公開済みのブログに書いてある。この章に写す前に、公開中のブログの本文を2026年10月17日に開き、数字が書かれていることを確かめた。
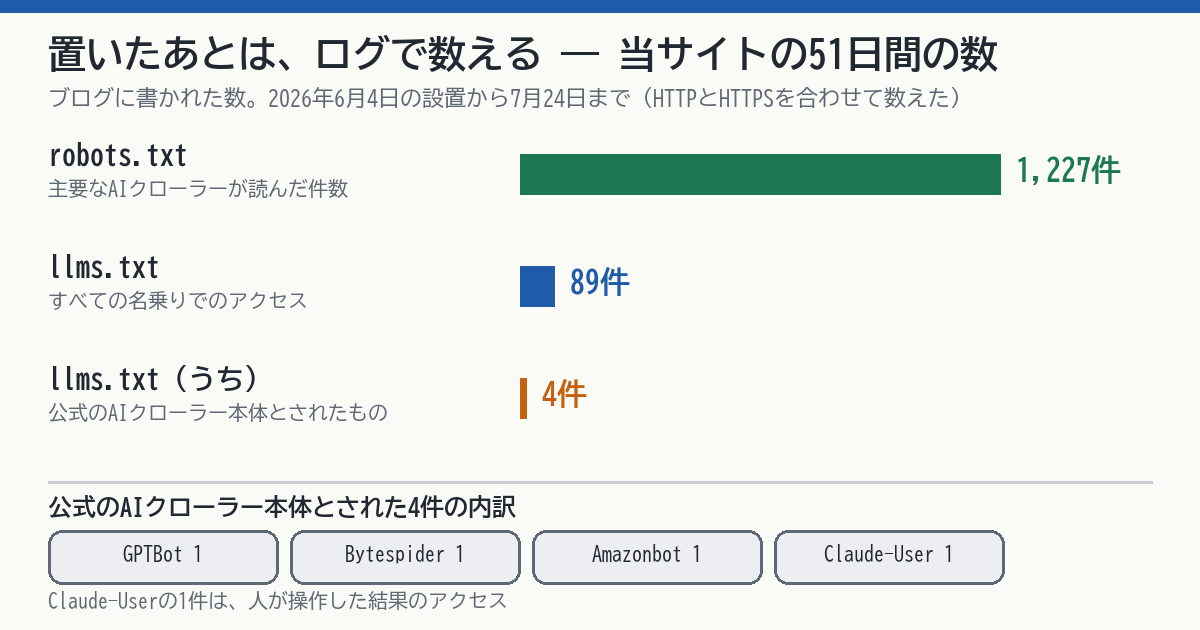
llms.txt を置いて51日、正直に答え合わせ第2弾 ── Google が『効かない』と言った以上に、他の AI も読みに来ていなかったには、2026年6月4日の設置から51日間(7月24日まで)の数え直しが書かれている。llms.txtへのアクセスは89件で、そのうち、公式のAIのクローラー本体とされたものは4件(GPTBot・Bytespider・Amazonbot・Claude-Userが各1件)だった。Claude-Userの1件は、人が操作した結果のアクセスで、自動の巡回ではない、とも書かれている。同じ期間に、主要なAIクローラーがrobots.txtを読んだ件数は合計1,227件だった。
以前のブログには、別の52日間について、ファイル別のアクセス数を載せたものもあった。その数え方は、のちに、AIは331回来たと書いた。実際は11,024回だった ── HTTPのログだけを52日間 見ていたで、HTTPのログだけを見ていたと訂正されている。訂正された数え方の数字は、この記事には写さない。
確かめていないこと
この章で分かったのは、当サイトのファイルの形と、リンク先の状態と、過去の記録の数字だけである。次のことは確かめていない。
- ブログに書かれた数字を、ログから数え直したこと。HTTPのログだけを見た数え方は訂正されているため、その期間の数字はこの章に写していない
- 10月17日時点の最新のアクセスログ。数字は、ブログに書かれた期間のものである。次に数え直す日を決めたら、この章に日付つきで追記する
- 名乗りを公式のIPアドレスの一覧と照らした結果。照らしていないので、名乗りは名乗りのままである
- llms.txtを置いたことが、AIの回答での引用に影響したかどうか。影響を測る比較の条件は用意できていない
- 他のサイトでの結果。数字は、当サイトの1サイトのものである
08 このテーマは、ここまで
2024年9月3日 — 提案が公開された
提案のページに、公開日が2024年9月3日と表示されている。v2の本文は、このときを、AIがサイトを日常的に読むことが、まだ予測だった時期と説明している(原文の趣旨)。
2026年5月5日 — Lighthouseの文書の更新日
Chrome for Developersの、Lighthouseのllms.txtの監査の文書は、最終更新が2026年5月5日(UTC)と表示されている。文書は、llms.txtを「emerging convention」(生まれつつある慣習)と呼ぶ。
"If the file is not provided by the server (resulting in a 404), the audit is marked as Not Applicable (N/A), as providing the file is optional at the moment."
(訳: サーバーがファイルを提供しない場合(404になる場合)、この監査は「該当なし」とされる。現時点では、ファイルを提供することは任意だからである。)
2026年7月10日 — Googleの文書の更新日
先に引用した、生成AI検索の最適化の案内は、最終更新が2026年7月10日(UTC)と表示されている。当サイトのブログは、この更新を見つけた日のことをllms.txt を置いて51日、正直に答え合わせ第2弾 ── Google が『効かない』と言った以上に、他の AI も読みに来ていなかったに書いている。別の文書「AI Features and Your Website」(最終更新は2025年12月10日)にも、AI向けのテキストファイルを作る必要はない、という趣旨の文がある。こちらはllms.txtの名前を挙げていない。
2026年8月 — 提案がv2になった
提案のページのChangesに、v2(2026年8月)の変更点が載っている。v2の変更点を当サイトのファイルに照らして測った結果はllms.txt が v2 になった日 ── 200 が返ることと、対応していることは別だったに、直した翌日に、読まなくてよい節へ記事を積んでいたと分かった話はllms.txt に 59 本 積んでいた ── ただし『読まなくていい』と書いてある棚にに書いた。
この記事の確認日
この記事の内容は、2026年10月17日に、提案のページ・Changesのページ・Googleの2つの文書・Lighthouseの文書・3社のクローラーの説明ページを開いて確かめた時点のものである。3社のページは、ほかの文書やヘルプまでは確かめていない。次に提案のページが更新されたときや、3社のどれかがllms.txtに触れたときは、この記事の01章に追記する。
現在の貴方のIPアドレス
このサイトで書いている人