WEBサイト
CloudflareのMarkdown for Agentsは、展開後6MiBまでのHTMLを変換するようになった ── 自社のページの大きさと、AIエージェントに読まれる形を確かめる13項目(2026年10月時点)
CloudflareのMarkdown for Agentsは、展開後6MiBまでのHTMLを変換するようになった ── 自社のページの大きさと、AIエージェントに読まれる形を確かめる13項目(2026年10月時点)
目次
01 何が起きたか — Markdown for Agentsが変換できるHTMLは、展開後6MiBまでになった
10月9日の更新で変わった3つ
CloudflareのChangelogに、2026年10月9日付で「More efficient Markdown for Agents conversion」(訳: Markdown for Agentsの変換を、より効率よくした)という更新が出た。Markdown for Agentsは、AIエージェントが「Markdownで欲しい」と頼んだときに、サイトのHTMLをCloudflareがMarkdownに変えて返す機能である。2026年10月15日に開いて読んだ。変わったのは3つである。
- 変換のやり方 — HTMLが届くそばから処理する方式(in-process streaming engine)に変わった。以前は、HTMLの応答をためてから、別の変換サービスへ送っていた。変換の手間とメモリの使用が減る、と書かれている。
- 変換できる大きさ — 展開後のHTML 2MiBまでが、6MiBまでに広がった。
- 応答のヘッダー — x-markdown-tokensとx-original-tokensが付かなくなり、Content-Lengthも付かなくなった。
上限の書き方は、次のとおりである。
"Conversion supports up to 6 MiB (6,291,456 bytes) of decompressed HTML, increased from 2 MiB (2,097,152 bytes). The limit applies after decompression, not to the compressed response size."
(訳: 変換は、展開後のHTMLで6MiB(6,291,456バイト)まで対応する。以前の2MiB(2,097,152バイト)から増えた。この上限は展開後に当てはまり、圧縮された応答の大きさには当てはまらない。)
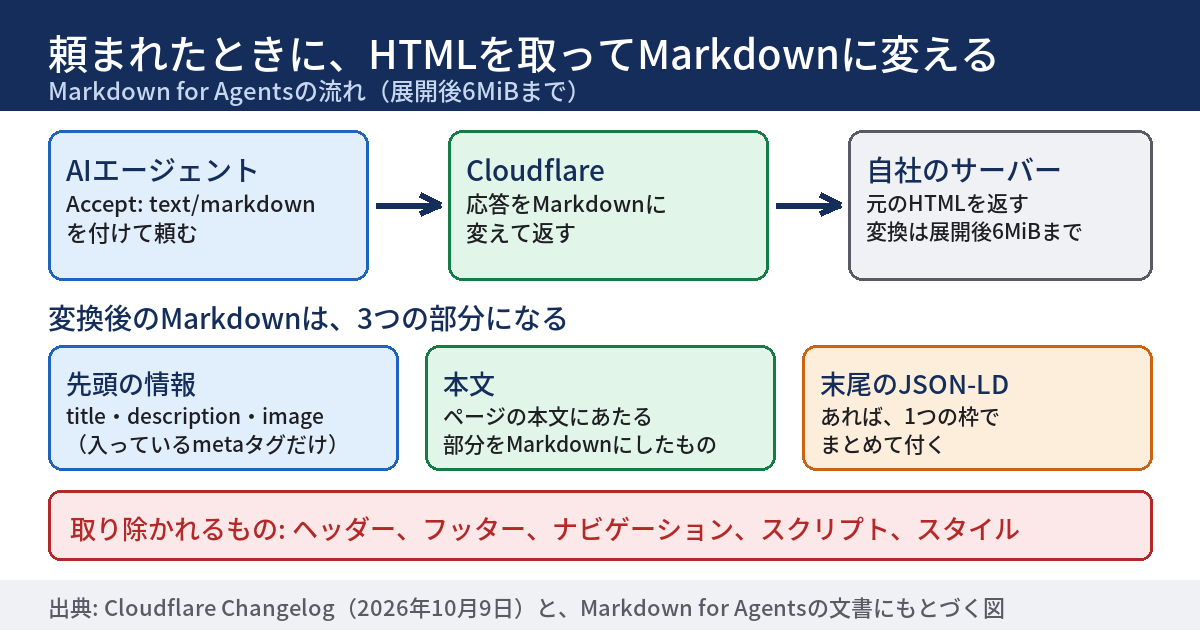
Markdown for Agentsは、頼まれたときに、HTMLを取って変換する
公式文書の説明では、エージェントがHTTPのAcceptヘッダーに「text/markdown」を入れて頼むと、Cloudflareが自社のサーバーから元のHTMLを取り、Markdownに変えて返す。変換は、頼まれたときに行われる。文書の最終更新は2026年10月9日で、文書の一覧には「Beta」と付いている。
使えるのは、Pro、Business、Enterpriseのプランと、SSL for SaaSのお客様で、費用はかからないと書かれている。ダッシュボードの「AI Crawl Control」から有効にする。変換できるのはHTMLだけで、ほかの種類の文書は対象外である。
変換後は、3つの部分になる
文書によると、変換後のMarkdownは3つの部分でできている。
- 先頭の情報(YAMLのfrontmatter) — ページのmetaタグから取ったtitle、description、imageである。入っているmetaタグだけが出る。
- 本文 — ヘッダー、フッター、ナビゲーション、スクリプト、スタイルのような本文でない部分は、取り除かれる。
- 末尾のJSON-LD — ページに構造化データ(JSON-LD)があれば、末尾に1つのコードの枠でまとめて付く。
この記事が読んだもの、読めなかったもの
読んだのは、CloudflareのChangelog、Markdown for Agentsの文書、2026年2月12日の発表のブログ、Workers AIの変換の文書、Googleのクローラーの文書2つ、MDNの文書である。すべて2026年10月15日に開いた。
確かめていないものもある。当サイトはCloudflareを使っていないので、変換の応答そのものは取っていない。上限を超えたHTMLに何が返るかは、読んだ範囲では書かれていなかった。この記事の主題は、製品の紹介ではなく、自社のHTMLの大きさ(展開後)と、見出し・表・本文が意味のある形で入っているかを確かめることである。
02 なぜ・背景 — 上限は「展開後」で数える。Googleの2MBも同じ数え方である
圧縮された大きさではなく、展開した大きさ
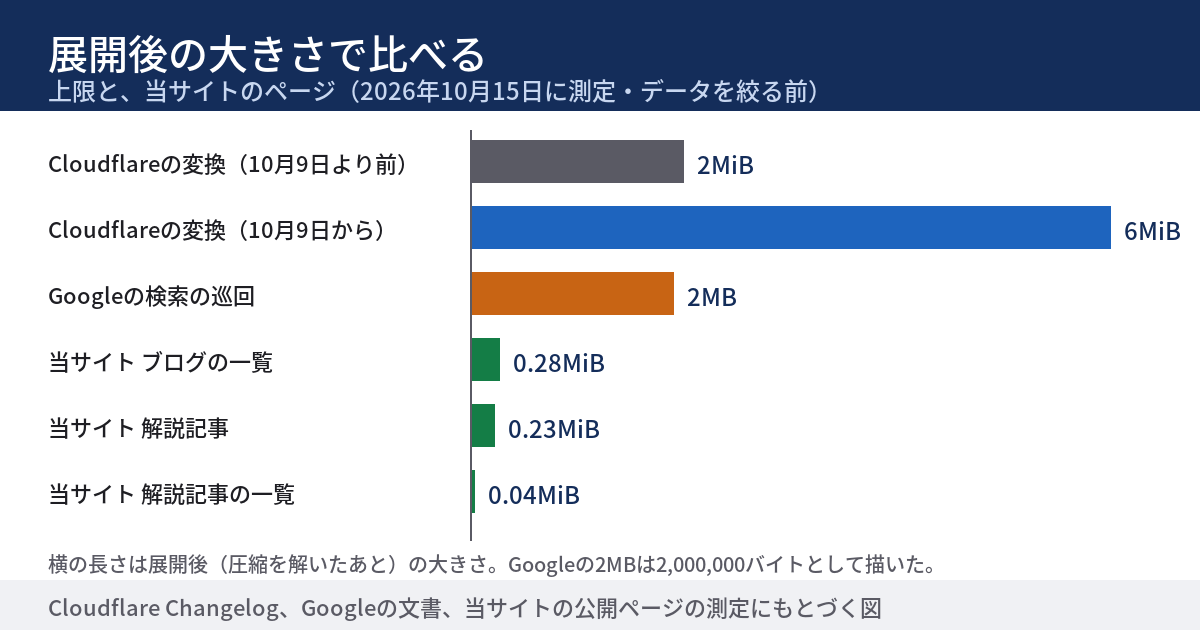
Cloudflareの上限は、展開後のHTMLで数える。転送のときに圧縮して小さくなっていても、展開した大きさが数えられる。Googleの文書にも、同じ数え方の記述がある。
"Once the cutoff limit is reached, Googlebot stops the fetch and only sends the already downloaded part of the file for indexing consideration. The file size limit is applied on the uncompressed data."
(訳: 上限に達すると、Googlebotは取得をやめ、そこまでに取り込んだ部分だけを、登録の対象として考えるために送る。ファイルの大きさの上限は、圧縮を解いたデータに当てはまる。)
Googleの同じ文書は、Google検索のための巡回では、対応するファイルの先頭の2MBを取り込む、と書いている。最終更新は2026年2月3日(UTC)である。この2MBの意味と確かめ方は、当サイトの記事「Googleのクロールは2MBで止まる ── 最新の公式解説と、自分のサイトで確認する13項目」で扱った。
3つの数字を、並べて読む
| どの話か | 数字 | 数え方・注意 |
|---|---|---|
| Cloudflareの変換 | 6MiB(6,291,456バイト)。2026年10月9日より前は2MiB | 展開後のHTMLで数える |
| Googlebot(Google検索) | 先頭の2MB | 圧縮を解いたデータで数える。超えた分は取り込まれない |
| Googleのクローラー全般 | 既定で先頭の15MB | 個別のクローラーは別の上限を持てる。例として、Googlebotは2MB。この文書の最終更新は2026年6月12日(UTC) |
単位にも注意する。Cloudflareは「MiB」と書き、バイト数まで添えている。Googleは「MB」と書き、MBが100万バイトなのか、1,048,576バイトなのかは、読んだ範囲では書かれていなかった。2つの数字の差は、およそ5%である。ページが上限に近いときだけ、この違いが問題になる。
変換の上限と、検索の上限は、別のもの
CloudflareのMarkdownへの変換は、エージェントがMarkdownを頼んだときの応答の話である。Googleの2MBは、Google検索のための巡回の話である。どちらかに収まっていても、もう一方の保証にはならない。ただし、どちらの数字も展開後で数えるので、自社のページの展開後の大きさを1回測れば、両方に当てられる。
応答のヘッダーの変更は、読む側の話
x-markdown-tokensは、変換後のMarkdownのおおよそのトークン数を知らせるヘッダーだった。2026年2月の発表のブログは、この値を、モデルが一度に読める量の見積もりや、文書を区切る方針に使える、と書いていた。今回、このヘッダーは付かなくなり、使っている側は自分で数える必要がある。サイトを配信する側が直すものは、読んだ範囲では見つからなかった。自社のエージェントや道具が、このヘッダーを読んでいるなら、その道具の側の問題になる。
同じブログは、HTMLが生のままAIに渡されることを、こう例えている。
"Feeding raw HTML to an AI is like paying by the word to read packaging instead of the letter inside."
(訳: HTMLを生のままAIに渡すのは、中の手紙ではなく、包装を、1語ずつ料金を払って読むようなものだ。)
同じブログには、Cloudflare自身のブログ記事1本が、HTMLでは16,180トークン、Markdownでは3,150トークンになったという数字がある。約80%の削減と書かれている。これは、Cloudflareの1本の記事の数字で、読者のサイトの数字ではない。
何が取り除かれ、何が残るか
変換の前に何が取り除かれるかは、Workers AIの文書にある。scriptとstyleのタグは無視され、title・description・og:title・og:description・og:imageのmetaタグが取り出され、JSON-LDは末尾に付く。本文の範囲を指定しない場合は、header・footer・headのような要素が取り除かれる。Markdown for Agentsの文書は、スクリプトについて、こう書いている。
"JSON-LD is the only <script> content preserved in the output — all other <script> and <style> content is stripped during HTML pre-processing."
(訳: JSON-LDは、出力に残る唯一の<script>の中身である。ほかの<script>と<style>の中身は、HTMLの前処理で取り除かれる。)
つまり、本文がヘッダーやフッターの要素の中に入っていたり、スクリプトの中のデータにしか無かったりすると、変換後に残らないと、文書の書き方から読める。この読みは、実際の変換では確かめていない。
応答に、利用の意思表示が付く
変換した応答には、Content-Signalヘッダーが付く。自社のサーバーの応答に、すでにこのヘッダーがあれば、その値が優先される。無ければ、「ai-train=yes, search=yes, ai-input=yes」(AIの学習、検索、AIへの入力に使ってよい)が既定で付く、と文書に書かれている。使わせるかどうかの方針は、サイトごとに決める。当サイトの方針は、記事「Cloudflareが9月15日に加えた「AI学習だけを止める」設定 ── 検索に載せたまま止められる範囲と、今週確かめる6つ」の末尾に書いた。
03 用語 — 読み違えやすい言葉を先にそろえる
Markdown for Agents
用語
Markdown for Agents:AIのエージェントがMarkdownを頼んだときに、CloudflareがサイトのHTMLをその場でMarkdownに変えて返す機能である。有効にするのはサイトの側で、対象のプランは文書に書かれている。
Acceptヘッダー
用語
Acceptヘッダー:HTTPの要求に付くヘッダーで、受け取れる種類(MIMEタイプ)を知らせる。MDNは、Acceptを、送り手が理解できる内容の種類を示すものと説明している。同じURLに、頼まれた種類に応じて別の形を返す仕組みを、コンテンツネゴシエーションという。Markdown for Agentsは、この仕組みを使う。
展開後の大きさ(MiBとMB)
用語
展開後の大きさ:gzipなどで圧縮して送られたHTMLを、元に戻したあとのバイト数である。MiBは1,048,576バイト(2の20乗)を1とする単位である。MBは、文書によって、1,000,000バイトの意味にも、MiBと同じ意味にも使われる。Cloudflareの6MiBは6,291,456バイトである。
Vary(バリー)ヘッダー
用語
Vary:応答の中身が、要求のどのヘッダーで変わるかを示すヘッダーである。MDNは、キャッシュが、挙げられたヘッダーごとに別の応答として保存するための印だと説明している。Markdown for Agentsの応答には、Acceptが入る。HTML版とMarkdown版が、別々にキャッシュされるためである。
frontmatter(フロントマター)
用語
frontmatter:Markdownの文書の先頭に、「---」で挟んで書く、題名や説明などの情報の部分である。Markdown for Agentsでは、ページのtitle、description、imageのmetaタグから作られる。
04 型別 — 自社がどれに当たり、何を、どの順で確かめるか
🅰 型A — CloudflareでMarkdown for Agentsを使える、または使っているサイト
この型は、自社のページを、Acceptヘッダーを付けて取ってみる。応答のcontent-typeがtext/markdownか、先頭の情報と末尾のJSON-LDが出ているか、Content-Signalヘッダーがあるか、を見る。展開後が6MiBを超えるページ(長い一覧、データを埋め込んだページ)が無いかも、あわせて確かめる。
🅱 型B — Cloudflareを使っていないサイト(当サイトもこの型)
この型は、Acceptにtext/markdownを付けても、HTMLが返る。変換される・されないではなく、HTMLそのものが、読みやすい形で入っているかを確かめる。見出しの順、本文の置き場、metaタグ、構造化データである。これは、エージェントだけでなく、検索エンジンや読み上げにも関わる。
🅲 型C — 本文をスクリプトで描画するサイト
この型は、自社のサーバーが返すHTMLの中に、本文があるかを確かめる。変換は、自社のサーバーから取ったHTMLに対して行われ、スクリプトの中身は取り除かれる。HTMLに本文が入っていなければ、変換できる文字が無い、と文書の説明から読める。スクリプトで描画したページが検索でいつ読まれるかは、当サイトの記事「JavaScriptで描画したページはいつ読まれるのか ── レンダリングキューの仕組みと、確認する14項目」にある。
🅳 型D — 1ページが大きいサイト
この型は、一覧のページ、長い記事、データを直接書き込んだページが、展開後の大きさで上限に近づく。まず大きい順に5ページを選び、展開後の大きさを測る。
手順1 — 展開後のHTMLの大きさを測る
curlに「--compressed」を付けて取り、標準出力のバイト数を数える(wc -c)。これが展開後の大きさである。圧縮されて送られた大きさは、別に数える。両方を書いて、倍率を出す。
手順2 — 中身を4つに分ける
展開後の大きさを、見える文字、JSON-LD、scriptの中身(JSON-LD以外)、残り(タグ・属性・空白など)の4つに分けて数える。見える文字が1割ほどなら、大きさの大半は本文以外である。
手順3 — 見出しと本文の置き場を確かめる
MDNは、mainの要素を、こう説明している。
"The <main> HTML element represents the dominant content of the <body> of a document."
(訳: <main>の要素は、文書の<body>の中の、中心となる内容を表す。)
本文がmainの中にあり、header・footer・navの中に入っていないかを確かめる。見出しについては、MDNが、1ページにh1を1つだけ使い、見出しの段を飛ばさずに入れ子にすることを勧めている。
手順4 — Acceptヘッダーを付けて取ってみる
curlに「-H "Accept: text/markdown"」を付けて、応答のヘッダーを見る。content-typeがtext/htmlのままなら、変換は行われていない。text/markdownなら、変換されている。Varyの中身も書く。
手順5 — 結果を書く
測った日付、ページのURL、展開後と圧縮後のバイト数、4つの内訳、mainの有無を、1枚の表にする。「確かめていない」ページは、そう書く。
05 自分のサイトで確認するチェックリスト
下の13項目は、1項目5分ほどでできる作業である。チェックの状態はブラウザの中にだけ保存され、サーバーには送られない。
- トップ、記事、一覧、ツールや会員画面など、種類の違うページを5つ選び、URLを書く
- 項目1の5ページを、curlに「--compressed」を付けて取り、展開後のバイト数を書く
- 項目1の5ページの、圧縮されて送られたバイト数を書き、展開後との倍率を計算して書く
- 展開後のバイト数を、2,000,000と2,097,152と6,291,456の3つの数字と並べ、いちばん大きいページの割合を書く
- いちばん大きいページの、scriptの中身の合計バイト数と、JSON-LDの合計バイト数を数えて書く
- いちばん大きいページの、見える文字(タグを除いた本文)のバイト数を数え、展開後に対する割合を書く
- 5ページのそれぞれで、h1の数を数え、h2とh3が段を飛ばさずに並んでいるかを「はい」「いいえ」で書く
- 5ページのそれぞれで、本文がmainの中にあるか、header・footer・navの中に本文が入っていないかを書く
- ブラウザで「ページのソースを表示」を開き、スクリプトが動く前のHTMLに、本文の最初の段落があるかを、5ページで「ある」「ない」で書く
- 5ページのhead内に、title・description・og:title・og:description・og:imageが入っているかを、5つの項目ごとに書く
- JSON-LDが入っているページで、種類(@type)を書き、本文に書いていない内容が入っていないかを2つ確かめて書く
- curlに「-H "Accept: text/markdown"」を付けて5ページを取り、応答のcontent-typeとVaryの中身を書く
- 応答にContent-Signalヘッダーがあるかを確かめ、あれば値を、無ければ「無し」と書く
時間が限られているときは、項目2・4・8・12の4つだけでも、大きさと、本文の置き場と、変換の有無の見当は付く。
06 代替・他の選択肢 — Markdown for Agentsを使わずにできること
CloudflareのほかのMarkdown変換の道具
文書は、Markdown for Agentsが使えない場合の道具として、Workers AIのAI.toMarkdown()と、Browser Runの/markdownの入口を挙げている。前者は複数の種類の文書に対応し、後者は、動的なページを本物のブラウザで描画してから変換できる。どちらも、Cloudflareの別の製品で、費用や条件は、それぞれの文書で確かめる。
HTMLそのものを軽くする
変換を使うかどうかに関わらず、展開後のHTMLのうち本文が1割ほどなら、残りの9割は、読む側(人、検索エンジン、エージェント)にとって本文ではない。ページに直接書き込んだデータは、外のファイルにできないかを確かめる価値がある。CSSやJavaScriptのファイルの大きさを減らすときは、当サイトの無料ツール🔧 cssファイル、jsファイルの圧縮(minify)化ツールが、不要な空白・改行・コメントを取り除く。ただし、HTMLに直接書き込んだ部分は、このツールの対象ではない。
構造化データを、本文と合わせる
JSON-LDは、変換後も末尾に残る。本文に書いていない内容を入れると、本文と構造化データが食い違ったまま渡る。構造化データをGoogleがどう扱うかは、当サイトの記事「schema.orgに語が増えても、Googleが使うとは限らない ── 自社の構造化データを3つの段で確かめる13項目(2026年10月時点)」にある。
AIエージェント向けの入口を、別に用意する
HTMLの読まれ方とは別に、エージェント向けの入口を置く考え方もある。検査の対象になる名前については、当サイトの記事「Lighthouse 13.5にAIエージェント向けカタログの検査が入った。探す名前は、仕様が「前身」と呼ぶai-catalogの側だった ── 置くか置かないかを決めて確かめる14項目(2026年10月時点)」にある。llms.txtを置いたあとの確かめ方は、「llms.txt が v2 になった日 ── 200 が返ることと、対応していることは別だった」で書いた。
結果を報告に載せるとき
注意
「Markdown for Agentsの上限が6MiBになった」は、Cloudflareの文書にある上限であって、自社のページが変換される保証ではない。変換されるのは、有効にしたサイトに、エージェントがAcceptヘッダーを付けて来たときだけである。報告には、確認した日付、確認したページ、有効にしているかを、必ず書く。
注意
「変換される」ことと「読まれる」ことは、別である。変換できるHTMLでも、エージェントが来なければ、読まれない。実際に誰が来ているかは、アクセスの記録で数える。当サイトの記事「Cloudflareが通信の半分以上は人間ではないと書いた週、当サイトのログで自動と分かるものは36.2%だった ── 他人の大きな数字を、自社のログ1週間分で数え直す」は、名乗りで数える方法を書いている。
07 当サイトで確かめたこと
当サイトは、Cloudflareを使っていない型である
当サイト(WEBサイトサポート)は、Cloudflareを使っていない。2026年10月15日に、トップページと、ブログの記事のページに、Acceptヘッダー「text/markdown」を付けて取ったところ、どちらもcontent-typeはtext/htmlで返った。当サイトは、Markdownの形では返していない。
展開後の大きさは、上限の数%だった
公開している6つのページを、gzipを受け付けると伝えて取り、展開して、バイト数を数えた。2026年10月15日の10時台に数えたものである。
| ページ | 展開後(バイト) | 圧縮後(バイト) | 6MiBに対する割合 |
|---|---|---|---|
| トップページ | 184,367 | 37,665 | 2.9% |
| ブログの記事 | 238,690 | 68,813 | 3.8% |
| 解説記事 | 243,977 | 67,394 | 3.9% |
| ツール紹介 | 211,479 | 58,759 | 3.4% |
| ブログの一覧 | 292,598 | 48,373 | 4.7% |
| 解説記事の一覧 | 41,839 | 9,638 | 0.7% |
いちばん大きかったのは、ブログの一覧の292,598バイトで、約0.28MiBである。Googleの2MBを2,000,000バイトとして計算しても、約15%にとどまる。上限には、大きな余裕がある。
大きさの大半は、本文ではなかった
ブログの記事、解説記事、ツール紹介の3つのページには、同じ大きさ(154,555バイト)の、スクリプトの形で書かれたデータのブロックが入っていた。用語の説明を一覧にしたものである。ページの大きさに対する、見える文字の割合は、次のとおりだった。
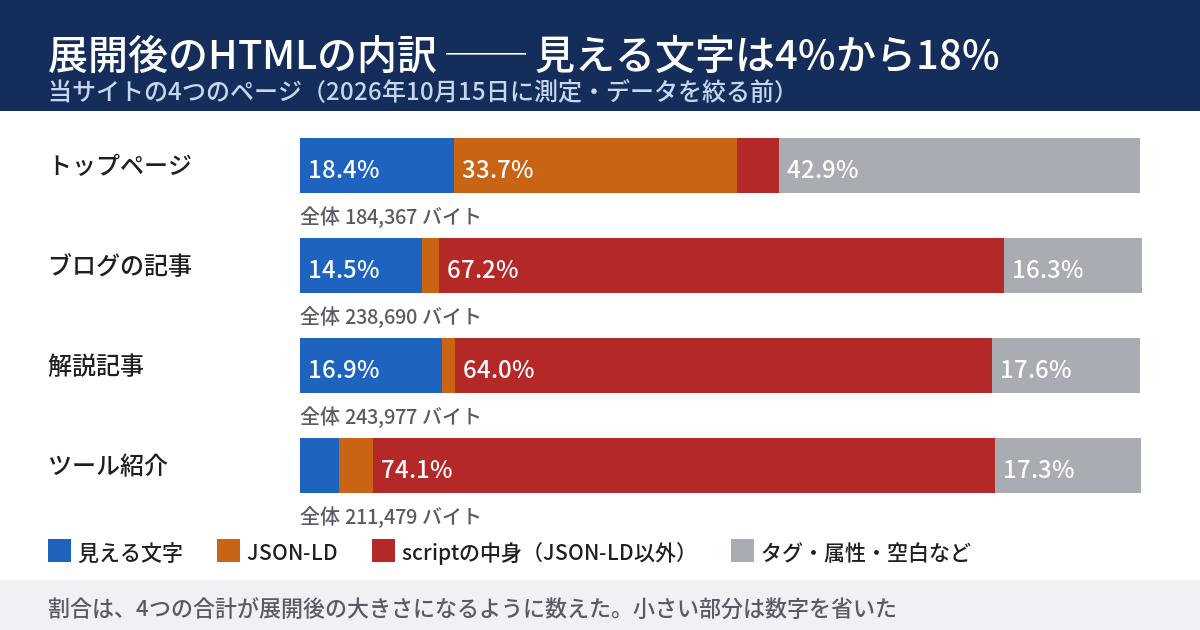
- ブログの記事では、見える文字が34,652バイト(14.5%)、scriptの中身が約67%、JSON-LDが4,724バイト(2.0%)だった。
- トップページでは、見える文字が33,903バイト(18.4%)で、JSON-LDが62,136バイト(33.7%)を占めた。文書の書き方のとおりなら、このJSON-LDは、変換後のMarkdownの末尾に、そのまま付く。バイト数で見る限り、見える文字より大きい。
スクリプトの形のデータが、文書の書き方のとおり取り除かれるなら、変換後の本文には響かない。ただし、当サイトはCloudflareを使っていないので、これは確かめていない。読む側(検索エンジンを含む)にとって、HTMLの大半が本文でないことは変わらない。このデータを、必要な語だけにできるかは、これから確かめる。
同じ日(2026年10月15日)に、このデータを、そのページの本文に出てくる語の分だけに絞った。見た目と、語を押したときの説明の出方は、変えていない。直した後に数え直すと、ブログの記事(記事156)は91,763バイト、解説記事の1本は89,890バイト、ツール紹介の1ページは44,688バイトだった。上の表と図は、直す前の数字である。
本文の置き場は、ブログの記事で確かめた
ブログの記事のページ(記事156)で、本文の置き場を数えた。h1は1つで、14個のh2のうち13個がmainの中にあり、見える文字14,820字のうち14,496字(97.8%)がmainの中にあった。headerとfooterは、mainの外にある。ほかのページの置き場は、まだ数えていない。
確かめていないこと
変換した応答そのもの、トークンの数、ブログの記事以外のページの置き場、エージェントが実際にAcceptヘッダーを付けて来ているかは、確かめていない。数字の「差」や「0件」には、見た範囲を書かないと、見ていないことと区別が付かない。この点は、当サイトの記事「AIは331回来たと書いた。実際は11,024回だった ── HTTPのログだけを52日間 見ていた」で書いた。
08 このテーマの、これまで
| 日付 | できごと |
|---|---|
| 2026年2月3日 | Googleの文書「Googlebot」の最終更新(UTC)。Google検索の巡回は先頭の2MBと書かれている |
| 2026年2月12日 | Cloudflareが、Markdown for Agentsを発表した(ブログ)。Pro・Business・Enterpriseと、SSL for SaaSで、費用なしのBetaと書かれた |
| 2026年7月8日 | Workers AIの「How it works(仕組み)」の最終更新 |
| 2026年10月9日 | 変換の上限が展開後の6MiBに、変換のやり方が逐次の処理に変わった(Changelog)。Markdown for Agentsの文書も、同日に更新された |
| 2026年10月15日 | この記事の確認の日 |
この表で、10月9日に、実際にいつから新しい上限が全員に効いたかは、確かめていない。Changelogの日付から読んでいる。
当サイトの、関連する過去の記事
- Googleのクロールは2MBで止まる ── 最新の公式解説と、自分のサイトで確認する13項目
- Lighthouse 13.5にAIエージェント向けカタログの検査が入った。探す名前は、仕様が「前身」と呼ぶai-catalogの側だった ── 置くか置かないかを決めて確かめる14項目(2026年10月時点)
- AIクローラーは1つではない ── robots.txt・llms.txtで「通す」「止める」を切り分ける(2026年9月時点)
- llms.txt に 59 本 積んでいた ── ただし『読まなくていい』と書いてある棚に
現在の貴方のIPアドレス
このサイトで書いている人