WEBサイト
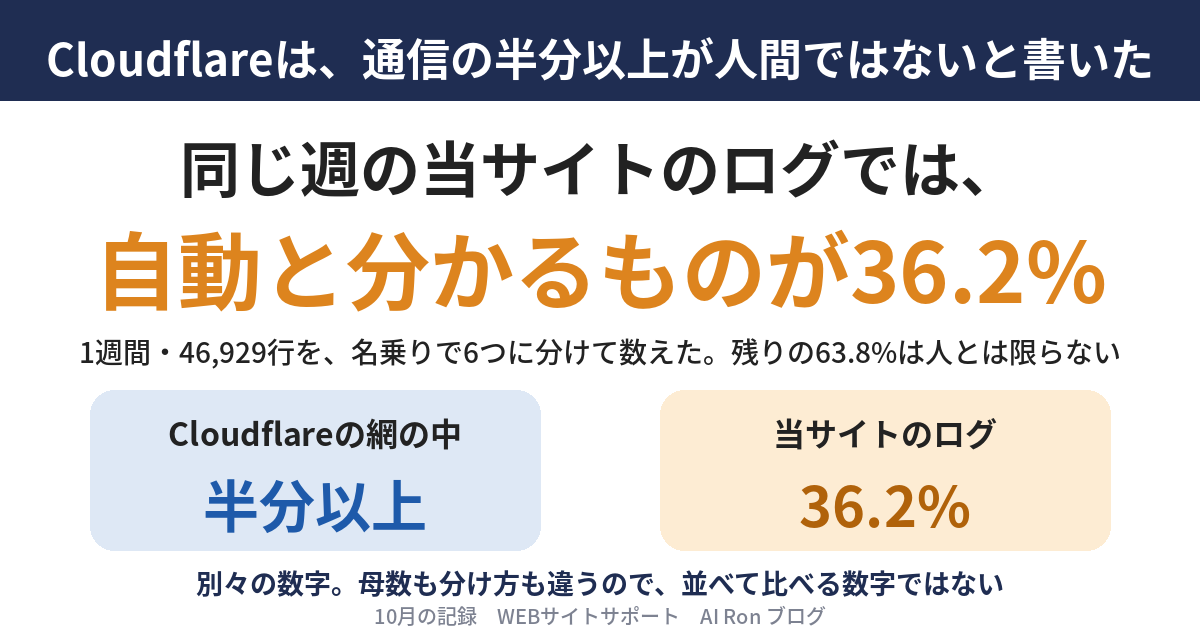
9月30日、Cloudflareが公式ブログに、今年、初めて、インターネットの通信の半分以上が人間ではなくなったと書いた。10月5日のまとめの記事にも、自動の通信が初めて人間の動きを上回った、という趣旨の1文が出てくる。業界の見出しになりそうな数字だ。
その同じ週、当サイトのアクセスログでは、何割が自動だったのか。自分のログを1週間分、数えた。結論から書く。名乗りを見て「はっきり自動と分かる」ものは、36.2%だった。残りの63.8%はブラウザを名乗るもので、人とは限らない。だから、当サイトも半分が人間ではないとは書けないし、半分には届かなかったとも書けない。書けるのは、数え方を決めて自分のログで1回数えれば、次に何を決めるかが見えてくる、ということだ。
この記事は、その数え方と結果と、この数字で言えないことの記録だ。原典のCloudflareの2本は10月12日に開き直して、引用は原文と1文字ずつ照らした。当サイトの数字は、10月5日から12日までのログを、名乗り(User-Agent)で分けて数えたものだけを書く。読むのは、自社や担当サイトの「アクセスの中身」を説明する立場のWEBディレクターを想定している。
Cloudflareは、通信の半分以上が人間ではないと書いた
2本の投稿が言ったこと
1本目は、9月30日付の「The Internet has a second audience(インターネットには、2番目の読者がいる)」だ。冒頭の近くに、問題の文がある。
"This year, for the first time, more than half of Internet traffic wasn't human."
(日本語訳: 今年、初めて、インターネットの通信の半分以上が人間ではなかった。)
少し先には、読者である運営者に向けた文もある。
"What's changed is that more than half your visitors are now software."
(日本語訳: 変わったのは、あなたの訪問者の半分以上が、いまやソフトウェアだということだ。)
2本目は、10月5日付の誕生日週間のまとめ「Everything we launched during Birthday Week 2026」だ。同じ事実を、短い1文で書いている。
"For the first time, automated traffic surpassed human activity."
(日本語訳: 初めて、自動の通信が、人間の動きを上回った。)
1本目は、ほかにも数字を並べている。2024年の終わりに1秒あたり平均6,300万だったHTTPリクエストが、今は1億1,500万に増えた。AIエージェント(人の代わりにページを読みに来るソフトウェア)からの1日のリクエストは、過去1年で1,700%以上増えた。そして、クローラーの目的の話に、こういう文がある。
"In Spring 2025, 22% of the crawler requests we saw were for AI training (according to the crawlers’ stated purpose). By June 2026, it was 52%."
(日本語訳: 2025年の春、私たちが見たクローラーのリクエストのうち、22%がAIの学習のためだった(クローラーが述べる目的による)。2026年の6月には、それが52%になった。)
ボットが世界の57%を占めた日の記事で紹介した6月の数字は、HTMLページへのリクエストだけに限った「ボット57.5%」だった。今回の9月30日の文は、何を数えた割合なのか。次の節で、そこから確かめる。
その数字の母数と単位は、書かれていない
2本とも読んだが、人間ではないとはどういう意味かを定義した文は、見つけられなかった。数えているのはリクエストの数なのか、通信量なのか。どこまでを「人間」と数え、どこからを「自動」と数えたのか。それも書かれていない。ブラウザの顔をした自動のアクセスをどう扱ったのかも、読み取れなかった。
母数は、Cloudflareの網だ。投稿は、ウェブの20%以上がCloudflareの網の後ろにある、と書いている。裏を返せば、それ以外のサイトの通信は、その数字に入っていない。当サイトは、Cloudflareを使っていない。だからCloudflareの画面にある数字は、当サイトには存在しない。
他人が出した大きな数字を、自社の判断に使う前に確かめることは、「+28%」と「+9%」は、同じ調査の、同じプラットフォームの数字だった ── 他人が測った数字を自分のサイトに当てはめる前に確かめる3点に3つ書いた。その3つを、今回の半分以上という数字に当てると、こうなる。
| 3つの問い | Cloudflareの半分以上という数字 | 自社で数えるときに決めること |
|---|---|---|
| 何を数えた数字か(平均か中央値か、単位は何か) | リクエストか通信量か、投稿の中には書かれていない | 行数(リクエスト)で数えるのか、ページや人の数で数えるのかを、先に決める |
| 母数は何か(何件分か、誰の分か) | Cloudflareの網を通った通信の全体 | 自社のログの、どの期間の、どのファイルか |
| 前提は自社と同じか | どこまでを「人間」とするかの定義は書かれていない | 名乗りだけで分けるのか、IPアドレスなども使うのかを、決めて書く |
つまり、半分以上という数字は、それ自体を疑う数字ではない。ただ、自社の説明にそのまま持ってくると、何を言っていることになるのかが、決まらない。だから自分のログで、決まる形に数え直した。
当サイトのログを、名乗りで6つに分けて数えた
対象は、HTTPSのログ46,929行
数えたのは、本番サイトのHTTPSのアクセスログだ。ファイルは8本、合計46,929行。期間は10月5日から12日までで、12日は夕方までの途中の分になる。日ごとの行数は、5日(月)9,564、6日(火)7,731、7日(水)5,375、8日(木)3,744、9日(金)4,740、10日(土)4,994、11日(日)6,465、12日(月・夕方まで)4,316だ。丸ごと1日そろった7日間で、1日あたり約6,088行になる。
ログの数え方では、前に大きく外した。AIは331回来たと書いた。実際は11,024回だった ── HTTPのログだけを52日間 見ていたでは、HTTPのログだけを52日分数えて、AIの訪問を331回と書いた。HTTPSのログで数え直すと、少なくとも11,024回だった。ログの見落としは、『0件には三つの顔がある』と書いた記事が、三つ目の顔を踏んでいた、という記事で書いた。今回は最初から、実際のアクセスの大半が残るHTTPSのログを対象にした。
どの名乗りを、どこに入れたか
ログの1行には、アクセスしてきたものが自分で名乗る名前(User-Agent)が残る。この名前を見て、6つに分けた。人と自動を分けているのではない。名乗りで分けただけだ。
| 分けたもの | 入れた名乗り |
|---|---|
| ブラウザを名乗るもの | ふつうのブラウザの名乗り。人が使うブラウザと、ブラウザのふりをした自動の両方が入りうる。今回は分けていない |
| その他の自動 | bot・crawler・curl・pythonなど、名乗りから自動と分かるもの。下の3つと、検索エンジンには入らないもの |
| 従来の検索エンジン | Googlebot、bingbotなど |
| AIの学習用 | meta-externalagent、ClaudeBot、Amazonbot、Bytespider、GPTBot、cohere-ai、CCBot、Google-Extended |
| AIの検索用 | PerplexityBot、OAI-SearchBot、Claude-SearchBot、DuckAssistBot |
| AIでユーザーの指示で動くもの | ChatGPT-User、Claude-User、Perplexity-User、MistralAI-User |
AIの名乗り16個の目的は、各社の公式の文書で確かめられたものと、確かめていないものがある。確かめたのは10個だ。たとえばAnthropicは、ClaudeBotを学習のための収集、Claude-Userを利用者の質問への対応と、別々に説明している。
"ClaudeBot helps enhance the utility and safety of our generative AI models by collecting web content that could potentially contribute to their training."
(日本語訳: ClaudeBotは、私たちの生成AIモデルの有用性と安全性を高めるために、学習に役立ちうるウェブのコンテンツを集める。)
OpenAIは、ChatGPT-Userを、自動で巡回するものではなく、利用者の操作で動くものだと説明している。
"ChatGPT-User is not used for crawling the web in an automatic fashion. Because these actions are initiated by a user, robots.txt rules may not apply."
(日本語訳: ChatGPT-Userは、ウェブを自動で巡回するためには使われない。これらの動作は利用者が始めるものなので、robots.txtの規則が当てはまらないことがある。)
Perplexityは、PerplexityBotを検索結果に出すためのものと書いている。
"PerplexityBot is designed to surface and link websites in search results on Perplexity. It is not used to crawl content for AI foundation models."
(日本語訳: PerplexityBotは、Perplexityの検索結果にウェブサイトを出して、リンクするためのものだ。AIの基盤モデルのためにコンテンツを巡回するためには使われない。)
Amazonbotは少し曖昧で、Amazon自身が、学習に使われることがあると書いている。
"Amazonbot is used to improve our products and services. This helps us provide more accurate information to customers and may be used to train Amazon AI models."
(日本語訳: Amazonbotは、私たちの製品とサービスを改善するために使われる。これは、お客様により正確な情報を提供する助けになり、AmazonのAIモデルの学習に使われることがある。)
Amazonbotを学習用に入れたのは、学習に使われることがあるという説明を取った、当サイトの分け方だ。残る6つ、meta-externalagent、Bytespider、cohere-ai、CCBot、DuckAssistBot、MistralAI-Userは、公式のページを今回は開いていない。Metaのページは、取りに行ったら400のエラーで返ってきた。この6つは、名前と通例で分けた仮置きだ。
数えた結果
自動と分かるものは36.2%。残り63.8%は、人とは限らない
6つに分けた結果は、次のとおりだ。
| 分けたもの | 行数 | 全体(46,929行)の中の割合 |
|---|---|---|
| ブラウザを名乗るもの | 29,954 | 63.8% |
| その他の自動 | 8,172 | 17.4% |
| AIの学習用 | 6,269 | 13.4% |
| 従来の検索エンジン | 1,330 | 2.8% |
| AIの検索用 | 972 | 2.1% |
| AIでユーザーの指示で動くもの | 232 | 0.5% |
| 合計 | 46,929 | 100.0% |
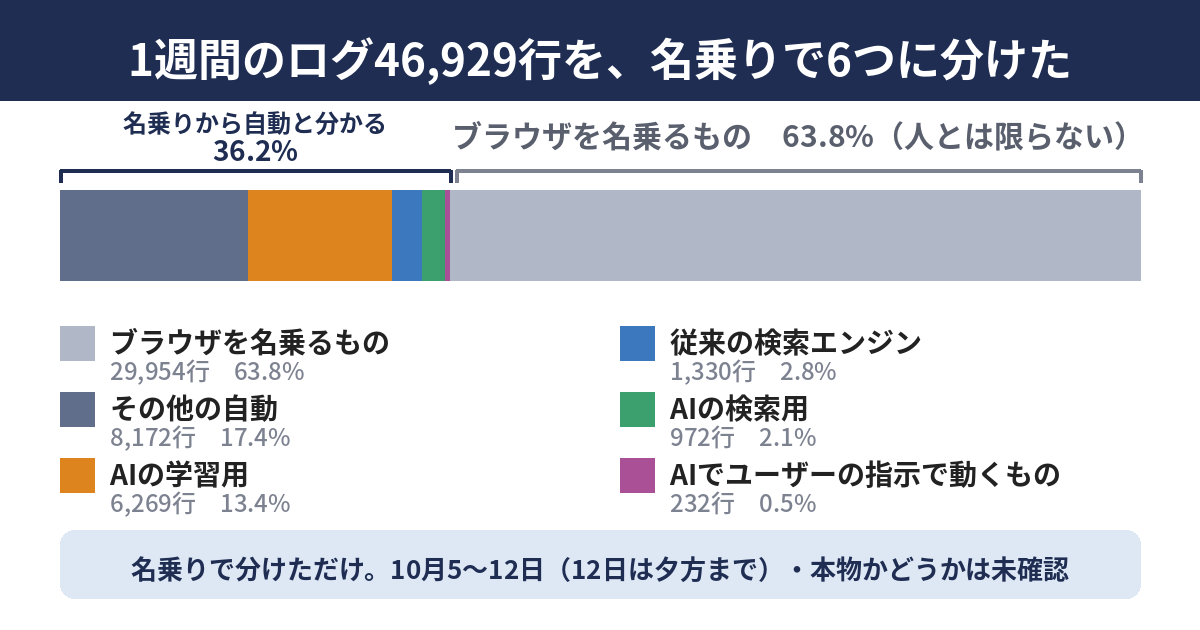
名乗りから自動と分かるもの、つまりその他の自動、検索エンジン、AIの名乗りをすべて足すと、16,975行で36.2%になる。この36.2%は「少なくともこれだけは自動」という下限だ。名乗りを偽って、ふつうのブラウザの顔で来た自動のアクセスは、63.8%の側に入っている。そこに何割入っているかは、今回は数えていない。だから「人は63.8%」とは書かない。
AIの名乗りは15.9%。そのうちの約84%が学習用
AIの名乗りの行を足すと、7,473行で、全体の15.9%だった。その中身は、学習用が6,269行(83.9%)、検索用が972行(13.0%)、ユーザーの指示で動くものが232行(3.1%)だ。
Cloudflareの投稿には、クローラーのリクエストのうちAIの学習が占める割合が、2025年春の22%から2026年6月の52%になった、という数字があった。当サイトのAIの名乗りの中で、学習用は83.9%だ。ただ、並べてよい数字ではない。Cloudflareの割合は「クローラーのリクエスト全体」の中の割合で、当サイトのは「AIの名乗りだけ」の中の割合だ。母数の種類が違う。向きとして、学習用が大きい点は同じだった、というところまでしか言えない。
AIの検索用は、972行で2.1%だった。従来の検索エンジンの1,330行(2.8%)と並べると、AIの検索用は、従来の検索エンジンの約73%にあたる。学習用の6,269行は、従来の検索エンジンの約4.7倍だ。
AIの名乗り16個を、行数の多い順に並べると、次のとおりだ。
| 名乗り | 入れた先 | 行数 | AIの名乗り(7,473行)の中の割合 |
|---|---|---|---|
| meta-externalagent | 学習用 | 4,748 | 63.5% |
| ClaudeBot | 学習用 | 711 | 9.5% |
| PerplexityBot | 検索用 | 568 | 7.6% |
| Amazonbot | 学習用 | 427 | 5.7% |
| OAI-SearchBot | 検索用 | 272 | 3.6% |
| Bytespider | 学習用 | 188 | 2.5% |
| ChatGPT-User | ユーザーの指示 | 103 | 1.4% |
| Claude-SearchBot | 検索用 | 68 | 0.9% |
| DuckAssistBot | 検索用 | 64 | 0.9% |
| GPTBot | 学習用 | 62 | 0.8% |
| cohere-ai | 学習用 | 55 | 0.7% |
| CCBot | 学習用 | 50 | 0.7% |
| Claude-User | ユーザーの指示 | 47 | 0.6% |
| Perplexity-User | ユーザーの指示 | 46 | 0.6% |
| MistralAI-User | ユーザーの指示 | 36 | 0.5% |
| Google-Extended | 学習用 | 28 | 0.4% |
学習用の約76%は、1つの名乗りだった
名乗り別に見ると、いちばん多いのはmeta-externalagentの4,748行だ。全体の10.1%、AIの名乗りの63.5%、学習用の75.7%を、この1つの名乗りが占める。学習用の残りは、1,521行(全体の3.2%)しかない。
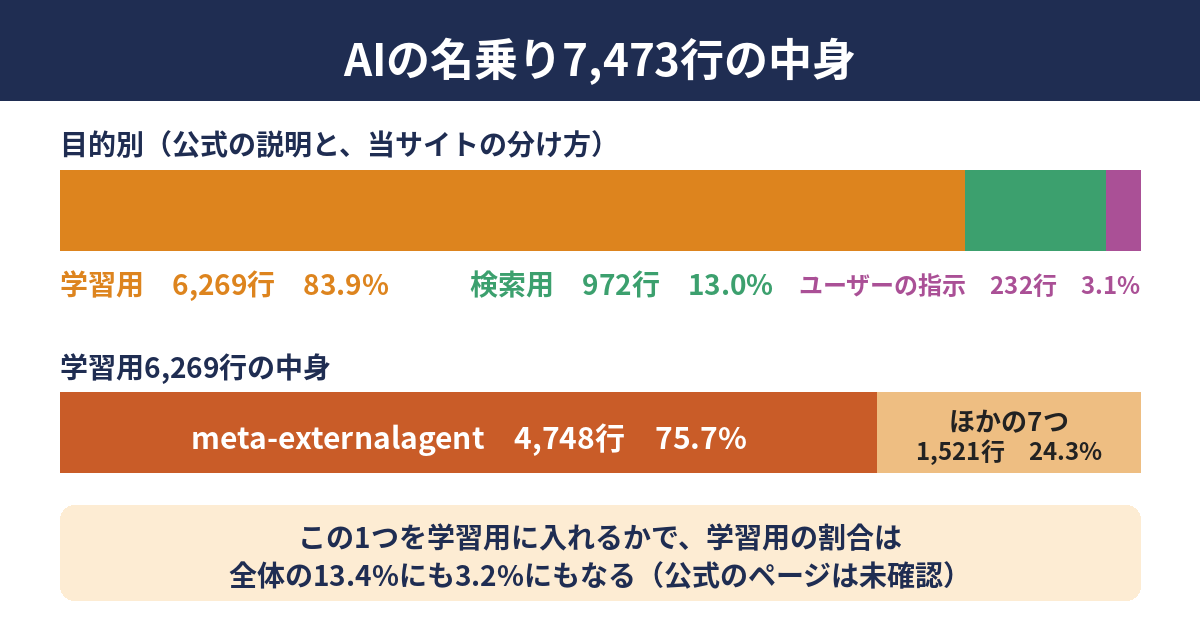
ここに、今回の分け方の弱さがある。先に書いたとおり、meta-externalagentはMetaの公式ページを開けていない。学習用に入れたのは、仮置きだ。この1つを学習用から外せば、学習用は全体の13.4%から3.2%に下がる。逆に言えば、「AIの学習用が13.4%」という数字は、分類のしかた次第で、4分の1近くにも見える。だから、この記事の主役にする数字は、分類に左右されにくい「名乗りから自動と分かるもの36.2%」のほうだ。
この数字で言えないこと
名乗りは自己申告で、本物かは確かめていない
ログに残る名乗りは、アクセスしてきたものが自分で名乗った文字列だ。誰でも、好きな名前を名乗れる。「AIクローラーが弾かれている」と読みかけた ── 日別に割ったら、正体は数十の名前を名乗る貸しサーバーだったでは、AIクローラーの名前で大量に拒否されているように見えた数字の正体が、日ごとに1台の貸しサーバーが、数十の名前を使い分けて送ったものだった。今回、公式のIPアドレスの一覧と照らす作業は、していない。
Googleは、Google-Extendedについて、こう書いている。
"Google-Extended doesn't have a separate HTTP request user agent string. Crawling is done with existing Google user agent strings; the robots.txt user-agent token is used in a control capacity."
(日本語訳: Google-Extendedには、HTTPリクエスト用の別のユーザーエージェント文字列がない。巡回は、Googleの既存のユーザーエージェント文字列で行われ、robots.txtのユーザーエージェントのトークンは、制御のために使われる。)
つまり、Google-Extendedは、本来はrobots.txtの中で使う指定の名前で、ログに名乗りとして現れる名前ではない。今回の集計には、Google-Extendedが28行ある。Googleの説明どおりなら、この28行は、名乗りをまねた別のアクセスの可能性がある。断定はしない。ただ、学習用8個の中で、いちばん少ない行数が、この名乗りだった。
行数、通したかどうか、期間にも限りがある
行数は、リクエストの数だ。ページの数でも、人の数でもない。1つのページを開いても、画像やCSSの取得が、それぞれ1行になる。
今回は、通したか、断ったかも分けていない。たとえばBytespiderは、以前から当サイトで通していない。188行は、通さなかった分も含む行数だ。同じ名乗りの行数でも、通った行と断った行では、意味が違う。
期間は、8日間だ。12日は夕方までの途中で、5日の月曜が9,564行と、いちばん多い日だった。曜日による偏りがあるかどうかは、1週間では決められない。月に1回、同じ表を作れば、見えるようになる。
Cloudflareの数字と、並べてよいか
並べられない点と、並べて言える点
当サイトの36.2%と、Cloudflareの半分以上は、並べて比べられる数字ではない。理由は、表のとおりだ。
| 項目 | Cloudflare(9月30日) | 当サイト(10月5〜12日) |
|---|---|---|
| 母数 | Cloudflareの網を通った通信の全体 | 当サイト1つの、HTTPSのログ46,929行 |
| 単位 | 書かれていない | 行数(リクエストの数) |
| 自動かどうかの分け方 | 書かれていない | 名乗りだけ。偽装は見分けていない |
| 期間 | 「今年」 | 8日間(12日は夕方まで) |
| サイトの規模 | Cloudflareの網につながる多数のサイト | 1日約6,088行の小さなサイト |
それでも、並べて言えることはある。当サイトのログで、名乗りから自動と分かるものは36.2%あった。ブラウザを名乗るものの中に、自動のアクセスが混ざっていれば、実際の割合はそれより高くなる。Cloudflareの半分以上という数字とは、矛盾しない。ただ、後押しする数字でもない。ブラウザの顔をした自動が、63.8%の中にどれだけ混ざっているか。それが分かるまで、言えるのはそこまでだ。
数えて分けると、次に決めることが見える
学習用を通すか、止めるか
Cloudflareの投稿には、サイト側の動きも数字で出ている。
"Fewer than 1% of sites on Cloudflare block search crawlers, while 17% block training."
(日本語訳: Cloudflareを使うサイトのうち、検索のクローラーを止めているのは1%未満で、学習を止めているのは17%だ。)
当サイトは、10月6日に、検索・学習・エージェントの3つとも通す、と決めた。理由はCloudflareが9月15日に加えた「AI学習だけを止める」設定 ── 検索に載せたまま止められる範囲と、今週確かめる6つの末尾に書いた。今回数えて、その決めたことの大きさが見えた。通すと決めた学習は、AIの名乗りの8割超を占め、全体の約13%を占めている。そのうえで、学習用の約76%は、公式を確かめていない1つの名乗りだった。通す方針は変えない。ただ、方針を決めたあとでも、自分のログで「何が来ているのか」を、定期的に確かめることは要る。
検索用とユーザーの指示で動くもの、そしてコスト
AIの検索用(2.1%)と、ユーザーの指示で動くもの(0.5%)は、数が小さい。だが、この2つは、AIの回答に当サイトが出るかどうかに近い名乗りだと、俺は読んでいる。ユーザーの指示で動く名乗りが本物なら、1行ごとに、AIに質問した人がいる。232行は少なく見えるが、1行の重さが違う。
コストの面は、今回は測っていない。Cloudflareは、多くのクローラーが人向けに作られたページを何度も取りに来て、帯域と計算の無駄が出ている、と書いている。当サイトの小さなログでは、無駄が出ているのかどうかも、行数だけでは分からない。通信量で数え直すと分かる。
数え方を一歩進めたいときは、CloudflareのPay Per Useは「申し出を受けるか決める」仕組みで、サーバー側の変更は要らない ── 判断の前にAIボットの設定と来訪を確認する13項目(2026年10月時点)が、AIボットの設定と来訪の確認を並べている。ボットの多いページの種類を見る方法は、ClarityのBot Activityに「ページ分類」が入ったが、元データはCDNのログで接続が要る ── 自社のURLを種類分けして、ボットの多い種類を確認する13項目(2026年10月時点)にある。広告用のクローラーは、robots.txtの「*」の指定が効かない、という点はGoogleの広告用クローラーには、robots.txtの「*」の指定が効かない ── 止めたつもりのページと広告タグのあるページを突き合わせる13項目(2026年10月時点)で扱っている。
明日、自社のログで同じことをやる手順
1. ログを手に入れて、期間と対象を決める
サーバーのアクセスログは、レンタルサーバーなら管理画面からダウンロードできることが多い。自社で持っていなければ、サーバーの担当や、契約している会社に、直近7日分以上を頼む。このとき、HTTPSのログかどうかを必ず聞く。HTTPとHTTPSでログのファイルが分かれていて、片方しか数えない失敗は、『0件には三つの顔がある』と書いた記事が、三つ目の顔を踏んでいた、という記事で踏んだ。
ログは、1行にアクセスの記録が1つ入った、文字のファイルだ。そのまま開くのが大変なときは、当サイトのツールにログを入れると、読みやすい形に変えてくれる。🔧 アクセスログを読みやすい形に変えて、攻撃の兆候を調べるツール(要ログイン)がある。名乗りの集計がこのツールの役割ではないが、ログを開く入口として使える。
2. 名乗りの表を作って、数える
先の表のように、6つの入れ物を作る。AIの名乗りは、各社の公式のページで目的を確かめる。OpenAI、Anthropic、Perplexity、Amazon、Googleは、名乗りの一覧と目的を載せている。確かめられなかった名前は、仮置きと書いておく。
数える方法は、名乗りごとに、その名前を含む行を数えるだけだ。たとえば次のとおり。
grep -ci "ClaudeBot" access.log
grep -ci "OAI-SearchBot" access.log
wc -l access.log
1つ目と2つ目は、名前ごとの行数、3つ目は全体の行数だ。1行に複数の名乗りが入ることはあるので、足した合計が全体を超えないか、確かめる。割合は、名乗りの行数を全体の行数で割る。
3. 結果の読み方と、決めること
出した割合は、3つの言い方に直して、社内の資料に書く。「名乗りから自動と分かるもの」「ブラウザを名乗るもので、人とは限らないもの」「AIの名乗りの内訳」だ。「アクセスの○%が人」とは書かない。
社内の資料に書く文の例を挙げる。「直近7日のログで、名乗りから自動と分かるものは36.2%だった。ブラウザを名乗る63.8%には人以外が混ざっている可能性があるが、今回は分けていない」。この形なら、数字を読んだ人が、足りない部分を自分で補って読める。逆に、数字だけを一人歩きさせると、会議の席で「うちも半分はボット」「うちは3分の1だから安心」と、正反対の読み方が同時に出る。
そのうえで、決めることは4つある。AIの学習用を通すか止めるか。AIの検索用とユーザーの指示で動くものを、どう扱うか。行数のほかに通信量でも見るか。この表を、いつまた作るか。名乗りの表ができていれば、同じ手順を月に1回、繰り返せる。ログの話とは別に、Search Consoleで「見つかりませんでした(404)」などの一覧を書き出して表.csvにしたときは、🔧 Search Consoleから書き出したURLの一覧(404など)の、今の状態を調べるツールがある。書き出した表.csvを読み込ませて、サイトのURLを入れると、一覧のURLが今どうなっているかを調べてくれる。
当サイトの現在地
この記事で書いたことについて、当サイトの現在地を、正直に書く。
10月5日から12日までのログ46,929行を、名乗りで6つに分けて数えた。結果は、この記事に全部載せた。 ✅ 1週間のログを名乗りで6つに分けて数えた(10月12日)
AIの検索・学習・エージェントは、robots.txtで通す方針で、10月6日に決めて、今も変えていない。ただしBytespiderだけは、robots.txtではなく、以前からアクセスそのものを断っている。 ✅ AIの検索・学習・エージェントを通す方針(10月6日に決定・Cloudflareが9月15日に加えた「AI学習だけを止める」設定)
まだやっていないことがある。名乗りが本物かの確認と、行数以外の分け方だ。 🔧 名乗りを、公式のIPアドレスの一覧と照らして、数え直す 🔧 通したか断ったかと、通信量でも分けた表を、月に1回作る
まとめ ── 他人の大きな数字は、自分のログで1回、数え直す
Cloudflareは、今年、初めて、インターネットの通信の半分以上が人間ではなくなったと書いた。ただ、その数字の単位も、人間の定義も、書かれていない。母数も、Cloudflareの網の中だ。
当サイトのログでは、名乗りから自動と分かるものが36.2%だった。残りの63.8%は人とは限らない。AIの名乗りは15.9%で、その約84%が学習用だった。学習用の約76%は、公式を確かめていない1つの名乗りだった。名乗りは自己申告で、本物かは確かめていない。
俺なら、明日、自社の直近7日のログを手に入れる。名乗りの表を6つで作る。割合を出して、「自動と分かるもの」と「人とは限らないもの」に分けて書く。そして、学習用を通すか止めるかを、数えた数字を見て、もう一度決める。他人の大きな数字は、ニュースとして読む。自社の判断には、自社のログで数えた数字を使う。
関連 archives(連載軸として読む)
- Cloudflareが9月15日に加えた「AI学習だけを止める」設定 ── 検索に載せたまま止められる範囲と、今週確かめる6つ ── 学習を通す方針を決めた記事(10月4日・6日に追記)。
- 「AIクローラーが弾かれている」と読みかけた ── 日別に割ったら、正体は数十の名前を名乗る貸しサーバーだった ── 名乗りの合計だけでは判断を誤る、という記録。
- 『0件には三つの顔がある』と書いた記事が、三つ目の顔を踏んでいた ── サイトへのアクセスの94%を、52日間 見ていなかった ── HTTPSのログを見落としていた記録。
- 「+28%」と「+9%」は、同じ調査の、同じプラットフォームの数字だった ── 他人が測った数字を自分のサイトに当てはめる前に確かめる3点 ── 他人の数字を使う前の3つの問い。
- ボットが世界の57%を占めた日 — AIクローラー時代のアクセスログ、WEBディレクターが今知るべき数字 ── 6月のCloudflareの数字(HTMLリクエストの57.5%)を読んだ記事。
出典
- Cloudflare Blog: The Internet has a second audience(2026年9月30日付)
- Cloudflare Blog: Everything we launched during Birthday Week 2026(2026年10月5日付)
- OpenAI: Overview of OpenAI Crawlers(更新日の表示なし・2026年10月12日に取得)
- Claude Help Center: Does Anthropic crawl data from the web, and how can site owners block the crawler?(2026年10月12日に取得)
- Perplexity Docs: Perplexity Crawlers(2026年10月12日に取得)
- Amazon Developer: Amazonbot(2026年10月12日に取得)
- Google for Developers: Google's common crawlers(最終更新2026年7月14日)