WEBサイト
CloudflareのPay Per Useは「申し出を受けるか決める」仕組みで、サーバー側の変更は要らない ── 判断の前にAIボットの設定と来訪を確認する13項目(2026年10月時点)
CloudflareのPay Per Useは「申し出を受けるか決める」仕組みで、サーバー側の変更は要らない ── 判断の前にAIボットの設定と来訪を確認する13項目(2026年10月時点)
目次
01 何が起きたか — 2026年9月30日、Pay Per Useがベータになった
公式ブログで公開された、Pay Per Useの中身
2026年9月30日、Cloudflareは公式ブログ「Pay Per Use」を公開し、Pay Per Useがベータになったと発表した。サイト運営者が持つ文章や画像などのコンテンツをAI企業が使ったとき、その対価をCloudflareが請求と精算を取りまとめて運営者に支払う仕組みである。入口の報道(Search Engine Journal)は、同じ日に始まったもう1つの仕組み「Monetization Gateway」とあわせて伝えている。
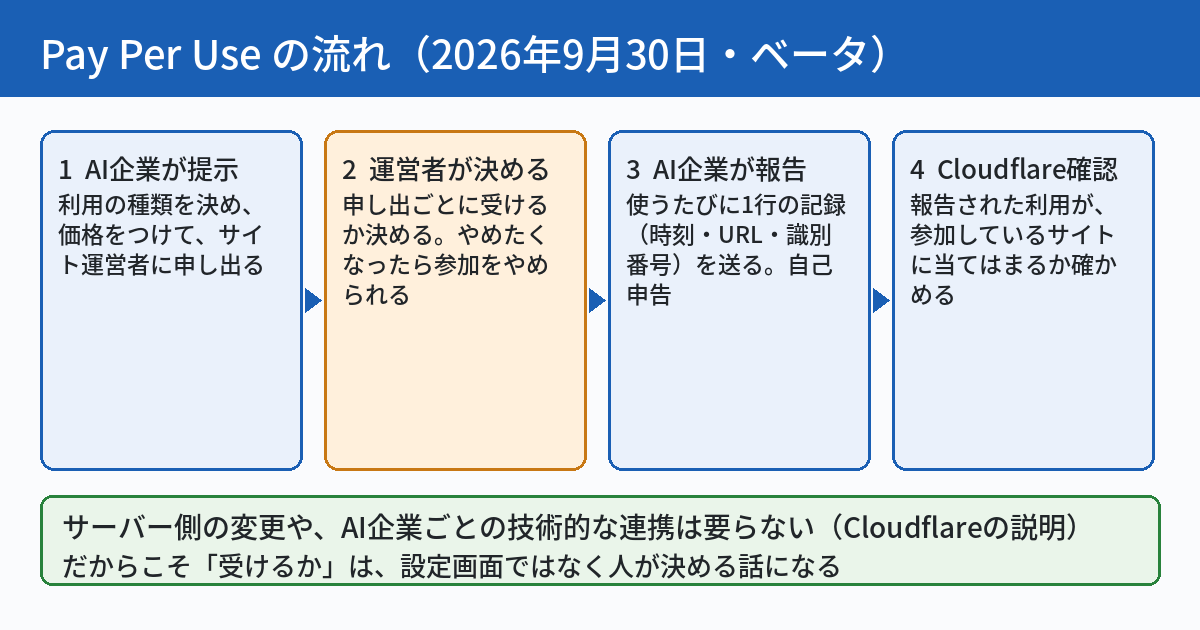
ブログの説明によると、流れは次のとおりである。AI企業(買い手)は、自社のクローラーをVerified bots(Cloudflareが「何者で何をしているか」を確かめたボット)として名乗り、お金を払う対象の「利用の種類」を自分で定義し、価格をつける。サイト運営者は、届いた申し出ごとに受けるかどうかを決める。そして買い手は、利用するたびに1行のJSONで報告する。
出典(Cloudflare公式ブログ)
"Pay Per Crawl, which we launched in 2025, charges for access. Pay Per Use pays for what happens next."
(訳: 私たちが2025年に始めたPay Per Crawlは、アクセスに対して課金します。Pay Per Useは、そのあとに起きたことに対して支払います。)
「受けるか」を決めるのは、サイト運営者
公式ブログには、運営者の立場について次の趣旨の文がある。
"Publishers decide whether to accept, and can stop participating if an arrangement no longer works for them."
(訳: 運営者は受けるかどうかを決めます。取り決めが合わなくなれば、参加をやめることもできます。)
つまり、AI企業から申し出が届いても、自動で収益化が始まるわけではない。運営者が1件ずつ判断する形である。同時に、この判断は「設定を1か所切り替えれば終わる」種類のものではなく、誰が・何を見て・いつ決めるかという社内の決め事の問題になる。この記事は、その決め事を作る前に、自社のサイトで何を確かめておくかを扱う。
サーバー側の変更は要らない、と書かれている
技術面について、ブログには次の1文がある。
"There is no origin change or technical integration with each AI company."
(訳: 各AI企業との間で、オリジン(サーバー側)の変更や技術的な連携は要りません。)
運営者側で新しいプログラムを入れたり、AI企業ごとに接続したりする作業は不要だと読める。ただし、これは「何も設定しなくてよい」という意味ではない。次の章で触れるとおり、買い手のクローラーが内容にアクセスできるかどうかは、運営者がすでに設けている制限に左右されると、同じブログが書いている。
公式が書いていないこと
2026年10月時点で、公式ブログからは次の2点が読み取れなかった。日本の運営者が参加できるかどうかと、1件あたりの報酬額である。Cloudflareのブログには、Pay Per Useに参加できる地域の記述も、参加方法の案内も見つからなかった。Search Engine Journalも、Pay Per Useについては"a separate product also in beta"(訳: 別の製品で、こちらもベータ)と書くだけで、地域には触れていない。米国の事業者に限るという記述は、同じ日に始まったMonetization Gatewayについてのものである("It’s currently in closed beta for U.S.-based sellers and buyers."、訳: 現在は、米国に拠点を置く売り手と買い手に限ったクローズドベータです)。Pay Per Useの地域の条件は、Cloudflareのブログにも報道にも書かれておらず、この記事では確かめられていない。
また、同じ報道は、CloudflareのGatewayの記事にもPay Per Useの記事にも、取引件数や支払額は書かれていないと伝えている。そのため、この記事も「いくら入るか」「受けると有利か」といった話はしない。公式も報道も述べていないからである。
02 なぜ・背景 — 「アクセスへの課金」から「使われたあとの支払い」へ
Pay Per Crawlが先にあった
Cloudflareは2025年に、AIクローラーがページを取得するたびに運営者が対価を請求できる「Pay Per Crawl」を発表した。その経緯と2026年の変更点は、当サイトのCloudflareの「Pay Per Crawl」は今どこまで進んだか ── Pay Per Use移行と、9月15日の変更点にまとめている。この記事ではその内容を繰り返さず、9月30日のベータ開始と、判断の前に確かめることだけを扱う。
Pay Per Crawlが「取りに来た」ことに値段をつける仕組みなら、Pay Per Useは取ったあとにどう使われたかに値段をつける仕組みである。この違いは、上の図の4段階を見ると分かりやすくなる。取得の回数ではなく、買い手が「この種類の利用をした」と報告した回数が基準になる。
買い手の報告は、買い手の自己申告
公式ブログによれば、買い手は「承諾したドメインの一覧」を取得し、使うたびにJSONを1行報告する。記録には時刻・URL・識別番号が含まれる、と読み取れる。
"The buyer fetches the list of domains that have accepted its offer, then reports each use as one line of JSON."
(訳: 買い手は、自社の申し出を承諾したドメインの一覧を取得し、利用のたびにそれを1行のJSONとして報告します。)
"Usage is self-reported: the program terms require complete reporting, and Cloudflare checks that each reported use maps to an enrolled publisher."
(訳: 利用は自己申告です。プログラムの規約は完全な報告を求めており、Cloudflareは、報告された利用がそれぞれ、参加している運営者に対応するかを確かめます。)
報告は自己申告だが、原文は、プログラムの規約が完全な報告("complete reporting")を求めているとも書いている。そのうえで、ここで押さえておきたいのは、Cloudflareが確かめるのは「報告がどの参加サイトに当たるか」だという点である。利用の種類そのものが実際に行われたかどうかを、運営者が自分のサイトの記録だけで裏づける仕組みとは、公式の文章からは読み取れない。だからこそ、自分のサイトに実際にどのクローラーが来ているかを、運営者の側でも確かめておく意味が出てくる。
クローラーのアクセスは、運営者の設定に左右される
ブログには、買い手のクローラーについて次の文もある。
"AI companies identify their crawling activity using Verified bots and, when permitted by the publisher’s controls, can access and index content owned by the publisher."
(訳: AI企業は自社のクロール活動をVerified botsとして名乗り、運営者の制御が許す場合には、運営者が持つコンテンツにアクセスしてインデックスできます。)
「運営者の制御が許す場合には」とある。robots.txtやCloudflareのAllow・Blockの設定が今どうなっているかは、Pay Per Useを受けるかどうか以前に、そのサイトで何が起きるかを決めている。判断の前に自社の設定を確認する必要があるのは、このためである。
実務のヒント
申し出が届いてから設定を調べ始めると、「いつの設定で、誰が決めたのか」が分からないまま答えを求められがちである。届く前に、今の設定を1枚の表に書き出しておくと、受ける・断る・保留にするのどれでも、根拠を持って返事ができる。
03 用語 — 読み違えやすい言葉を先にそろえる
運営者と買い手
用語
運営者(Publisher):コンテンツを持つサイトの側。公式ブログではPay Per Useの申し出を受けるか決める立場である。買い手(Buyer):コンテンツを使うAI企業の側。利用の種類を定義して価格をつけ、利用を報告する立場である。
Verified bots
用語
Verified bots:Cloudflareが「自分が何者で、何をしているかを隠さない」と確認したサービスのことである。Cloudflareの開発者向け文書によれば、確認には2つの条件があり、1つは暗号の署名・公開されたIPアドレスの一覧と固定のUser-Agent・逆引きのいずれかで自分の身元を示すこと、もう1つはrobots.txtなどの指示に従い、無理のない頻度でアクセスすることである。
robots.txtとAllow・Blockは別の設定
robots.txtは、サイトが公開している「アクセスしてよい範囲のお願い」である。Googleの公式文書は、これを「ページをGoogleから隠す仕組みではない」と書いている("it is not a mechanism for keeping a web page out of Google."、訳: ページをGoogleから外しておくための仕組みではありません)。さらに、守るかどうかは来る側次第だという趣旨の文もある。
"The instructions in robots.txt files cannot enforce crawler behavior to your site; it's up to the crawler to obey them."
(訳: robots.txtの指示は、あなたのサイトに対するクローラーの動きを強制できません。従うかどうかはクローラー次第です。)
一方、CloudflareのAI Crawl Controlには、クローラーごとにAllow(許可)かBlock(拒否)を選ぶ画面がある。開発者向け文書は、Allowを選んでもrobots.txtが自動で無効になるわけではなく、別にrobots.txtの遵守を強制する選択もできると説明している。両者は別々の設定である。
Monetization Gatewayとx402
同じ日に始まったMonetization Gatewayは、ウェブページだけでなくAPIやデータセットなども対象に、アクセスごとに課金するための入口である。支払いにはx402というHTTPの規格が使われ、ステーブルコインで精算される、とCloudflareの7月のブログは説明している。Pay Per Useとは別の仕組みで、7月の時点では既存のCloudflare利用者向けの待機リストを受け付けていた。この記事では詳細に踏み込まない。
04 型別 — 誰に関係し、何を、どの順で確かめるか
🅰 適用範囲 — Cloudflareを使っていないサイトにも関係する
Pay Per Useは、Cloudflareに登録しているサイトが対象の仕組みである。ただし、この記事の確認項目のうち半分以上は、Cloudflareを使っていないサイトでもそのまま使える。robots.txtにどのAIクローラーの名前が書かれているか、実際にどの名前のアクセスが来ているかは、どのサーバーでも確かめられるからである。
Cloudflareを使っているサイトでは、AI Crawl Controlの画面で、クローラーごとの許可・拒否の状態と、来訪の数を見られる。開発者向け文書によれば、この機能は設定なしで動き、画面でクローラーごとにAllowかBlockを選べる。来訪元のページ(リファラル)の数は、有料プランの利用者だけが見られる、とも書かれている。
🅱 この記事が確かめていないこと
注意
この記事は、日本の事業者がPay Per Useに参加できるか、報酬がいくらになるか、どのAI企業が買い手として参加しているかを確かめていない。公式ブログにも報道にも、これらは書かれていなかった。「参加すると収益になる」「断ると機会を逃す」といった評価も、公式と報道のどちらも述べていないため、書かない。
また、利用の種類が本当に実行されたかを、運営者の側で確認できる仕組みがあるかどうかも、公式の文章からは読み取れなかった。申し出が届いた時点で、この点を質問できる窓口があるかを、Cloudflareまたは買い手に確認するのが安全である。
🅲 手順 — 3つの層を、この順で見る
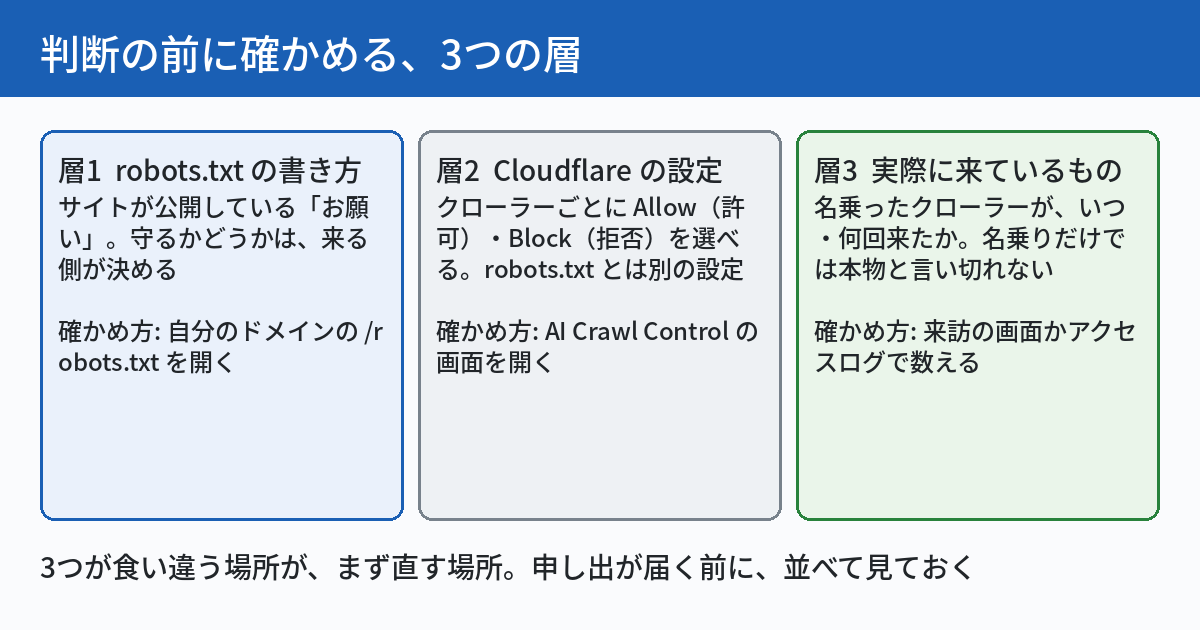
確認は、次の3つの層を下から上へではなく、公開されているものから順に見ていく。
層1 — robots.txtにAIクローラーの名前があるか
自分のドメインの末尾に「/robots.txt」をつけてブラウザで開く。見るのは、次の表に挙げた名前が書かれているかどうかである。書かれていなければ、そのクローラーには個別の指示を出していないことになる。
| 名前 | 運営元 | 公式の説明する用途 |
|---|---|---|
| OAI-SearchBot | OpenAI | ChatGPTの検索結果にサイトを表示するため |
| GPTBot | OpenAI | 生成AIの基盤モデルの学習に使うコンテンツの収集 |
| ChatGPT-User | OpenAI | ChatGPTの利用者が操作したときのページ取得(自動のクロールには使わない、と説明されている) |
| ClaudeBot | Anthropic | 生成AIモデルの学習に使うウェブコンテンツの収集 |
| Claude-User | Anthropic | 利用者がClaudeに質問してウェブの参照が必要なときの取得 |
| Claude-SearchBot | Anthropic | 検索結果の品質を上げるため、ウェブの内容を分析する |
ただしChatGPT-Userだけは、読み方が違う。OpenAIの公式文書は、"Because these actions are initiated by a user, robots.txt rules may not apply."(訳: これらの動作は利用者が始めるため、robots.txtのルールが当てはまらないことがあります)と書いている。そのため、上の表の6つを並べて食い違いを探すときも、ChatGPT-Userについては、robots.txtに書いてあることと実際の来訪が一致しないことがありうる。
OpenAIの公式文書は、これらの設定が1つずつ独立していると説明している。たとえば検索結果に出るためにOAI-SearchBotを許可しつつ、学習用のGPTBotは断る、という組み合わせができる。
"Each setting is independent of the others – for example, a webmaster can allow OAI-SearchBot in order to appear in search results while disallowing GPTBot to indicate that crawled content should not be used for training OpenAI's generative AI foundation models."
(訳: それぞれの設定は他から独立しています。たとえばウェブマスターは、検索結果に表示されるためにOAI-SearchBotを許可しながら、収集した内容をOpenAIの生成AI基盤モデルの学習に使わないよう示すためにGPTBotを拒否できます。)
Anthropicの公式ヘルプも、3つのクローラーを分けて説明し、ブロックしたときに影響が違うと書いている。ClaudeBotを止めると将来の学習データの対象から外れ、Claude-UserとClaude-SearchBotを止めると利用者の検索での見え方に影響する、という整理である。
層2 — Cloudflareの設定が、robots.txtと食い違っていないか
Cloudflareの管理画面でAI Crawl Controlを開き、「Security」タブで、クローラーごとのAllow・Blockを確認する。開発者向け文書には、ブロックしたときに返す応答を403か402から選べること、パス単位の例外を設けられることも書かれている。さらに「Directives」タブでは、robots.txtで禁止されているパスを要求したクローラーを一覧で見られる。
注意
Directivesタブの違反の記録は、リアルタイムでは記録されない。また、新しいルールを足すと、以前は問題のなかったアクセスが、あとから違反として表示されることがある(Cloudflare開発者向け文書の説明)。件数の増減だけで、すぐに結論を出してはいけない。
Cloudflareには、robots.txtの管理をCloudflareに任せる選択肢もある。その場合、一般的な学習用クローラーを止める指示と、Content Signals(コンテンツをどう使ってよいかをサイトが示すための宣言)が自動で加わる、と文書にある。自分で書いたrobots.txtと、Cloudflareが管理するrobots.txtのどちらが公開されているかは、ブラウザで開いて確かめるのが確実である。
層3 — 実際に来ているクローラーを数える
AI Crawl Controlの来訪の画面では、クローラーごとの総リクエスト数、許可されたリクエスト数、失敗したリクエスト数を見られる。運営会社ごとの集計もあり、CSVの書き出しにも対応している。期間は画面で選べる。
サーバーのアクセスログを使える場合は、ログの中でクローラーの名前を含む行を数える方法もある。ただし名乗りは自己申告である。当サイトの「AIクローラーが弾かれている」と読みかけた ── 日別に割ったら、正体は数十の名前を名乗る貸しサーバーだったでは、名前だけで判定すると誤読する例を扱った。提供元が公開しているIPアドレスの一覧と、数件だけでも照らし合わせるのが確実である(Anthropicは公式ヘルプで、確認用のIP一覧を案内している)。
サイト全体の状態をまず見たいときは、当サイトの無料ツール🔧 WEBサイト総合分析・レポートツールで、公開ページの基本情報を一覧できる。
05 自分のサイトで確認するチェックリスト
下の13項目は、Pay Per Useの申し出が届く前に、1項目5分ほどでできる作業である。チェックの状態はブラウザの中にだけ保存され、サーバーには送られない。Cloudflareを使っていない場合は、項目5〜8と項目12に「使っていない」と書いて飛ばす。
- Cloudflare公式ブログ「Pay Per Use」を開き、「利用の種類」「価格」「受けるかを決める人」について書かれた段落を、それぞれ1つずつ探して、メモに書き写す
- 自社のCloudflareのダッシュボードにログインできる人を、1人以上、名前で書き出す(使っていなければ「使っていない」と書く)
- ブラウザで自社ドメインの「/robots.txt」を開き、OAI-SearchBot・GPTBot・ChatGPT-User・ClaudeBot・Claude-User・Claude-SearchBotの6つについて、「書いてある」か「書いていない」かを表に記入する
- 同じrobots.txtの中で、Googlebotに対する「Disallow: /」の行が無いことを確認する
- CloudflareのAI Crawl Controlを開き、「Security」タブで、OpenAIとAnthropicの6つのクローラーのうち、Allowになっているものの数を書き出す
- 手順3のrobots.txtの表と、手順5のAllow・Blockの状態を並べて、食い違うクローラー(robots.txtでは止めているのにAllowになっている、など)が何個あるかを数える
- 「Directives」タブを開き、robots.txtに反するパスを要求したクローラーの一覧を見て、上位3つの名前を書き出す
- 来訪の画面で期間を直近7日に選び、リクエスト数の多い上位5つのクローラー名を書き出す
- アクセスログを使える場合は、手順8の1位のクローラーの名前を含む行を数え、画面の数字との差を記録する
- 手順9で数えたクローラーのうち1つについて、アクセス元のIPアドレスを1件、提供元が公開するIP一覧と照らし合わせて、一致するかを記録する
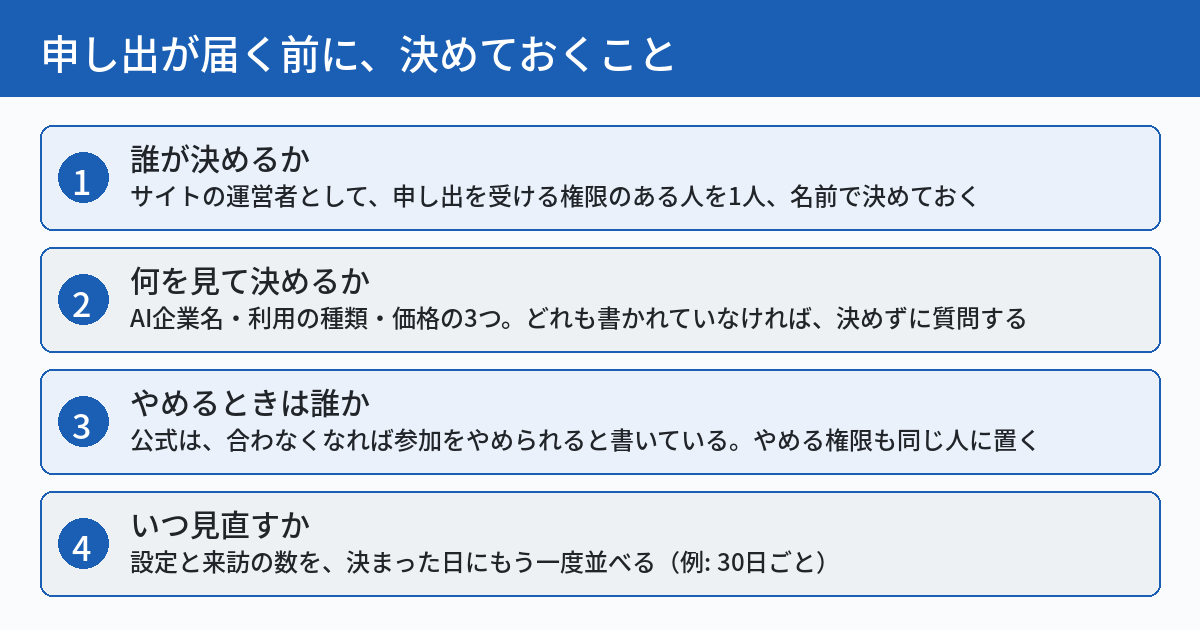
- Pay Per Useの申し出を受ける権限のある人を、1人、名前で決めて、メモに書き出す
- Cloudflareのダッシュボードで、Pay Per Useの画面が見えるかを確かめ、見えない場合は「見えない」と日付つきで記録する
- 申し出が届いたときに確認する項目として、「AI企業名」「利用の種類」「価格」の3つを書いた確認用のメモを1枚用意し、次に設定を見直す日を、カレンダーに1つ登録する
チェックリストの使い方
13項目のうち、項目1〜2と項目11〜13は人と決まりを整える作業で、項目3〜10は設定と来訪を並べる作業である。時間が限られているときは、項目3・5・6の3つだけでも、「robots.txtとCloudflareの設定が食い違っていないか」が分かる。食い違いが見つかったら、その場で直すのではなく、まずどちらが意図した設定かを、設定した人に確かめる。ChatGPT-Userはrobots.txtのルールが当てはまらないことがあるため、食い違いの数に入れるときは、その点を書き添える。
robots.txtの読み方そのものに不安がある場合は、当サイトのnoindex・nofollow・robots.txtは、それぞれ何を止めているのか ── 混同しやすい3つの設定を確認する15項目と、AIクローラーは1つではない ── robots.txt・llms.txtで「通す」「止める」を切り分ける(2026年9月時点)が助けになる。robots.txtが取得できなかったときのGoogleの扱いは、robots.txtがエラーを返し続けると、最後は「制限なし」に行き着く ── HTTPステータス別の扱いを確認する13項目(2026年9月時点)に書いた。
06 受ける・断る・保留 — 3つの選択肢を表で比べる
公式の説明の範囲で比べる
次の表は、申し出が届いたときの3つの選択肢について、公式ブログが書いている範囲と、書かれていないため先に確かめておくことを並べたものである。「どれが有利か」は書いていない。公式も報道も述べていないためである。
| 選択肢 | 公式の説明で読み取れること | 先に確かめておくこと |
|---|---|---|
| 受ける | 運営者が申し出ごとに決める。合わなくなれば参加をやめられる | 利用の種類の定義・価格・報告の頻度が、申し出に書かれているか。やめるときの手続き |
| 断る | 運営者は、受けない申し出を断れる | 断ったあとも、そのAI企業のクローラーへの設定(Allow・Block)は別にある。設定を見直す日を決めておく |
| 保留にする | 公式ブログで確認できた範囲では、保留中の扱いに触れていない | 保留の期限と、期限が来たときに誰が決めるか。質問を出す相手 |
受けるにしても、断るにしても、先に決めること
どの選択肢でも、前の章の項目11(決める人)と項目13(確認用のメモ)が、そのまま使える。決める人が決まっていない状態で申し出が届くと、返事が遅れるだけでなく、誰の判断で設定を変えたのかが残らない。
Pay Per Useの外にある選択肢
Pay Per Useに参加しなくても、AIクローラーの許可・拒否は、robots.txtとCloudflareのAllow・Blockで今すぐ決められる。収益化の仕組みと、アクセスを制御する仕組みは、別のレイヤーである。Cloudflareの設定が検索サービスの表示にどう影響するかは、当サイトのCloudflareのデフォルト「AI bots ブロック」があなたのGEOを殺している ── robots.txt無関係のインフラ層ブロックと、WEBディレクターが今すぐ確認すべき3つの設定が参考になる。
実務のヒント
設定を変えるときは、変える前の状態を画面の保存か書き出しで残すことを勧める。あとから「いつから止めていたか」を調べたくなる場面で、残してあれば数分で答えが出る。
公開前の確認や、外から見える設定の確認には、🔧 外からできるセキュリティ対策監査ツール(無料の会員登録が必要)も使える。
07 このサイトでの記録
当サイトでは、Cloudflareの設定とAIクローラーの扱いについて、これまで何本かの記事を公開してきた。この記事は当サイトがPay Per Useに参加したことを報告するものではない。確かめたのは公開されている公式の文章と報道、そしてこの記事で薦める確認の手順である。
AIクローラーの来訪を数える作業は、当サイトでも何度か数え方を直している。AIは331回来たと書いた。実際は11,024回だった ── HTTPのログだけを52日間 見ていたでは、見る範囲を広げると数字が変わった例を扱った。項目9のように「画面の数字」と「ログの数字」を並べるのは、その経験から来ている。数字が違っても、どちらかが間違いとは限らない。何を数えているかが違うことが多いからである。
08 このテーマの、これまで
Pay Per Crawlから、Pay Per Useのベータまで
| 時期 | 出来事 |
|---|---|
| 2025年7月 | CloudflareがPay Per Crawlを発表。クロールのたびに対価を請求できる仕組みとして、限定的なベータで始まる |
| 2026年6月16日 | Pay Per Crawlに、URIパターンによる除外設定と、動的な価格設定が追加される(Cloudflareの変更記録) |
| 2026年7月1日 | Cloudflareが、Pay Per Useへの移行と、Monetization Gatewayを発表する |
| 2026年9月30日 | Pay Per Useと、Monetization Gatewayがベータになる(Cloudflare公式ブログ・Search Engine Journal) |
2026年9月15日に適用予定とされていたBot Defaultsなど、途中の変更については、当サイトのCloudflareの「Pay Per Crawl」は今どこまで進んだか ── Pay Per Use移行と、9月15日の変更点に書いた。適用後にどうなったかは、この記事では確かめていない。
当サイトの、Cloudflareに関する過去の記事
- Cloudflareが「稼ぎ方」を変えた日 — Pay Per CrawlからPay Per Useへ、"引用されたら払う"時代の帰属という宿題 — 7月の発表を受けて、帰属の計算方法という宿題を扱った。
- Cloudflareが『価値』を可視化し始めた日 — BotBase と Attribution Business Insights、archives/93の一週間後に来た次の一手 — Cloudflareが見せる数字の読み方を扱った。
- Cloudflareが「検証」の定義を変えた日 — Search/Agent/Training 三分類の刷新と、37体allowの次の一手 — クローラーの分類の変更を扱った。
- 「守る」から「見分ける」へ ── Cloudflare Precursor GAが変えるbot対策と、WEBディレクターが今週確認すべき3点 — ボット対策の見分け方を扱った。
現在の貴方のIPアドレス
このサイトで書いている人