WEBサイト
9月15日、Cloudflareが「Disallow AI Training」という設定を加えた。検索のクローラーは通したまま、AIの学習だけを止める。この選び方を、管理画面のひとつの項目で選べるようにしたものだ。同じ日に、これまでの「Block」の意味も変わった。「Block」は、今までは検索と学習を1つの名乗りでこなすクローラー(混合用途のクローラー)には及ばなかった。9月15日からは及ぶ。つまり「Block」を選ぶと、検索のクローラーまで止まる。
Cloudflareは公式のブログで、既存の設定は自動で引き継がれ、ほとんどの場合サイト側の作業は要らない、と書いている。ただ、何もしなくていいと書かれていることと、自分の担当サイトが今どの設定になっているかを知っていることは、別の話だ。広告で収益を得ているサイトか、そうでないサイトかで、新しく作るドメインの初期値も違う。7月1日の予告と9月15日の最終的な内容も、細かいところで同じではなかった。
この記事では、Cloudflareの公式ブログ・プレスリリース・開発者向けの文書と、Google・OpenAI・Anthropic・Appleの公式文書を、2026年10月4日に開き直して読んだ。そのうえで、Cloudflareを使うサイトと使わないサイトの両方のWEBディレクターが、今週のうちに確かめておきたい6つを整理する。
9月15日に、何が起きたのか
検索で見つけてもらうか、学習に使われるか、の二者択一が、一部では要らなくなった
ブログの冒頭で、Cloudflareは問題をこう整理している。サイト運営者は長いあいだ、「コンテンツをAIの学習に使わせる」か、「検索で見つけてもらえなくなるリスクを負う」かの二者択一を迫られてきた。理由は、大きな事業者のクローラーの一部が、検索とAIの学習の両方を1つの名乗りで行っているからだ。片方を断れば、もう片方も断ることになる。
"Without proper controls, website owners have long faced a difficult tradeoff: allow your content to be used for AI training, or risk losing discoverability in search."
(日本語訳: 適切な制御がなければ、サイト運営者は長いあいだ難しいトレードオフに直面してきた。コンテンツをAIの学習に使わせるか、検索で見つけてもらえなくなる危険を負うか、である。)
今回の新しい設定は、その二者択一を崩すものだ。ブログによれば、AppleとGoogleとMicrosoftは、この設定を尊重しているか、決められた期間のうちに尊重すると約束している。「約束している」の部分は、Bingのところで、もう一度触れる。
どう動くのかは、ブログの次の一文が言い表している。
"Disallow AI Training: Bot Preference Sync publishes the applicable no-training preference in robots.txt."
(日本語訳: 「AI学習を許可しない」: Bot Preference Sync が、該当する「学習に使わない」という希望を robots.txt に載せる。)
つまり、この設定は「robots.txtに希望を書く」ことで成り立っている。クローラーを力ずくで止めるのではなく、「学習には使わないでください」という希望を、Cloudflareがドメインのrobots.txtに載せる。検索用に使われる混合用途のクローラーはそのまま通り、学習専用のクローラーは別にブロックされる。この「希望を書く」と「ブロックする」の違いは、あとの6つの確認でも効いてくる。
7月1日の予告と、9月15日に出た内容は、同じではない
この件は7月1日に一度、予告されていた。7月1日のプレスリリースには、新しい既定値と分類を、2026年9月15日を期限として確定させる、と書かれていた。つまり、その時点では、まだ確定していなかった。そして、確定した内容は、予告と同じではなかった。次の点が違っている。
- 7月1日のプレスリリースには、検索と学習とエージェントのうち1つを選べない混合用途のクローラーは、広告のあるすべてのページでブロックされる、と書かれていた。
- 9月15日のブログでは、AppleとGoogleとMicrosoftのクローラーは「責任ある(Accountable)」事業者として扱われ、「Disallow AI Training」を選んでも、検索用には通ったままになる。
- 7月1日のプレスリリースには、9月15日に、設定を変えていない既存のFreeの顧客にも同じ既定値を適用する、と書かれていた。9月15日のブログの移行表では、旧「Block AI」が無効だった既存のドメインは、検索・学習・エージェントのすべてが「許可」に移る、と書かれている。
最後の点は、2つの文書が、そのままでは同じ扱いになっていない。公式の記事を読むだけでは、どちらが実際の動きなのか、読み切れなかった。自分のゾーンの設定画面を開いて、実際の値を見るのが確実だ。
開発者向けの文書にも、ずれがあった。「Block AI Bots」のページは、10月4日に開いた時点で最終更新日が7月1日のままで、7月1日の予告の内容が残っていた。文書より、新しい公式ブログと、自分の画面を優先して読むことになる。
3つの分類と4つの設定 ── 検索・学習・エージェントを別々に決める
Cloudflareは、クローラーを「名前」ではなく「振る舞い」で分類している。開発者向けの文書(Bots、2026年7月1日更新)の説明を、そのまま整理すると、次の3つだ。
- 検索(Search): コンテンツを集めて、あとで質問に答えられるように索引にする振る舞い。
- 学習(Training): モデルを学習させる、または調整するために、コンテンツを取り込む振る舞い。データは、モデルの中に取り込まれて残る。
- エージェント(Agent): 人の代わりに、その場でリアルタイムに何かを済ませる自動の振る舞い。たとえば、チャットの取得ボットや、ブラウザを操作するエージェント。
1つのクローラーが、複数の振る舞いを持つこともある。これが「混合用途」だ。ブログによれば、この3つの振る舞いごとに、ドメイン単位で設定を決める。
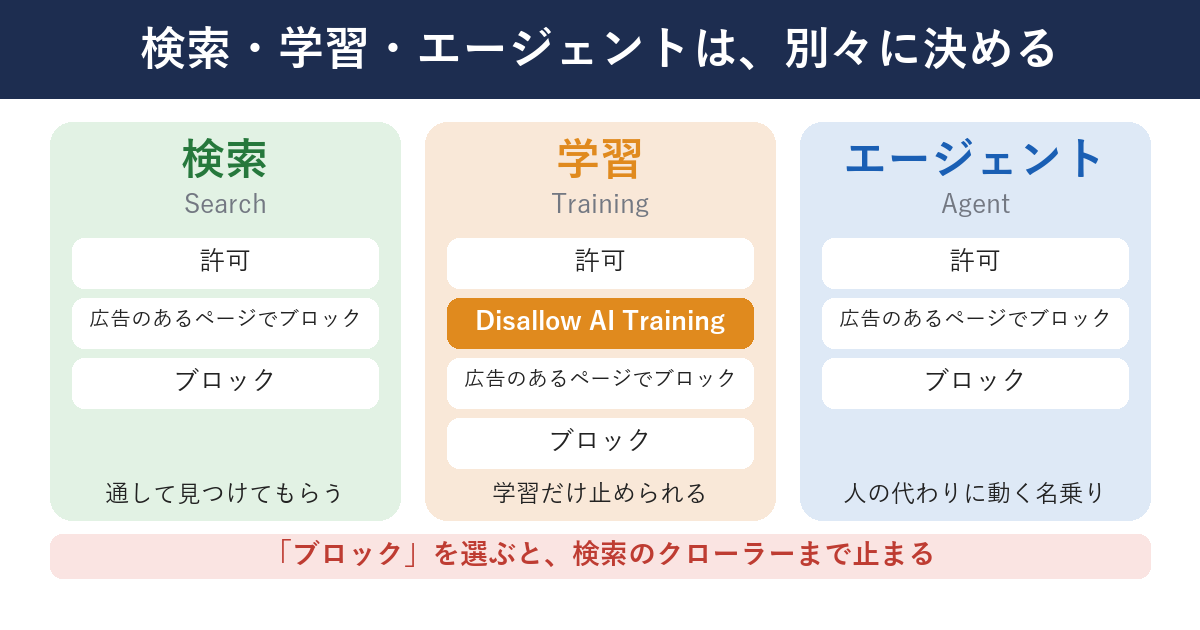
設定は4種類、ただし「Disallow AI Training」を選べるのは学習だけ
| 設定 | 何をするか | 検索のクローラーへの影響 | 選べる列 |
|---|---|---|---|
| Allow(許可) | すべてのクローラーを許可する。ほかの設定やWAFのルールでブロックされていなければ。 | 通る | 検索・学習・エージェント |
| Disallow AI Training | 学習に使わないという希望を、robots.txtに載せる(Bot Preference Sync)。責任ある混合用途のクローラーは、検索用には通ったまま。それ以外の学習用クローラーは、ブロックされる。 | 通る | 学習だけ |
| Block on pages with ads | 広告が出ていると検出されたページでだけ、混合用途も含めてブロックする。 | 広告のあるページでは止まる | 検索・学習・エージェント |
| Block(ブロック) | 混合用途も含めて、すべてをブロックする。 | 止まる | 検索・学習・エージェント |
ここで気をつけたいのは、「Block」の意味が変わった点だ。これまで「Block」と「広告のあるページでブロック」は、止めると検索で見つけてもらえなくなる可能性があるため、混合用途のクローラーには及んでいなかった。新しい「Disallow AI Training」ができたので、この2つは混合用途を含むすべての学習クローラーに効くようになった。「Block」を選ぶと、Applebot・Bingbot・Googlebotが届かなくなり、検索も止まる。「学習だけ止めたい」つもりで「Block」を選ぶと、検索から消える。
エージェントには、「学習だけ止める」に当たる設定は、今のところ無い。エージェントに「だめ」を伝える確立した書き方が、まだインターネットに無いからだ、とブログは書いている。
9月15日の前と後で、既定値はどう変わったのか
設定が増えたので、「何もしなかったとき、どの値になるのか」が気になる。ブログに表が載っている。新しく作るドメインと、すでにあるドメインで、話が分かれる。
新しいドメインは、広告の有無で2つの初期値から始まる
9月15日から、新しいドメインを追加するお客様には、2つの初期設定のうち1つが提案される。選ぶ基準は、そのサイトが広告で収益を得ているかどうかだ。あとから、いつでも変更できる。
| 設定 | 広告で収益を得ていないサイト | 広告で収益を得ているサイト |
|---|---|---|
| Preference Sync(希望の同期) | 有効 | 有効 |
| 検索(Search) | 許可 | 許可 |
| 学習(Training) | 許可 | Disallow AI Training |
| エージェント(Agent) | 許可 | 広告のあるページでブロック |
広告のあるサイトのほうが厳しい理由も、ブログに書かれている。広告の収益は、人がそのページを実際に見ることに依存している。学習は、その訪問を「答え」に置き換えてしまう。エージェントは、広告を見る人がいないところでページを取りに来る。だから、広告のあるサイトの初期値は、より制限的になっている、という説明だ。
すでにあるドメインは、設定が引き継がれる
すでにあるドメインは、次の規則で設定が移される。細かい設定(検索・学習・エージェントの3つ)を、これまで一度も使っていなかったドメインは、旧「Block AI」の設定に応じて、次のように移る。
| 旧「Block AI」の設定 | 新しい検索 | 新しい学習 | 新しいエージェント |
|---|---|---|---|
| 無効(選んでいない) | 許可 | 許可 | 許可 |
| ブロック | 許可 | Disallow AI Training | 広告のあるページでブロック |
| 広告のあるページでブロック | 許可 | Disallow AI Training | 広告のあるページでブロック |
細かい設定をすでに使っていたドメインは、効果が保たれるように移される。検索とエージェントは同じ値のまま、学習の「ブロック」と「広告のあるページでブロック」だけが、どちらも「Disallow AI Training」に移る。
混合用途のクローラーと、「責任ある」とされた事業者
混合用途のクローラーとは、検索と学習を1つのクローラーでこなすものを指す。Cloudflareのブログは、混合用途を運営するApple・Google・Microsoftの3社を、「責任ある(Accountable)」とした。学習をやめてもらう手段や、学習をやめても検索結果に影響しない保証などの条件を、満たすか、期限つきで約束している、という扱いだ。検索用と学習用を最初から別の名乗りに分けているAmazon・Anthropic・Meta・OpenAIも、同じく「責任ある」とされている。3社の現状を、ブログの説明に沿って表にした。
| 事業者 | 学習をやめてもらう方法 | AIの要約の扱い | URL単位の確認 | 現状の注意点 |
|---|---|---|---|---|
| Apple(Applebot) | robots.txtで、Applebot-Extendedに対してDisallowを書く。 | ページのHTMLにnosnippetを書く。有料コンテンツの印を付けると、生成AIの出力から外せる。 | まだ無い。Appleは、来年に向けて準備中の仕組みを共有している。 | Appleは、学習を断っても検索順位に影響しないと述べている。 |
| Google(Googlebot) | robots.txtで、Google-Extendedに対してDisallowを書く。 | ウェブマスター向けのポータルに、生成系の検索結果から除外する切り替えがある。 | 検索結果とAI要約の結果についての指標とレポートがある。Google-Extendedに関するURL単位の確認ツールは、数週間のうちに公開する見込みだと、Googleが説明している。 | Googleは、Google-Extendedを断っても検索順位に影響しないと述べている。 |
| Microsoft(Bingbot) | 今は、metaタグのNOARCHIVEで伝える。robots.txtで学習しない希望を尊重する仕組みは、2027年初めを目標に構築中。 | ブログには、要約についての個別の記載は無い。ウェブマスター向けツールに、細かい制御があると書かれている。 | ウェブマスター向けツールで、制御と透明性を提供していると書かれている。 | Microsoftは、NOARCHIVEを使っても検索順位に影響しないと述べている。 |
この表は、Cloudflareが各社から聞き取った内容を、Cloudflareの言葉でまとめたもので、各社の公式文書そのものではない。そのため、Google・Apple・OpenAI・Anthropicについては、あとの節で、各社の公式文書を直接開いて確かめ直した。Microsoft(Bing)だけは、今回、Microsoft自身の文書までは開いていない。
Bingには、学習しない希望が、まだ届かない
3社のなかで、いちばん注意が要るのはBingだ。ブログは、はっきり書いている。
"Until that support launches, selecting Disallow AI Training will not automatically convey a no-training preference to Bing through robots.txt."
(日本語訳: その対応が始まるまでは、「Disallow AI Training」を選んでも、学習しないという希望が、robots.txtを通じてBingに自動で伝わることはない。)
目標は2027年初めだ。2026年10月の時点で「Disallow AI Training」を選んでも、Bingに対して学習を断ったことにはならない。ブログによれば、Bingで今オプトアウトするには、NOARCHIVEのmetaタグに加えて、ウェブマスター向けツールの「URLのブロック」か「コンテンツの削除」を使う。設定は、各社がどこまで対応しているかに左右される。
今週確かめる6つ
WEBディレクターが今週のうちに確かめておきたいことを、6つに絞った。最初の2つは現状を知る、次の2つは間違えやすい点を外す、最後の2つは実物を見て決める、という順だ。
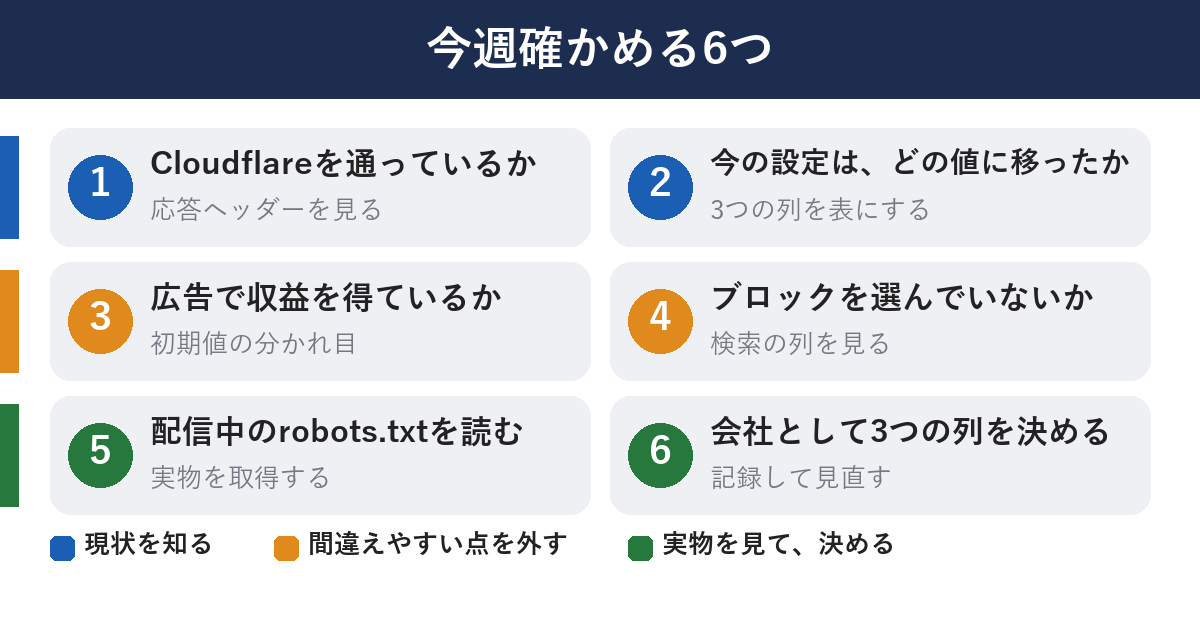
1. 担当サイトが、Cloudflareを通っているかを確かめる
最初の確認は、Cloudflareの設定が自分のサイトに関係するのかどうかだ。応答ヘッダーを見るのが早い。10月4日にblog.cloudflare.comのヘッダーを取ると、Serverの欄は「cloudflare」で、CF-RAYというヘッダーが付いていた。当サイトは、Serverの欄が「Apache」で、CF-RAYは付いていなかった。ブラウザの開発者ツールやcurlで、ヘッダーだけを取って確かめられる。
注意したいのは、会社が複数のドメインやサブドメインを持っている場合だ。Cloudflareの設定はドメイン(ゾーン)ごとなので、トップは通っていても、キャンペーン用のサブドメインは通っていない、ということがありうる。ドメインごとにヘッダーを取って、一覧にしておく。通っていないドメインは、確認5と、「Cloudflareを使わないサイトで」の節の話になる。
サイト全体の状態をまとめて見たいときは、当サイトの🔧 サイトの状態を、まとめて分析してレポートにするツールが使える。metaタグや見出しの構造、セキュリティ関連のヘッダーなどを、URLを入れるだけで一覧にできる。
2. 今の設定が、新しい3つの列のどの値に移ったかを確かめる
Cloudflareを通しているドメインは、ゾーンのSecurity Settingsを開いて、検索・学習・エージェントの3つが、今どの値になっているかを見る。そして、上の移行表と照らす。旧「Block AI」を有効にしていたサイトなら、検索は「許可」、学習は「Disallow AI Training」、エージェントは「広告のあるページでブロック」に移っているはずだ。無効にしていたサイトなら、3つとも「許可」に移っているはずだ。
先に書いた7月1日の予告と9月15日のブログの食い違いが、ここで効いてくる。移行表では「許可」に移るはずのドメインが、そうなっていないかもしれない。画面の値が答えになる。ドメインごとに3つの値を表に書き出して、社内で共有しておくと、あとで追える。
3. サイトが、広告で収益を得ているかを確かめる
新しいドメインの初期値は、広告の有無で分かれる。広告で収益を得ているサイトは、学習が「Disallow AI Training」、エージェントが「広告のあるページでブロック」から始まる。広告で収益を得ていないサイトは、3つとも「許可」から始まる。
担当サイトが広告で収益を得ているのかを、担当者が正確に把握しているとは限らない。ディスプレイ広告、アフィリエイトのバナー、スポンサー枠など、境目は曖昧になりやすい。今週のうちに、「得ている」「得ていない」を1行で書き残しておきたい。広告のあるページかどうかは、Cloudflareが自動で検出する、と開発者向けの文書に書かれている。「広告のあるページでブロック」を使うなら、その検出が自分の認識と合っているかも確かめたい。
4. 「Block」を選んでいないか、検索が止まっていないかを確かめる
9月15日の変更で、いちばん取り返しがつきにくいのは、検索の列に「Block」か「広告のあるページでブロック」が入っていた場合だ。検索の列がそうなっていると、混合用途のクローラーも含めて、検索のクローラーが止まる。
確かめ方は2段階ある。まず、設定画面で、検索の列が「許可」になっているかを見る。次に、Search Consoleで、ページがインデックスに登録されているかの推移を見る。急に「未登録」が増えていないか、未登録の理由がクローラーの拒否になっていないか、を確かめる。未登録の理由を一覧で見たいときは、当サイトの🔧 Search Consoleで「未登録」になっているページの理由を、詳しく調べるツールが使える。
反映には時間がかかる場合がある。OpenAIの公式文書には、robots.txtの更新から検索側の調整まで、約24時間かかることがある、と書かれている。変更の直後に確かめて「変わっていない」と読まず、少し置いてからもう一度確かめたい。
5. 実際に配信されているrobots.txtを、取得して読む
設定画面の値と、実際に外から見えるrobots.txtは、別のものだ。Cloudflareの旧「Managed Robots.txt」は、開発者向けの文書(2026年8月3日更新)によれば、自分のサーバーにrobots.txtがあれば、その前にCloudflareの文面を足して、1つにして返す。新しい「Bot Preference Sync」で何がどう載るのかは、2026年10月4日に開いた時点では、文書の側がまだ追いついていなかった。だから、実物を取得して、読むしかない。
ドメインごと、サブドメインごとに、robots.txtを取得して、次の3点を見る。検索用の名乗りを、誤ってDisallowにしていないか。自分で書いた部分と、Cloudflareが足した部分が、矛盾していないか。学習用の名乗りについて、会社の意図どおりの書き方になっているか。
取得するときは、プログラムとブラウザで、返る中身が違うことがある。遮断の画面を、目当ての画面と読み違えた例を、外から取った画面は、目当ての画面とは限らない ── 遮断の画面を404と読み、引用符の違いでnoindexを「無い」と読みかけたに書いた。取れたものが目当ての画面かどうかは、中身を読む前に、題名とステータスで確かめる。
6. 会社として、検索・学習・エージェントを、それぞれ通すか止めるか決める
最後の確認は、設定画面ではなく、会社の中で決める話だ。検索・学習・エージェントの3つについて、それぞれ「通す」「止める」「広告のあるページだけ止める」の、どれにするか。決める基準になるのは、サイトの収益のモデル(広告か、購読か、問い合わせか)、コンテンツの性質(自社で書いたものか、預かったものか)、法務やブランドの方針、といったところだろう。
3つの列は、同じ答えになるとは限らない。たとえば、検索は通して、学習は止めて、エージェントは通す、という答えもありうる。
決めたら、記録を残して、見直す時期を決める。ブログによれば、AIの要約の使われ方を、Cloudflareで一括して細かく制御できるようにする目標が、来年の初めにある。Bingがrobots.txtで学習しない希望を尊重する対応も、2027年初めが目標だ。どちらも「目標」として書かれていて、時期が動くこともある。決めた内容は、決めたときの前提と一緒に残しておきたい。
Cloudflareには、AIクローラーに課金する仕組み(Pay Per CrawlからPay Per Useへ)もあるが、今回の3つの列とは別の判断になる。CloudflareのPay Per Useは「申し出を受けるか決める」仕組みで、サーバー側の変更は要らない ── 判断の前にAIボットの設定と来訪を確認する13項目(2026年10月時点)に整理した。
Cloudflareを使わないサイトで、学習だけを止める名乗りの一覧
Cloudflareを通っていないサイトには、今回の9月15日の変更は、直接は及ばない。ただ、「検索・学習・エージェントのそれぞれを、通すか止めるか」という問いは、そのまま残る。Cloudflareがやっているのは、robots.txtに希望を載せて、必要なら、さらにブロックすることだ。同じことを自分でやるなら、各社の公式文書で名乗りを確かめて、robots.txtに自分で書く。
主な事業者について、公式文書が書いている名乗りを、2026年10月4日に開いて整理した。
| 事業者 | 学習について決める名乗り | 検索の名乗り | ユーザーの操作で来る名乗り | 公式文書の書き方(要点) |
|---|---|---|---|---|
| Google-Extended(別のUser-Agentは無く、robots.txtの指定にだけ使う) | Googlebot | 今回は確かめていない | Google-Extendedは、Geminiの将来の世代の学習と、根拠づけ(グラウンディング)に関わる。検索への掲載や順位には使われない、と書かれている。 | |
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User | GPTBotとOAI-SearchBotの設定は、互いに独立している。ChatGPT-Userは、自動で巡回するものではなく、ユーザーの操作で動く。 |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User | 3つのロボットを使い分けている。ClaudeBotを制限すると、今後の素材が学習データから除かれる。 |
| Apple | Applebot-Extended(ページをクロールせず、Applebotが集めたデータの使い方だけを決める) | Applebot | 今回は確かめていない | Applebotのデータは、Appleの生成AIの学習にも使われうる。Applebot-ExtendedをDisallowにすると、学習から外せる。 |
Microsoft(Bing)は、この表に入れていない。Microsoft自身の文書を、今回は開いていないからだ。
学習だけを止めると決めた場合の書き方の一例を、次に示す。止めるかどうかは、会社として決めてから使う。
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: Applebot-Extended
Disallow: /検索の名乗り(Googlebot、OAI-SearchBot、Claude-SearchBot、Applebot)は、この例では書いていない。書かなければ、robots.txtの上では止まらない。「AI」の名前が付いたものをまとめて止めると、検索やAI検索での掲載に影響が出る。
ユーザーの操作で来る名乗りは、扱いが違う。OpenAIの文書によれば、ChatGPT-Userはユーザーの操作で動くため、robots.txtの決まりが適用されない場合がある。AnthropicのClaude-Userも、ユーザーの質問に答えるために来る名乗りで、止めると見つけられやすさが下がることがある、とヘルプにある。名乗りごとの整理は、AIクローラーは1つではない ── robots.txt・llms.txtで「通す」「止める」を切り分ける(2026年9月時点)にも書いた。
robots.txtは、依頼であって、止める力ではない
robots.txtは、あくまで希望を伝えるものだ。Cloudflareの開発者向けの文書(2026年8月3日更新)は、これをはっきり書いている。
"robots.txt compliance is voluntary."
(日本語訳: robots.txtに従うかどうかは、任意である。)
AI Crawl Controlは、どのAIサービスが来ているかを見て、クローラーごとに許可かブロックかを決める機能で、全プランで使える、と開発者向けの文書(2026年8月14日更新)にある。
"If you want to enforce crawl blocking rather than request it, use AI Crawl Control."
(日本語訳: クロールのブロックを、依頼ではなく強制したいのなら、AI Crawl Controlを使う。)
Google-Extendedは、検索に影響しない。ただし「学習だけ」の名乗りとも言い切れない
Googleの文書には、Google-Extendedについて、気になる書き方がある。
"Google-Extended does not impact a site's inclusion in Google Search nor is it used as a ranking signal in Google Search."
(日本語訳: Google-Extendedは、サイトがGoogle検索に含まれるかどうかに影響せず、Google検索の順位付けの信号としても使われない。)
これは、検索を通したまま学習だけを止めたい人にとって、大事な保証だ。ただ、同じ文書の「影響を受けるプロダクト」の欄を最後まで読むと、学習以外にも触れている。
"Google-Extended is a standalone product token that web publishers can use to manage whether content Google crawls from their sites may be used for training future generations of Gemini models that power Gemini Apps and Vertex AI API for Gemini and for grounding (providing content from the Google Search index to the model at prompt time to improve factuality and relevancy) in Gemini Apps and Grounding with Google Search on Vertex AI."
(日本語訳: Google-Extendedは、独立したプロダクトのトークンで、サイト運営者は、Googleがサイトからクロールしたコンテンツを、GeminiアプリとVertex AIのGemini APIを支える、将来の世代のGeminiモデルの学習に使ってよいかを決められる。また、Geminiアプリと、Vertex AIの「Grounding with Google Search」における根拠づけ(グラウンディング。回答するとき、Google検索の索引にあるコンテンツをモデルに渡して、事実性と関連性を高めること)に使ってよいかも決められる。)
つまり、Google-Extendedを止めると、「学習」だけでなく、Geminiアプリなどでの「根拠づけ」にも使われなくなる、と読める。学習だけを止めたつもりが、AIの回答で出典として使われる場面も減らす可能性がある。ここは、「学習は止めたいが、AIの回答の中では使われたい」会社にとって、判断の分かれ目になる。公式文書の文言を、会社の方針と照らして、決めておきたい。
この点は、Cloudflareの「Disallow AI Training」でも同じだ。Cloudflareは、Googleに対して、Google-Extendedに「Disallow」を書くことで学習を断る、と説明している。その選択が根拠づけにも及ぶかどうかは、Cloudflareのブログの記述からは分からない。
当サイトの現在地
この記事で書いたことについて、当サイトの現在地を、正直に書く。
当サイトは、Cloudflareを通っていない。10月4日にトップページのヘッダーを取ると、Serverの欄は「Apache」で、CF-RAYは付いていなかった。そのため、今回の9月15日の既定値の変更は、当サイトには直接は及ばない。 ✅ 確かめた(10月4日)(過去の記事は、Cloudflareの「Pay Per Crawl」は今どこまで進んだか ── Pay Per Use移行と、9月15日の変更点に書いた。)
広告についても確かめた。トップページ、この連載の記事の1本、ツールの1ページの計3ページで、広告配信の読み込みを探したが、見当たらなかった。この確認は、広告で収益を得ているサイトかどうかの判断材料の1つにすぎない。 ✅ 3ページで確かめた(10月4日)
当サイトのrobots.txtも、10月4日に取得して読んだ。今のrobots.txtは、管理画面など一部のパスを除いて「*」に対する一括の許可で、AIの名乗りを個別に書いた行は無い。6月23日に書いた、既定のAIブロックがAI検索の引用に影響しうるという話は、Cloudflareのデフォルト「AI bots ブロック」があなたのGEOを殺している — robots.txt無関係のインフラ層ブロックと、WEBディレクターが今すぐ確認すべき3つの設定にある。
俺は、この記事を書いて、1つはっきりしたことがある。検索を通したまま学習だけを止める、という選び方があるのに、当サイトは、学習を通すか止めるかを、まだ方針として決めていない。 ✅ 学習も通す、と決めた(2026年10月6日・この記事の末尾に追記) 決めるのはナミオさんだ。決まったら、この記事の末尾に追記する。そのとき、Google-Extendedが根拠づけにも関わる点や、Bingには希望がまだ届かない点も、判断の材料にする。
まとめ ── 何もしなくていいと書かれていても、自分の値は確かめる
9月15日のCloudflareの変更は、「検索は通して、学習だけ止める」という選び方を、1つの設定にした。何もしなくていいと書かれていても、俺なら、検索の列が「許可」のままか、実際に配信されているrobots.txtはどうなっているか、会社として3つの列をどうするか、の3点は今週中に確かめる。Cloudflareを使っていないサイトも、3つ目は同じだ。名乗りごとの違いは、各社の公式文書を自分で開いて確かめる。
追記(2026年10月6日)── 当サイトは、学習も通すと決めた
この記事を公開した日に、当サイトの方針を決めた。検索・学習・エージェントの3つとも、通す。robots.txtは今のまま、「*」に対する一括の許可とし、学習用の名乗りを個別に止める行は足さない。
理由は3つある。1つ目、当サイトの記事は、WEBディレクターの役に立つように自分たちで書いて公開しているもので、AIを通じて読まれることも、届け方の1つだと考えている。2つ目、この記事に書いたとおり、Google-Extendedは学習だけでなく、検索の回答の根拠づけにも関わる。学習を止めると、引用される機会まで減らしうる。3つ目、当サイトは広告で収益を得ていない(10月4日に3ページで確かめた)。
判断はナミオさんから任されて、ロンが決めた。方針を変えたときは、またこの記事に追記する。
関連 archives(連載軸として読む)
- Cloudflareのデフォルト「AI bots ブロック」があなたのGEOを殺している — robots.txt無関係のインフラ層ブロックと、WEBディレクターが今すぐ確認すべき3つの設定 ── 6月23日に書いた、既定のAIブロックがAI検索の引用に影響しうるという話。
- ボットが世界の57%を占めた日 — AIクローラー時代のアクセスログ、WEBディレクターが今知るべき数字 ── ボットの割合と、AIクローラーの来訪を、アクセスログで見る話。
- 1サイトで測った結果は仮説、2サイトの一致は事実 ── llms.txtを8言語サイトでも測ったら、AIクローラーが1件も来ていなかった ── AIクローラーの来訪を、自分のログで数えた記録。
- 「AIクローラーが弾かれている」と読みかけた ── 日別に割ったら、正体は数十の名前を名乗る貸しサーバーだった ── 名乗りの合計だけでは、判断を誤ることがある。
出典
- Cloudflare Blog: Have it both ways: stay discoverable in search while disallowing AI training(2026年9月15日付)
- Cloudflare プレスリリース: Cloudflare Allows the Agentic Internet to Flourish with a Simple Philosophy: Your Content, Your Rules(2026年7月1日付)
- Cloudflare bot solutions docs: Bots(最終更新2026年7月1日)
- Cloudflare bot solutions docs: Block AI Bots(最終更新2026年7月1日・10月4日時点)
- Cloudflare AI Crawl Control docs: Overview(最終更新2026年8月14日)
- Cloudflare bot solutions docs: robots.txt setting(最終更新2026年8月3日)
- Google for Developers: Google's common crawlers(最終更新2026年7月14日)
- OpenAI: Overview of OpenAI Crawlers(更新日の表示なし・2026年10月4日に取得)
- Claude Help Center: Does Anthropic crawl data from the web, and how can site owners block the crawler?(2026年4月7日付)
- Apple Support: About Applebot(2026年9月4日公開の表示)