WEBサイト
Googleの広告用クローラーには、robots.txtの「*」の指定が効かない ── 止めたつもりのページと広告タグのあるページを突き合わせる13項目(2026年10月時点)
Googleの広告用クローラーには、robots.txtの「*」の指定が効かない ── 止めたつもりのページと広告タグのあるページを突き合わせる13項目(2026年10月時点)
目次
01 何が起きたか — 広告用のクローラーは、robots.txtの「*」の指定を無視すると公式文書に書かれている
2026年10月4日に開いた公式文書の更新日は、9月17日だった
Googleのクロール関連の文書「特殊なケースのクローラーの一覧」(英語版の題名は"List of Google's special-case crawlers")を、2026年10月4日に開いた。ページ末尾の最終更新日は2026年9月17日(UTC)である。同じ日付の項目が、クロール文書の変更履歴にも載っている。
この文書の冒頭には、次の説明がある。
"The special-case crawlers are used by specific Google products where there's an agreement between the crawled site and the product about the crawl process. For example, AdsBot ignores the global robots.txt user agent (*) with the ad publisher's permission."
(訳: 特殊なケースのクローラーは、クロールされるサイトとGoogleの製品との間で、クロールの進め方について合意がある、特定の製品で使われます。たとえばAdsBotは、広告を出す側の許可のもとで、robots.txtの全体向けのユーザーエージェント(*)を無視します。)
つまり、robots.txtにUser-agent: *で拒否を書いても、広告用のクローラーにはその指定が適用されないと読める。ホームページの制作や運用を担当するWEBディレクターにとっては、「robots.txtで止めたはずのページに、広告用のクローラーが来ているかもしれない」という確認の入り口になる。
9月17日の更新は、見出しの言い換えだった
変更履歴の2026年9月17日の項目の題名は、"Generalized the Mediapartners-Google crawler documentation"(訳: Mediapartners-Googleのクローラーの文書を一般化した)である。内容は、Mediapartners-Googleの文書を、AdSenseだけでなく広告に関する複数のGoogle製品に影響すると明確にし、節の見出しを「AdSense」から「Mediapartners-Google」に改めた、というものだ。
出典(Googleのクロール文書の変更履歴)
"Crawling preferences addressed to the Mediapartners-Google user agent affect multiple ad-related Google products (for example, Google AdSense and Google Ad Manager)."
(訳: Mediapartners-Googleのユーザーエージェントに向けたクロールの設定は、広告に関する複数のGoogle製品(たとえばGoogle AdSenseとGoogle Ad Manager)に影響します。)
この項目は、文書の書き方の更新であり、クローラーの動きを変えたという説明ではない。「9月17日から挙動が変わった」とは、変更履歴のどこにも書かれていない。この記事も、そう書かない。文書の更新日と、挙動が変わった日は、別の日付として扱う。
「*」の指定が効かないと書かれているのは、4つの名前
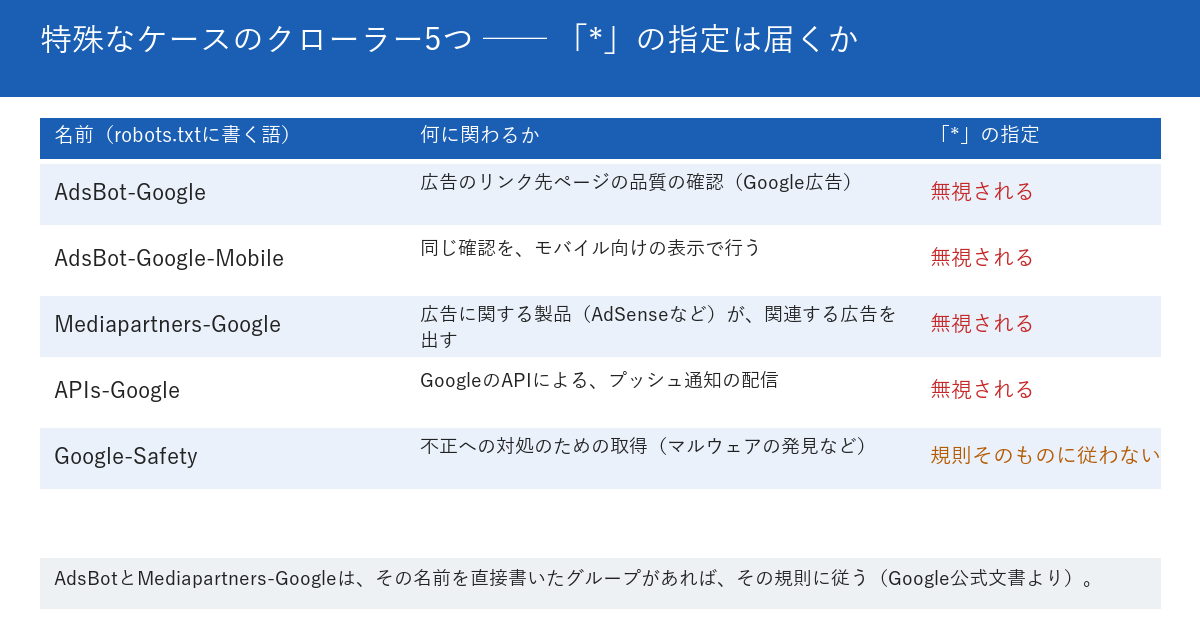
公式文書の現在の一覧で、「全体向けのユーザーエージェント(*)は無視される」(原文は"The global user agent (*) is ignored.")と書かれているのは、次の4つである。
- AdsBot-Google:Google広告が、広告のリンク先ページの品質を確認するために使う。
- AdsBot-Google-Mobile:同じ確認を、モバイル向けの表示で行う。
- Mediapartners-Google:広告に関するGoogleの製品(AdSenseとGoogle Ad Managerなど)が、関連する広告を出すために使う。
- APIs-Google:GoogleのAPIが、プッシュ通知を届けるために使う。
同じ一覧には、もう1つ、Google-Safetyがある。こちらは、「*」だけでなく、robots.txtの規則そのものに従わないと書かれている(Google上に公開されたリンクのマルウェアの発見など、不正への対処のための取得に使われる、と説明されている)。
02 なぜ・背景 — 広告用のクローラーは、「合意」の上で動いている
特殊なケースのクローラーは、検索用のクローラーとは別の位置づけ
Googleは、自社のクローラーを3種類に分けている。検索のGooglebotのような一般のクローラー、サイトとGoogleの製品の間に合意があるときに使う特殊なケースのクローラー、利用者の操作で取得するユーザーが起動する取得機能である。公式の概要ページは、一般のクローラーについて、自動のクロールではrobots.txtの規則に必ず従うと書いている。一方、特殊なケースのクローラーは、"may ignore robots.txt rules"(訳: robots.txtの規則を無視することがある)と、一覧のページに書かれている。
ここで言う「合意」は、広告を配信する側が、広告の配信や審査のためにクロールされることを受け入れているという意味である。AdsBotについて、冒頭の文章は「広告を出す側の許可のもとで」と書いている。広告を出していないサイトには、そもそもこの合意が無い。
AdSenseの公式ヘルプは、広告タグのあるページにだけ来ると書いている
AdSenseの公式ヘルプ「AdSenseのクローラーについて」は、いくつかの事実を挙げている。クローラーが取得しようとするのは、広告のタグを設置したURLだけであること。AdSenseのクローラー(Mediapartners-Google)はGoogleの検索のクローラーとは別物だが、キャッシュは共有していること。AdSenseにサイトを追加するときの確認には、Google-Display-Ads-Botというクローラーも使われること。クロールの頻度は、Googleの側からも制御できず、自動で行われること。これらも書かれている。
そして、同じページの中に、この記事の主題に直接関わる注意書きがある。
"If you’re serving ads on pages that are being roboted out with the line User-agent: *, then the AdSense crawler will still crawl these pages."
(訳:
User-agent: *の行でrobots.txtにより取得を止めているページで広告を配信している場合でも、AdSenseのクローラーは、それらのページを引き続きクロールします。)
つまり、広告のタグがあるページは、「*」で止めても、広告のクローラーには取得され続ける。止めたつもりのページに広告のタグが残っていると、止めたはずのページに取得の通信が来る。
確認する場所が、2か所に分かれている
この確認が見落とされやすいのは、確認する場所が2つに分かれているからである。robots.txtを管理する人と、広告のタグを管理する人は、同じ会社の中でも別の担当であることが多い。robots.txtを見るだけでは、どのページに広告のタグがあるかは分からない。広告の管理画面だけを見ても、robots.txtで何を止めているかは分からない。2つを突き合わせるのが、この記事の手順の中心である。
03 用語 — 読み違えやすい言葉を先にそろえる
グループと、ユーザーエージェントトークン
用語
グループ:robots.txtの中の、User-agent:の行から次のUser-agent:の行までのまとまりのことである。ユーザーエージェントトークン:User-agent:の行に書く、クローラーの名前のことである(GooglebotやAdsBot-Googleなど)。*は、名前を指定しない「全体向け」のグループを表す。
公式のrobots.txtの仕様の文書(最終更新2026年8月31日)は、クローラーごとに有効なグループは1つだけだと書いている。そのクローラーに一致する、最も限定的な名前のグループが選ばれ、他のグループは無視される。そして、名前を指定したグループと全体向けのグループは、組み合わされない。
"User agent specific groups and global groups (*) are not combined."
(訳: ユーザーエージェントを指定したグループと、全体向けのグループ(*)は、組み合わされません。)
Mediapartners-Googleと、AdsBot-Google
用語
Mediapartners-Google:広告に関するGoogleの製品が、関連する広告を出すためにページを取得するクローラーである。AdsBot-Google:Google広告が、広告のリンク先ページの品質を確認するために使うクローラーである。名前の似たAdsBot-Google-Mobileは、モバイル向けの表示での確認用である。
逆引きと順引き
用語
逆引き:IPアドレスから、そのアドレスに付いたドメイン名を調べることである。順引き:ドメイン名から、IPアドレスを調べることである。公式の確認手順は、まず逆引きでドメイン名を調べ、次にそのドメイン名を順引きして、最初のIPアドレスと一致することを確かめる、という2段になっている。
「止める」には3種類ある
ここで言う「止めたつもり」は、実は3つの別の操作に分かれる。robots.txtで取得を止めること、noindexで検索結果に出さないこと、パスワードで入れなくすることである。公式のrobots.txtの入門ページは、robots.txtは主にクローラーの通信量を調整するためのもので、ページをGoogleから外す仕組みではないと書いている。3つの違いは、当サイトのnoindex・nofollow・robots.txtは、それぞれ何を止めているのか ── 混同しやすい3つの設定を確認する15項目で詳しく扱った。この記事は、その内容を繰り返さない。
04 型別 — どのページが対象になり、何を、どの順で確かめるか
🅰 適用範囲 — 広告のクローラーが来るページは、2種類
公式文書から読み取れる、広告用のクローラーが取得に来るページは、大きく2つの型に分かれる。どちらに当たるかで、確認する相手が変わる。
| 型 | 来るクローラー | 確認する相手 |
|---|---|---|
| 広告を掲載しているページ | Mediapartners-Google | AdSenseやGoogle Ad Managerの管理画面で、タグを設置したページを調べる |
| 広告のリンク先のページ | AdsBot-Google、AdsBot-Google-Mobile | Google広告の担当者に、リンク先に指定しているURLの一覧をもらう |
| どちらにも当たらないページ | この2種類は、対象外と読める | 広告のタグも、広告のリンク先の指定も無いことを、念のため確かめる |
🅱 公式文書が書いていないこと
次のことは、公式文書に書かれていない。この記事も、断定しない。
- 広告用のクローラーが「*」を無視するようになった日付。文書の更新日は分かるが、挙動の開始日は書かれていない。
- Google Ad Managerの側の説明。この記事で開いたのは、AdSenseの公式ヘルプである。Ad Managerのヘルプでの扱いは、確かめていない。
- 広告のタグがあるページが、noindexなどで検索結果から外れている場合の、取得の頻度。
この記事が確かめていないこと
自社のサイトに、広告用のクローラーが実際に来ているかは、サイトごとに違うため、この記事では確かめていない。確かめ方は、手順4に書いた。
🅲 手順1 — 止めたいページと、止めたくないページを一覧にする
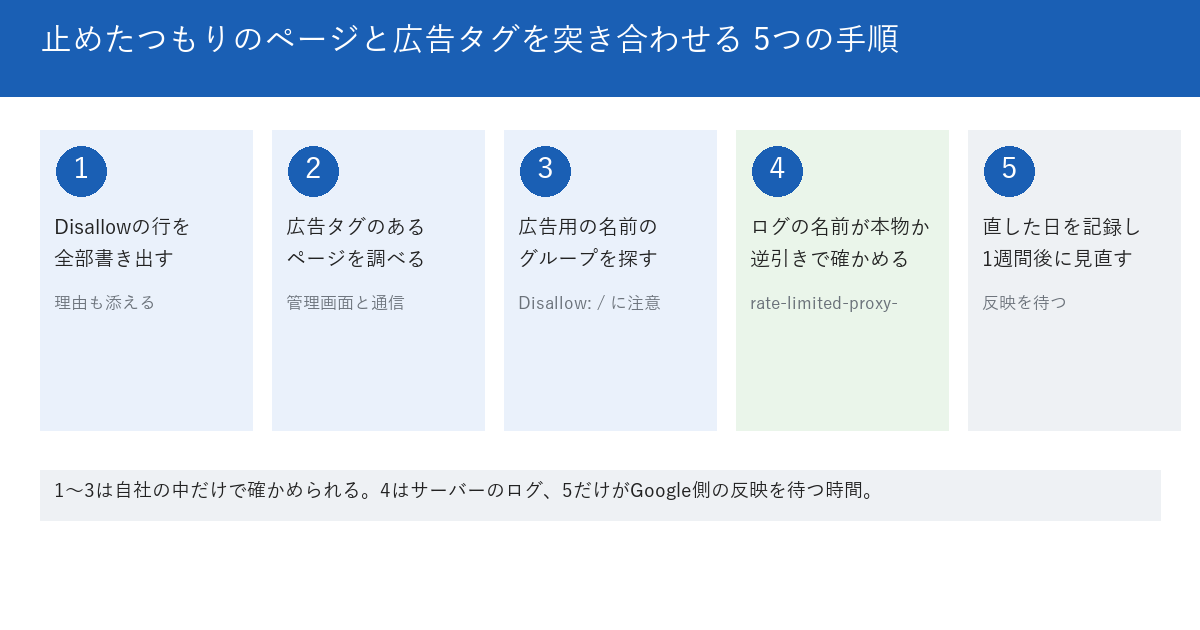
最初に、robots.txtを開いて、Disallow:の行を全部、メモに書き出す。次に、それぞれの行が「なぜ書かれているのか」を、担当者に聞く。会員のページ、検索結果のページ、テスト用のページ、といった理由があれば、その種類も添えておく。理由が分からない行は、「理由不明」と記録する。
この一覧は、後の手順で「広告のタグがあるか」を調べる対象になる。行が多いサイトでは、ページの種類ごとに代表のURLを1つ選んで確かめる方法もある。ただし、種類の取りこぼしが無いように、一覧は全部書き出す。
🅲 手順2 — 広告のタグがあるページを調べる
次に、広告のタグがどのページにあるかを調べる。方法は2つある。1つ目は、広告の管理画面で、タグを設置したサイトとページの一覧を見ることである。2つ目は、手順1で書き出した種類ごとの代表のURLをブラウザで開き、開発者ツールのNetworkタブで、広告の配信元への通信が出るかを見ることである。
タグ管理のサービスから広告が出ている場合は、ページのソースを見ても広告のコードが見つからないことがある。通信まで見るのは、そのためである。タグ管理のサービスで外部ツールがどう管理されているかは、当サイトのサイトにつながる外部ツールと権限は、サービスごとに別々の画面で管理されている ── 計測・CMS・広告の連携を棚卸しする14項目(2026年9月時点)で扱った。
🅲 手順3 — robots.txtを、広告用の名前で読む
robots.txtの中に、Mediapartners-Google、AdsBot-Google、AdsBot-Google-Mobileの名前のグループがあるかを探す。あれば、そのグループの規則が、広告用のクローラーに適用される。無ければ、手順1で書き出した「*」の規則は、広告用のクローラーには適用されない。
AdSenseのヘルプは、AdSenseのクローラーの取得を止めたいときに、robots.txtへ書く名前として、Mediapartners-GoogleとGoogle-Display-Ads-Botの2つを挙げている。Google-Display-Ads-Botは、特殊なケースのクローラーの一覧には載っておらず、「*」が効くかどうかは、確かめた範囲の公式文書には書かれていない。この名前も、グループがあるかを探す対象に入れる。
名前を書いたグループがある場合に、注意すべき点がある。AdSenseの公式ヘルプ「AdSenseのクローラーに、robots.txtでアクセスを許可する」は、User-agent: Mediapartners-Googleの下にDisallow: /を書くと、そのサイトに広告を配信できなくなると説明している。Google広告のヘルプも、リンク先のページの確認で、User-agent: AdsBot-Googleの行を探し、その直後にDisallow: /が無いことを確かめるよう案内している。広告を使っているのに、この行を書くと、広告の側に影響が出る。
🅲 手順4 — ログに来ているのが、本物のクローラーか確かめる
サーバーのアクセスログを調べて、広告用のクローラーの名前が出ているかを探す。ただし、ユーザーエージェントの文字列は、誰でも偽れる。公式文書も、"Caution: The user agent string can be spoofed."(訳: 注意: ユーザーエージェントの文字列は偽装されうる。)と書いている。
本物かどうかは、IPアドレスで確かめる。公式の確認手順は、特殊なケースのクローラーについて、逆引きしたドメイン名がrate-limited-proxy-***-***-***-***.google.comの形になると書いている。コマンドが使える場合は、次のように確かめる。
host 66.249.90.77
host rate-limited-proxy-66-249-90-77.google.com1行目の結果がrate-limited-proxy-で始まるドメイン名になり、2行目の結果が元のIPアドレスと一致すれば、公式の手順に沿った確認ができたことになる(上の数字は、公式文書が例として載せたものである)。
大量のログを機械で見分けるには、Googleが公開している特殊なクローラーのIPアドレスの範囲のファイルと照らし合わせる方法もある。2026年10月4日に取得したこのファイルは、作成日時が2026年10月2日で、IPv4の範囲136件とIPv6の範囲136件が入っていた。範囲が入れ替わることがあるため、使う直前に取り直す。範囲のファイルの置き場所が変わった件は、当サイトのGoogleクローラーのIPレンジJSONファイルが新しい場所へ ── 自社の設定で確認する13項目(2026年9月時点)で扱った。
🅲 手順5 — 直したら、反映を待って、もう一度見る
robots.txtを直したあとの反映には、時間がかかることがある。AdSenseの公式ヘルプ「AdSenseのクローラーに、robots.txtでアクセスを許可する」は、次のように書いている。
"Any changes you make to your robots.txt file might not be reflected in our index until our crawlers attempt to visit your site again."
(訳: robots.txtに加えた変更は、クローラーがもう一度サイトを訪れるまで、Googleの記録に反映されないことがあります。)
robots.txtの変更について、何日かかるかは、確かめた範囲の公式文書には書かれていない。同じ「AdSenseのクローラーについて」のヘルプには、クローラーのレポートが週に1回更新されると書かれているため、直した日付を記録し、1週間後に、手順3と手順4をもう一度行う。
05 自分のサイトで確認するチェックリスト
下の13項目は、1項目5分ほどでできる作業である。項目1〜3が手順1、項目4〜6が手順2、項目7〜9が手順3、項目10〜12が手順4、項目13が手順5に対応している。チェックの状態はブラウザの中にだけ保存され、サーバーには送られない。
- ホームページのアドレスの後ろに/robots.txtを付けてブラウザで開き、Disallowの行を上から全部、メモに書き出して、行の数を数字で書く
- 書き出したDisallowの行それぞれについて、何を止めている行か(会員用・検索結果・テスト用など)を、担当者に聞くか、サイトの画面で確かめて、メモの行ごとに書き添える
- メモの中で、理由を答えられなかった行に「理由不明」と書き、その数を数える
- 広告の管理画面(AdSenseやGoogle Ad Managerなど)を開いて、タグを設置しているサイトと、ページの一覧を、画面ごとにメモに書き出す
- Google広告のリンク先に指定しているURLを、広告の担当者から一覧でもらうか、管理画面で確かめて、メモに書き出す
- 止めたいページ(手順1の一覧)から、種類ごとに代表のURLを1つ選んで開き、開発者ツールのNetworkタブで、広告の配信元への通信が出るかを、1つずつ「出る」か「出ない」かで書く
- robots.txtの中で、Mediapartners-Google・Google-Display-Ads-Bot・AdsBot-Google・AdsBot-Google-Mobileの名前が書かれたUser-agentの行を探し、見つかった行の数を数える(無ければ0と書く)
- 項目7で見つかった名前のグループの中に、Disallow: /(サイト全体の拒否)の行が無いことを、グループごとに1つずつ確かめる
- 手順1の一覧のうち、項目4〜6で広告のタグまたはリンク先の指定が見つかったページに「広告あり」と印を付け、印の数を数える
- サーバーのアクセスログから、Mediapartners-Google・Google-Display-Ads-Bot・AdsBot-Googleの名前が出た行を探し、見つかった件数を、名前ごとに書く
- 項目10で見つかった行のうち、ばらばらのIPアドレスを3つ選び、hostコマンドで逆引きして、rate-limited-proxy-で始まるドメイン名になるかを、アドレスごとに記録する
- 項目11で逆引きの結果が違ったアドレスがあれば、そのアドレスと日付を書き出して、サーバーの管理者または運営会社に、偽装の可能性として伝える
- robots.txtや広告のタグを直した日付を記録し、その1週間後の日付をカレンダーに1つ登録して、項目7と項目10をもう一度行う
チェックリストの使い方
時間が限られているときは、項目1・4・7の3つだけでも、「何を止めているか」「広告のタグはどこにあるか」「広告用の名前のグループがあるか」が分かる。広告を使っていないサイトなら、項目4と項目5で何も出ず、項目7が0であれば、確認は終わりに近い。
06 代替・他の選択肢 — 取得を止めたいときの手段を、表で比べる
広告のタグがあるページを、広告用のクローラーから外す方法
次の表は、「止めたいページに、広告用のクローラーを来させたくない」ときの選択肢を、公式文書から読み取れる範囲で並べたものである。どの方法が「いちばんよい」かは、書かれていない。
| 選択肢 | 公式文書から読み取れること | 先に確かめておくこと |
|---|---|---|
| 広告のタグを外す | AdSenseのクローラーが取得するのは、広告のタグを設置したURLだけと書かれている | タグ管理のサービスの中に、同じタグが残っていないか |
| User-agent: *だけに書く | 広告用のクローラーには、その指定が適用されないと書かれている | 止めたつもりのページが、広告のタグのあるページと重なっていないか |
| 名前を書いたグループで拒否する | AdSenseのクローラーは、名前を指定した拒否には従うと書かれている | サイト全体を拒否すると、広告を配信できなくなる。拒否の範囲を限ったか |
| noindexやパスワードを使う | robots.txtはページをGoogleから外す仕組みではない、と入門ページに書かれている | 広告のリンク先のページを、パスワードで守ると、広告の審査で取得できなくなる |
広告のリンク先は、誰でも開けることが条件
Google広告のヘルプは、リンク先のページがログインなしで誰でも開けることを求め、転送の回数も10回未満にするよう書いている。パスワードで守ったページを、広告のリンク先にしている場合は、そのページをAdsBotが取得できない。ダイナミック検索広告では、"Disapproved: Page cannot be crawled"(訳: 不承認: ページをクロールできません)という状態になると、Google広告のヘルプに書かれている。止めたいページと、広告のリンク先が重なっている場合は、どちらを優先するかを、広告の担当者と先に決めておく。
サイトの状態を一覧で見るときは、ツールを使う
手順1と手順2の前に、サイトの公開ページの基本情報を一覧で見たいときは、当サイトの無料ツール🔧 WEBサイト総合分析・レポートツールが使える。ページ内のリンクの抜けを一覧で見たいときは、🔧 WEBサイト内のリンク漏れ・チェックツールが手がかりになる。どちらも、広告のタグの有無を判定するツールではない。
実務のヒント
robots.txtを直す前に、今の内容を、日付つきで保存しておく。直したあとに広告の側で問題が出たとき、元に戻せる。直すのは、広告の担当者に「robots.txtを変える日」を知らせたあとにする。
注意
公式のrobots.txtの入門ページは、robots.txtで止めたページでも、他のページからのリンクがあれば、URLだけが検索結果に出ることがあると書いている。止めたいのが「検索結果に出すこと」なら、robots.txtでは足りない。noindexまたはパスワードを使う。
07 当サイトで確かめたこと
robots.txtの中身
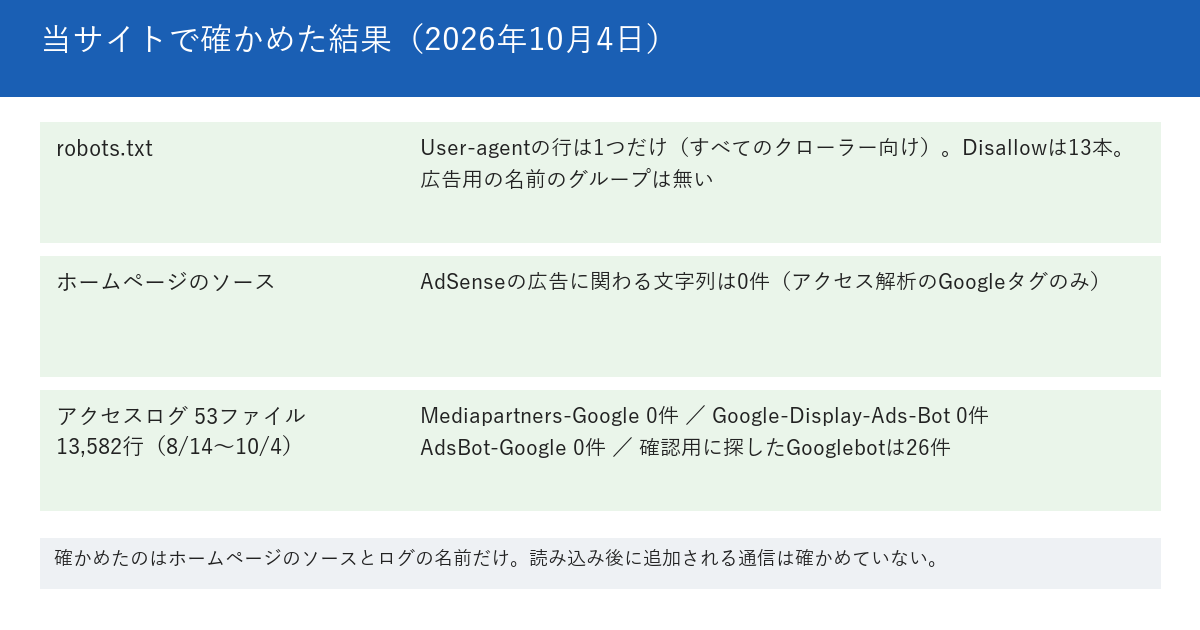
2026年10月4日に、当サイトのrobots.txtを開いた。User-agentの行は1つだけで、すべてのクローラー向けの「*」だった。Mediapartners-Google・Google-Display-Ads-Bot・AdsBot-Google・AdsBot-Google-Mobileの名前を書いたグループは、無かった。Disallowの行は13本で、すべてその「*」のグループの中にある。
広告のタグ
同じ日に、ホームページのソースを取得し、AdSenseの広告に関わる文字列を探した。見つかったのは0件だった。ソースに書かれているのは、アクセス解析のGoogleタグで、広告の配信のタグは見つからなかった。ただし、確かめたのはホームページのソースだけで、ほかのページや、読み込んだあとに追加される通信は確かめていない。
アクセスログ
サーバーに残っている日別のアクセスログを、すべて調べた。ファイル名の日付が2026年8月14日から10月3日までの圧縮ファイル51本と、10月4日付の未圧縮ファイル1本、現行のファイル1本の、合計53ファイル(13,582行)である。圧縮ファイルは展開し、全部をつなげて、grepの-c(行数を数える)と-F(文字列をそのまま探す)で、名前を含む行を数えた。Mediapartners-Google・Google-Display-Ads-Bot・AdsBot-Googleの3つは、どれも0件だった。同じログでGooglebotは26件見つかったため、名前を探す方法は動いている。
当サイトの状態から言えること
当サイトは、この記事の確認をほぼ通過した状態にある。名前のグループが無く、広告のタグも見つからず、ログにも出ていない。この結果は、広告を使っていないサイトでは、確認が短くて済むことを示している。広告を使っているサイトの場合は、同じ手順でも、項目4・5・6・9で、それぞれ「あり」の行が出るはずである。
08 このテーマの、これまで
広告用のクローラーと、robots.txtをめぐる日付つきの記録
| 日付 | 出来事 |
|---|---|
| 2026年2月11日 | Googleが、一般・特殊なケース・ユーザー起動のクローラーのIPアドレスの範囲の置き場所を、新しい場所に変えた(変更履歴より) |
| 2026年3月20日 | Googleのリクエストの確認方法の文書の最終更新日(UTC) |
| 2026年8月31日 | robots.txtの仕様の文書の最終更新日(UTC) |
| 2026年9月17日 | 特殊なケースのクローラーの文書が更新された。Mediapartners-Googleの節の見出しが「AdSense」から「Mediapartners-Google」に変わった |
| 2026年10月2日 | 特殊なクローラーのIPアドレスの範囲のファイルの作成日時(ファイルの中の記載) |
| 2026年10月4日 | この記事のために、公式文書を開き、当サイトのrobots.txtとホームページとログを確かめた |
表の日付のうち、文書の更新日は、ページ末尾に書かれた最終更新日(UTC)である。挙動が変わった日は、どの行にも含まれていない。文書の更新日だけでは、挙動の変更日は分からない。
当サイトの、関連する過去の記事
- 同じ条件で測っていなかった ── robots.txtは「24時間キャッシュ」のはずが、測ったら1日13.9件と152.3件。3サイトの数字を並べる前に確認すべきだったこと — robots.txtの話を、数える条件をそろえて測り直した記録。
- 「AIクローラーが弾かれている」と読みかけた ── 日別に割ったら、正体は数十の名前を名乗る貸しサーバーだった — ログの名前を、日別・発信元別に割って、正体を確かめた記録。
- Cloudflareのデフォルト「AI bots ブロック」があなたのGEOを殺している — robots.txt無関係のインフラ層ブロックと、WEBディレクターが今すぐ確認すべき3つの設定 — robots.txtの外側にあるブロックの話。
- 1163が100 perfectになった日 — AdSenseとGoogleポリシーの矛盾を、AIが判定した瞬間 — AdSenseとGoogleのポリシーを、確かめた記録。
- AIは331回来たと書いた。実際は11,024回だった ── HTTPのログだけを52日間 見ていた — HTTPのログだけを見ていた期間が、数字を小さくしていた話。
現在の貴方のIPアドレス
このサイトで書いている人