WEBサイト
Googlebotの名乗りは誰でも書ける。通す・止めるを名乗りだけで決めず、接続元で確かめる ── 自分のサイトの判定を点検する13項目(2026年10月時点)
Googlebotの名乗りは誰でも書ける。通す・止めるを名乗りだけで決めず、接続元で確かめる ── 自分のサイトの判定を点検する13項目(2026年10月時点)
目次
01 何が起きたか — 名乗りの文字列は偽装できる。Googleは、逆引き・正引きと、公開しているIP範囲の一覧の2つで確かめるよう案内している
新しい発表ではなく、確認の手順をもう一度読み直す記事
先に書いておく。この記事は、新しい機能や仕様変更の発表を伝えるものではない。2026年10月20日に、Googleの「Verify requests from Google crawlers and fetchers」(訳: Googleのクローラーとフェッチャーからのリクエストを確認する)のページを開き、本文を読み直した。ページの最終更新は2026年3月20日と表示されていた。今週の公式の発表のなかに、この手順そのものを変える内容は、確かめられなかった。
それでも今、読み直す理由がある。アクセスを通すか止めるかを、名乗り(User-Agent)の文字列だけで決めている仕組みは、サイトのあちこちに残りやすいからだ。アクセスログに「Googlebot」と書いてあっても、それは接続してきた側が自分で書いた文字列である。ページの閲覧に使うブラウザの名前を変えるのと同じで、誰でも書き換えられる。
Googleのページが書いていること
ページの冒頭は、確認の目的をこう書いている。
"This is useful if you're concerned that spammers or other troublemakers are accessing your site while claiming to be from Google."
(訳: これは、スパマーやその他の迷惑な者が、Googleを名乗ってサイトにアクセスしていないかが気になるときに役立つ。)
つまり、Google自身が「Googleを名乗る別のアクセス」が来ることを前提に、確かめる手順を公開している。さらに、一般的なクローラーの一覧のページ(最終更新2026年10月15日)にも、次の注意書きがある。
"The HTTP user agent string can be spoofed."
(訳: HTTPのユーザーエージェントの文字列は、偽装されうる。)
確認の方法は2つある
確認ページは、方法を2つに分けている。1つは、コマンドラインの道具で1件ずつ調べる方法で、もう1つは、公開されているIPアドレスの一覧に自動で照らす方法である。
"Manually: For one-off lookups, use command line tools. This method is sufficient for most use cases."
(訳: 手動: 1回かぎりの調べには、コマンドラインの道具を使う。この方法は、たいていの使い方に足りる。)
"Automatically: For large scale lookups, use an automatic solution to match a crawler's IP address against the list of published Google IP addresses."
(訳: 自動: 大量の調べには、自動の仕組みを使い、クローラーのIPアドレスを、公開されているGoogleのIPアドレスの一覧と照らす。)
逆引き・正引きの手順(公式の説明を要旨で)
手動の手順は4つの動作である。ログに残った接続元のIPアドレスについて、hostコマンドで逆引きをして、返ってきたドメイン名が、googlebot.com・google.com・googleusercontent.comのどれかであることを見る。次に、その名前を正引きして、元のIPアドレスと同じ答えが返るかを見る。ページには、Googlebotの例として、66.249.66.1を引くとcrawl-66-249-66-1.googlebot.comが返り、その名前を引くと66.249.66.1に戻る様子が載っている。
Googleのクローラーには3つの種類がある
ページは、Googleの取得する側を3種類に分け、種類ごとに、逆引きで返る名前の形と、IP範囲のファイル名を示している。
| 種類 | ページの説明(要旨) | 逆引きで返る名前の形 | IP範囲のファイル |
|---|---|---|---|
| 一般的なクローラー | Googlebotのように、Googleの製品に使う。自動の取得では、robots.txtの規則に常に従う | crawl-***-***-***-***.googlebot.com、またはgeo-crawl-***.geo.googlebot.com | common-crawlers.json |
| 特別な用途のクローラー | AdsBotのように、特定の機能を担う。robots.txtに従う場合と従わない場合がある | rate-limited-proxy-***-***-***-***.google.com | special-crawlers.json |
| 利用者が起点の取得 | 利用者の操作で動く。利用者が頼んだ取得なので、robots.txtの規則を無視する | google-proxy-***.google.com、またはgae.googleusercontent.comの名前 | user-triggered-fetchers.jsonなど3本 |
表のとおり、Googleの名乗りが1つの種類にまとまっているわけではない。種類によってrobots.txtへの従い方が違うので、名乗りだけで「Googleだから規則に従うはず」と読むと、判断を誤る。公式の説明では、特別な用途のクローラーについて、次のように書かれている。
"These crawlers or fetchers may or may not respect robots.txt rules."
(訳: これらのクローラーやフェッチャーは、robots.txtの規則に従うこともあれば、従わないこともある。)
IP範囲の一覧の置き場所が新しくなった経緯は、当サイトの解説記事「GoogleクローラーのIPレンジJSONファイルが新しい場所へ ── 自社の設定で確認する13項目(2026年9月時点)」に書いた。この記事では繰り返さず、一覧のファイルが、今は確認ページに並んでいることだけを前提にする。
02 なぜ・背景 — 名乗りだけの判定は、偽物を通し、本物を止める、両方向の誤りを起こす
誤りの向きは2つある
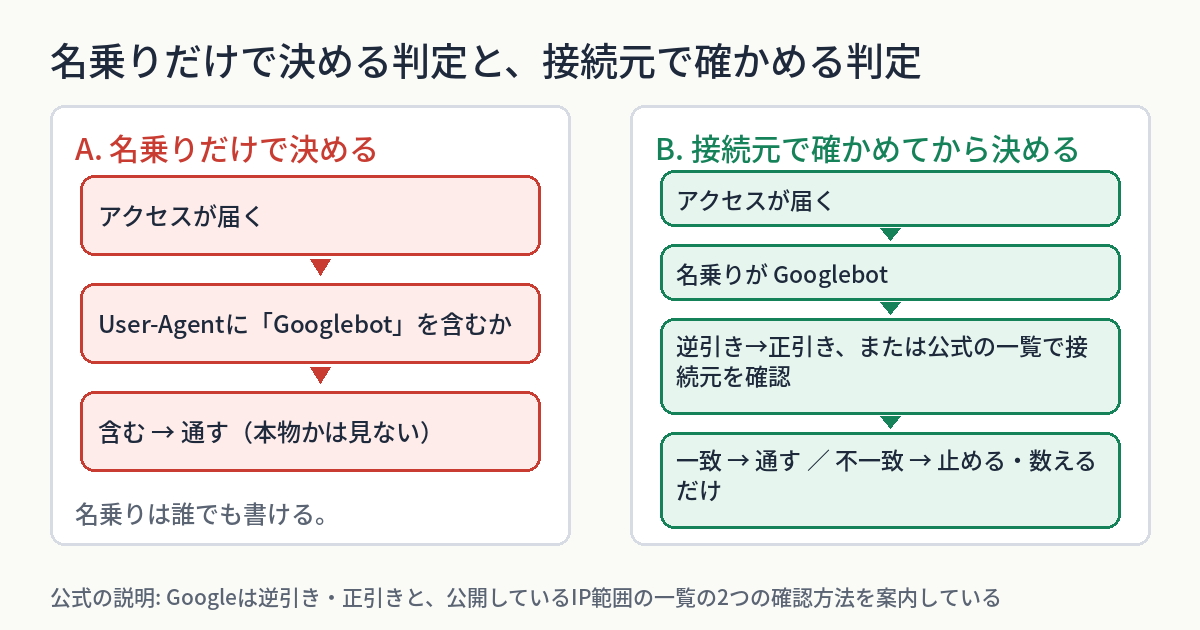
名乗りだけで通す・止めるを決める仕組みは、誤りが2つの向きに出る。1つ目は、偽物を通す誤りである。「Googlebotを含むアクセスは通す」と書いた条件があれば、同じ文字列を書いただけのアクセスも通る。2つ目は、本物を止める誤りである。「名乗りに『bot』を含むアクセスは止める」と書けば、本物のGooglebotも一緒に止まる。どちらも、名乗りという1つの文字列に、本物かどうかの判断を任せたために起きる。
当サイトでも、名乗りだけで読みかけた
当サイトは、この誤りを自分で踏みかけた。当サイトの記事「「AIクローラーが弾かれている」と読みかけた ── 日別に割ったら、正体は数十の名前を名乗る貸しサーバーだった」では、AIの検索のクローラーの名前で大量の403が出ていると読みかけた。日ごとに割ると、1日に1台の貸しサーバーが、数十の名前を使い分けていた。
「本物か」を数える方法は、公式が書いている
名乗りを疑うことと、本物を確かめる方法を持つことは別である。確かめる方法は、各社が自分のページで書いている。Perplexityの文書は、アクセス制限の設定にあたって、次の形を勧めている。
"When configuring WAF rules for Perplexity bots, combine both User-Agent string matching and IP address verification for enhanced security while ensuring legitimate bot traffic can access your content."
(訳: Perplexityのボット向けにWAF(Webアプリケーションのファイアウォール)の規則を設定するときは、安全性を高めつつ正規のボットの通信が内容に届くよう、ユーザーエージェントの文字列の一致と、IPアドレスの確認の両方を組み合わせる。)
名乗りは捨てるものではなく、接続元と組み合わせて使う材料である、という位置づけだ。Anthropicのヘルプのページ(2026年10月20日に開いた。ページには「更新から6か月以上」と表示されていた)も、一覧との照合で本物を確かめる考え方を示している。
"If a crawler has a source IP address on this list, it indicates that the crawler is coming from Anthropic."
(訳: クローラーの接続元のIPアドレスがこの一覧にあれば、そのクローラーはAnthropicから来ている。)
一覧の外にあるアクセスが、すべて偽物とは限らない
注意
照合を始める前に、読み違えやすい点を書いておく。一覧と合わないことは、偽物の証明ではない。一覧には作成日があり、数えたい期間の途中で更新されていれば、更新前に使われていた範囲は「合わない」に入る。一覧を出している会社が、全部の発信元を載せているとも限らない。当サイトの数字を数え直した記事「Cloudflareが確認済みのボットを「行儀」で評価し始めた週、当サイトの9つの名乗りの取得(4,317行)の18.1%は、公式のIPアドレスの一覧と合わなかった ── 14日分のログで数え直した」でも、この点を分けて書いた。
03 用語 — User-Agent、逆引き・正引き、CIDR、許可の一覧
User-Agent(名乗り)
用語
User-Agentは、リクエストを送る側が、自分の種類を伝えるために送る文字列である。ブラウザも、検索のクローラーも、自動の道具も、この欄に好きな文字列を入れられる。サーバーは、届いた文字列をそのまま記録するだけで、本物かどうかは分からない。この記事では、読みやすくするため、「名乗り」と書く。
逆引きと正引き
用語
逆引きは、IPアドレスから、そのIPアドレスに結び付けられたドメイン名を引く調べである。正引きは、ドメイン名から、IPアドレスを引く調べである。Googleの手順は、逆引きで得た名前を、もう一度正引きして、元のIPアドレスに戻るかまで確かめる。
CIDRとIPアドレスの範囲
CIDRは、IPアドレスの範囲を、「アドレス/先頭から何ビットが共通か」の形で書く表記である。たとえば、66.249.66.0/24は、66.249.66.0から66.249.66.255までの256個の範囲を表す。各社が公開しているJSONの一覧には、この形の範囲が並んでいる。Googleのページも、JSONの中のIPアドレスはCIDR形式で表される、と書いている。
許可の一覧と、取り直しの手間
サーバーやWAFの設定で、「このIPアドレスの範囲は通す」と決めておく一覧を、この記事では許可の一覧と呼ぶ。許可の一覧は、公式の一覧が更新されたときに、人が取り直して入れ替えるものだ。取り直しを忘れると、本物の新しい範囲が止まる。
04 型別 — 名乗りを使っている場所を、「通す」「止める」「数える」の3つに分けて見る
A. この記事が当てはまるサイト
当てはまるのは、アクセスの扱いを、サーバーの設定・WAF・プラグイン・アプリのコードのどこかで決めているサイトである。レンタルサーバーの管理画面に「特定のボットを許可する」「特定のボットを拒否する」という欄があるなら、その欄の中身も対象になる。
B. 通す条件に名乗りを使っている
注意
いちばん危ないのは、通す条件に名乗りを使っている場所である。たとえば、会員向けの画面や、回数を制限している画面に、「Googlebotなら制限しない」という例外を書いている場合だ。例外の条件が名乗りだけなら、同じ文字列を書いた誰もが、制限をすり抜けられる。通す例外は、接続元(逆引き・正引き、または公式の一覧)で決める形に寄せる。
C. 止める条件に名乗りを使っている
止める条件に名乗りを使うことは、通す条件ほど危なくはない。名乗りを書いたアクセスを止めても、偽物を止めているだけだからだ。ただし、条件が広すぎると、本物を巻き込む。「名乗りに『bot』を含むと止める」のような部分一致は、本物の検索のクローラーも止めうる。止めたあとに、本物が止まっていないかを数えるのが、この型の確認である。
D. CDNやプロキシの後ろにあるサイト
もう1つの型は、CDNやリバースプロキシの後ろにサイトを置いている場合である。サーバーのログに残る接続元が、プロキシ自身のアドレスになり、本当の接続元は別のヘッダー(X-Forwarded-Forなど)に入る。ここでの注意は、そのヘッダーはプロキシを通らずに直接送られた場合には、誰でも書けるという点である(これは一般的な注意で、特定のサービスの文書にある文ではない)。どの段で本当の接続元を取り出しているかを、先に確かめる。
会社ごとに、確認の材料は違う
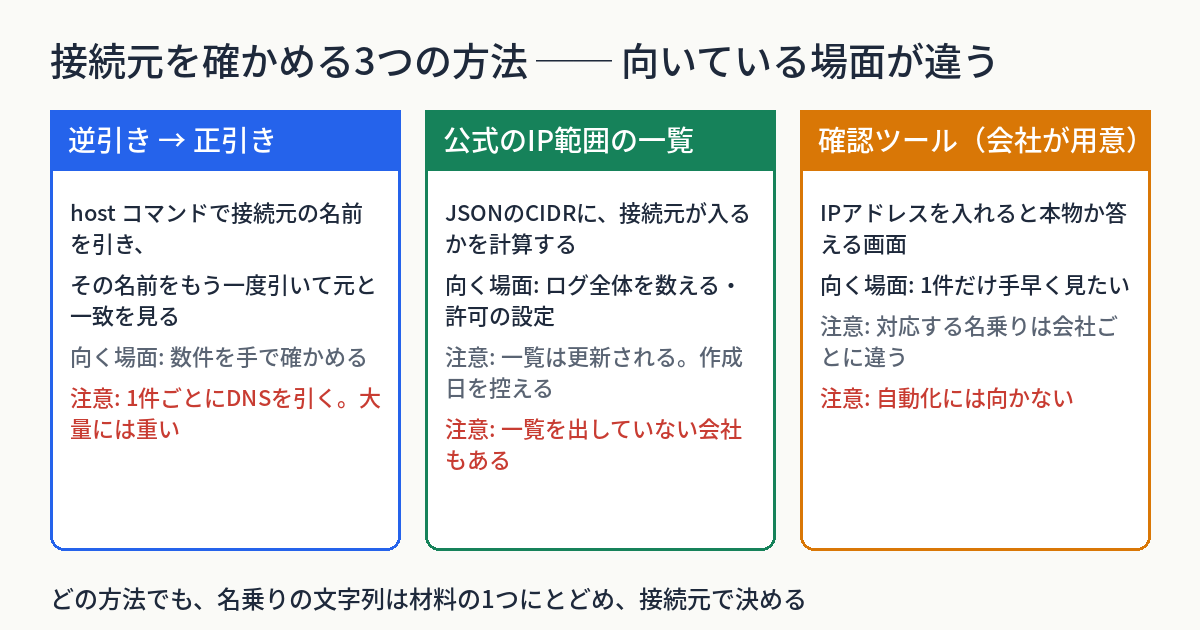
名乗りを公式の材料と照らすとき、材料の出し方は会社ごとに違う。2026年10月20日に各社のページを開いて確かめた範囲を、表にまとめた。「確かめていない」と書いた欄は、このページ群の本文では見つけられなかったものである。
| 会社・名乗り | 公式のIP範囲の一覧 | 逆引き・ほかの方法 |
|---|---|---|
| common-crawlers.jsonなど、5本のJSON | 逆引きと正引き(googlebot.com・google.com・googleusercontent.com) | |
| Bing | bingbot.json(2026年10月20日に開いて存在を確認) | IPアドレスを入れて確かめる「Bingbot検証ツール」の画面がある。逆引きの扱いは確かめていない |
| OpenAI | OAI-SearchBot・GPTBot・ChatGPT-User・OAI-AdsBotの名前ごとにJSONがある | 逆引きは、読んだページでは確かめていない |
| Perplexity | PerplexityBotとPerplexity-Userの名前ごとにJSONがある | 逆引きは、読んだページでは確かめていない |
| Anthropic | ヘルプのページに一覧へのリンクがある(bots.json) | 逆引きは、読んだページでは確かめていない |
| Apple | applebot.jsonがある | 逆引きで、applebot.apple.comのドメインになるかを見る |
Appleのページは、逆引きを最初の方法に挙げている。
"Traffic coming from Applebot is generally identified by using reverse DNS in the *.applebot.apple.com domain."
(訳: Applebotからの通信は、たいてい、*.applebot.apple.comのドメインでの逆引きによって見分けられる。)
OpenAIのChatGPT-Userについては、公式のページに、別の注意がある。利用者の操作で動く名乗りなので、robots.txtの規則が当てはまらないことがある。
"Because these actions are initiated by a user, robots.txt rules may not apply."
(訳: これらの動作は利用者が起点になっているので、robots.txtの規則は当てはまらないことがある。)
05 自分のサイトで確認するチェックリスト
下の13項目は、1項目5分ほどでできる作業である。項目4から11は、アクセスログを開く。ログを見られない環境のときは、その項目を飛ばして、残りだけでもよい。項目6と7はhostコマンドが使える環境で行う。チェックの状態はブラウザの中にだけ保存され、サーバーには送られない。
- サーバーの設定・WAF・プラグイン・アプリのコードの4か所を開き、名乗りの文字列を条件に使っている箇所が合計でいくつあるかを書く
- 項目1の各箇所を、「通す」「止める」「数えるだけ」のどれに使っているかに分け、それぞれの個数を書く
- 項目1のうち、名乗りに「含む」で当てている条件(部分一致)が何個あるかを数えて書く
- サイトがCDNやプロキシの後ろにあるかを調べ、ログの先頭5行の接続元が、プロキシのアドレスになっていないかを「なっている」「なっていない」で書く
- アクセスログの直近7日から、Googlebotを名乗る行を取り出し、行数と、接続元のアドレスが何種類あるかを書く
- 項目5の接続元を多い順に3つ選び、hostコマンドで逆引きして、返った名前がgooglebot.com・google.com・googleusercontent.comのどれかを、1つずつ書く
- 項目6で得た名前をhostコマンドで正引きし、元のIPアドレスと同じかを、3つとも「同じ」「違う」で書く
- Googleのcommon-crawlers.jsonを1つ保存し、creationTimeの値と、prefixesの数を書く
- 項目5の全部の行を、項目8の範囲に照らし、「入る行数」と「入らない行数」を書く(Pythonのipaddressで数行で書ける)
- 項目9で「入らない」行の応答ステータスを、200・403・その他に分けて、件数を書く
- 公式の一覧を出している別の名乗りを1つ選び(OpenAIやBingなど)、項目8から10と同じ手順で、入る行数と入らない行数を書く
- 許可の一覧にIPアドレスの範囲を入れている場合は、最新の公式の一覧と突き合わせ、一覧にあって許可の一覧に無い範囲が何件あるかを書く
- 公式の一覧を取り直す頻度を「毎日」「毎週」「毎月」のどれかに決め、次に取り直す日付を、記録に書く
項目9の数え方の例
公式のJSONの一覧には、IPアドレスの範囲が、ipv4Prefixまたはipv6Prefixという名前で並んでいる。Pythonの標準のipaddressを使うと、次のように書ける。
import ipaddress, json
data = json.load(open("common-crawlers.json"))
print(data["creationTime"], len(data["prefixes"]))
nets = [ipaddress.ip_network(p.get("ipv4Prefix") or p["ipv6Prefix"])
        for p in data["prefixes"]]
def in_list(ip):
    a = ipaddress.ip_address(ip)
    return any(a in n for n in nets)   # IPv4とIPv6が混ざっても、違う種類はFalseになる
ヒント
ログの1行ごとに接続元を取り出して、in_listに渡し、結果を名乗りごとに数える。接続元の取り出し方は、ログの書式で変わる。列の位置を決め打ちせず、先頭の数行を目で見て、接続元がどの列かを確かめてから数える。
06 代替・他の選択肢 — 本物かを確かめる方法は、1つではない
名乗りだけで続ける
いちばん手間がかからないが、偽物も通る。会員向けの画面の例外や、回数制限の例外にこの形を使っている場合は、避ける。名乗りを、数えるだけの用途にとどめるなら、問題は小さい。
逆引きと正引きを使う
公式が手動で十分と書く方法で、数件の確認に向く。長所は、一覧の更新を待たずに、いまその接続元が公式のドメインを持っているかが分かることである。短所は、1件ごとにDNSを引くので、ログ全体には重いことである。結果をいったん保存して、同じ接続元の再確認を省く形にすると、軽くなる(これは筆者の整理である)。
公式のIP範囲の一覧に照らす
ログ全体を数える仕事や、許可の設定には、一覧に照らす方法が向く。計算だけで済み、DNSを引かない。短所は、一覧が更新されることと、一覧を出していない会社があることである。作成日を控え、定期的に取り直す。
確認ツールを使う
Bingは、IPアドレスを入れると、Bingbotかどうかを調べる画面を用意している。1件だけ手早く見たいときに便利である。大量の確認や自動化には向かない。
署名で本物を確かめる方向
名乗りの文字列ではなく、リクエストに付いた署名で身元を確かめる方向の標準化も進んでいる。当サイトの解説記事「Cloudflareは確認済みボットを、名乗りが本物かに加えて、robots.txtと429を守り続けているかでも評価し続ける仕組みを書いた ── 自分のサイトのrobots.txtと429がボットに読める形かを確認する13項目(2026年10月時点)」は、確認済みボットの仕組みのなかで、署名による身元の確認にも触れている。署名が広く使われるまでは、この記事の方法が当面の手段になる。
07 当サイトで確かめたこと
当サイト(WEBサイトサポート)は、この記事の項目5と、項目8から10にあたる数え直しを、2026年10月17日に行った。結果は、当サイトの運営者ブログの記事「Cloudflareが確認済みのボットを「行儀」で評価し始めた週、当サイトの9つの名乗りの取得(4,317行)の18.1%は、公式のIPアドレスの一覧と合わなかった ── 14日分のログで数え直した」に書いた。この章では、そこから、名乗りを接続元で確かめる意味が伝わる数字だけを、記事の本文を開き直して写す。
数えた範囲
対象は、本番サイトのHTTPSのアクセスログで、2026年10月3日から16日までの14日分(53ファイル、248,039行)である。HTTPとHTTPSでログのファイルが分かれていて、当サイトの記事「AIは331回来たと書いた。実際は11,024回だった ── HTTPのログだけを52日間 見ていた」のように、HTTPのログだけを数えて大きく外した経験があるため、今回は最初からHTTPSのログを対象にした。その中から、名乗りが9つのうちのどれかである行を取り出し、接続元のIPアドレスが、名乗った会社の公式の一覧のどれかの範囲に入るかを調べた。数えているのは行、つまりリクエストの数で、ページの数でも人の数でもない。
全体の結果
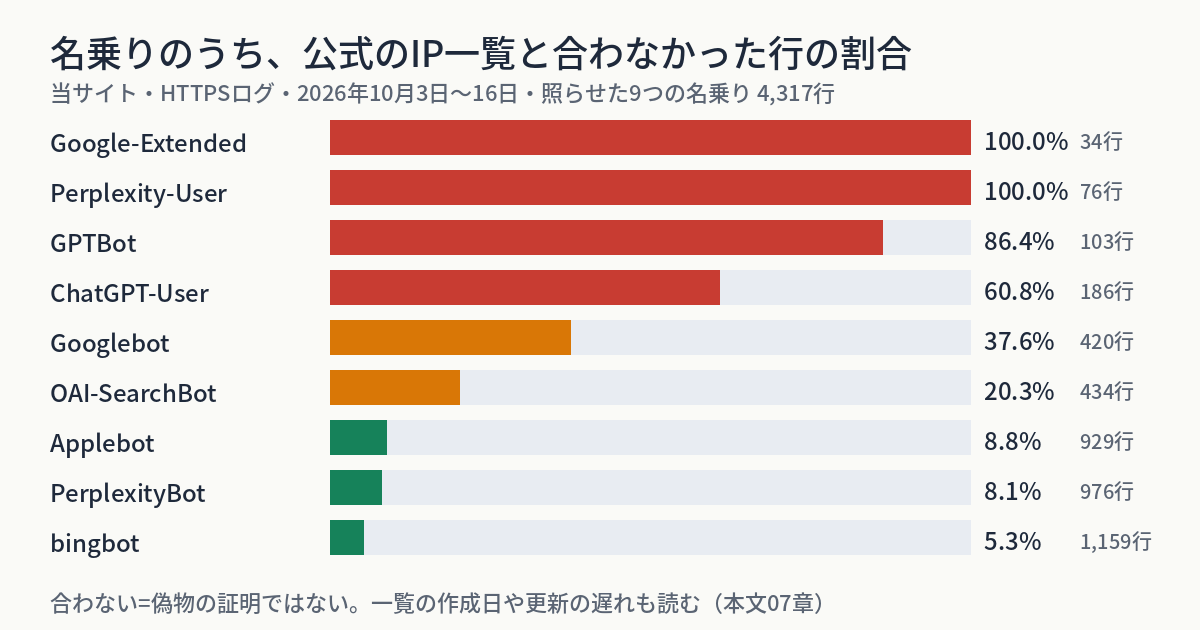
照らせた9つの名乗りの取得は、合計4,317行だった。このうち、名乗った会社の公式の一覧と合わなかったのは780行(18.1%)である。なお、一覧と照らしていない名乗りは、この数に入っていない。
Googlebotを名乗る行の37.6%は、一覧の外だった
Googlebotを名乗る行は420行あり、うち262行は一覧と合い、158行(37.6%)は合わなかった。合わなかった158行のうち、153行は403で返していて、5行は200で返していた。この5行が200になった理由は、調べていない。
GPTBotを名乗る行の86.4%は、一覧の外だった
GPTBotを名乗る行は103行で、OpenAIの一覧と合ったのは14行しかなく、89行(86.4%)が合わなかった。しかも、合った14行が取っていたのは、sitemap.xmlの1つだけだった。名乗りだけで数えると「GPTBotが100回以上来た」と書けるが、本物と言えるのは14回だけになる。
偽物を止める設定が、本物まで止めていないか
一覧と合わない780行のうち、403で断っていたのは775行(99.4%)だった。一方、一覧と合う3,537行のうち、403だったのは、ChatGPT-Userの1行だけである。偽物を止める設定は、本物を巻き込んでいないかを、数えるまで言えない。今回は数えて、巻き込みが1行あることが分かった。
その1行は、設定にまだ入っていなかった範囲だった
2026年10月19日に、その1行の理由を調べた。発信元は、OpenAIの公式の一覧には入っていたが、当サイトの設定には、まだ入っていなかった範囲だった。公式の一覧は毎週自動で取り直しているが、設定に足すのは人の手である。取り直しと、設定への反映が、別の手間になっていた。同じ日に、一覧にあって設定に無かった範囲を足した。この記事のチェックリストの項目12は、この経験から入れた。
一覧と合わないことは、偽物の証明ではない
当サイトの数字にも、同じ限定が付く。ChatGPT-Userの一覧の作成日は10月7日で、ログは10月3日からあるため、3日から6日の間に使われていた範囲が一覧に無ければ、その間の本物が「合わない」に入る。bingbotの一覧は2024年1月、PerplexityBotの一覧は2025年2月の作成で、古い。Perplexity-Userを名乗る76行は、全部が一覧の外だったが、名乗りをまねたものか、一覧に載っていない範囲から来る本物かは、分けられなかった。分けるには、一覧を取り直して、日を変えて数え直すしかない。
確かめていないこと
注意
今回の数え直しは、一覧との照合だけで行った。逆引き・正引きは使っていない。Googlebotを名乗る行で一覧の外だった158行を、逆引きと正引きでも確かめたわけではない。また、Anthropic・Amazon・Metaなど、今回は一覧と照らしていない名乗りもある。この記事のチェックリストの項目6と7は、これから当サイトでも、数件を選んで行う。結果は、この記事の末尾に、日付をつけて追記する。
08 このテーマの、これまで
| 日付 | できごと |
|---|---|
| 2026年3月20日 | Googleの「Verify requests from Google crawlers and fetchers」のページの最終更新日(ページの表示) |
| 2026年9月4日 | Appleの「About Applebot」のページに表示されている公開日 |
| 2026年10月7日 | 当サイトが数え直した記事によると、AnthropicとChatGPT-Userの一覧の作成日 |
| 2026年10月15日 | Googleの一般的なクローラーの一覧のページの最終更新日(ページの表示) |
| 2026年10月17日 | 当サイトが、14日分のログを9つの名乗りで公式の一覧と照らして数え直した |
| 2026年10月19日 | 当サイトが、ChatGPT-Userで断った1行の理由を調べ、一覧にあって設定に無かった範囲を足した。Googleの一般的なクローラーのJSONの作成日時もこの日(2026年10月20日に開いて確認) |
| 2026年10月20日 | この記事の確認の日。各社のページと、一覧のJSONを開き直した |
表の2026年10月7日の行は、当サイトの記事に書いた日付を写したもので、各社のページでは確かめ直していない。
- Cloudflareが確認済みのボットを「行儀」で評価し始めた週、当サイトの9つの名乗りの取得(4,317行)の18.1%は、公式のIPアドレスの一覧と合わなかった ── 14日分のログで数え直した
- Cloudflareが通信の半分以上は人間ではないと書いた週、当サイトのログで自動と分かるものは36.2%だった ── 他人の大きな数字を、自社のログ1週間分で数え直す
- 「AIクローラーが弾かれている」と読みかけた ── 日別に割ったら、正体は数十の名前を名乗る貸しサーバーだった
- AIは331回来たと書いた。実際は11,024回だった ── HTTPのログだけを52日間 見ていた
- Cloudflareが9月15日に加えた「AI学習だけを止める」設定 ── 検索に載せたまま止められる範囲と、今週確かめる6つ
現在の貴方のIPアドレス
このサイトで書いている人