WEBサイト
Cloudflareは確認済みボットを、名乗りが本物かに加えて、robots.txtと429を守り続けているかでも評価し続ける仕組みを書いた ── 自分のサイトのrobots.txtと429がボットに読める形かを確認する13項目(2026年10月時点)
Cloudflareは確認済みボットを、名乗りが本物かに加えて、robots.txtと429を守り続けているかでも評価し続ける仕組みを書いた ── 自分のサイトのrobots.txtと429がボットに読める形かを確認する13項目(2026年10月時点)
目次
- 01 何が起きたか — Cloudflareは確認済みボットを、名乗りが本物かだけでなく、robots.txtと429を守り続けているかでも見ると書いた
- 02 なぜ・背景 — 名乗りの確認だけでは、サイトの希望が守られるとは限らない
- 03 用語 — 確認済みボット、信頼の帯、Web Bot Auth、BotBase、429、Retry-After
- 04 型別 — 規則と合図が読める形かを、3つに分けて確かめる
- 05 自分のサイトで確認するチェックリスト
- 06 代替・他の選択肢 — ボットに守ってもらう手段は、robots.txt以外にもある
- 07 当サイトで確かめたこと
- 08 このテーマの、これまで
- 09 この記事のまとめ
01 何が起きたか — Cloudflareは確認済みボットを、名乗りが本物かだけでなく、robots.txtと429を守り続けているかでも見ると書いた
2026年10月16日のCloudflareのブログ
Cloudflareの公式ブログに、確認済みボット(Verified bots)の評価の仕組みを足したという記事が出た。題は「Continuous accountability for Verified bots」(訳: 確認済みボットへの、継続的な説明責任)で、日付は2026年10月16日、書き手はChris Tsoukaladelis氏と記されている。2026年10月17日に開いて、本文を読んだ。
先に断っておく。この記事が書くのは、Cloudflareというサービスの、確認済みボットの扱いの話である。当サイトはCloudflareを通していないので、評価を見る側ではない。それでも、この話は、自分のサイトを持つ人に関係する。ボットを評価する側が見ているのは、サイトが公開した規則(robots.txt)と、サイトが返した合図(429)に、ボットがどう動いたかである。つまり、Cloudflareを通る通信については、規則と合図が読める形で出ていなければ、評価の材料にもならない。この記事は、その用意を自分のサイトで確かめる手順にした。
運転免許の例えと、「リスク」と「信頼」の違い
ブログは、運転免許を例に始まる。免許は、持ち主が誰で、運転の試験に受かったことを示すが、これから責任をもって運転するかは示さない。ボットも同じで、運営者を確かめれば責任の所在は分かるが、信頼は、そのあとの行動で決まる、と書く。知られたボットでも、サイトの希望を無視したり、取得元に負荷をかけたり、制御をすり抜けたりすることがある。悪意とは限らず、設定の誤りや不具合のことも多い、とも書いている。
そのうえで、ブログは2つの言葉を分ける。リスクは、ある時点の1つの要求が有害になりうる可能性で、瞬間ごとに変わる。信頼は、くり返される一貫した行動で築かれる。
"Trust is built over time through repeated and consistent behavior."
(訳: 信頼は、くり返される一貫した行動によって、時間をかけて築かれる。)
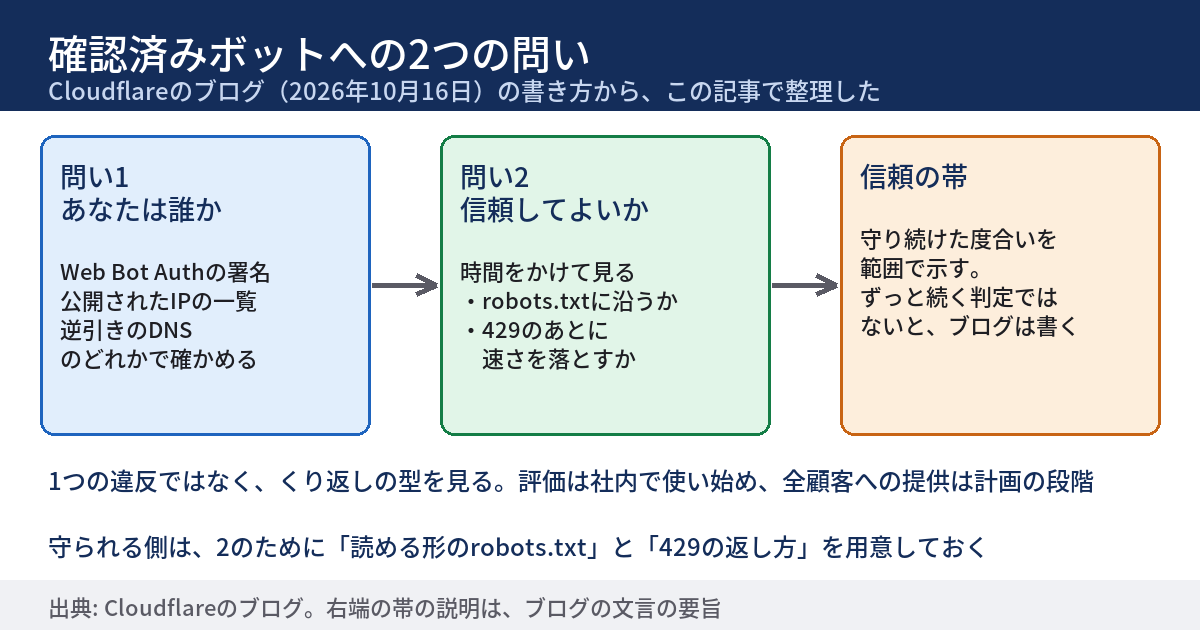
評価する2つの信号
ブログは、ボットが「害をなさない」という規則を守っているかを測る仕組みを、今日紹介する、と書く。最初に評価する信号は、次の2つである。
| 信号 | ブログの問い | サイトの側が出す材料 |
|---|---|---|
| 指示に従うか | ボットは、サイトの指示を尊重しているか(robots.txtと、時間をかけた観測の一致) | 公開したrobots.txt |
| 合図に応えるか | ボットは、直接のフィードバックに応えたか(429を受けたあとに、速さを落とすか) | 返した429と、待ち時間の案内 |
どちらの信号を重く見るかは、ブログには書かれていない。2つは並べて挙げられているだけで、点数の付け方や重みも示されていない。サイトの側から見ると、robots.txtは事前に出しておく規則で、429はその場で返す合図である。役割が違うので、どちらか一方ではなく、両方を読める形にしておくのが確実である。
評価は、信頼の帯(trust band)という形で表す、とブログは書く。ボットが、サイトの希望をどれだけ一貫して守ってきたかと、どの行動を材料にしたかを示す範囲で、ボットやその運営者への、ずっと続く判定ではない、という説明である。
まだ始まっていないこと
ブログには、予定と今の状態が、はっきり書き分けられている。今の状態は、Cloudflareが社内でこの仕組みを使い始めているところまでである。顧客に提供する予定として、次のように書かれている。
"we plan to make the system available to all Cloudflare customers, who will be able to choose the trust threshold used to decide how Verified bot traffic is handled."
(訳: この仕組みを、すべてのCloudflareの顧客に使えるようにする計画で、顧客は、確認済みボットの通信をどう扱うかを決める信頼の閾値を、選べるようになる。)
評価の点を、Radarで公開することも、「将来」と書かれている。つまり、今日の時点で、顧客が信頼の帯を画面で見られる、とは書かれていない。日付は、ブログに書かれていないので、この記事も書かない。
02 なぜ・背景 — 名乗りの確認だけでは、サイトの希望が守られるとは限らない
確認済みボットになる3つの条件
ブログは、確認済みボットになるには、大きく3つの条件を満たす必要があると書く。正確で安全に名乗ること、言ったことだけをすること、乱用的な行動をしないことである。ボットはWeb Bot Authという署名を要求に付けて身元を示し、その記録はBotBaseという一覧に、公開された形式でまとめられる。名乗りの問題は、これで扱えるので、次の焦点は2つ目の条件、つまり「害をなさない」に移る、とブログは書く。
Cloudflareの文書も、名乗りと行動の2本立てである点は同じである。確認済みボットとは、自分が誰で、何をするかを透明にしているボットまたはエージェントで、2つの基準を満たすという。1つは正直な名乗り、もう1つは乱用しない行動である。
"Non-abusive behavior — it obeys robots.txt and crawl directives, maintains reasonable request rates, and has not been observed evading website owner preferences or attacking sites."
(訳: 乱用しない行動 — robots.txtと取得の指示に従い、無理のない要求の速さを保ち、サイトの持ち主の希望をすり抜けたり、サイトを攻撃したりしているところを観測されていない。)
2025年のPerplexityの除外
ブログは、前例として、2025年にPerplexityのボットを確認済みの一覧から外したことを挙げている。取得を断っているサイトの資源に取りに行き、断られたあとに、制御を回避しようとしたため、という説明である。この件は、2025年8月4日のCloudflareのブログにも書かれている。名乗りが確認できても、行動が合わなければ、一覧から外れる、という実例である。
「守る」から「見分ける」へ
当サイトは、これまでにも、ボットの扱いの変化を何度か書いた。名乗りの署名による確認が、標準化に向かう動きは、IETF WebBotAuth WG が発足した日 — 標準化が始まった、半歩先で警告した側の次の責任に書いた。ボットを一括で守るのではなく、見分けて扱う方向へ変わる流れは、「守る」から「見分ける」へ ── Cloudflare Precursor GAが変えるbot対策と、WEBディレクターが今週確認すべき3点に書いた。今回は、その「見分けたあと」に、行動を見続ける段が加わった、という位置づけである。
Cloudflareを使っていないサイトにとっての意味
評価の仕組みは、Cloudflareの中で動く。使っていないサイトが、信頼の帯を見ることはない。それでも、確かめられることがある。robots.txtが、ボットに読める形で出ているかと、429を返す仕組みがあるなら、その返し方が標準に沿っているかである。どちらも、Cloudflareに関係なく、自分のサイトの側の用意で、ボットに規則を守ってもらうための前提になる。
03 用語 — 確認済みボット、信頼の帯、Web Bot Auth、BotBase、429、Retry-After
確認済みボット(Verified bot)と信頼の帯(trust band)
用語
確認済みボットは、Cloudflareが、運営者と目的の透明さを確かめたボットである。信頼の帯は、そのボットが、サイトの希望をどれだけ一貫して守ってきたかを示す範囲で、評価に使った行動を説明できる形にする、とブログは書く。
Web Bot AuthとBotBase
Web Bot Authは、ボットが、自分の要求に署名を付けて、身元を示す方法である。署名した要求を受けたサイトは、名乗りが偽装でないかを、暗号で確かめられる。BotBaseは、確認済みのボットを、公開された形式で記録する一覧で、Cloudflareの文書では、Radarのボットとエージェントの一覧として公開される、と書かれている。
Bot Preference SyncとBot Management
ブログは、この仕組みを、2つの既存の機能と合わせて「説明責任の輪」と呼ぶ。Bot Preference Syncは、サイトの持ち主が、自分の希望を公開するのを助ける機能で、Bot Managementは、そのボットの通信をどう扱うかを、持ち主が決める機能である。希望を出し、守られているかを見て、扱いを決める、という3つの役割が並ぶ。
429(Too Many Requests)とRetry-After
用語
429は、一定の時間に要求が多すぎる、という意味の応答の番号である。Retry-Afterは、次の要求までどれだけ待ってほしいかを伝える応答ヘッダーで、秒数か日時で書く。429にRetry-Afterを付けるかは、任意である。
robots.txtとRFC 9309
robots.txtは、サイトのいちばん上の階層に置く、ボットへの規則のファイルである。仕組みの仕様は、2022年9月に、IETFのRFC 9309として標準化された。この記事では、仕様に書かれた「MUST(必ず)」「SHOULD(そうするべき)」「MAY(してもよい)」の言い方を、そのまま区別して書く。
04 型別 — 規則と合図が読める形かを、3つに分けて確かめる
A. この記事が当てはまるサイト
当てはまるのは、robots.txtを公開しているサイトと、アクセスが多いときに、429のような合図を返す仕組みがあるサイトである。会員登録やログインの画面、検索の画面のように、1回の取得が重い画面を持つサイトは、特に、速さの合図が効く場所を持っていると考えられる(これは筆者の整理で、公式の文書にある文ではない)。Cloudflareを使っているかは、条件にならない。ただし、信頼の帯が使えるようになったときに自分で閾値を選べるのは、Cloudflareの顧客だけである。
B. ブログが書いていないこと
注意
ブログには、信頼の帯の点数の尺度、閾値の数字、「くり返し」が何回か、評価の対象になるボットの一覧、顧客が見る画面の名前が書かれていない。この記事も、それらを書かない。「評価が下がると通信が止まる」とも書かれていない。公式に書かれた範囲を、分けて読む。
もう1つ、書かれていないことがある。評価が、どの通信を材料にしているかである。ブログは「観測された通信」と書くだけで、Cloudflareを通っていないサイトの通信を使うかどうかには触れていない。
C-1. robots.txtが読める場所と形か
RFC 9309は、規則を、サービスのいちばん上の階層にある「/robots.txt」というファイルに置くこと、ファイルはUTF-8で、種類はtext/plainにすることを定めている。Googleの文書も、UTF-8のプレーンテキストを求めている。Googleは、ファイルのサイズの上限を500キビバイト(KiB)とし、それを超えた部分は無視すると書く。RFC 9309は、取得側が処理できる上限は少なくとも500KiBとしている。
"Google enforces a robots.txt file size limit of 500 kibibytes (KiB)."
(訳: Googleは、robots.txtのファイルに、500キビバイトのサイズの上限を設けている。)
もう1つ、Googleの文書は、robots.txtの代わりにHTMLが返ってきたときの動きも書いている。規則を取り出そうと解析して、それ以外は無視する。つまり、robots.txtのアドレスに、エラーの画面や、トップページのHTMLが200で返っていると、ボットは、意図しない規則を読むか、規則が無いものとして扱うかもしれない。
C-2. 取得できなかったときの、ボットの扱い
robots.txtが取れないとき、ボットがどう動くかは、ステータスで決まる。RFC 9309とGoogleの文書を、並べると次のようになる。
| ステータス | RFC 9309 | Googleの文書 |
|---|---|---|
| 2xx(成功) | 取れた規則に、必ず従う | サーバーが返したとおりに規則を処理する |
| 3xx(転送) | 少なくとも5回までの転送は、たどるべき。それを超えたら、利用できないとみなしてよい | 少なくとも5回たどり、そこで止めて、404として扱う |
| 4xx(クライアントのエラー) | 利用できない状態。サーバーの資源に、何でもアクセスしてよい | 429を除く4xxは、有効なrobots.txtが無いものとして扱う。取得の制限は無いと考える |
| 5xx(サーバーのエラー) | 到達できない状態。全面禁止と、必ずみなす | 最初の12時間は取得を止め、次の30日は最後に取れた版を使う。それ以降は、サイトの状態で変わる |
表で、4xxの行が重要である。サイトが、robots.txtに403や404を返していると、規則を出したつもりでも、ボットは「規則が無い」と読んでよい。規則を出したいなら、200で返す必要がある。
出典
RFC 9309(2022年9月)は、到達できない場合の扱いを次のように書く。
"If the robots.txt file is unreachable due to server or network errors, this means the robots.txt file is undefined and the crawler MUST assume complete disallow."
(訳: サーバーやネットワークのエラーでrobots.txtに到達できないときは、robots.txtが未定義という意味で、取得側は、全面禁止とみなさなければならない。)
この点と、robots.txtがエラーを返し続けたときの長い経過は、robots.txtがエラーを返し続けると、最後は「制限なし」に行き着く ── HTTPステータス別の扱いを確認する13項目(2026年9月時点)で詳しく書いた。この記事では繰り返さない。
C-3. 429を返すときの形
429の仕様は、RFC 6585(2012年4月)にある。要求が一定の時間に多すぎることを表し、応答には、状況を説明する内容を含めるべきで、Retry-Afterのヘッダーを含めてもよい、とされる。
"The response representations SHOULD include details explaining the condition, and MAY include a Retry-After header indicating how long to wait before making a new request."
(訳: 応答の内容には、その状況を説明する詳細を含めるべきで、次の要求まで、どれだけ待つかを示すRetry-Afterのヘッダーを含めてもよい。)
Retry-Afterの書き方は、RFC 9110(2022年6月)の10.2.3にある。値は、日時か、待つ秒数のどちらかで、その節は、503と、3xxの転送に付けたときの意味を説明している。429との組み合わせは、RFC 6585の側に書かれている。書き方の細かい決まりは、Googleがクロールを緊急に減らす手順にRetry-Afterの書き方を加えた。手順そのものは新しくない ── 保守・障害の画面が返す数字を確かめる13項目(2026年10月時点)に書いたので、ここでは書かない。
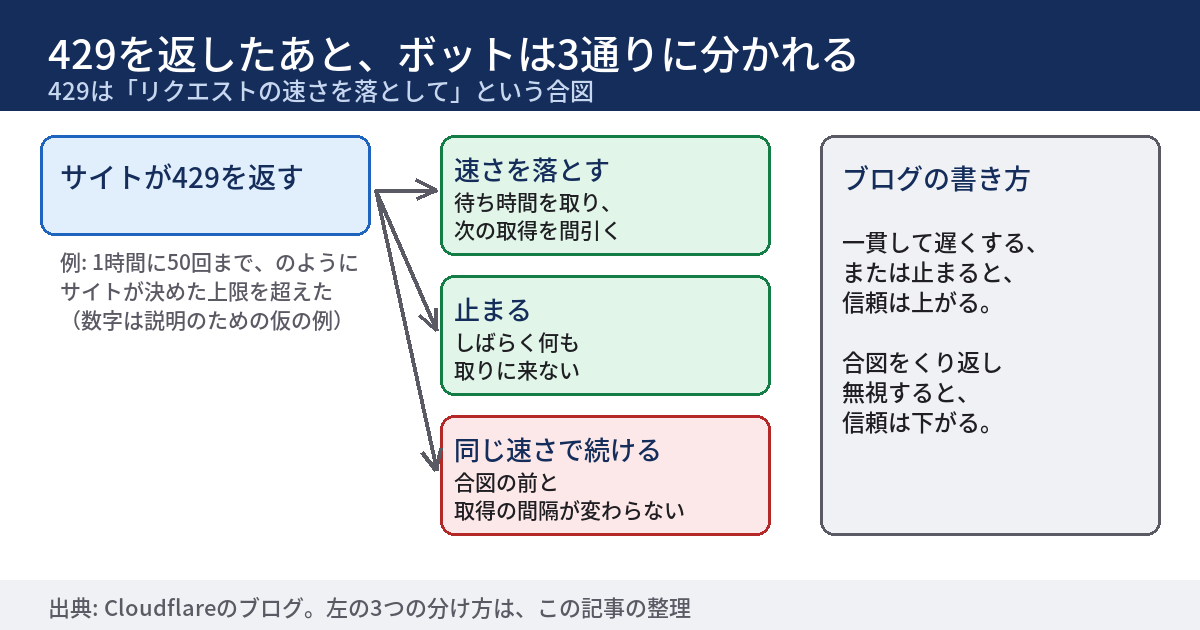
ブログは、429を、訪問者に、要求の速さを落とすよう求める指示として説明する。
"A 429 is a directive for the visitor to reduce its request rate, sometimes with guidance about how long to wait before trying again."
(訳: 429は、訪問者に要求の速さを落とすよう求める指示で、ときには、再び試すまでにどれだけ待つかの案内を伴う。)
Googleの文書は、429を、サーバーが過負荷だという合図として扱い、サーバーのエラーと同じに数えると書く。そして、5xxと429があると、取得の速さを一時的に落とす。一方で、401と403は、取得の速さを下げるためには使わないよう書かれている。
実務のヒント
429は、返す側にも負担がかかる。RFC 6585は、攻撃を受けているときに、すべてに429を返すと資源を使うので、429を使うことは必須ではなく、接続を切るなど別の手もある、と書く。合図を出すか、切るかは、状況で決める。
C-4. ログで、守っているかを数える
規則と合図を出したら、ボットが守ったかは、自分のアクセスログで数えられる。数えるのは、次の3つで、いずれも名乗りごとに分ける。
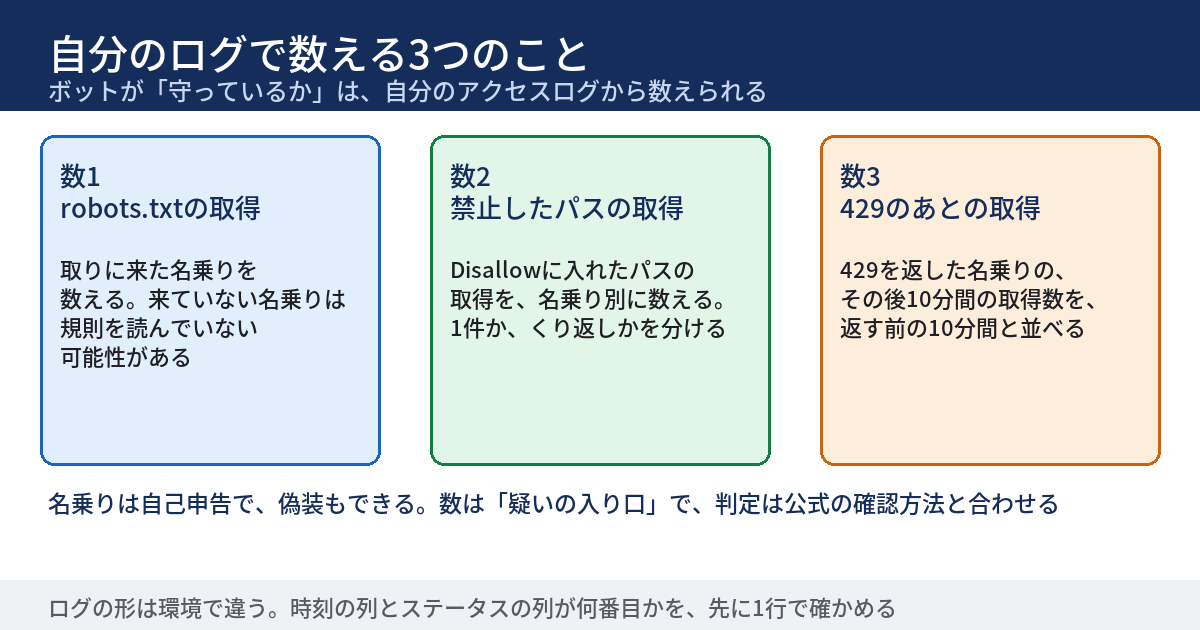
1つ目は、robots.txtを取りに来た名乗りである。取りに来ていない名乗りが、ほかのページを大量に取っていれば、規則を読んでいない可能性がある。2つ目は、禁止したパスを取った名乗りである。1件だけなら、ブログのいう1回きりの違反(one-offs)かもしれない。ブログは、単発の違反は大きな意味を持たないかもしれず、見ているのは、サイトの希望を無視する行動のくり返しだと書く。3つ目は、429を返したあとの取得数である。返した前後で、取得の間隔が変わったかを見る。
名乗りは自己申告なので、偽装ができる。ある週のログで、名乗りを数えたら、本物の確認と食い違った例は、「AIクローラーが弾かれている」と読みかけた ── 日別に割ったら、正体は数十の名前を名乗る貸しサーバーだったに書いた。名乗り・発信元・ふるまいで分けて数える考え方は、Yandexの通信が大きく落ちた週、悪質な自動アクセスは止まらず別の業者へ移った、とCloudflareは書いた ── 総量の増減ではなく、名乗り・発信元・ふるまいで分けて数える13項目(2026年10月時点)に詳しい。ログを名乗りで数える手順は、Cloudflareが通信の半分以上は人間ではないと書いた週、当サイトのログで自動と分かるものは36.2%だった ── 他人の大きな数字を、自社のログ1週間分で数え直すが、1週間分を数えた実例である。
実務のヒント
数える前に、ログの1行を1つ開いて、時刻・ステータス・名乗りが何番目の列かを確かめる。ログの書式は環境ごとに違う。列の番号を決め打ちして数えると、別の列の値を数えてしまう。
自分のサイトのリンクのステータスを、まとめて一覧にしたいときは、サイト内のリンクを調べて、アクセスのステータスをExcelにまとめられる、当サイトの無料ツールが使える。🔧 WEBサイト内のリンク漏れ・チェックツールは、リンク先が200以外を返していないかを、一度に見たいときに向いている。
05 自分のサイトで確認するチェックリスト
下の13項目は、1項目5分ほどでできる作業である。項目6から9と11は、アクセスログを開く。ログを見られない環境のときは、その項目を飛ばして、残りだけでもよい。チェックの状態はブラウザの中にだけ保存され、サーバーには送られない。
- 自分のサイトのrobots.txtを開き、HTTPのステータスとContent-Typeを、curlなどでヘッダーだけ取って書く
- robots.txtのファイルのサイズを、バイトで書き、500KiB(512,000バイト)より小さいかを、「小さい」「大きい」で書く
- robots.txtのUser-agentの行を数え、すべての名乗り向け(*)の群と、名指しの群を、それぞれ何個あるか書く
- 止めたいパスを3つ書き出し、robots.txtのDisallowに入っているかを、1つずつ「入っている」「入っていない」で書く
- wwwの有無とhttpとhttpsを組み合わせた4つのアドレスでrobots.txtを取り、ステータスと転送先を表に書き、転送が5回以内かを書く
- アクセスログの直近7日で、robots.txtを取った名乗りを多い順に5つ書き、取得数を添える
- 項目4で入れたDisallowのパスを、項目6の5つの名乗りが取っていないかを、名乗りごとの件数で書く
- 項目6のうち1つの名乗りについて、1時間ごとの取得数を並べ、いちばん多い1時間の件数を書く
- 直近7日のログで、ステータス429の件数を数え、0件のときも「0」と書く
- 429を返す仕組みがあるサイトは、429の応答を1回取り、Retry-Afterのヘッダーの有無と値を、ヘッダーを開いて書く
- 項目9で429を受けた名乗りを1つ選び、受けた後の10分間と前の10分間の取得数を、並べて書く
- 自分のサイトがCloudflareを通っているかを、応答ヘッダーのServerやCF-RAYの有無で調べ、「通っている」「通っていない」で書く
- 項目1から12の結果を、「規則」「合図」「ログ」の3列の表にまとめ、日付をつけて保存する
時間が限られているときは、項目1・4・6・9の4つだけでも、規則が読める形かと、ボットが来ているかの見当は付く。
06 代替・他の選択肢 — ボットに守ってもらう手段は、robots.txt以外にもある
評価の仕組みは、Cloudflareの顧客向けの機能である。使っていないサイトや、評価が使えるようになるまでの間に、同じ目的を果たす手段は、いくつかある。ただし、手段ごとに、強制力が違う。
robots.txtだけで頼む
いちばん手軽だが、強制力は無い。RFC 9309自身が、そう書いている。
"The Robots Exclusion Protocol is not a substitute for valid content security measures."
(訳: ロボット排除プロトコルは、有効なコンテンツ保護の手段の代わりにはならない。)
ブログも、robots.txtは、ボットがしてはいけないことの最低限の規則を定めるもので、書かれていないことが許されている、という意味ではないと書く。罠は、robots.txtに書いたパスが、公開されることである。RFC 9309は、パスを載せると、見つけやすくなると書く。隠したいものを、robots.txtに書かない。
429で速さを求める
1つの名乗りが、禁止していないパスを、無理な速さで取るときは、429が合図になる。Googleは、取得の速さを下げる手段として、429や5xxを挙げ、401や403は使わないよう書く。一方で、Googleの文書は、robots.txtのcrawl-delayという指定を、対応していないフィールドとして挙げている。取得の間隔を、robots.txtで頼めないので、Googleの取得を遅くしたいときは、応答のステータスで伝える。
認証をかける
見せたくないページは、ログインや認証の後ろに置く。RFC 9309も、パスへのアクセスを抑えたいなら、アプリケーションの層で、HTTPの認証のような有効な保護手段を使うよう書く。robots.txtや429は、お願いと合図で、保護ではない。
ネットワークの入口で管理する
Cloudflareの場合は、Bot Managementで、ボットの通信の扱いを決められる。評価が使えるようになったときは、顧客が閾値を選べる、とブログは書く。ほかの事業者の、同種の機能は、この記事では確かめていない。
何もしないで、ログだけ数える
手をかけられないときは、ログの数だけを残して、必要になったときに比べられるようにしておく。数があれば、あとから、規則を足したか、合図を出したかの前後を比べられる。
07 当サイトで確かめたこと
当サイト(WEBサイトサポート)で、この記事の項目1にあたる確認を、2026年10月17日に行った。確かめたのは、公開されているrobots.txtと、存在しないアドレスの応答である。
robots.txtの応答
当サイトのrobots.txtを、外から取った。ステータスは200、Content-Typeはtext/plain; charset=UTF-8で、ファイルのサイズは370バイトだった。500KiBの上限と比べて、十分に小さい。HTMLではなくプレーンテキストが返っていて、規則の形で出ている。
存在しないアドレスの応答
存在しないアドレスを1つ取ると、404が返った。robots.txtではなく、通常のページのアドレスの扱いである。robots.txtが404のときの扱いは、表のとおり「規則が無い」になるが、当サイトのrobots.txtは200で返っているので、その状態にはなっていない。
確かめていないこと
当サイトはCloudflareを通していないので、確認済みボットの評価は、当サイトに関係しない。また、429をどう返しているか、ボットがログでどう動いたかは、この記事では確かめていない。ログの数1から数3は、これから数える。数えたら、この記事の末尾に、日付をつけて追記する。
08 このテーマの、これまで
| 日付 | できごと |
|---|---|
| 2012年4月 | RFC 6585が、429(Too Many Requests)を定めた |
| 2022年6月 | RFC 9110が、Retry-Afterの書き方を定めた |
| 2022年9月 | RFC 9309が、robots.txtの仕組みを標準化した |
| 2025年8月4日 | Cloudflareが、Perplexityのボットを確認済みの一覧から外したと書いた |
| 2026年7月1日 | Cloudflareの文書によると、確認済みボットと署名つきエージェントの区別が、新しい項目で表されるようになった |
| 2026年10月16日 | Cloudflareが、確認済みボットの行動を評価し、報告する仕組みを書いた |
| 2026年10月17日 | この記事の確認の日。当サイトのrobots.txtと、存在しないアドレスの応答を確かめた |
この表で、2012年・2022年の日付は、各RFCの発行月で、2025年・2026年7月の出来事は、Cloudflareの記述を要約したもので、この記事では確かめていない。ボットの扱いは、当サイトのブログでも、以前に扱った。
- IETF WebBotAuth WG が発足した日 — 標準化が始まった、半歩先で警告した側の次の責任
- Cloudflareが『価値』を可視化し始めた日 — BotBase と Attribution Business Insights、archives/93の一週間後に来た次の一手
- 「守る」から「見分ける」へ ── Cloudflare Precursor GAが変えるbot対策と、WEBディレクターが今週確認すべき3点
- 同じ条件で測っていなかった ── robots.txtは「24時間キャッシュ」のはずが、測ったら1日13.9件と152.3件。3サイトの数字を並べる前に確認すべきだったこと
- Cloudflareが9月15日に加えた「AI学習だけを止める」設定 ── 検索に載せたまま止められる範囲と、今週確かめる6つ
現在の貴方のIPアドレス
このサイトで書いている人