WEBサイト
Googleがクロールを緊急に減らす手順にRetry-Afterの書き方を加えた。手順そのものは新しくない ── 保守・障害の画面が返す数字を確かめる13項目(2026年10月時点)
Googleがクロールを緊急に減らす手順にRetry-Afterの書き方を加えた。手順そのものは新しくない ── 保守・障害の画面が返す数字を確かめる13項目(2026年10月時点)
目次
01 何が起きたか — Googleが、クロールを緊急に減らす手順に、Retry-Afterの書き方を10月6日に加えた
2026年10月6日の更新履歴
Googleのクロールの文書には、更新履歴のページがある。2026年10月6日の項目は、Retry-Afterというヘッダーの説明を、クロールを減らす手順の文書に加えた、という内容である。2026年10月11日に開いて確かめた。「何を」の欄は、次のように書く。
"Restructured the emergency crawl rate reduction section and added information and examples about the Retry-After HTTP header to the Reduce the Google crawl rate documentation."
(訳: 緊急のクロール頻度の引き下げの節を組み直し、Retry-Afterヘッダーの情報と例を、「Googleのクロール頻度を下げる」の文書に加えた。)
「なぜ」の欄は、新しい対応ではない、と書く。
"Support for the Retry-After HTTP header is not new (it was already documented in Temporarily pause or disable a website), and adding it directly to the crawl rate reduction guide makes it easier to find and understand when urgently reducing crawler traffic."
(訳: Retry-AfterのHTTPヘッダーへの対応は新しくない(「ウェブサイトを一時的に停止または無効にする」の文書に、すでに書かれていた)。クロール頻度を下げる手引きに直接加えたのは、クローラーのアクセスを急いで減らすときに、見つけやすく、分かりやすくするためである。)
つまり、10月6日にGoogleの動きが変わったわけではない。以前から書かれていたことが、緊急時に開く文書の中に、例つきで置かれた。この記事は、自社のサーバーの返事を確かめる手順をまとめる。
文書が書く手順は、200の代わりにエラーを返すこと
更新されたのは「Reduce the Google crawl rate」(訳: Googleのクロール頻度を下げる)という文書である。急いでクロールを減らす手順を、次の1文で書いている。
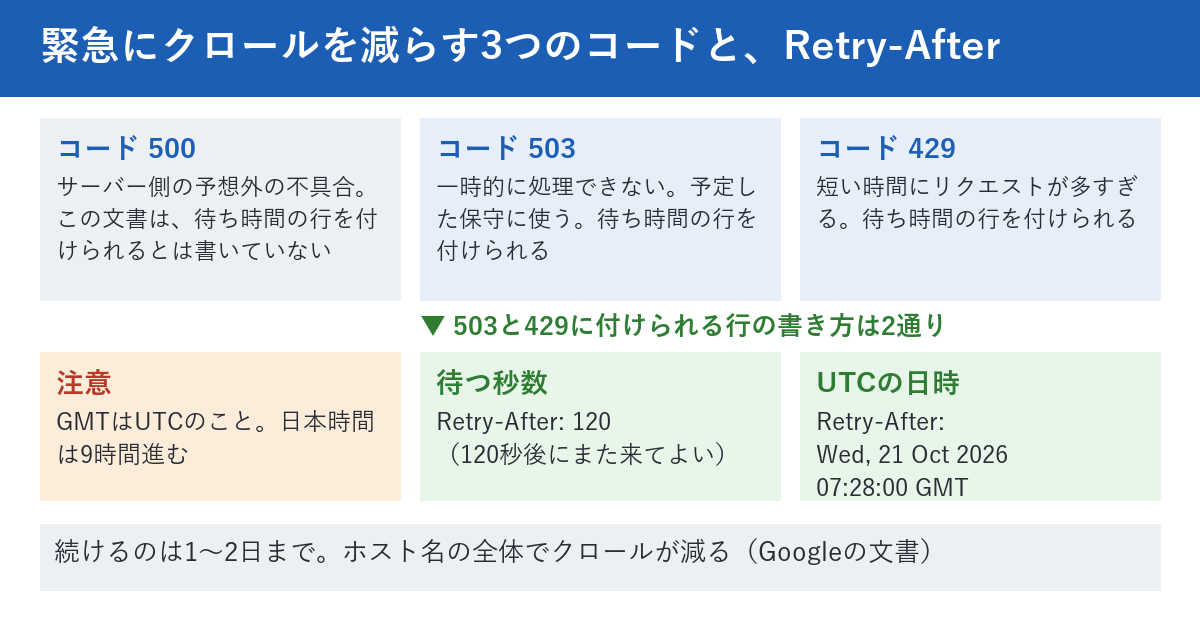
"To urgently reduce the crawl rate for a short period of time (for example, a couple of hours, or 1-2 days), return a 500, 503, or 429 HTTP response status code instead of 200 to the crawl requests."
(訳: 短い期間(たとえば数時間、または1〜2日)だけ、急いでクロール頻度を下げるには、クロールのリクエストに対して、200の代わりに、500、503、または429のHTTPレスポンスのステータスコードを返す。)
続けて、503か429を返すときに付けられるヘッダーを、次のように書いている。
"When returning a 503 or 429 status code, you can also include a Retry-After HTTP header (as defined in RFC 9110 HTTP Semantics) to indicate when Google's crawlers can retry the request, using either a delay in seconds or an absolute UTC date and time:"
(訳: 503か429のステータスコードを返すとき、Googleのクローラーが再びリクエストしてよい時期を示すために、Retry-AfterのHTTPヘッダー(RFC 9110 HTTP Semanticsで定められたもの)も付けられる。時期は、待つ秒数か、UTCの日時そのもので示す。)
書き方は2つ。秒数か、UTCの日時
文書は、2つの書き方を、例で見せている。1つは秒数で、Retry-After: 120。もう1つはUTCの日時で、Retry-After: Wed, 21 Oct 2026 07:28:00 GMTである。末尾の「GMT」は、日本時間ではなくUTCを指す。日本時間の午後4時28分は、UTCでは午前7時28分になる。日時で書くときは、この9時間の差を間違えやすい。
出典
「Reduce the Google crawl rate」の末尾には「Last updated 2026-10-06 UTC.」(訳: 最終更新 2026年10月6日 UTC)とある。更新履歴の10月6日の項目と、日付が一致している。
02 なぜ・背景 — クロールを減らす手段が、サーバーからエラーを返すことしかない場合がある
クロールが急に増える原因は、サイトの作りにあることが多い
文書は、クロールが急に増えたときの原因を、まず探すよう書いている。報告の多い原因は、URLの組み立ての無駄で、絞り込みや並べ替えのある一覧、日付ごとのURLが大量にあるカレンダー、動的検索広告の対象の3つである。先に確かめるのは、ホスティング会社への問い合わせと、直近のアクセスの記録だ、とも書く。
つまり、エラーを返すのは、原因を直すまでの一時しのぎである。原因が絞り込みの一覧にあるなら、クロールの予算の考え方を扱った、当サイトの記事「クロールバジェットを気にすべきサイトの条件 ── 2つの要素を確認する14項目(2026年9月時点)」が先に役に立つ。
減らすと、Googleの側で何が起きるか
文書は、減らす前に警告を置いている。
"When considering reducing Google's crawl rate, keep in mind that this will have broad effects."
(訳: Googleのクロール頻度を下げることを考えるときは、これが広い影響を持つことを覚えておくこと。)
影響は、検索と広告で別々に書かれている。検索は、新しいページが見つかりにくくなり、既存のページの更新が遅れ、削除したページが長く残りうる、という内容である。広告は、キャンペーンが取り消されたり停止されたりし、配信されないことがある、という内容である。
効くのは、そのホスト名の全体
エラーを返したときの動きを、文書は2点で書いている。
"It reduces your site's crawl rate across the whole hostname (for example, subdomain.example.com), including both the URLs that return errors and the URLs that return content."
(訳: ホスト名全体(たとえばsubdomain.example.com)で、サイトのクロール頻度が下がる。エラーを返すURLも、内容を返すURLも、どちらも含まれる。)
"It automatically increases the crawl rate again once the number of these errors is reduced."
(訳: これらのエラーの数が減ると、クロール頻度が自動的にまた上がる。)
1点目の意味は大きい。一部のURLだけにエラーを返したつもりでも、同じホスト名の全体でクロールが減る。ホスト名が別(wwwありとなし、サブドメイン)なら、別々に扱われる、と読める。これは筆者の整理である。
03 用語 — 500・503・429とRetry-Afterを、先に分けておく
503と429と500は、同じ「エラー」でも意味が違う
3つのコードは、HTTPの標準では次のように書かれている。503は、サーバーが一時的に要求を処理できない場合に使う。
"The 503 (Service Unavailable) status code indicates that the server is currently unable to handle the request due to a temporary overload or scheduled maintenance, which will likely be alleviated after some delay."
(訳: 503(Service Unavailable)のステータスコードは、一時的な過負荷や予定された保守のために、サーバーが今はリクエストを処理できないことを示す。しばらくすれば解消される見込みである。)
429は、短い時間に送られたリクエストが多すぎるときに使う、いわゆるレート制限のコードである(RFC 6585)。
500は、サーバー側の予想外の不具合を表す。予定した保守は503、アクセスが多すぎるときの制限は429、と使い分けるのが、標準の言葉に沿った読み方である。
Googleは429を、サーバーが過負荷のしるしと読む
Googleの別の文書は、ステータスコードごとの扱いを書いている。429については、次のように書く。
"Google's crawlers treat the 429 status code as a signal that the server is overloaded, and it's considered a server error."
(訳: Googleのクローラーは、429のステータスコードを、サーバーが過負荷であるしるしとして扱い、サーバーエラーとみなされる。)
Retry-Afterは、「いつ戻ってきてよいか」を伝えるヘッダー
Retry-Afterの定義は、HTTPの標準にある。503と一緒に付けたときの意味は、次のとおりである。
"When sent with a 503 (Service Unavailable) response, Retry-After indicates how long the service is expected to be unavailable to the client."
(訳: 503(Service Unavailable)の応答と一緒に送られたとき、Retry-Afterは、そのサービスが利用者に対してどれくらいの間使えない見込みかを示す。)
値の形は2つで、標準は次のように書いている。
"The Retry-After field value can be either an HTTP-date or a number of seconds to delay after receiving the response."
(訳: Retry-Afterの値は、HTTPの日時か、応答を受け取ってから待つ秒数のどちらかである。)
読む側の対応について、MDN Web Docsは次のように書いている。
"Support for the Retry-After header on both clients and servers is still inconsistent."
(訳: Retry-Afterヘッダーへの対応は、クライアントでもサーバーでも、まだ一貫していない。)
用語
ソフト404は、本当は「見つかりません」と言いたいページが、200で返っている状態を指す。Googleの文書は、2xxで返った内容がエラーメッセージを思わせる場合、Search Consoleにソフト404のエラーが出る、と書く。保守の画面を200で返すと、この扱いを受ける場合がある。
04 型別 — 保守・障害の画面が「何を返すか」を、3つの型に分けて測る
🅰 適用範囲 — 保守の画面を出す全部のサイトが対象
保守や障害の画面を、まったく出さないサイトは少ない。レンタルサーバーの保守、CMSの更新中の表示、ホスティング会社の障害など、自分で作っていない画面が出ることもある。返るステータスコードは、次の3つの型のどれかに分かれる。
| 型 | Googleの文書での扱い | 自社で確かめること |
|---|---|---|
| 200で返す | 内容が空やエラーメッセージを思わせるなら、ソフト404になりうる。更新履歴の手順(500・503・429)には当たらない | 保守の画面のステータスコードが200のままではないか |
| 503か429で返す | クロールが一時的に遅くなる。ホスト名の全体に効く。Retry-Afterを付けられる | Retry-Afterが付いているか。秒数か日時か。期間が1〜2日を超えないか |
| 別のURLへ転送する | 転送先の内容が処理される。転送先が200なら、200で返す型と同じ扱いになりうる | 転送が何回あるか。最後のURLが何を返すか |
3行目の「転送」は、筆者の整理である。Googleの文書は、転送元のURLの内容は無視され、最終的な転送先の内容が処理される、と書いている。
🅱 この記事が確かめていないこと
注意
この記事は、Retry-Afterを付けたら、Googleが実際に再訪する時期が変わるかを測っていない。公式の文書にも、Retry-Afterを付けると再訪が早まる、という保証は書かれていない。当サイトの保守の画面が、本番で何を返すかも、本番を止めて測ることはしていない。
🅲 手順1 — curlで、保守の画面の返事を取る
Googleの文書は、503の確認の方法も書いている。
"Confirm a 503 HTTP response status code locally by using curl or a similar tool."
(訳: 503のHTTPレスポンスのステータスコードを、curlか同様のツールを使って、手元で確認すること。)
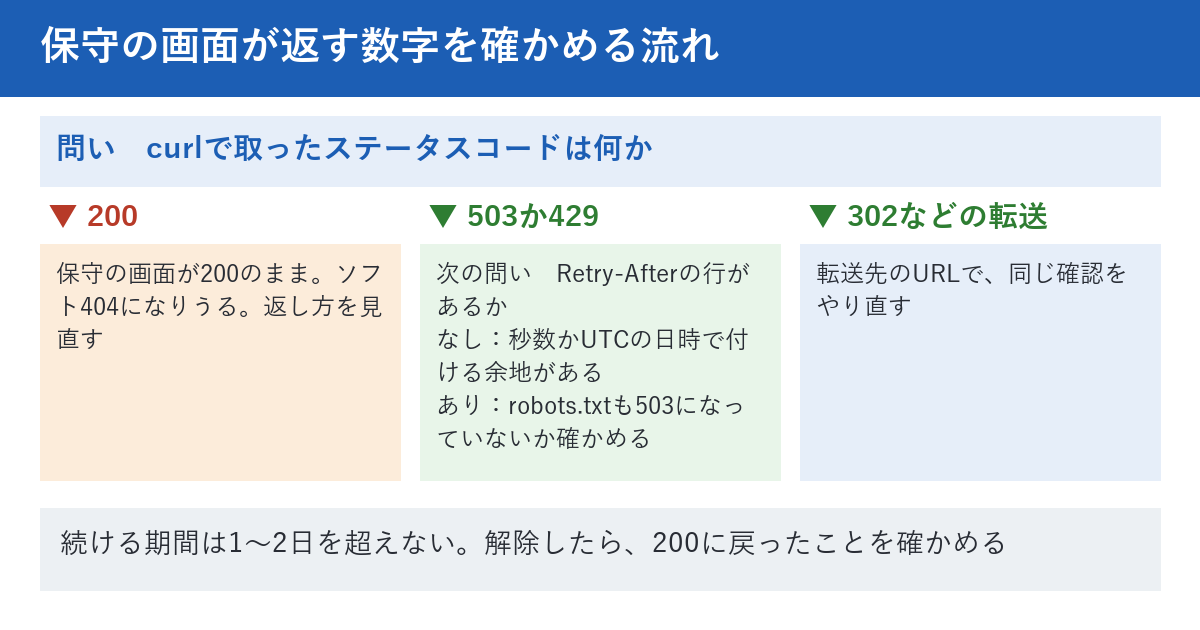
確かめるのは、ステータスコードの数字と、ヘッダーの行である。ブラウザの画面は案内が出ているだけで、数字が見えない。保守の画面を出せる時間が限られているなら、1回で数字とヘッダーを保存する。
実務のヒント
ステータスコードとヘッダーを画面に出すには、curl -s -o /dev/null -D - 調べるURLを使う。本文は捨てて、応答ヘッダーの全部を表示する指定である。数字だけなら、-w "%{http_code}"を足す。
🅲 手順2 — 503か429のとき、Retry-Afterが付いているかを見る
ステータスコードが503か429なら、次はヘッダーの中のRetry-Afterの行を探す。Googleの保守の文書は、503の画面を作るときの工夫を、次のように書いている。
"Use the retry-after HTTP header with a best effort date or duration."
(訳: retry-afterのHTTPヘッダーを、できるだけ正確な日時か期間で付けること。)
行が無ければ、付ける余地がある。有るなら、秒数か、UTCの日時かを書き留める。日時なら、日本時間に直して(9時間足して)、予定の終了時刻と合っているかを見る。
🅲 手順3 — robots.txtまで503にしていないかを見る
保守の画面を出す設定が、サイトの全体にかかっていると、robots.txtまで503になることがある。Googleの保守の文書は、これを名指しで止めている。
"Don't return a 503 HTTP response status code for the robots.txt file because this blocks all crawling."
(訳: robots.txtのファイルには、503のHTTPレスポンスのステータスコードを返さないこと。クロールの全部がブロックされるからである。)
robots.txtの仕様の文書は、5xxで取れなかったときの動きを書いている。
"For the first 12 hours, Google stops crawling the site but keeps trying to fetch the robots.txt file."
(訳: 最初の12時間は、Googleはそのサイトのクロールを止めるが、robots.txtのファイルを取りに行くことは続ける。)
確かめ方は、保守の画面が出ている間に、robots.txtのURLにも同じcurlを送ることである。サイトを一時的に止めるときの文書(出典欄の「Temporarily pause or disable a website」)は、保守の画面を出す場合の注意として、次のように書いている。
"Continue to allow crawling through the robots.txt file."
(訳: robots.txtのファイルを通したクロールは、許可し続ける。)
同じ文書は、robots.txtに503を返さないようにとも書いている。ふだんどおり200で返す形にしておく、という意味だと読める。
🅲 手順4 — CDN・キャッシュ・転送が、返事を変えていないかを見る
保守の画面を、サーバー本体ではなく、手前の仕組み(CDN、ホスティング会社の保守ページなど)が返すことがある。サーバー本体が503を返していても、手前の仕組みが古いキャッシュの200を返せば、外から見えるのは200になる。逆もありうる。どちらになるかは、自分の設定による。
Googleのネットワークエラーの文書は、自分でホスティングしていないなら、ホスティング会社かCDNの提供元に助けを求めるよう書いている。手がかりは、curlの応答ヘッダーの中にある。キャッシュの状態を示す行(Ageなど)があれば、返事がどこで作られたかを疑う。手前の仕組みを通る経路と、サーバー本体を直接開く経路を比べられるなら、両方で数字を書き留める。
🅲 手順5 — CMSの保守モードが返す数字を、仕組みで確かめる
CMSの更新中の画面も、ステータスコードを返している。WordPressの公開されているソースコードで、保守の画面を出す関数を、2026年10月11日に開いて読んだ。標準の動きは、Retry-After: 600のヘッダーを付け、「Briefly unavailable for scheduled maintenance. Check back in a minute.」(訳: 予定された保守のため、一時的に使えません。しばらくしてからまた確認してください。)という文を、503で返すものだった。
ただし、保守の画面を差し替える仕組みもある。プラグインや独自の保守画面が入っていれば、返す数字は別になりうる。標準の動きだけで決めず、自分のサイトにcurlを送る。
🅲 手順6 — 続ける期間の上限を決め、終わったら元に戻ったかを見る
文書は、エラーを返し続ける期間に、はっきりした目安を置いている。
"We don't recommend that you do this for a long period of time (meaning, longer than 1-2 days) as it may have a negative effect on how your site appears in Google products."
(訳: これを長い期間(つまり1〜2日より長く)続けることは勧めない。サイトがGoogleの製品に表示される見え方に、悪い影響が出るおそれがあるからである。)
検索については、さらに具体的に書いている。
"For example, in the case of Search, if Googlebot observes these status codes on the same URL for multiple days, the URL may be dropped from Google's index."
(訳: たとえば検索の場合、Googlebotが同じURLでこれらのステータスコードを何日も続けて見ると、そのURLがGoogleのインデックスから外れるおそれがある。)
解除のあとは、元の200に戻ったかを確かめる。Googleの文書は、戻したあとの動きを、次のように書いている。
"Once the server starts responding with a 2xx status code, Google gradually increases the crawl rate for the site."
(訳: サーバーが2xxのステータスコードで応答し始めると、Googleはそのサイトのクロール頻度を、徐々に上げる。)
「徐々に」とあるので、解除した直後に元の頻度に戻るとは限らない。
05 自分のサイトで確認するチェックリスト
下の13項目は、1項目5分ほどでできる作業である。保守の画面をまだ出せない日は、項目1〜4だけ先に進めてよい。チェックの状態は、ブラウザの中にだけ保存され、サーバーには送られない。
- 公式の文書「Reduce the Google crawl rate」を開き、末尾の「Last updated」の日付(2026-10-06 UTC)と、緊急に減らすときに返す3つのコード(500・503・429)を、メモに書き写す
- 自社の保守や障害の画面を出す手段を、「サーバー設定」「CMSの保守モード」「ホスティング会社の保守ページ」「CDNの画面」から該当するものすべてに丸を付けて書き出す(担当が分からない手段は「不明」と書く)
- 自社のホスト名(wwwあり・なし、サブドメイン)を全部書き出し、保守の画面を出す手段がホスト名ごとに同じか違うかを書く
- 平常時のトップページにcurlでGETを送り、ステータスコードを「200」の形で書く
- 保守の画面を出せる環境で、curlのGETを1回送り、ステータスコードを「200」「503」「429」「302」のどれかで書く
- 項目5が503か429なら、応答ヘッダーのRetry-Afterの行を探し、「あり(秒数)」「あり(日時)」「なし」のどれかで書く
- 項目6が「あり(日時)」なら、日時の末尾がGMTかを見て、日本時間に直した時刻(9時間足す)を、予定の終了時刻と並べて書く
- 項目5が200なら、保守の画面の案内の文言を1行書き写し、ステータスコードが200のままで案内を出していることをメモに書く(ソフト404の恐れ)
- 保守の画面が出ている間に、robots.txtのURLにcurlのGETを送り、「200」か「503」かを書く(503なら、直す依頼を担当に書く)
- CDNやキャッシュを間に置いているなら、応答ヘッダーにAgeなどキャッシュの状態を示す行があるかを書き、手前の仕組みを通る経路とサーバー本体を直接開く経路の数字を並べて書く
- 保守の画面を続ける最長の期間を、「最大2日」を上限にして日数で決め、予定の開始と終了の日時といっしょに書く
- 保守が終わったら、平常時のページに同じcurlを送り、200に戻ったことと、Retry-Afterの行が消えたことを、日時つきで書く
- 保守の時間帯のアクセスの記録から、Googlebotを名乗るリクエストに返したステータスコードを数え、「503が◯件、200が◯件」の形で書く(名乗りが本物かの確認は、公式の確認方法で別に行う)
06 代替・他の選択肢 — 503を返す前に、考える手が3つある
機能を絞って、サイトは出したままにする
Googleの保守の文書は、サイトを閉じる前の手を、まず「機能を絞る」と書いている。
| 選択肢 | Googleの文書での位置づけ | 向く場面 |
|---|---|---|
| 機能を絞る | 推奨。検索での見え方への悪い影響が最も小さいと書かれている | 注文だけ止めたいなど、一部の機能の停止 |
| 1〜2日のあいだ503を返す | サイト全体を止める必要があるときの、短期間の方法として書かれている | サーバーの移行、障害の復旧のあいだ |
| 200の案内ページを置く | もっと長く止めるときの方法として書かれている | 数日を超えて止めるとき |
数日を超えるなら、200で返す案内のトップページを置く
同じ文書は、長く止めるときの方法を、次のように書いている。
"If you need to disable the site for a longer time, then provide an indexable home page as a placeholder for users to find in Search by using the 200 HTTP status code."
(訳: もっと長い間サイトを止める必要があるなら、検索で利用者が見つけられるように、インデックスできる仮のトップページを、200のHTTPステータスコードで出すこと。)
つまり、200で返すこと自体が間違いなのではない。1〜2日のあいだは503、それを超えるなら、案内を載せた200の仮のページ、という使い分けが書かれている。
403・404・410・noindexで止めない
止めるつもりで、別の手を使ってしまう例も、保守の文書は名指しで書いている。
"Don't block the website by returning 403, 404, 410 HTTP status codes, or with a noindex robots meta tag or x-robots-tag HTTP header."
(訳: 403、404、410のHTTPステータスコードを返したり、noindexのrobotsメタタグやx-robots-tagのHTTPヘッダーを使ったりして、ウェブサイトをブロックしないこと。)
理由は、これらを使うとサイトのURLが検索から外れるから、と書かれている。
当サイトの無料ツールと、記事
平常時の状態を記録するときは、当サイトの無料ツール🔧 WEBサイト内のリンク漏れ・チェックツールが使える。リンクや画像のアドレスを調べて、アクセスステータスをまとめて出せるので、保守の前後で200以外が増えていないかを見比べられる。見た目を前後で画像に残したいときは、当サイトの無料ツール🔧 WEBサイトのスクリーンショット、まとめて撮っちゃおツールが使える。
エラー画面全般の返し方は、当サイトの記事「「正規URLを別のドメインに取られた」と見えたら、先にエラー画面の返し方を確かめる ── 重要ページの取得結果を確認する13項目(2026年10月時点)」でも扱った。
07 当サイトで確かめたこと
平常時の公開ページ12本は、200で返り、Retry-Afterは付いていなかった
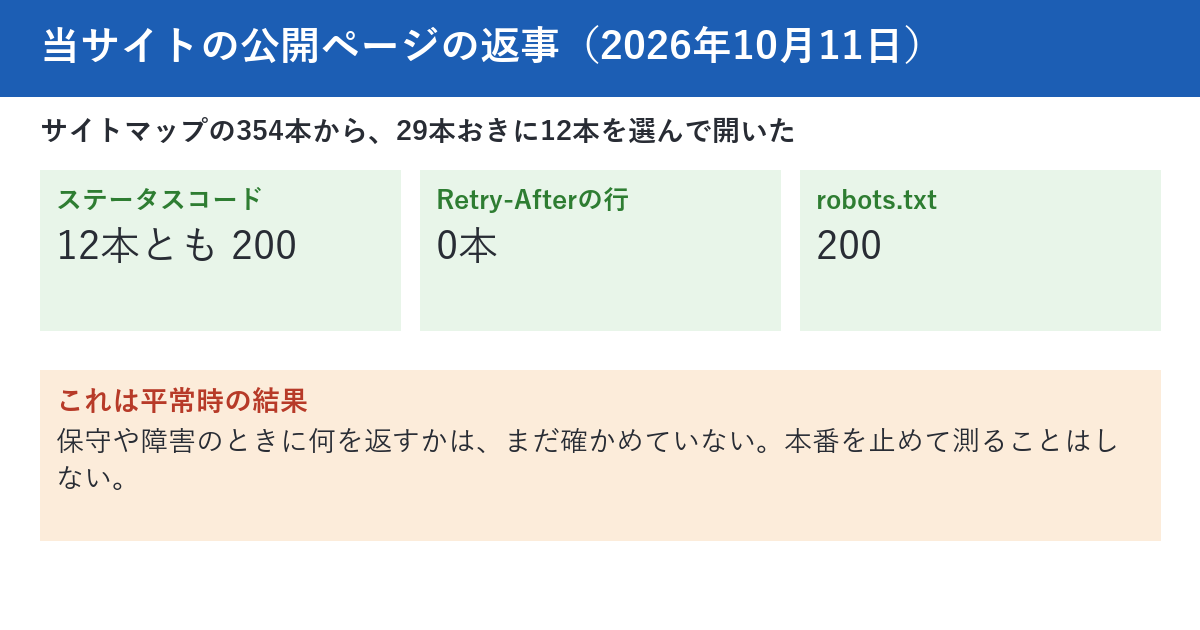
当サイトの公開ページを、2026年10月11日の午前9時すぎに、curlで開いた。サイトマップの354本のアドレスを、先頭から29本おきに数え、12本目(先頭から320番目)までの12本を選んだ。13本目に当たる最後の1本(349番目)は開いていない。12本とも200で返り、応答ヘッダーにRetry-Afterの行は1本にも付いていなかった。続けて、robots.txtも同じ方法で開き、200で返ることを確かめた。
保守のときの返事は、まだ確かめていない
言えるのは、平常時に200で返っていることまでである。保守や障害のときに何を返すかは、確かめていない。本番のサイトを止めて測ると、読んでいる人の利用を妨げる。この確認は、当サイトの記事「記事に書いた弱点が、自分のサイトにあった ── 公開した日にチェック項目を当てたら、エラー画面の返し方と、サイトの名前の書き方がそろっていなかった」で、これから行うと宣言した項目の1つである。止めずに確かめる方法を先に決めてから行う。
測り方の注意
外から取った画面は、目当ての画面とは限らないので、題名を先に見る。この考え方は、当サイトの記事「外から取った画面は、目当ての画面とは限らない ── 遮断の画面を404と読み、引用符の違いでnoindexを「無い」と読みかけた」に書いた。「200が返る」ことと、狙いどおり動いていることが別だった例は、「llms.txt が v2 になった日 ── 200 が返ることと、対応していることは別だった」と「24時間越しに自分を捕まえた日 — 「HTTP 200」が嘘をついた配置ミスと、テンプレート1行で1153記事を直した話」にある。robots.txtの取得の頻度を、同じ条件で測れていなかった例は、「同じ条件で測っていなかった ── robots.txtは「24時間キャッシュ」のはずが、測ったら1日13.9件と152.3件。3サイトの数字を並べる前に確認すべきだったこと」にある。
08 このテーマの、これまで
保守とクロールの頻度に関わる公式の文書の、最終更新日
関わる公式の文書を、2026年10月11日に開き、ページの末尾の最終更新日を書き写した。日付は、すべてUTCである。
| 文書 | 最終更新(UTC) | 内容 |
|---|---|---|
| Reduce the Google crawl rate | 2026年10月6日 | クロールを緊急に減らす手順。500・503・429とRetry-After |
| Temporarily pause or disable a website | 2025年12月10日 | サイトを一時的に止めるときの方法と、避けること |
| How HTTP status codes affect Google's crawlers | 2026年2月4日 | ステータスコードごとのGoogleの扱い |
| How Google interprets the robots.txt specification | 2026年8月31日 | robots.txtが取れないときの動き |
表の日付を見ると、10月6日に新しくなったのは、クロールを減らす手順の文書だけで、サイトを止める方法の文書は、2025年12月10日のままだった。今回の更新が、Googleの動きを変えた、という記録は、更新履歴にも、各文書にも、見つけていない。
当サイトの、関連する過去の記事
- 「正規URLを別のドメインに取られた」と見えたら、先にエラー画面の返し方を確かめる ── 重要ページの取得結果を確認する13項目(2026年10月時点) — エラー画面が返す数字を、先に確かめる記事。
- robots.txtがエラーを返し続けると、最後は「制限なし」に行き着く ── HTTPステータス別の扱いを確認する13項目(2026年9月時点) — robots.txtが取れなかったときの、扱いの流れ。
- 記事に書いた弱点が、自分のサイトにあった ── 公開した日にチェック項目を当てたら、エラー画面の返し方と、サイトの名前の書き方がそろっていなかった — 障害時のステータスの確認を、これから行うと宣言した回。
現在の貴方のIPアドレス
このサイトで書いている人