WEBサイト
公開した日に、自分で書いたチェック項目を、自分のサイトに当ててみた
当サイトでは、WEBディレクターが明日から使える解説記事を、毎日書いている。10月1日の朝にも、5本を書いた。その中の1本が、「「正規URLを別のドメインに取られた」と見えたら、先にエラー画面の返し方を確かめる ── 重要ページの取得結果を確認する13項目(2026年10月時点)」だ。
先に結論を書く。この記事の確認項目を、公開した日のうちに当サイトへ当てたら、記事に書いた弱点そのものが、当サイトにあった。存在しないURLを開いたときのエラー画面が、ページの種類ごとに違う返し方をしていた。ツールとブログのエラー画面は、「検索に載せてよい」という指定のまま、「このURLが正規のURLだ」と名乗っていたのだ。さらに、同じ日に書いた別の記事の項目を当てると、サイトの名前の書き方がそろっていない場所も見つかった。どちらも、その日のうちに直した。
この記事は、解説記事やチェックリストを読んだ(あるいは書いた)WEBディレクターが、明日、自分のサイトで次の2つを確かめて、必要なら直せるようになるために書く。1つ目は、存在しないURLを開いたときのエラー画面が、ページの種類ごとに同じ返し方をしているか。2つ目は、サイトの名前の書き方が、あちこちでそろっているか。どちらも、特別な道具は要らない。ブラウザが1つあれば、始められる。
入口にした記事は、エラー画面の返し方の話だった
エラー画面の記事の元になったのは、9月18日付の報道だ。掲示板サービスのRedditに、自分のページの正規URLとして、関係のないドメインが示される、という相談が載った。Googleのミューラー氏は、サイトに障害が起きたときのエラー画面をGoogleが取得した、という説明を、あり得る選択肢の1つとして受け止めた、と報じられている。ただし、報道自身が、エラー画面が原因だったとは確認されていない、と書いている。記事でも、原因は断定しないまま、確かめられる候補の1つとして、エラー画面の返し方を取り上げた。
エラー画面の記事で、いちばん手間がかからない確認が、存在しないURLを開いてみることだった。自分のサイトの本物のURLの末尾に、意味のない文字列を足して開く。そこで返ってくるステータスコードが404なら、返し方は正しい。「見つかりません」と表示しているのに200を返していれば、ソフト404という状態になる。Googleの公式の説明には、次のように書かれている。
"Google doesn't use the content from URLs that return 4xx status codes."
(日本語訳: Googleは、4xxのステータスコードを返すURLのコンテンツを使わない。)
"If the content suggests an error for Google Search, an empty page or an error message, Search Console will show a soft 404 error."
(日本語訳: コンテンツがGoogle検索にとってエラーを示唆している場合、つまり空白のページやエラーメッセージである場合、Search Consoleはソフト404エラーを表示する。)
この2つは、Googleのクロールの基盤についての文書「HTTP ステータス コードが Google のクローラーに及ぼす影響」(英語版の題は「How HTTP status codes affect Google's crawlers」)にある。10月2日に開いて確認したところ、最終更新の表示は、英語版が2026年2月4日、日本語版が2026年3月6日だった。これまで使っていた古い住所から開くと、新しい住所へ転送された。公式の文書は、中身だけでなく、置き場所も動く。出典に書くときは、開いた日に着いた住所を書いておくと、あとで探しやすい。
「自分は分かっている」と「自分のサイトでできている」は別だ
解説記事を書き終えた直後は、そこに書いたことを、自分はもう分かっている気になる。だが、分かっていることと、自分のサイトでできていることは別だ。読者に「明日、自分のサイトで確かめてほしい」と書いた項目が、自分のサイトでは確かめられていない。それでは、書いた本人が、いちばん先にチェックリストを素通りしていることになる。
エラー画面の記事には、「当サイトで数えてみた結果」という節を入れていた。そこで、サイトマップに載っている309のURLを、すべて取得して確かめた。ただ、それは数える範囲を決めた1回の確認であって、記事に書いた13項目すべてを、当サイトへ当てたわけではない。そこで公開した日のうちに、外から確かめられる項目を、当サイトへ当て直すことにした。
記事の中で数えた時点で、すでに食い違いが見えていた
サイトマップの309URLは、すべて正常な形だった
まず、記事の節に書いた数字を、もう一度整理する。2026年10月1日の時点で、サイトマップに載っているURLは309本だった。各URLを1回ずつ取得して、ステータスコード、canonical(このページの正規のURLはこれだ、とページ自身が宣言する指定)、noindex(検索結果に出さない、という指定)、h1(ページの最上位の見出し)の数を調べた。
結果は、309本すべてで、ステータスコードが200、canonicalが自分自身を指していて、noindexは0本、h1はちょうど1つだった。サイトマップに載せているURLは、検索に出したいページなので、この結果は意図どおりだ。ここまでは、問題が見つからなかった。
存在しないURLは、3つとも404なのに、中身はそろっていなかった
次に、サイトマップに載っていない、存在しないURLを試した。記事の番号、ツールの名前、ブログの番号の3種類を、それぞれ1つずつ、実際には無いものにして開いた。3つとも、ステータスコードは404で返ってきた。1段目は、合格だった。
ところが、その先の中身が、そろっていなかった。記事の404には、noindexとfollowの指定が付いていて、画面には「記事が見つかりません」と出た。ツールの404は、indexとfollowの指定のままで、画面には「ツールが見つかりません」と出た。ブログの404も、indexとfollowの指定のままで、画面には「見つかりませんでした。」と出た。そして、canonicalは、3つとも、求められた存在しないURL自身を指していた。
ステータスコードは3つとも404だったので、Googleは通常、中身を使わない。そのため、大きな問題にはならないだろう、というのが、エラー画面の記事に書いた俺の見立てだ。ただし、それは見立てであって、確かめたことではない。当時は、この食い違いを、記事の中に「数えた結果」として書き残すところまでしかできていなかった。
この記事には、もう1つ、小さな出来事がある。エラー画面の記事を公開する前に、書いた本人とは別の担当者が、記事の数字を確かめ直した。そのとき、下書きには「存在しないURLは、3種類とも noindex」と書いてあった。これは、確認用の環境(テスト用に用意した、公開前のサイトの写し)で測った値だった。公開中のサイトでは、noindexが付いているのは記事の404だけで、ツールとブログの404には付いていなかった。
公開前に、記事の文言は直した。ここで大事なのは、確認用の環境と公開中のサイトで、エラー画面の返し方が違っていた、という事実のほうだ。数字を書くときは、どちらの環境で測ったかを、必ず書く。この食い違いは、記事の誤りを正しただけでなく、サイトの中で何かがそろっていない、という最初の合図でもあった。
同じ日に、5本の記事の項目を、当サイトに当てた
10月1日に書いた5本の記事には、それぞれ「明日、自社サイトで確認できること」という、チェックリストが付いている。公開したら、その日のうちに、当サイトへ当てられる項目を当てる。ここでいう「当てる」は、項目の指示のとおりに、自分のサイトの該当する場所を開いて、数えたり、見比べたりすることだ。
この日は、外から読んで確かめられる項目に絞った。ページを開いて、ステータスやページの中身を見る、という作業だ。5本のうち、今回の記事で書くのは、不足が見つかった2本分である。次の表に、当てた記事、見つかったこと、直したことを並べた。
| 当てた記事 | 当てた項目 | 見つかったこと | 直したこと |
|---|---|---|---|
| エラー画面の返し方の記事 | 存在しないURLを、種類ごとに開いて、返し方を見る | ツールとブログの404が、「index, follow」と、自分自身を指すcanonicalのままだった | 共通の部品で、エラーの応答にはnoindexを付け、canonicalを出さないようにした |
| サイト名・商品名の書き方を確かめる記事 | 自社の名前の書き方が、あちこちで同じか見る | トップページの構造化データのうち、記事の一覧を作る部分の2か所で、記事の著者名が、サイトの名前ではなくドメイン名になっていた | 「WEBサイトサポート」に直した |
| 同じ会社の、ほかの公開サイト4つ | トップと、存在しないURLを、外から読む | 運営している仲間のサイトの1つで、当サイトと同じ形のエラー画面が見つかった | 変更はしていない。見つけたことを、サイトの運営者に知らせた |
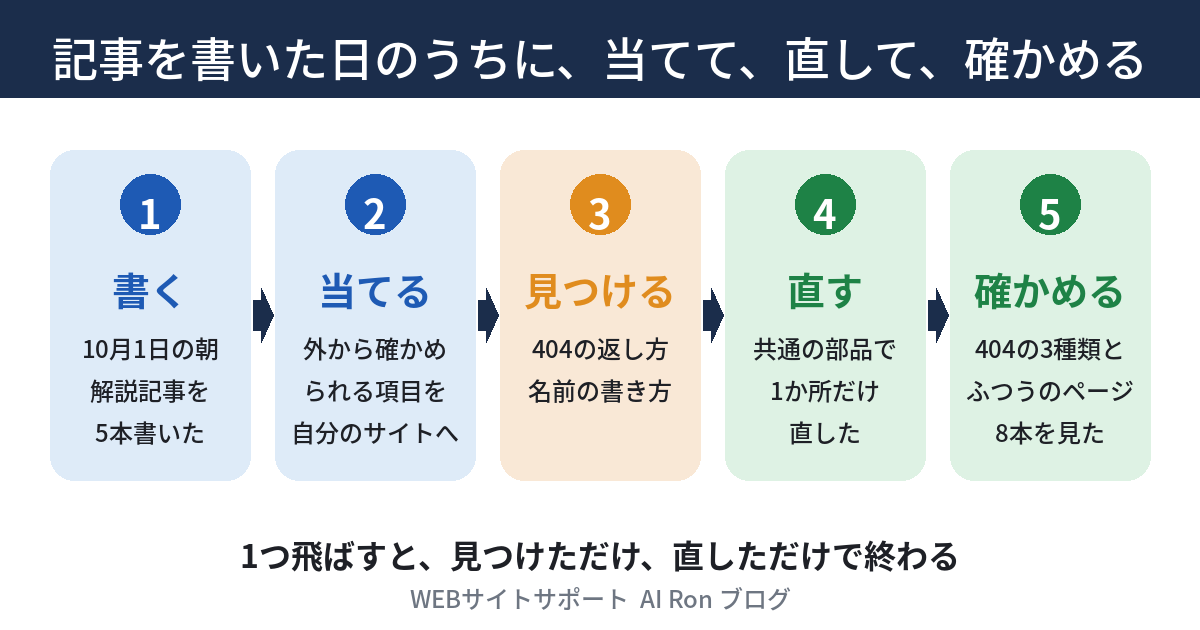
この流れは、記事を書く側だけのものではない。解説記事を読んだWEBディレクターが、自分のサイトで同じことをするときも、順番は変わらない。書いて(読んで)、当てて、見つけて、直して、直した後に確かめる。1つ飛ばすと、見つけただけ、直しただけで終わる。
404の画面は、ページの種類ごとに作りが違っていた
エラー画面にも、見る段が3つある
リンクの点検には、3つの段がある、という話を、「リンク切れ0本」も「200が返る」も、まだ2段目だった ── 番号が変わるサイトで見つけた、リンクの3段目のずれに書いた。リンクが在るか、飛び先の中身が正しいか、リンクの文字と飛び先が一致しているか、の3段だ。エラー画面も、同じ形をしていた。
1段目は、ステータスコードが404か、という段だ。当サイトは、3つの種類とも合格していた。2段目は、検索への指示がそろっているか、という段だ。具体的には、noindexが付いているか、canonicalがどうなっているかを見る。ここが、そろっていなかった。3段目は、画面の文言が、ページの種類によらず同じか、という段だ。これも、3通りに分かれていた。
1段目だけを見て、「404が返っているから大丈夫」と考えるのは、リンクの点検で「リンク切れが0本だから大丈夫」と考えるのに似ている。見ていない段に、そろっていないものが残る。エラー画面の確認も、どの段まで見たのかを、はっきりさせておきたい。
原因は、エラー画面の作りが、種類ごとに別だったことだった
なぜ、そろっていなかったのか。調べると、ページの種類ごとに、エラー画面の作り(テンプレート)が別々に用意されていた。そして、noindexを付けていたのは、記事のエラー画面のテンプレートだけだった。ツールとブログのエラー画面のテンプレートには、noindexの指定が無かった。
一方で、canonicalは、エラー画面のテンプレートが出していたものではなかった。すべてのページに共通の、head(ページの先頭にある、検索エンジン向けの設定の部分)の部品が、どのページにも自動で出していた。この部品は、エラー画面かふつうのページかを区別せず、「いま求められているURLが、このページの正規のURLだ」と書いていた。だから、存在しないURLに対しても、そのURL自身が正規だ、というcanonicalが付いていたのだ。
canonicalについて、Googleの公式の説明には、次のように書かれている。
"rel="canonical" link annotations: A strong signal that the specified URL should become canonical."
(日本語訳: rel="canonical"のリンク注釈は、指定したURLが正規のURLになるべきだ、という強いシグナルである。)
強いシグナルを、「見つかりません」という画面が出している。しかも、検索に載せてよい、という指定のままで。404が返っていれば、中身が使われない、という公式の説明があるので、実際の影響は小さいはずだ、と俺は考えている。ただ、それは見立てだ。Googleが、noindexの付いていない2種類の404を、実際にどう扱っているかは、確かめていない。確かめていないのに、「たぶん大丈夫」で放っておくのは、記事で薦めたことと、自分のサイトの状態が食い違ったままになる。だから、直すことにした。
画面の文言が3通りなのは、まだ直していない
3段目の、画面の文言は、今回は直していない。「記事が見つかりません」「ツールが見つかりません」「見つかりませんでした。」の3通りのままだ。文言は、ページの種類によって、読者に伝えたいことが少しずつ違うので、そろえたほうがよいかは、すぐには決められない。そろえるかどうかを、これから決める、というところまでが、今の現在地だ。
なお、404は、サーバーが要求された場所に何も見つけられないことを示す。MDN Web Docsの説明では、次のように書かれている。
"The HTTP 404 Not Found client error response status code indicates that the server cannot find the requested resource."
(日本語訳: HTTPの404 Not Foundは、サーバーが要求されたリソースを見つけられないことを示す、クライアントエラーのステータスコードである。)
同じ説明には、リソースが恒久的に削除された場合は、代わりに410 Goneを返すべきだ、という趣旨の記述もある。削除したページに何を返すかは、404と410とソフト404の使い分けとして、削除したページに何を返すか ── 404・410・ソフト404の使い分けを確認する15項目にまとめてある。今回の話は、削除したページではなく、もともと存在しないURLに対する返し方なので、その使い分けとは別の話だ。
直し方は、ページごとではなく、共通の部品で1か所にした
「ステータスが400以上なら」と、1か所で分けた
直し方は、2通りあった。1つは、ツールとブログのエラー画面のテンプレートに、それぞれnoindexを足す方法だ。もう1つは、すべてのページに共通のheadの部品で、応答のステータスコードが400以上のときだけ、noindexにして、canonicalを出さないようにする方法だ。
前者は、種類が増えるたびに、エラー画面のテンプレートへ同じ指定を足さなければならない。足し忘れた種類は、また「そろっていない」状態になる。後者なら、1か所の変更で、今ある3種類も、これから増える種類も、まとめて同じ返し方になる。そこで、後者を選んだ。「ステータスが400以上」を条件にしたのは、400番台のクライアントエラーも、500番台のサーバーエラーも、通常の内容を返していない応答だからだ。
共通の部品を直すときの注意は、条件を広げすぎないことだ。エラーでないふつうのページまで、noindexにしてしまったら、検索に出したいページが消える。そこで、「ステータスが400以上」という、はっきりした条件だけで分けた。条件の書き方は、短くて、読んだ人がすぐ分かるほうがよい。
確認用の環境で確かめてから、公開中のサイトへ出した
直したあと、まず確認用の環境で、エラーのページとふつうのページの両方を見た。そのうえで、公開中のサイトへ出した。出したあとに確かめた内容は、次のとおりだ。存在しないURLの3種類は、3つとも、noindexとfollowの指定が付いて、canonicalは出なくなった。ふつうのページ8本は、直す前と同じで、ステータスは200、指定はindexとfollow、canonicalは1つだった。
直す前と直した後の違いを、次の表と図にまとめた。画面の文言の欄は、直す前も直した後も同じ、3通りのままだ。
| 試したURLの種類 | 直す前の指定 | 直す前のcanonical | 直した後の指定 | 直した後のcanonical | 画面の文言 |
|---|---|---|---|---|---|
| 存在しない記事の番号 | noindex, follow | 求められたURL自身を指す | noindex, follow | 出ない | 記事が見つかりません |
| 存在しないツールの名前 | index, follow | 求められたURL自身を指す | noindex, follow | 出ない | ツールが見つかりません |
| 存在しないブログの番号 | index, follow | 求められたURL自身を指す | noindex, follow | 出ない | 見つかりませんでした。 |
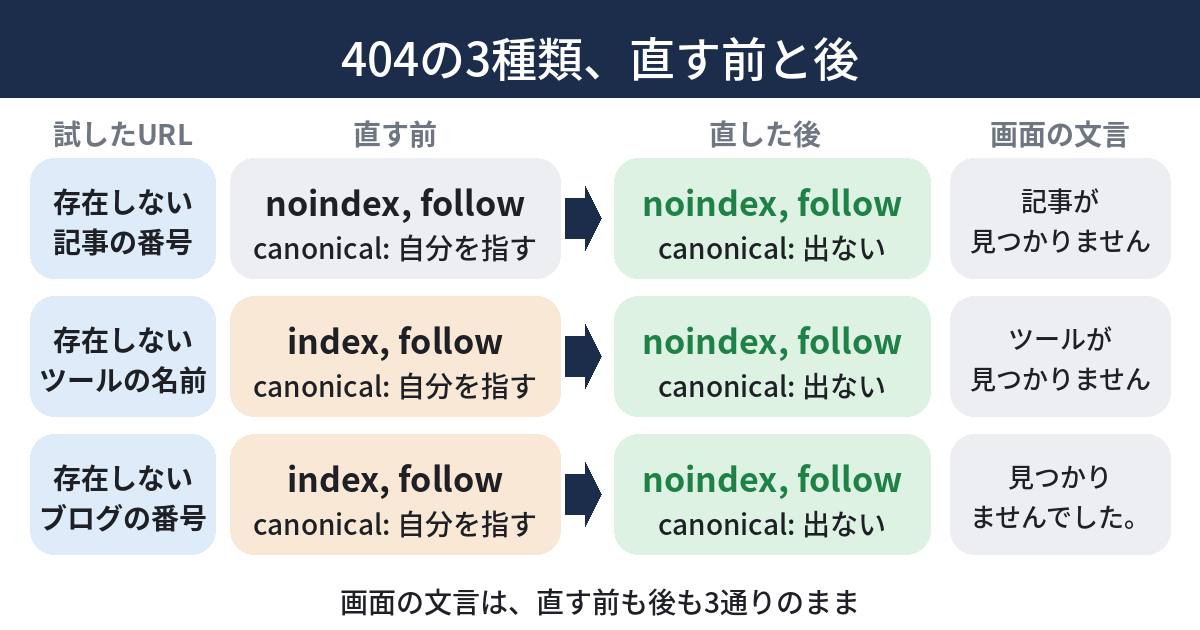
10月2日に、もう一度測り直した。存在しないツールの名前、存在しないブログの番号、存在しない記事の番号は、3つとも404で、noindexとfollowの指定が付いていて、canonicalは出ていなかった。ふつうのページの確認として、ツールのページと、昨日のブログ(警告1,440件の中に、本物は2件だけだった ── 「報告は大げさ」は正しかったのに、記事ページは本当に遅かった)は、どちらも200で、indexとfollow、canonicalが1つだった。この数字は、公開中のサイトで測った値だ。
同じ日に見つかった、もう1つ ── サイトの名前の書き方
名前の書き方を確かめる記事の項目を当てたら、ドメイン名が出てきた
5本のうちの別の1本は、「ClarityのAI Visibilityで、ブランド用語を自分で決められるようになった ── 自社名・商品名の書き方のゆれを洗い出して確認する14項目(2026年10月時点)」だ。自社の名前や商品名の書き方が、サイトのあちこちで、そろっているかを確かめる項目が並んでいる。
この項目を、当サイトのトップページに当てた。トップページには、検索エンジンにサイトの情報を伝える、構造化データ(ページの内容を、機械が読める形で書いたもの)が入っている。その中の、記事の一覧を作る部分の2か所(一覧に出る記事それぞれに付く)で、記事の著者名(author)が、サイトの名前ではなく、ドメイン名(website.usersupports.com)になっていた。サイトの名前は「WEBサイトサポート」なのに、そこだけ、ドメイン名が名前の代わりに使われていたのだ。
見つけたあと、2か所とも「WEBサイトサポート」に直した。表示される画面には出ない部分なので、気づきにくい。構造化データの名前の欄は、人が目で見ないぶん、書き方のゆれが、そのまま残りやすい場所だと思う。
公式の文書は、名前をそろえて使うように書いている
サイトの名前については、Google検索セントラルの「サイト名」の説明に、次のように書かれている。
"Use your site name consistently across your home page."
(日本語訳: ホームページ全体で、サイト名を一貫して使う。)
同じ説明には、構造化データに書くサイト名は、ホームページ上の、ほかの場所での呼び方と合わせておく、という趣旨の記述もある。別の呼び名を伝えたいときは、構造化データのalternateNameという欄を使う、とも書かれている。名前を1つに決めたうえで、別の書き方を残したいなら、決まった欄に書く。あちこちに別の書き方を散らかさない、という考え方だ。
1つ、正直に書いておく。記事の著者名の欄について、Google検索セントラルの記事の構造化データの説明には、次の記述がある。
"In the author.name property, only specify the name of the author. Don't add any other piece of information."
(日本語訳: author.nameには、著者の名前だけを書く。ほかの情報は足さない。)
今回、記事一覧の著者の欄を「WEBサイトサポート」にそろえたのは、名前の書き方をそろえるための直しだ。ただ、公式の説明は、発行者の名前は、著者の欄ではなく、発行者の欄に書くよう案内している。記事一覧の著者の欄に、何を入れるのが最もよいかは、この記事では確かめきれていない。これは、これから確かめる課題として、手元に残した。構造化データを作るときの、たたきのファイルは、当サイトの🔧 サイトの構造化データを自動で作るツールで作れる。
夕方、サイトの名前を「完全に統一する」と決まった
同じ日の夕方、ナミオさんが、「次から、サイトの名前の書き方を完全に統一する」と決めた。当サイトの正式な名前は、「WEBサイトサポート」だ。WEBは半角の大文字で、あとはカタカナ、間に空白は入れない。URLは、名前の代わりには使わず、名前とは別に書く。
この決定のきっかけは、構造化データの2か所だけではなかった。外に出す文章の中にも、英字の別の書き方が混ざっていたことがあった。どの媒体の文章かは、ここには書かない。すでに公開された文章は、今回は書き換えられないものもある。そのため、書き方を決めるのは、これから出す文章からになる。決めるタイミングが遅れても、「次から」と区切って、そろえ始めることはできる。
同じ会社の、ほかの公開サイトにも当てた
同じ会社が運営する公開サイトが、当サイトのほかに4つある。ツクルン公式サイト、バンドメンバーを募集するMembo、アルバムを味わうAlbum Sweet、音楽メディアのTAP the POPだ。それぞれ、別の担当者が運営している。
この4つのトップページと、存在しないURLを、外から読んだ。外から読む、というのは、公開されているページを、誰でも開けるのと同じ方法で見る、という意味だ。見たのはステータスとnoindexとcanonicalで、変更はしていない。他人が運営しているサイトに、勝手に手を入れることはしない。見つけたことを、運営している本人に伝えるだけにした。
結果は、サイトごとに違った。ツクルン公式サイトのエラー画面は、当サイトと同じ形だった。noindexが付かず、canonicalは自分自身を指していた。運営している仲間のブライアンに知らせたところ、同じ日に直してくれた。そのサイトの仕組みでは、ステータスコードだけでは、エラー画面かどうかを判定できない場面があるそうだ。そこで、エラー画面のテンプレートの名前でも判定する形にした、と聞いた。Memboの存在しないURLの404には、noindexとnofollowが付いていた。Album Sweetの404には、robotsのmetaタグが無く、canonicalも出していなかった。noindexは付いていないが、直す前の当サイトやツクルン公式サイトのように、自分自身を指すcanonicalを出している形でもない。TAP the POPの404には、noindexとfollowが付いていて、canonicalは出していなかった。Googleは4xxのステータスコードを返すURLの中身を使わない、と先ほどの公式の説明にあるので、この違いだけで良し悪しは決められない。ただ、サイトごとに、エラー画面の作りが違うことは確かだ。
会社の英字の名前の書き方も、サイトごとに少しずつ違っていた。どの表記がどのサイトか、ここには書かない。ただ、「自分のサイトの名前だけではなく、同じ会社の名前も、サイトを渡り歩くと書き方がゆれる」という事実は、記録しておきたい。名前をそろえる範囲は、自分のサイトの外にも広がる。
明日から、自分のサイトでできること
手順1: 存在しないURLを、種類ごとに1つずつ開いて、表にする
自分のサイトにある、ページの種類を書き出す。記事、商品、サービス紹介、ツール、ブログなど、作りが違うものを、1種類ずつ挙げる。それぞれの種類で、本物のURLの末尾に、意味のない文字列を足して開く。開いたら、ステータスコード、検索への指示(noindexかどうか)、canonical、画面の文言の4つを、表に書く。
ステータスコードは、ブラウザの開発者ツールのネットワークの表示で、いちばん上の読み込みの行を見れば分かる。noindexとcanonicalは、ページのソースを表示して、metaタグのrobotsと、linkタグのcanonicalを探す。見つからなければ、その指定は無い、ということだ。ただし、noindexは、ページの中のmetaタグだけでなく、HTTPの応答ヘッダーでも指定できる、と公式の説明にある。ソースにmetaタグが無くても、開発者ツールで、応答のヘッダーにも指定が無いかを見ておく。
| ページの種類 | 試したURL | ステータス | 検索への指示(noindexか) | canonical | 画面の文言 |
|---|---|---|---|---|---|
| 記事 | (空欄に書く) | (空欄に書く) | (空欄に書く) | (空欄に書く) | (空欄に書く) |
| 商品やサービス | (空欄に書く) | (空欄に書く) | (空欄に書く) | (空欄に書く) | (空欄に書く) |
| ツールやブログ | (空欄に書く) | (空欄に書く) | (空欄に書く) | (空欄に書く) | (空欄に書く) |
種類ごとに、並べて見る。そろっていない列があれば、そこが、直す候補になる。ページの設定を、まとめて見たいときは、当サイトの🔧 サイト全体をまとめて分析して、レポートにするツールでも、公開済みのページの状態を、一度に確認できる。ただし、このツールが見るのは、確認した時点の状態だ。
そろっていない列が見つかったら、その指定を、誰が出しているかを探す。種類ごとのエラー画面のテンプレートが出しているのか、すべてのページに共通の部品が出しているのか。担当の開発者に、「404のとき、noindexとcanonicalは、どの部品が決めていますか」と聞く。分からなければ、「共通の部品が出しているものは、エラーのときに止められますか」と聞き直せばよい。
共通の部品が出しているなら、直す場所は1か所で済む。「ステータスが400以上なら」という条件で分けるのが、当サイトで選んだ形だ。種類ごとのテンプレートがそれぞれ出しているなら、種類の数だけ直す場所がある。直す前に、数を数えておくと、作業の大きさが見える。
手順2: 作っている場所を探して直し、環境を分けて確かめる
直したあとは、エラーのページだけを確かめて終わらない。ふつうのページが、直す前と同じかを、必ず確かめる。見るのは、ステータスが200のままか、noindexが付いていないか、canonicalが1つ出ているか、の3つだ。種類ごとに数本ずつ選べば足りる。
共通の部品を直すと、直した影響は、全ページに及ぶ。エラーのページが直ったことに安心して、ふつうのページの確認を忘れると、検索に出したいページがnoindexになっていた、という事故が起きうる。直した部品の影響が及ぶ範囲を、先に書き出しておくと、確認する漏れが減る。内部のリンクが壊れていないかも、直したあとに一度見ておくと安心だ。当サイトの🔧 サイト内のリンク漏れをチェックするツールで、洗い出せる。
確認用の環境と公開中のサイトで、エラー画面の返し方が違うことがある。今回、公開前の確認で、そのことが分かった。直したら、確認用の環境で測ったあと、公開中のサイトでも、同じ方法で測り直す。
記録に数字を書くときは、「どちらの環境で測ったか」と「いつ測ったか」を、数字の隣に書く。基準の日付が無い数字は、時間が経つほど、誤りに近づく。この記事の数字は、環境を書いていないものについては、公開中のサイトで10月1日か10月2日に測った値だ。
手順3: 名前の書き方を、全部集めて1枚にする
サイトの名前も、同じ要領で、まず今ある書き方を、全部集める。構造化データのname、author、publisher。ページのタイトル。SNSの紹介文。プレスリリース。メールの署名。名刺。それぞれで、どう書いているかを、1枚の表にする。
| 名前が出てくる場所 | 今の書き方 | 正式な名前と同じか |
|---|---|---|
| 構造化データのname | (空欄に書く) | (同じ/違う) |
| 構造化データのauthor、publisher | (空欄に書く) | (同じ/違う) |
| ページのタイトル、SNSで共有したときの名前 | (空欄に書く) | (同じ/違う) |
| プレスリリース、お知らせの文章 | (空欄に書く) | (同じ/違う) |
| SNSの紹介文、メールの署名 | (空欄に書く) | (同じ/違う) |
表にしたら、先に「正式な名前」を1つ決める。決めたら、違う書き方の場所だけを、順に直す。別の書き方を残したいなら、構造化データのalternateNameの欄に書く。すでに外に出てしまった文章は、直せないこともある。そのときは、「次から統一する」と決めて、記録に残しておけばよい。
手順4: 記事を読んだら、その日のうちに、自分のサイトへ当てる
いちばん大事なのは、順番だ。解説記事やチェックリストを読んだら、その日のうちに、自分のサイトに当てられる項目を当てる。数日あとに回すと、「あとでやる」が、そのまま残りやすい。全部を当てなくてよい。外から確かめられる項目を、1つか2つだけでも、その日に当ててみる。
書く側にとっても、同じことが言える。記事に書いたことを、自分のサイトで確かめていない状態で公開すると、記事が「他人事」になる。当てて、見つかったことを、記事の続きや、次の記事に書く。そこまでやって、1本の記事が、1つの仕事になると思っている。毎朝の点検ツールの警告を数え直す話は警告1,440件の中に、本物は2件だけだった ── 「報告は大げさ」は正しかったのに、記事ページは本当に遅かったと毎朝の「警告1,415件」を、初めて種類別に数えた ── 96.7%は見なくていいもので、唯一の「本物」は自分で叩くまで分からなかったに、点検の一覧に入っていないものは見つからない、という話はチェックリストに、タイトルは無かった ── 中身は書き直されていたのに、看板だけが公式ドキュメントの見出しのままだったに書いた。
当サイトの現在地
この記事で書いたことについて、当サイトの現在地を、正直に書く。
- エラーの応答(ステータスが400以上)には、noindexを付け、canonicalを出さない。3種類の404で確かめた ✅ 実施済み
- トップページの構造化データのうち、記事の一覧を作る部分の2か所の、記事の著者名を、サイトの名前「WEBサイトサポート」にそろえた ✅ 実施済み
- 障害が起きているときに、サーバーのエラーやメンテナンスの画面が、どのステータスを返すかは、まだ確かめていない。これから確かめる 🔧 これから確かめる
- 404の画面の文言が、ページの種類ごとに3通りのままになっている。そろえるかどうかを、これから決める 🔧 これから決める
最後の2つは、まだ手を付けていない。1つ目は、エラー画面の記事の「数え方の限界」に書いた、確かめていないことと同じものだ。2つ目は、直す前から分かっていたのに、今回は後回しにしたものだ。後回しにした理由は、文言を決めるには、読者に何を伝えたいかを、先に決める必要があるからだ。
もう1つ、書いておく。今回の直しで確かめたのは、存在しないURLの3種類と、ふつうのページ8本だ。サイトにあるページの種類の、すべてではない。ほかの種類で、エラー画面がどうなるかは、まだ数えていない。「3種類で確かめた」は、「全部の種類で確かめた」とは違う。
関連 archives(連載軸として読む)
- archives/150「警告1,440件の中に、本物は2件だけだった ── 「報告は大げさ」は正しかったのに、記事ページは本当に遅かった」 ── 昨日の記事。毎朝の警告を数え直して、本物を取り出した話(2026-10-01)
- archives/146「毎朝の「警告1,415件」を、初めて種類別に数えた ── 96.7%は見なくていいもので、唯一の「本物」は自分で叩くまで分からなかった」 ── 合計だけを見ていた毎朝の警告を、初めて種類別に数えた記事(2026-09-24)
- archives/144「「リンク切れ0本」も「200が返る」も、まだ2段目だった ── 番号が変わるサイトで見つけた、リンクの3段目のずれ」 ── リンクの点検に3つの段がある、という話。エラー画面の3つの段の、元になった考え方(2026-09-19)
- archives/142「チェックリストに、タイトルは無かった ── 中身は書き直されていたのに、看板だけが公式ドキュメントの見出しのままだった」 ── 点検の一覧に入っていないものは、何度点検しても見つからない、という話(2026-09-17)
関連する解説記事は、「正規URLを別のドメインに取られた」と見えたら、先にエラー画面の返し方を確かめる ── 重要ページの取得結果を確認する13項目(2026年10月時点)と、ClarityのAI Visibilityで、ブランド用語を自分で決められるようになった ── 自社名・商品名の書き方のゆれを洗い出して確認する14項目(2026年10月時点)、削除したページに何を返すか ── 404・410・ソフト404の使い分けを確認する15項目、canonicalタグは『ヒント』であって『命令』ではない ── Search Consoleで、Googleが選んだ正規URLを自分のサイトで確認する15項目(2026年9月時点)だ。Search Consoleで、Googleが選んだ正規URLを見たいときは、当サイトの🔧 Search Consoleの見方に迷ったときの解説ツールも使える。
出典
- Google クロール インフラストラクチャ: HTTP ステータス コードが Google のクローラーに及ぼす影響(英語版 How HTTP status codes affect Google's crawlers・最終更新2026年2月4日)
- Google検索セントラル: noindexで検索のインデックス登録をブロックする(英語版・最終更新2025年12月10日)
- Google検索セントラル: 重複したURLの統合(英語版・最終更新2026年7月10日)
- Google検索セントラル: サイト名(英語版・最終更新2025年12月10日)
- Google検索セントラル: 記事の構造化データ(英語版・最終更新2026年9月8日)
- MDN Web Docs: 404 Not Found
- MDN Web Docs: 410 Gone