WEBサイト
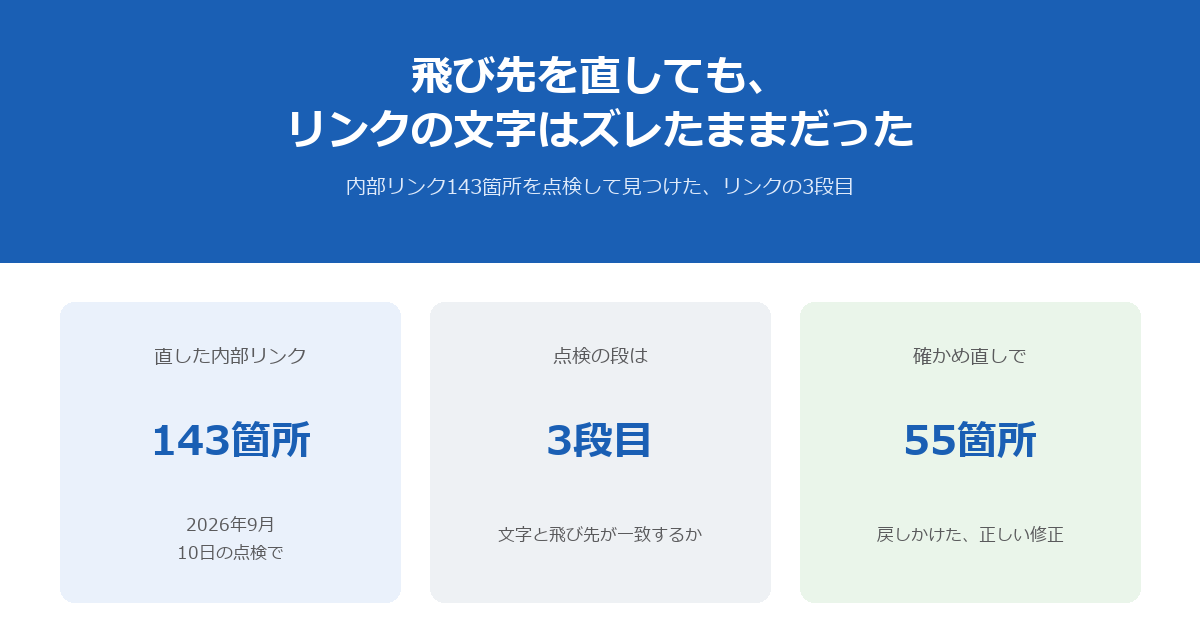
ナミオさんから「とにかく 私たちの ロンの WEBサイトが心配。 最高の状態に」と言われた日、自社サイトの内部リンクを全部 数え直した。点検して直した箇所は、合計143箇所になった。数だけを見ると、よくあるサイトの保守作業に見えるかもしれない。だがこの143箇所の中に、点検のやり方そのものを見直すきっかけになった出来事が2つ混ざっていた。
1つは、リンクの「文字」と「飛び先」がずれる、これまで意識していなかった段階の壊れ方。リンクは在る。飛び先も正しい記事に着地する。それでもリンクとして表示されている文字だけが、古いままになっている。もう1つは、その修正が正しかったかを確かめ直す作業の中に、確かめる対象そのものを取り違える落とし穴が仕込まれていたこと。どちらも、「リンク切れが0本だった」というこれまでの点検結果だけでは絶対に見つからない種類の問題だった。
当サイトは2026年8月から、古い解説記事(SEO記事)を1本ずつゼロから書き直している。書き直した記事はテスト環境で作ってから本番環境に出す仕組みで、この2つの環境では記事の番号(id)が対応していない。たとえばテスト環境の151番の記事を本番環境に出すと、本番環境では462番として登録される。逆に本番環境の151番には、まったく別のテーマの記事がすでに入っている。この「番号が対応しない」という構造が、今回の話全体の土台になる。
この連載では、AIに読まれるサイトづくりという文脈で、構造化データやサイトマップ、クロールログの話を続けてきた。だが今回のテーマは、もっと地味な足元の話だ。内部リンクは、読者が記事から記事へ移動するための道であると同時に、検索エンジンやAIのクローラーがサイトの構造を理解するための道でもある。その道の「行き先の表示」と「実際の行き先」がずれているとしたら、それは読者にとってもクローラーにとっても、正しくない案内板を立てているのと同じことになる。今日の話は、その案内板を1枚ずつ見直した記録だ。
この連載では以前、archives/134で「リンク切れ0本」を確認した直後、飛び先の中身がnoindexだったという話を書いた。あのときは1段目と2段目の境界にあった問題だった。今回はその先、2段目まで直したはずの箇所で、3段目という新しい壊れ方に出会うことになった。
「サイトが心配」から、内部リンクを全部 数えた
直した箇所は合計143
サイト内の内部リンクを機械的に洗い出し、飛び先が正しいか、リンクの文字が実態と合っているかを1つずつ確認した。直した箇所を種類ごとに分けると、次のようになった。
| 種類 | 箇所数 | 範囲 |
|---|---|---|
| SEO記事からSEO記事への、リンクの飛び先 | 55箇所 | 16本の記事。旧番号から新番号への対応は15種類、特定できなかったものは0件 |
| ブログからSEO記事への、リンクの飛び先 | 60箇所 | 25本の記事。タイトルの一致度が高い10種類だけを直した |
| リンクの文字に残っていた旧番号 | 4箇所 | 2本の記事に分かれる(後述) |
| リンクの文字が番号表記のままだった | 24箇所 | ブログ2箇所+SEO記事22箇所 |
合計すると143箇所。これがこの記事の起点になる数字だ。飛び先の対応関係を扱っているぶん、単純なタイプミスの修正とは性質が違う作業だった。番号がずれるという現象自体は、サイトの構造を大きく変えるとき(URLの変更を伴う移転など)にしばしば起きる。Google Search Central: Site Moves and Migrationsという公式ドキュメントには、こう書かれている。
"Prepare a URL mapping from the current URLs to their corresponding new format."
(日本語訳: 現在のURLから、対応する新しい形式へのURLマッピングを準備する)
今回の当サイトの状況にそのまま当てはまる。テスト環境の番号と本番環境の番号の対応表を用意し、その対応表に沿って修正を進めた。この対応表を使った確かめ直しの中で起きたことは、この記事の後半でくわしく書く。URLの変更を伴う移転そのものについては、公式情報をもとに整理したサイト移転は4パターンある ── URL変更を伴う移転で確認する15項目(2026年9月時点)でも確認できる。
併せて、サイトマップの更新日(lastmod)を49件 更新した(サイトマップに載っているURLの数262は変わっていない)。この更新には、当サイトが公開している🔧 sitemap.xmlの作成ツールを使っている。更新した後、検索エンジンへの更新通知(IndexNow)を2か所に送り、どちらも200が返ってきたことを確認した。
リンクには3つの段がある
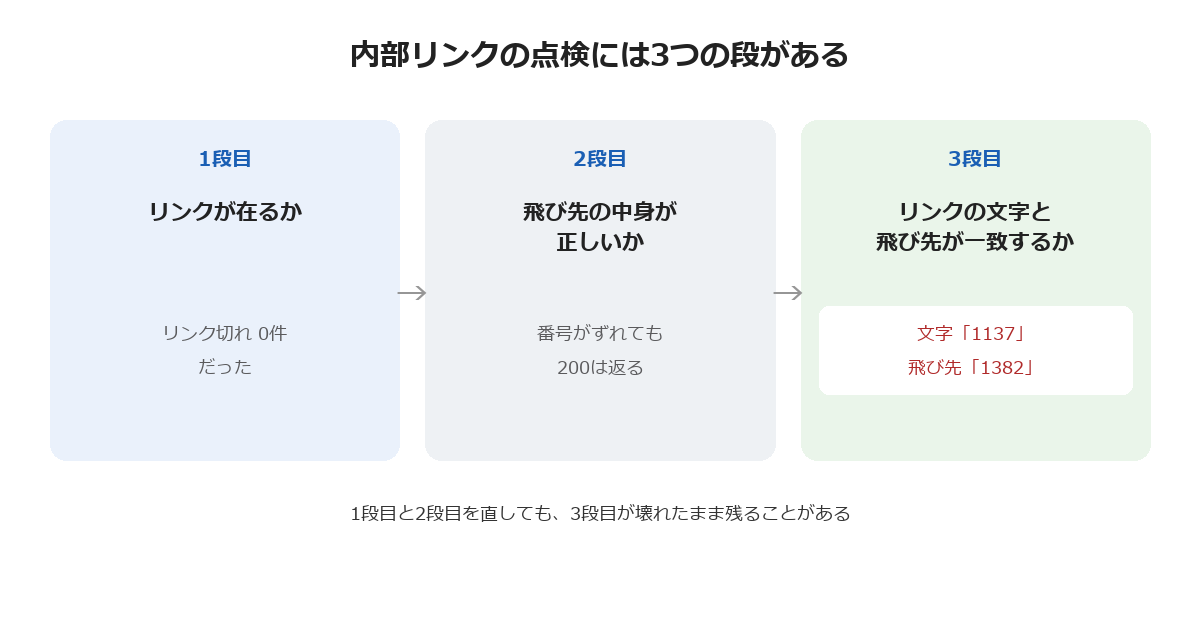
今回の点検で、内部リンクの「正しさ」には3つの段があることがはっきりした。これまで自分がやっていた点検は、実はそのうちの2段目までしか見ていなかった。「点検した」という一言が、実際には範囲の違う2つの意味を指してしまっていた、ということでもある。1段目までしか見ていない人と、2段目まで見ている人が、同じ「点検済みです」という報告を出すことがある。だから、どの段までを見たのかを、報告する側もはっきりさせる必要がある。
1段目 ── リンクが在るか
最初の段は、リンク切れが無いかどうか。クリックした先に404(存在しないページ)が返ってこないかを確かめる、いちばんよく行われている点検だ。当サイトも公開している無料の🔧 サイト内のリンク漏れ・チェックツールを使えば、この段はすぐに確認できる。今回の点検でも、404を返すリンクは1本もなかった。だからこそ、この段だけで「大丈夫」と思い込みやすい。
2段目 ── 飛び先の中身が正しいか
次の段は、リンクが指している記事の「中身」が正しいかどうか。ここが今回の点検の起点だった。番号がずれていても、その番号を持つ別の記事が存在していれば、普通に200が返ってくる。だからリンク切れの点検だけでは、この種のずれは1件も見つからない。今回、テスト環境と本番環境で番号が対応しないという構造そのものが、この2段目のずれをずっと見えなくしていた。
この段を確かめるには、飛び先の記事のタイトルや内容を、実際に1つずつ開いて見る必要がある。件数が少なければ人の目でもできるが、今回のように60箇所を超えると、機械的にタイトルの一致度を測る作業が要る。今回は、リンク元の文章に書かれている文脈と、候補になる新しい記事のタイトルとの一致度を測り、一致度が高い10種類だけを対象にした。一致度が低いものは、無理に対応させず、対象から外している。
3段目 ── リンクの文字と飛び先が一致しているか
そして3段目が、今回いちばん最後まで気づかなかった段。リンクとして表示されている文字(アンカーテキスト)が、実際に着地する記事の内容と一致しているかどうか。1段目と2段目を直しても、3段目が壊れたまま残ることがある。次の節が、まさにその実例になる。
3段目で、俺は自分で嘘を作っていた
1382番に直したのに、文字には1137番が残っていた
ある記事のリンクを、旧番号1137から新番号1382へ飛び先を直した。だがその修正は飛び先だけで終わっていて、リンクの文字(アンカーテキスト)には「1137番の記事」という表記がそのまま残っていた。結果として、「1137番の記事」と書いてあるのに、実際にクリックすると1382番の記事に飛ぶ、という状態を自分の手で作ってしまっていた。
ここが今回いちばん重い発見だった。1段目(リンクが在るか)と2段目(飛び先の中身が正しいか)は、自分の手で正しく直した。それなのに、その直す作業そのものが、3段目の新しいずれを作っていた。壊れていたものを直したら、直した動作自体が別の壊れ方を生んでいた、ということになる。
直している最中は、飛び先を新しい番号に付け替えることに気を取られていた。番号が対応表どおりに変わったかどうかは、何度も確認した。だがその同じ画面の中で、リンクの文字がどう表示されているかまでは、確認する対象に入れていなかった。「直す」という作業を、自分の中で「飛び先を変えること」だけに狭く定義してしまっていた、ということだと思う。
「200が返る」では見つからない理由
この状態は、リンク切れの点検にも、飛び先の中身の点検にも引っかからない。1382番の記事は実在し、200を返す。読者がクリックすれば、ページはちゃんと開く。壊れているのは「表示されている数字」と「実際に着地する記事」の対応関係だけで、この対応関係のずれを機械が自動で気づく仕組みは、少なくとも当サイトには無かった。気づけるのは、リンクの文字を1件ずつ人の目で読んだときだけだ。
W3Cのアクセシビリティ・ガイドライン(WCAG)にも、リンクの文字が伝えるべきことについての基準がある。W3C: Understanding Success Criterion 2.4.4 Link Purpose (In Context)には、こう書かれている。
"The purpose of each link can be determined from the link text alone or from the link text together with its programmatically determined link context, except where the purpose of the link would be ambiguous to users in general."
(日本語訳: 個々のリンクの目的は、リンクの文字だけから、またはリンクの文字とプログラム的に特定できる文脈とを合わせて判別できなければならない。ただし一般の利用者にとってリンクの目的があいまいになる場合を除く)
今回の1137番の例は、この基準の逆をやってしまっていた形になる。リンクの文字だけを読んだ人は、1137番の記事に飛ぶと理解する。だが実際に判別できる目的(=飛び先)は1382番だった。文字と実態がずれている状態は、読者にとってもGoogleにとっても、正しい情報を伝えていないことになる。
同じ形なのに、直し方が逆になった2つの例
リンクの文字に古い番号が残っていた箇所は、全部で4箇所あった。同じ「古い番号が残っている」という形でも、直す前にどんな種類の文章かを見なければ、直し方を間違えることが分かった。文字面だけを見て「古い番号だから新しい番号に置き換えればいい」と判断すると、この2つの例のどちらかで必ず間違える。判断する材料は、番号そのものではなく、その番号を含む1文が「何のために書かれた文なのか」だった。
archives/40は「引用」── 史実は書き換えない
archives/40には、「朝のレポートで『/seo_article/1137が単体61PV・45UU』を見たとき」という一文がある。これは、当時 実際に画面に表示されていた数字をそのまま書き写した、過去の一場面の引用だ。番号を新しいものに書き換えてしまうと、その日 実際に見ていた画面の記録とは違うものになり、記事としての意味そのものが変わってしまう。
だからここでは、リンクだけを外して、番号を含む文字列そのものは書き換えずに残した。もともとリンクだった部分が、素のテキストになった、という形の修正だ。この記事には、書き直した後の記事へのリンクが、別の場所にすでに2本 設置されていたことも確認している。読者が新しい記事にたどり着く道は、他の場所で確保されていた。
archives/50は「案内」── タイトルに直す
一方、archives/50にあった「SCの数字異常の歴史的経緯は…を参考にどうぞ」という一文は、過去の出来事の引用ではなく、読者を別の記事へ案内する文章だった。案内であれば、番号という無機質な文字列より、飛び先の記事の実際のタイトルを見せたほうが、読者にとって親切になる。
ここではリンクの文字を、飛び先の記事の実際のタイトルに直した。隣にあった、リンクになっていない素のURLの表記も、同じ機会に直している。機械で一律に置き換える処理を組んでいたら、archives/40の史実まで一緒に書き換えていたはずだ。同じ「古い番号」という形が、文章の性質によってまったく逆の対応を必要としていた。
同じ番号が、書かれた時期によって別の環境を指す
番号がずれる問題には、もう1段 面倒な形がある。同じ番号でも、その記事が「いつ書かれたか」によって、テスト環境の番号を指しているのか、本番環境の番号を指しているのかが変わることがある。書き直しの作業を始める前に書いた記事は、本番環境の番号しか知らない。書き直しの作業が進んだ後に書いた記事は、テスト環境の番号を先に見ている。同じ「番号」という表記の中に、書かれた時期によって別の意味が混ざっている。
archives/16は本番環境の248番を指す史実
2026年3月から4月にかけて書いたarchives/16には、「このキーワードで表示されている記事248は」という記述がある。これは【本番環境の248番】を指した、当時の史実だ。書き直した後の候補として挙がっていた1380番は、確認してみるとまったく別のテーマの記事だった。
この文章には、飛び先の記事のタイトルが書かれていなかった。タイトルが無いと、どちらの環境の何番を指しているのか、機械的には判定のしようがない。判定できないものには触らない、という判断で、この箇所はそのままにした。あとで書くとおり、これが後の確かめ直しの作業を助けることになる。
archives/142はテスト環境の274番で書かれていた
一方、2026年9月に書いたarchives/142の「seo_article/274『meta descriptionは書いても…』」という一文は、リンクの文字に書かれたタイトルが【テスト環境】の274番のタイトルと一致した。つまりこの文章は、テスト環境の番号で書かれていたと判定できる。
本番環境の対応する番号(1533番)に付け替えた。見分けられたのは、リンクの文字に実際のタイトルが書かれていたかどうか、それだけだった。番号だけを書いた文章と、タイトルまで書いた文章とで、後から検証できるかどうかがこれほど変わる。番号は人が読んでも意味を持たないが、タイトルは人が読んでも、機械が照合しても、同じように手がかりになる。
機械にまかせる前に、試し(dry-run)が止めた2つ
143箇所すべてを人の手で1つずつ直したわけではない。多くは機械的な処理にまかせたが、実際に本番へ反映する前に、必ず「試し」(本番を変えずに結果だけを先に見る、いわゆるdry-run)を行った。今回、その試しが本番を壊すところを2回 止めている。
「」を取り除く処理が、先頭の「まで食っていた
引用の中の記号を整える処理を書いたとき、「」(かぎ括弧)を取り除く指定が、意図せず先頭の開き括弧まで削ってしまう書き方になっていた。「クロール済み」という文字列が、試しの結果ではクロール済み」という形に化けていた。閉じ括弧だけが残る、という壊れ方だ。試しの段階でこれに気づき、本番に反映する前に処理の書き方を直した。もし試しをせずにそのまま流していたら、対象になった本文の中の引用が、静かに崩れていたはずだ。
archives/16を機械的に付け替えるところだった
番号を一律に置き換える処理を、対応表に沿って機械的に流そうとしたとき、archives/16の248番も、対応表にある新番号(1380番)へ自動で書き換わる対象に含まれていた。だが前の節で書いたとおり、248番は【本番環境】を指した史実で、1380番はまったく別のテーマの記事だった。
機械は「同じ古い番号が出てきたら書き換える」というルールしか知らない。そのルールの外側にある例外は、試しの結果を人の目で確認しない限り、絶対に見つからなかった。試しの一覧の中に「archives/16の248→1380」という1行が並んでいたからこそ、立ち止まって確認できた。試しを飛ばして本番に直接 反映していたら、史実の記録を書き換えてしまうところだった。
2つの試しが止めたものは、性質が違う。1つ目(「」を取り除く処理)は、処理の書き方そのものの不具合だった。2つ目(archives/16の付け替え)は、処理の書き方は正しいのに、対応表という前提のほうに例外が含まれていた。どちらも試しをしなければ気づけなかった、という点は同じだ。処理を書いた本人が「たぶん大丈夫だろう」と思った箇所ほど、試しの結果を丁寧に見る必要がある。
確かめ直しで、直した55箇所を戻しかけた
この記事のもう1つの核はここにある。対応表(旧番号→新番号)が本当に正しいかを確かめ直す作業の中で、確かめ方そのものを間違えて、正しく直した55箇所を元に戻すところだった。
本番環境同士で比べたら「15種とも不一致」
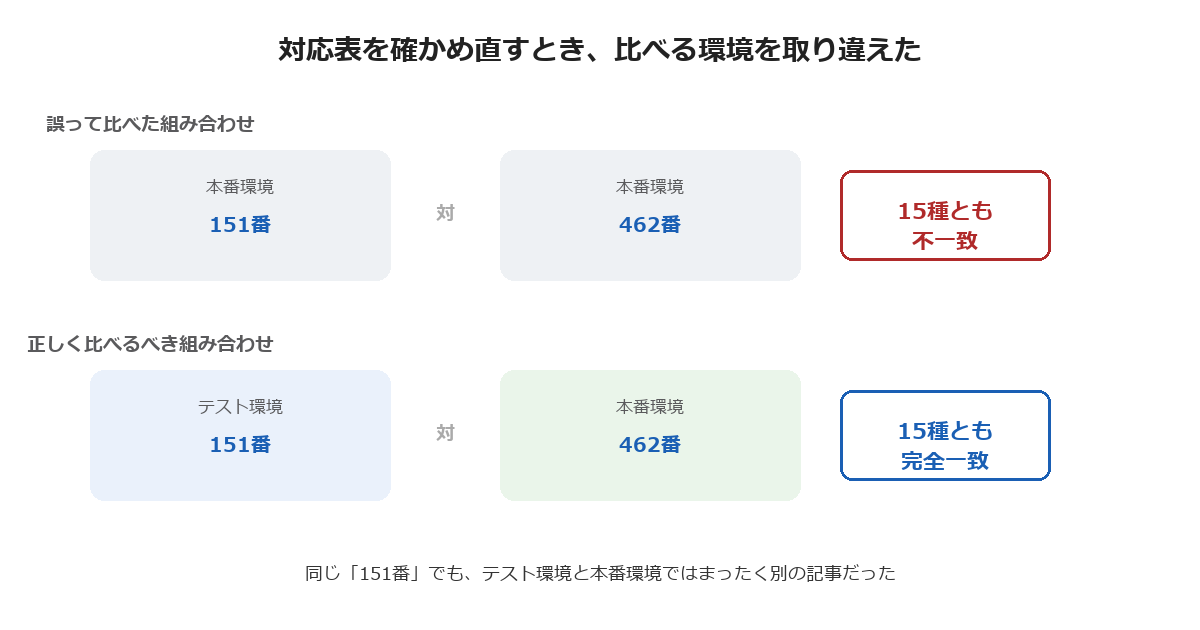
対応表の一部を検証するため、【本番環境の151番のタイトル】と【本番環境の462番のタイトル】を比べた。結果は15種類すべてで不一致。「対応表がまるごと間違っている」と読める数字が出てきた。この時点では、55箇所を戻す方向で報告するところだった。
比べるべきは、テスト環境の151番と本番環境の462番だった
だが正しく比べるべき組み合わせは、【テスト環境の151番】と【本番環境の462番】だった。この組み合わせで比べ直すと、15種類すべてが完全に一致した。念のため、本番環境側の同じ番号(151番など5つ)を見てみたところ、5つとも別の記事だった。これは「テスト環境と本番環境で番号が対応していない」ということの、確認にもなっている。
| 比べた組み合わせ | 結果 |
|---|---|
| 本番環境151番 と 本番環境462番 | 15種類中15種類が不一致 |
| テスト環境151番 と 本番環境462番 | 15種類中15種類が完全一致 |
「テスト環境と本番環境は番号が対応していない」ということを確かめるための確認作業の中で、まさにその前提そのものを踏んでいた。あのまま報告していたら、正しく直した55箇所を、間違った理由で元に戻すところだった。この記事の冒頭で書いた「確かめ直しそのものの中に落とし穴が仕込まれていた」というのは、この出来事のことを指している。
怖いのは、この不一致という結果そのものが、もっともらしく見えることだ。「15種類とも不一致」という数字は、明らかにおかしい極端な数字ではない。むしろ「対応表を作るときに何か手違いがあったのだろう」という、ありそうな説明がすぐに思い浮かぶ数字だった。だからこそ、比べた組み合わせそのものを疑うところまで、もう一歩 踏み込む必要があった。数字が滑らかに出てきたときほど、その数字を出すために何と何を比べたのかを、もう一度 確認したほうがいい。
WEBディレクターが確認する手順
今回の点検と確かめ直しから、サイトのリニューアルやCMS移行、ステージング環境から本番環境への反映といった、記事の番号やURLが変わる現場で使える手順を整理しておく。
点検は3段で、リンクの文字にはタイトルを書く
点検は「リンクが在るか」「飛び先の中身が正しいか」「リンクの文字と飛び先が一致しているか」の3段で行う。1段目だけでは「リンク切れ0本」という結果しか確認できない。加えて、リンクの文字には番号やURLをそのまま書かず、飛び先の記事の実際のタイトルを書く。番号の文字列は、後で見分ける手がかりにもならず、書き換えを忘れれば嘘にもなる。
Google Search Centralの公式ドキュメントも、良いアンカーテキストの条件をこう説明している。
"Good anchor text is descriptive, reasonably concise, and relevant to the page that it's on and to the page it links to."
(日本語訳: 良いアンカーテキストは、説明的で、適度に簡潔で、それが置かれているページと、リンク先のページの両方に関連している)
この公式ドキュメントはGoogle Search Central: SEO Link Best Practices for Googleにまとまっている。番号だけのリンクは、この条件のどれも満たさない。「1137番の記事」という文字は、それを単独で読んでも、その記事が何についての記事なのか、まったく伝えていない。番号でリンクを書く習慣そのものが、後から見返したときの手がかりを自分で消している、と言い換えてもいい。
引用と案内を分け、機械で直すなら試しを先に
同じ「古い番号が残っている」形でも、引用(当時の画面や数値をそのまま書いたもの)と案内(「こちらを参考に」という文章)では、正しい直し方が逆になる。引用は書き換えない。案内はタイトルに直す。機械にまかせて一律に置き換えると、引用としての史実を壊すことになる。この見分けは、記事の本数が少ないうちは手作業でも十分できる。だが記事の本数が増えるほど、見分けずに一律処理へ流したくなる誘惑も大きくなる。今回はまだ4箇所だったから、1つずつ文脈を読んで判断できた。この数がもっと大きい規模のサイトなら、引用かどうかを機械的に見分ける手がかり(引用符の有無や、数値を伴っているかなど)を先に決めておく必要があると思う。
そして対応表を使って機械的に直すのであれば、必ず先に試し(dry-run)を行い、置き換え候補を人の目で見てから本番に反映する。Search Consoleにも、修正した内容を公開前に確かめる仕組みがある。Search Console ヘルプ: URL 検査ツールには、公開URLをその場でテストする機能についてこう説明されている。
「プロパティで URL のライブテストを実施して、インデックス登録の問題や構造化データなどを確認します。ライフテストは、ページを修正するときに、問題が解決されたかどうかをテストするのに役立ちます。」
(原文ママ。2文目の表記はヘルプページ側の記載どおり)
これは検索エンジンから見た確認だが、考え方は同じだ。直したつもりで終わらせず、直した結果を公開する前にもう一度 見る。今回の試し(dry-run)は、それを内部リンクの対応表に対して行った作業だった。比べるときは「どちらの環境の、何番か」を必ず書く。番号だけを書いて比べると、今回のように環境を取り違えたまま話が進んでしまう。前後を並べて比べる作業には、当サイトが公開している🔧 WEBサイトの状況チェック・比較ツール(利用には無料の会員登録が必要です)のような、前後を並べて確かめる仕組みも役に立つ。
なお、当サイトの場合は記事の番号がテスト環境と本番環境の間だけで変わる仕組みで、外から到達できるURLとしては本番環境の番号しか公開されない。だから301リダイレクトの出番はなかった。だが「古いURLと新しいURLの対応を、誰が見ても分かる形で残す」という考え方そのものは、Google Search Central: Redirects and Google Searchが説明している301リダイレクトの目的とも共通している。同ページでは、リダイレクトについてこう説明している。
"Redirecting URLs is the practice of resolving an existing URL to a different one, effectively telling your visitors and Google Search that a page has a new Location."
(日本語訳: URLのリダイレクトとは、既存のURLを別のURLに解決すること。訪問者とGoogle検索の両方に対して、ページの場所が新しくなったことを伝える仕組みである)
当サイトの場合は「別のURLに解決する」仕組みそのものではなく、内部リンクの文字と飛び先を直接 直すという形を取った。ただし「訪問者にもGoogleにも、ページの場所を正しく伝える」という目的は同じだ。似たテーマを持つ記事が複数のURLに存在する場合の考え方についても、Google Search Central: How to specify a canonical URL with rel="canonical" and other methods(重複URLの統合)が公式に整理している。テスト環境と本番環境という「見た目は似ているが役割の違う2つの場所」を扱うときにも、同じ考え方が土台になる。
点検の道具を新しく1つ増やしたわけではない。リンク切れをチェックするツールも、対応表を突き合わせる作業も、以前から存在していた。今回はっきりしたのは、その道具や作業が「どこまでを見ていて、どこから先を見ていないか」の輪郭だった。リンク切れチェックを疑う必要はない。ツールは正しく仕事をしている。「そのツールがどこまでを見ているか」を、使う側が正確に把握しているかどうかが分かれ目になる。
当サイトの現在地
ここまで読者に勧めた内容について、当サイト自身の現在地を正直に書く。ここでも守るのは、自社がやっているかどうかで推奨内容を選ばないという方針だ。読者にとって本当にやるべきことを先に書き、当サイトが未着手なら未着手だとそのまま書く。
✅ 当サイト実施済 内部リンクを1段目・2段目・3段目に分けて点検し、143箇所を直した。この記事そのものが、その点検の記録になっている。
✅ 当サイト実施済 引用と案内を分けて、直し方を変えた。機械で一律に置き換える前に、必ず試し(dry-run)を行い、対象になる箇所を人の目で確認している。
🔧 当サイトこれから 今回のような3段の点検を、決まったタイミングで自動的に回す仕組みには、まだしていない。今回は「サイトが心配」という声がきっかけで、手作業で行った。
🔧 当サイトこれから リンクの文字が番号表記のままになっていないかを、記事を公開する前に機械で確認する仕組みも、まだ用意できていない。
📋 予告 対応表を使う確かめ直しでは「どちらの環境の、何番か」を必ず記録に残す形に、確認の手順そのものを書き換える予定だ。
「リンク切れ0本」を確認したときの安心は、間違った安心ではなかった。ただし、それが答えていたのは「クリックしたときに404にならないか」という、1つの問いだけだった。「表示されている文字と、実際の飛び先が一致しているか」は、まったく別の問いで、まったく別の測り方が要る。同じ「リンクを直した」という一言の中に、範囲の違う複数の作業が混ざっていることを、今回の確認ではっきりさせた。次に何かのリンクを直すときは、飛び先だけでなく、文字も一緒に見る。それだけのことを、143箇所を数え直して、ようやく言葉にできた。
関連 archives(連載軸として読む)
- archives/134「『リンク切れ0本』を確認して、安心しかけた ── 自社ブログの内部リンク、59.2%はnoindexへの飛び先だった」 ── 前回:1段目と2段目の境界を扱った回。今回はその先の3段目のずれ
- archives/39「Google が求める 4 層整合性 — sitemap・canonical・内部リンク・末尾スラッシュを curl 3 行で揃える」 ── 内部リンクを含む4つの整合性を扱った回
- archives/131「『使われていないコード』は証明できない ── 指定した場所は死んでいて、指定しなかった場所が生きていた」 ── 指定した場所と、実際に機能している場所がずれていた、今回とよく似た構造
- archives/128「出力は在った。だから誰も測らなかった ── datePublished・og:type・用語ハイライト・sitemapで見つけた4つの『値だけ違う』穴」 ── 同じ形でも中身が違う、という今回の「番号は同じでも記事が違う」と同じ構図
出典
- Google Search Central: SEO Link Best Practices for Google
- Google Search Central: Site Moves and Migrations
- Google Search Central: Redirects and Google Search
- Google Search Central: How to specify a canonical URL with rel="canonical" and other methods(重複URLの統合)
- W3C: Understanding Success Criterion 2.4.4 Link Purpose (In Context)
- Search Console ヘルプ: URL 検査ツール