WEBサイト
「正規URLを別のドメインに取られた」と見えたら、先にエラー画面の返し方を確かめる ── 重要ページの取得結果を確認する13項目(2026年10月時点)
「正規URLを別のドメインに取られた」と見えたら、先にエラー画面の返し方を確かめる ── 重要ページの取得結果を確認する13項目(2026年10月時点)
目次
01 何が起きたか — 「別のドメインが正規URLに選ばれた」という報告に、Googleの担当者が答えた
報道が伝えたこと
2026年9月18日、検索業界のニュースサイトSearch Engine Journalが、「Googleが、別のドメインが正規URL(canonical)になる脱インデックスの報告に答えた」という趣旨の記事を載せた(筆者はRoger Montti氏)。きっかけは、掲示板サービスのRedditに載った相談である。記事によれば、投稿者は自分のサイトのページが少しずつ、しかし増えながら検索から外れており、Googleが正規URLとして示す先が、まったく関係のないカジノ系のサイトになっている、と訴えた。
"We are seeing a slightly but growing de-indexing of our pages in Google by a very strange domain."
(訳: 私たちのページが、とても奇妙なドメインによって、わずかずつ、しかし増えながらGoogleから脱インデックスされているのを見ています。)
公式情報ではなく、報道である
入口にした報道:Google Responds To Cross-Domain Canonical De-Indexing Report(訳: Googleが、ドメインをまたぐ正規URLによる脱インデックスの報告に応じた)(Search Engine Journal・2026年9月18日)。Redditの元の投稿は確認できていない。ミューラー氏の発言は、この報道が伝えた内容として扱い、英文の引用は、ページの文字を取り出した結果にもとづく。使うときは原文のページで確かめてほしい。
Googleのミューラー氏が挙げた3つの結末
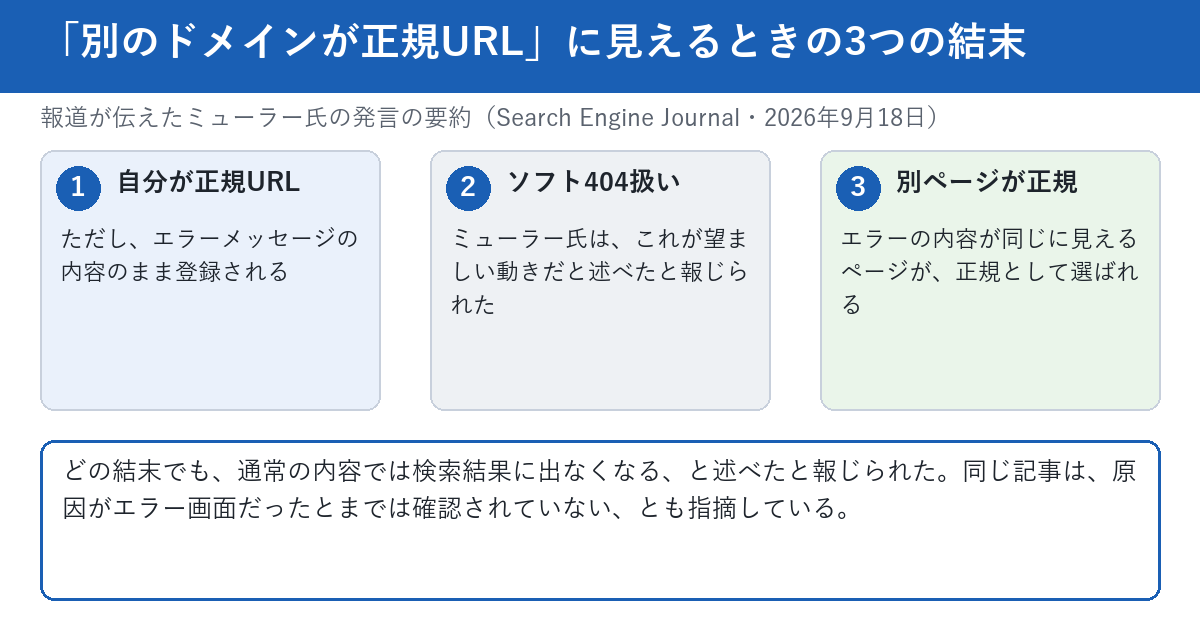
記事によれば、Googleのジョン・ミューラー氏は、別の投稿者が出した説明を、あり得る選択肢の1つと受け止めた。その説明とは、サイトに障害が起きたとき、本来のページの代わりに、JavaScriptで作った汎用のエラーメッセージが表示されていて、Googlebotがそのエラーの画面を取得したのではないか、というものである。同じエラー画面が複数のURLに出ていれば、Googleはそれらを重複と見なしうる。ミューラー氏は、結末が3通りあると述べたと伝えられている。
"a) your page is seen as canonical, but indexed with the server message => your page is not showing in search for normal content"
(訳: a) あなたのページが正規URLと見なされるが、サーバーのメッセージの内容で登録される。その場合、通常の内容では検索に表示されない。)
"b) your page is seen as a soft-404 (imo this is what we should be doing) => your page is not showing in search for normal content"
(訳: b) あなたのページがソフト404と見なされる(私の考えでは、これがGoogleのやるべき扱いだ)。その場合も、通常の内容では検索に表示されない。)
"c) the other page is canonical => your page is not showing in search for normal content"
(訳: c) 別のページが正規URLになる。その場合も、通常の内容では検索に表示されない。)
3つとも、結果は同じである。通常の内容では、検索に出なくなる。違うのは、Search Consoleの画面で、どう見えるかである。
報道自身が付けた但し書き
この報道は、エラー画面が原因だったと断定していない。筆者のMontti氏は、同時に起きた出来事を原因と結果だと思い込むことがある、と書き、投稿者が原因を取り違えている可能性に触れている。「エラー画面が原因だった」とは、報道の中でも確認されていない。この記事も同じ立場で書く。原因を決めつけず、「確かめられる候補の1つ」として扱う。
ミューラー氏が勧めたこと
報道によれば、ミューラー氏は、エラーを公開の前に見つける方法を用意するのがよい、という趣旨のことを述べた。サイトを公開する前に自動のテストをたくさん回し、重要なページを定期的に確認して、検索エンジンが出会う前に問題を見つける、という内容である。Search Consoleのライブテスト(公開URLのテスト)で、Googleがそのページをどう描画しているかを確かめることも勧めたと伝えられている。この記事の手順は、その2つを、自社のサイトで実際にできる形にしたものである。
02 なぜ・背景 — 正規URLは1つの信号では決まらず、エラー画面は「同じ内容」に見えやすい
正規URLは、複数の信号を合わせて選ばれる
Googleの重複URLの統合に関する公式文書は、正規ページを示す方法を、強さの順に3つ挙げている(日本語版の最終更新は2026年7月14日)。リダイレクトは、リダイレクト先が正規ページになるべきことを強く示す信号とされる。rel="canonical"は、指定したURLが正規ページになるべきことを強く示す信号とされる。サイトマップは、正規ページになることを示すが、信号としては弱いもの、とされている。自分が書いたcanonicalは、あくまで信号の1つである。同じ文書の中に、別のドメインが選ばれた場合を説明した箇所は、確認した範囲では見つからなかった。
この仕組みは、別の記事でも整理している(canonicalタグは『ヒント』であって『命令』ではない ── Search Consoleで、Googleが選んだ正規URLを自分のサイトで確認する15項目(2026年9月時点))。この記事は、別のドメインに見えたときの切り分けに絞る。
エラー画面は、URLが違っても同じ内容になる
ここから先は、筆者の見立てである。商品ページが100本あるサイトで、商品データを取りにいく先が止まったとする。止まっている間は、100本のURLのどれを開いても、同じ「現在、情報を取得できません」という画面が出るかもしれない。URLは違うのに、ページの中身は同じになる。Googleは、中身が同じページを重複としてまとめる。エラーの瞬間に取得されたページは、重複としてまとめられやすい形をしている。報道の投稿者が見たとされる「別のドメイン」が、なぜそのドメインだったのかは、報道からは分からない。
Googleは、4xxのページの中身を使わない
Googleの、HTTPステータスコードとネットワークエラーに関する文書は、4xxのステータスコードを返すURLのコンテンツを、Googleは使用しない、と書いている(日本語版の最終更新は2026年3月6日)。404を返すエラー画面は、中身が使われず、重複の判定の材料にもなりにくい。反対に、エラー画面を200で返すと、ページとして受け取られる余地が残る。見た目が同じエラー画面でも、200と404では、Googleの受け取り方が変わる。
ソフト404は、見た目ではなく返し方の話である
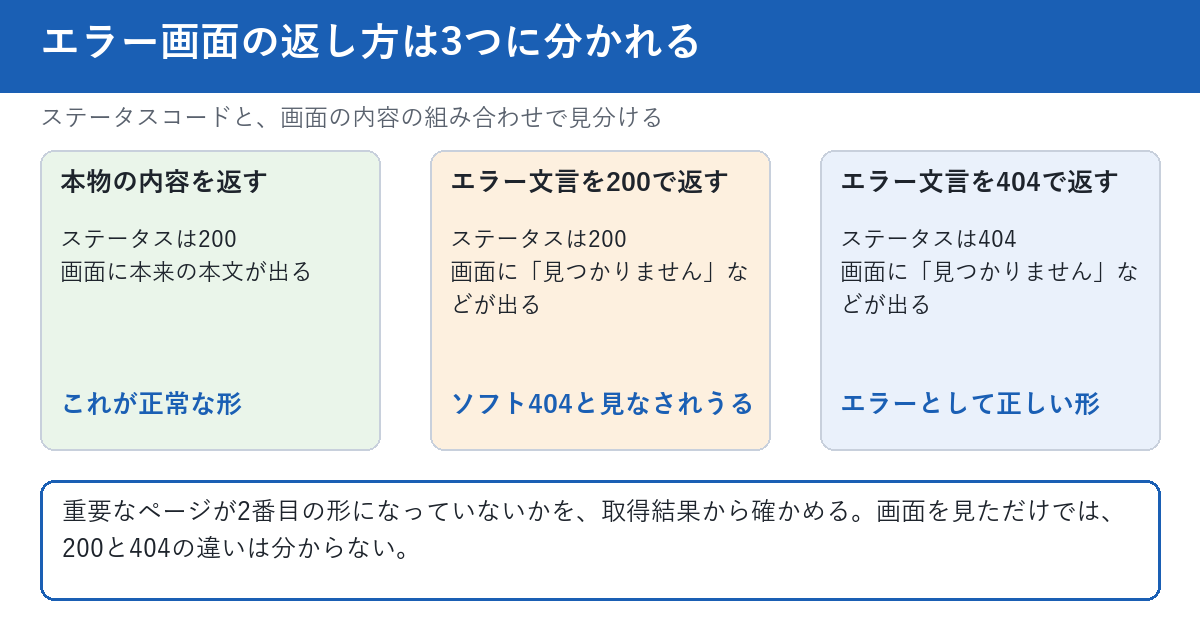
同じ文書は、コンテンツにエラーがあることが示唆される場合(空白のページ、またはエラーメッセージ)、Search Consoleがソフト404のエラーを表示する、と書いている。「見つかりません」と表示しているのに、200を返しているページが、その典型である。画面を見ているだけでは、200と404は区別できない。区別するには、取得した結果のステータスコードを見る必要がある。
障害の瞬間にだけ起きるので、あとから見つけにくい
エラー画面が出ていた時間が短ければ、あとでサイトを開いても、いつもどおりに表示される。正常な画面を確認しても、障害の瞬間に取得された内容は確認できない。だからこそ、Googleがどう取得したかを、Search Consoleの側から見る手順が要る。
03 この記事で出てくる用語
ソフト404
用語
ソフト404:「見つかりません」のような、利用者向けの表示を出しているのに、404ではないステータスコードを返しているページ。Search Consoleのヘルプは、「404 HTTP レスポンス コードではなく、ユーザーフレンドリーな形の『見つかりませんでした』というメッセージが返されました」という趣旨で説明している(最終更新日の表示はなかった)。ここでの「ソフト」は、ステータスコードが本物の404ではない、という意味である。
正規URL(canonical)
用語
正規URL(canonical):同じ内容、またはよく似た内容のページが複数のURLにあるとき、Googleが代表として扱うURL。サイトの側が指定することもでき、Googleが別のURLを選ぶこともある。この記事では、サイトが指定したURLを「指定した正規URL」、Googleが選んだURLを「Googleが選択した正規URL」と書き分ける。
公開URLのテスト
Search ConsoleのURL検査ツールにある機能で、公開されているURLを、その場でGoogleに取得させて確認するものである。Googleのヘルプは、テストしたページの詳細として、描画されたページのスクリーンショット、返された未加工のHTML、HTMLヘッダー、JavaScriptコンソールの出力などが表示される、と説明している。インデックスに登録済みの情報ではなく、今、取得した結果を見るための機能である。
04 型別 — 適用範囲・この記事が確認していないこと・手順
A. この記事が当てはまる範囲
対象は、Search Consoleにサイトを登録していて、重要なページが検索に出ているかを気にしている担当者である。商品データやお知らせを、外部のサービスやデータベースから読み込んで表示するページを持つサイトは、特に当てはまりやすい。
B. この記事が確認していないこと
次の点は、この記事の範囲外である。第一に、エラー画面が原因で、別のドメインが正規URLに選ばれることがあるかどうかは、確かめていない。報道でも確認されていない。第二に、Redditの投稿者のサイトで何が起きていたかは、分からない。第三に、公式の文書に、別のドメインが正規URLに選ばれる理由を説明した箇所があるかどうかは、確認した範囲では見つからなかった。第四に、悪意のある第三者によるcanonicalの不正な書き込みなど、エラー画面以外の原因は、手順の対象にしていない。
注意
Googleの正規化に関する公式文書は、指定と違う正規URLが選ばれる原因として、エラー画面だけでなく、誤った正規化の要素、サーバー設定の誤り、悪意のあるハッキング、配信元が別にあるコンテンツ、コンテンツを盗用したサイトなどを挙げている。この記事の手順で異常が見つからなかったときは、エラー画面ではなかったと言えるだけで、原因が分かったわけではない。公式文書の該当の箇所を、あわせて確認してほしい。
C. 手順の全体像 — 4つの順番で進める
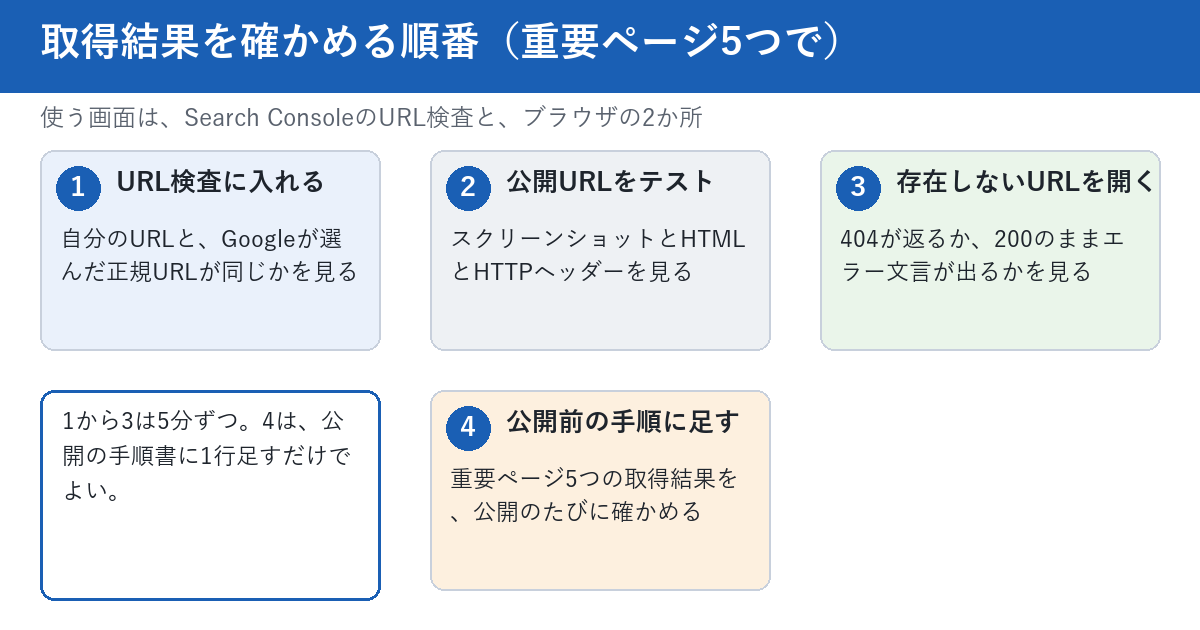
手順は4つに分ける。1つ目は、Search ConsoleのURL検査で、重要なページの正規URLを確かめること。2つ目は、公開URLのテストで、Googleが今、そのページをどう取得するかを見ること。3つ目は、存在しないURLを開いて、エラー画面の返し方を確かめること。4つ目は、この確認を、公開のたびに行う手順に入れることである。1から3は、ブラウザとSearch Consoleだけで、1ページあたり5分ほどで終わる。
重要なページを、5つに絞る理由
サイト全体を調べようとすると、5分では終わらない。トップページ、主力の商品やサービスのページ、問い合わせ、会社概要、最新の記事の5つに絞れば、1つ1つを5分以内に確認できる。5つで異常が見つかれば、同じ仕組みで作られた他のページにも、同じことが起きている可能性がある。
手順1 — URL検査で、Googleが選んだ正規URLを見る
Search ConsoleのURL検査に、重要なページのURLを入れる。Googleの公式文書は、指定と違う正規URLが選ばれているときの確認の最初に、URL検査ツールでGoogleが選択した正規ページを確認することを挙げている。画面に、指定した正規URLと、Googleが選択した正規URLに当たる2つの情報が出る。表示名は、利用中の言語や時期で違うことがある。この2つが同じかどうかが、最初の判断の材料になる。違っていて、しかも別のドメインなら、そのURLの文字列を控え、自分のサイトと関係があるかを、Search Consoleの画面や検索結果での表示で確かめる。見覚えのない、不審なドメインは、ブラウザで開かない。
手順2 — 公開URLのテストで、今の取得結果を見る
同じ画面で、公開URLのテストを実行する。終わったら、テストしたページの詳細を開き、スクリーンショット、HTML、HTTPヘッダーを見る。スクリーンショットに、本来の内容ではなく、エラー文言が写っていれば、Googleはそのとき、エラー画面を取得したことになる。公式のヘルプには、テストに失敗したときの理由の例も載っている。当サイトの🔧 Search Consoleお助けツールの解説で、画面の見方を先に確認しておくと、迷いにくい。
手順3 — 存在しないURLを開いて、エラー画面の返し方を確かめる
自社のサイトで、本物のURLの末尾に、意味のない文字列を足したURLを開く。ブラウザの開発者ツールのネットワークの表示で、そのURLのステータスコードを見る。「見つかりません」と表示されているのに200なら、ソフト404になっている。404なら、エラー画面の返し方は正しい。
手順4 — 公開の手順に、1行足す
ミューラー氏が勧めたとされる、公開前の自動テストは、大げさなものでなくてよい。公開の手順書に、「重要ページ5つを開いて、ステータスコードが200で、本文の見出しが出ていることを確かめる」と1行足すだけで、エラー画面を200で公開したまま気づかない、という事態を減らせる。JavaScriptでエラー画面を作っているサイトでは、公式のJavaScript SEOの文書が、ソフト404を避ける方法を2つ挙げている。1つは、404を返すURLへリダイレクトするJavaScriptを使うこと(JavaScriptのリダイレクトは、サーバー側のリダイレクトやmeta refreshが使えないときにだけ使うよう、リダイレクトの公式文書が書いている。最終更新は2026年4月17日)。もう1つは、エラーページにnoindexのメタタグをJavaScriptで足すことである。
noindexをJavaScriptで足すときの注意
同じ文書は、Googleがnoindexのタグを検出した場合、レンダリングとJavaScriptの実行がスキップされることがある、と書いている(日本語版の最終更新は2026年3月5日)。エラー画面の扱いは、最初のHTMLの段階で決めておくほうが確実である。noindexそのものは、検索結果にそのページを表示しない指定、とGoogleの文書は説明している(最終更新は2026年3月25日)。
05 明日、自社サイトで確認できることチェックリスト
まず13項目を通して見る
以下は、明日、Search Consoleとブラウザだけで、重要なページがエラー画面を返していないかを確かめるまでの項目である。チェックの状態はブラウザに保存され、サーバーには送信されない。1番目が準備、2〜5番目がURL検査と公開URLのテスト、6〜9番目がエラー画面の返し方の確認、10〜11番目が影響の範囲の確認、12〜13番目が再発の防止である。
実務のヒント
ステータスコードの確認は、ブラウザの開発者ツールのネットワークの表示で足りる。ページを開いた状態で、いちばん上に出る読み込みの行のステータスを見る。自社のサイトの内部リンクを、まとめて確かめたいときは、当サイトの🔧 WEBサイト内のリンク漏れ・チェックツールが使える。
- トップページ、主力の商品かサービスのページ、問い合わせ、会社概要、最新の記事の5つのURLを書き出して、確認の対象にする
- 5つのURLをSearch ConsoleのURL検査に1つずつ入れ、指定した正規URLと、Googleが選択した正規URLが同じか確認する
- 2番目で違いが出たURLがあれば、Googleが選択した正規URLの文字列を、Search Consoleの画面で見て、自分のサイトか別のドメインかを確認して控える(見知らぬドメインはブラウザで開かない)
- 5つのURLで公開URLのテストを実行し、テストしたページの詳細で、スクリーンショットに本来の内容が写っているか確認する
- 同じ詳細の画面で、HTMLヘッダーのステータスが200か、HTMLの中に本文の見出しの文字列が1つ含まれているかを確認する
- 自社サイトの本物のURLの末尾に、意味のない文字列を足したURLを3つ開き、ステータスコードが404か確認する
- 6番目で「見つかりません」と表示されているのにステータスが200のURLがあれば、全部控える
- 外部のサービスやデータベースから内容を読み込むページを、開発の担当者に聞いて3つまで挙げてもらい、一覧に書き出す
- 8番目のページで、読み込みに失敗したときに表示される画面とステータスコードを、担当者に聞いて1ページずつ控える
- Googleで、自社のドメインと、エラー画面に出る文言の一部を組み合わせて検索し、同じ文言のページが何件出るかを控える
- サイトの障害や保守のため、サーバーが止まった日が直近3か月にあるか、運用の記録で確認し、あれば日付を書き出す
- 公開作業の手順書を開き、重要ページ5つを取得して200と見出しを確かめる1行があるか確認し、無ければ足す
- 重要ページ5つの確認を、毎週の点検に入れる日付を決め、カレンダーに1件入れる
観点別の内訳と、かかる時間
| 観点 | 該当する項目 | 目安時間 |
|---|---|---|
| 対象を決める | 1番目(1項目) | 5分 |
| URL検査で正規URLを見る | 2〜3番目(2項目) | 15分 |
| 公開URLのテストを見る | 4〜5番目(2項目) | 20分 |
| エラー画面の返し方を見る | 6〜9番目(4項目) | 25〜30分 |
| 影響の範囲を知る | 10〜11番目(2項目) | 10分 |
| 再発を防ぐ | 12〜13番目(2項目) | 10分 |
すべてに目を通す時間の目安は、あわせて1時間30分ほどである(筆者の見積もりで、サイトの大きさによって変わる)。1つの項目が5分を超えそうなら、対象のURLを5つから3つに減らしてよい。
5分で終わらない項目があったとき
公開URLのテストが失敗する、開発の担当者がすぐに答えられない、という場合は、分かった範囲だけを表に書き、「確認できなかった」と書き残す。分からなかったことを残しておけば、次に聞くべき人と質問が決まる。表に空欄が残っていても、先の項目には進める。
06 代替・他の選択肢(表で)
Googleが何を取得したかを知る手段は、1つではない
05章では、Search Consoleのテストとブラウザを中心にした。ただ、同じ「取得結果を確かめる」でも、手段によって見えるものが違う。ここでは、手段ごとに向いていることと、その手段だけでは分からないことを表にまとめる。製品の優劣ではなく、種類ごとの整理である。
それぞれの手段が「できないこと」も知っておく
| 手段 | 向いていること | 使い方 | この手段だけでは分からないこと |
|---|---|---|---|
| 公開URLのテスト | 今、Googleが取得する内容を見る | URL検査に入れて、スクリーンショットとHTMLとヘッダーを見る。 | 過去の障害の瞬間に、何を取得したかは分からない |
| URL検査のインデックス登録済みの情報 | Googleが登録している状態を見る | URL検査の結果で、最後のクロールの日時と、選択された正規URLを見る。 | 障害の瞬間の画面そのものは、確認できないことがある |
| ブラウザの開発者ツール | ステータスコードとヘッダーを確かめる | ネットワークの表示で、読み込みの行のステータスを見る。 | Googlebotが取得したときの結果とは、異なることがある |
| サーバーのアクセスログ | 障害の時間帯に、どのステータスを返したかを見る | 障害の日時で絞り、Googlebotを名乗るアクセスの、ステータスコードを数える。 | 名乗りだけでは、本物のGooglebotかどうか分からない(Googleは、逆引きのDNSやIPの範囲の一覧で確かめる方法を公開している) |
| 外形監視のサービス | 重要ページの状態を定期的に確かめる | 5分や1時間おきに、重要ページのステータスと、本文の一部の文字列を確かめる。 | Googleが取得した内容と同じとは限らず、設定した文字列の有無しか見ない |
サイトの状態をまとめて点検したいときは、当サイトの🔧 WEBサイト総合分析・レポートツールで、公開済みページの状態を一度に確認できる。ただし、これらのツールが見るのは、確認した時点の状態であり、過去の障害の瞬間ではない。
07 当サイトで数えてみた結果
数えた範囲と方法
当サイトでも、重要なページが正常な内容を返しているかを、実際に数えてみた。対象は、2026年10月1日時点で、サイトマップに載っている309のURLである。各URLを1回ずつ取得し、ステータスコード、ページの本文の文字数(タグを取り除いた数)、canonicalの指定、noindexの有無、h1の数、タイトルを調べた。名乗りは、自社の点検であることが分かる名前にした。確認できたのは「サイトマップのURLが取得できた状態」であり、障害が起きた瞬間の状態は、調べていない。
結果は、309のURLすべてで、正常な形だった
| 見たこと | 結果 | 件数 |
|---|---|---|
| ステータスコード | 200で返ったURL | 309本中309本 |
| canonical | 自分自身のURLを指していた | 309本中309本 |
| noindex | noindexが付いていた | 0本 |
| h1の数 | ちょうど1つだった | 309本中309本 |
| 本文の文字数 | 3,000字未満 | 15本(ツール12本・ブログ1本・会社概要1本・記事の一覧1本) |
| 存在しないURL | 3つの種類のURLを試して、3つとも404が返った。noindexが付いたのは記事の404だけだった | 404は3つ中3つ、noindexは3つ中1つ |
本文の文字数の中央値は約12,000字で、最も短いのは記事の一覧のページ(約1,100字)だった。3,000字未満の15本のうち12本はツールのページで、道具の説明が中心なので、短いのは意図した形である。短いことと、ソフト404であることは、別の話である。この15本は、「中身が薄いかもしれない」という候補であり、エラー画面だったという証拠ではない。
存在しないURLは3つとも404を返したが、noindexと画面の文言は揃っていなかった
存在しない記事の番号、存在しないツールの名前、存在しないブログの番号の3つを、公開中のサイトで1回ずつ試した(2026年10月1日)。3つとも404が返った。ただし、残りは同じではなかった。記事の404は、noindexとfollowの指定が付き、画面には「記事が見つかりません」と出た。ツールの404は、indexとfollowの指定のままで、画面には「ツールが見つかりません」と出た。ブログの404も、indexとfollowの指定のままで、画面には「見つかりませんでした。」と出た。canonicalの指定は、3つとも求められたURL自身を指していた。つまり、noindexが付いたのは記事の404だけで、ツールとブログの404は付いておらず、画面の文言も3通りだった。404が返っていれば、中身はGoogleに使われないと、公式文書は書いている。そのため、noindexがなくても、通常は大きな問題にならないと筆者は考えている。ただし、noindexが付いていない2つの404ページを、Googleが実際にどう扱うかは確認しておらず、これは筆者の見立てである。
タイトルのエラー語で絞ると、誤検出が出た
タイトルに「エラー」「404」「見つかりません」を含むページを探したところ、5本が出た。すべて、エラーを主題にした解説記事のタイトルだった。ソフト404ではなかった。文字列で絞るだけでは、主題としてエラーを扱う記事を、エラー画面と取り違える。ステータスコードを先に見て、文字列は補助にする形のほうが、誤検出が少なかった。
この数え方の限界
今回は、次のことを調べていない。第一に、JavaScriptを実行した後の画面である。取得したHTMLだけを見たため、描画後にエラー文言に置き換わるページは、見つけられない。第二に、障害が起きている間の画面である。サイトが正常なときに取得した結果であり、外部のデータの取得先が止まったときの動きは、確かめていない。第三に、サイトマップに載っていないURLである。当サイトが、障害の瞬間にどのステータスを返すかは、まだ確かめていない。公開前に重要ページを取得して確かめる決まりも、今回の数え方では確認できなかった。次の更新までに足す予定である。
数えるときに、探した範囲を書く大切さは、別の記事でも書いた(「0件」に、探した数を書いていなかった ── 9種類で確かめた5日後、73種類で確かめ直した)。
08 このテーマの、これまで
報道と、Googleの公式文書の時系列
今回の報道は、2026年9月18日付である。引用したGoogleの文書の、日本語版に表示された最終更新日は、重複URLの統合が2026年7月14日、正規化の問題の修正が9月11日、HTTPステータスコードが3月6日、JavaScript SEOが3月5日である。Search Consoleのヘルプには、最終更新日の表示が見当たらなかった。
当サイトの過去の記事 — ステータスと正規URLの話
ステータスコードと正規URLについては、これまでも記事にしてきた。削除したページに何を返すかは、別の記事にまとめてある(削除したページに何を返すか ── 404・410・ソフト404の使い分けを確認する15項目)。サーバーがエラーを返し続けたときの、Googleの扱いは、こちらである(robots.txtがエラーを返し続けると、最後は「制限なし」に行き着く ── HTTPステータス別の扱いを確認する13項目(2026年9月時点))。JavaScriptで描画するページがいつ読まれるかは、こちらにある(JavaScriptで描画したページはいつ読まれるのか ── レンダリングキューの仕組みと、確認する14項目)。
確認の範囲が狭かったと後から分かる話は、当サイトのブログにもある(「リンク切れ0本」も「200が返る」も、まだ2段目だった ── 番号が変わるサイトで見つけた、リンクの3段目のずれ)。
数字は確認した時点のものとして扱う
この記事で引用した報道、公式の文言と日付、当サイトの数字は、2026年10月1日に確認したものである。Googleの文書や、Search Consoleの画面は、その後に変わる可能性がある。基準日を書かない数字は、時間が経つほど誤りに近づく。使うときは、必要に応じて公式のページを直接開き、最新の記載を確かめてほしい。
現在の貴方のIPアドレス
このサイトで書いている人