WEBサイト
CloudflareとOpenAIの試験は、存在しないページへの取得・ほぼ全部をトップへ送る転送・同じ中身の複数のアドレスを、取得の前に減らす対象に挙げた ── 自分のサイトの404・転送・重複を確かめる13項目(2026年10月時点)
CloudflareとOpenAIの試験は、存在しないページへの取得・ほぼ全部をトップへ送る転送・同じ中身の複数のアドレスを、取得の前に減らす対象に挙げた ── 自分のサイトの404・転送・重複を確かめる13項目(2026年10月時点)
目次
01 何が起きたか — CloudflareとOpenAIの試験は、AIの検索が取得の前に減らしたい「無駄な取得」の型を3つ挙げた
2026年10月15日に出たCloudflareのブログ
Cloudflareのブログに、OpenAIと共同で進めている研究の試験について、最初の結果を伝える記事が出た。題は「Cloudflare and OpenAI: Making AI discovery better for everyone」(訳: CloudflareとOpenAI — AIによる発見を、みんなにとってよいものに)で、日付は2026年10月15日と書かれている。書き手の4人のうち2人は、OpenAIの所属と記されている。2026年10月16日に開いて読んだ。
試験が始まったのは2026年7月である。ブログによれば、目的は、Cloudflareのネットワークから得られる信号が、ChatGPTの利用者が新しい内容をより効率よく見つける助けになるかを調べることだった。結果についてブログは、これまで知られていなかったページがOpenAIの検索の索引に入った、と書いている。
先に断っておく。ブログの数字はCloudflareが自社のブログで書いたもので、読者のサイトの数字ではない。この記事が取り出したいのは、数字ではなく、ブログが「無駄」と呼んだ3つの型である。それを、Cloudflareを使っていないサイトでも、自分のアクセスの記録と、数本のアドレスを開くだけで確かめられる手順にした。
試験の大きさ
ブログが書いている規模は次のとおりである。
"This joint pilot, which used a participating cohort of ~1% of Cloudflare's total network, has enabled OpenAI to discover and index hundreds of millions of new web pages, helping people discover more useful content and get more questions answered through ChatGPT."
(訳: この共同の試験は、Cloudflareのネットワーク全体のおよそ1%にあたる参加者の集団を使い、OpenAIが数億の新しいウェブページを見つけて索引に入れるのを可能にした。人々がより役に立つ内容を見つけ、ChatGPTを通してより多くの質問への答えを得る助けになっている。)
「無駄な取得」として挙がった3つの型
この記事の中心は、ブログの「From discovery to useful answers」(訳: 発見から、役に立つ答えへ)という節にある次の3文である。
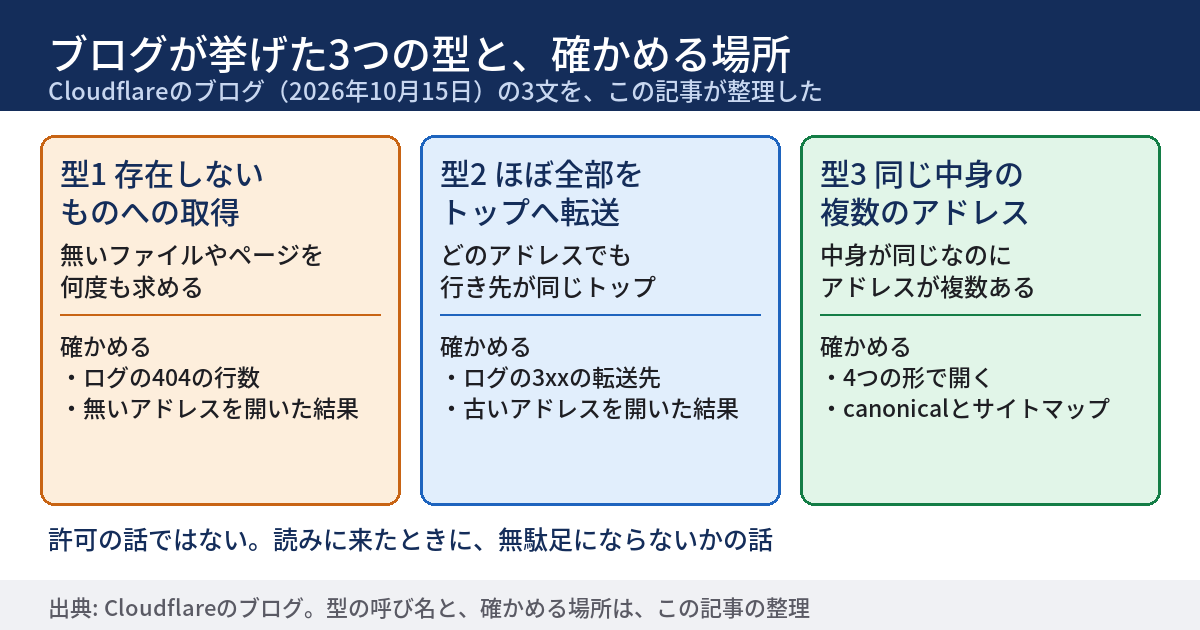
"Bots repeatedly ask for files that aren't there. Some sites redirect almost any address to their homepage. Other addresses lead to copies of the same content."
(訳: ボットは、そこに無いファイルを何度も求める。サイトによっては、ほとんどどのアドレスでも、自分のトップページへ転送する。ほかのアドレスは、同じ内容の写しにつながる。)
3つの型を、この記事では次のように呼ぶ。
- 型1: 存在しないものへの取得 — 無いファイルやページを、何度も求める。
- 型2: ほぼ全部のアドレスをトップへ転送するサイト — どのアドレスでも、行き先が同じトップページになる。
- 型3: 同じ中身を返す複数のアドレス — 中身が同じなのに、アドレスが複数ある。
この3つを見分けることについて、ブログはこう書いている。
"Recognizing these patterns gives us a way to cut wasted work before a crawler fetches the page, and improve efficiency in a way that benefits site owners."
(訳: これらの型を見分けられれば、クローラーがページを取得する前に、無駄な作業を減らせる。サイトの持ち主にも益になる形で、効率を上げられる。)
ページの信号は、アクセスの許可ではない
ブログは、持ち主の選択が全体を通して大事だと断ったうえで、次のように書いている。
"A signal about a page doesn't grant permission to access it. This research uses metadata about the web for search and discovery, rather than sharing page content for model training."
(訳: ページに関する信号は、そのページに入る許可を与えるものではない。この研究が使うのは、検索と発見のためのウェブに関する付随情報であり、モデルの学習のためにページの内容を共有するものではない。)
つまり、ここで問題になっているのは許可ではなく、読みに来たときに無駄足にならないかである。許可の話は、当サイトの記事「Cloudflareが9月15日に加えた「AI学習だけを止める」設定 ── 検索に載せたまま止められる範囲と、今週確かめる6つ」で扱った。
この記事が読んだもの、読めなかったもの
読んだのは、Cloudflareのブログ本文、Googleの検索セントラルの文書6つ、Search Consoleのヘルプ、OpenAIのクローラーの説明、Cloudflareの文書、IETFの文書(RFC 9110)である。すべて2026年10月16日に開いた。引用した英文は、本文を取り直して1文字ずつ照らした。
確かめていないものもある。ブログの「無駄」の判定がどんな信号で行われているか、試験に参加する条件は何かは、ブログに書かれていない。OpenAIの検索がこの3つの型を実際にどう扱うかも、この記事では確かめられない。だからこの記事は「OpenAIの検索がこうする」とは書かない。書くのは、ブログが挙げた3つの型は、自分のサイトの記録と画面で数えられる、ということである。
02 なぜ・背景 — 取得は、サイトにとっての負荷でもあり、無駄は見つけ方にも影響する
取得を増やすことは、みんなの負担になる
ブログは、新しいページを見つけるために、すべてのページをもっと頻繁に取りに行く方法は、誰にとっても高くつくと書いている。
"Keeping up by fetching every page more often would be expensive for everyone. For a website owner, a crawler that repeatedly downloads an unchanged page adds load without bringing any benefit."
(訳: すべてのページをもっと頻繁に取得して追いつこうとすれば、みんなにとって高くつく。サイトの持ち主にとって、変わっていないページを何度もダウンロードするクローラーは、利益を何ももたらさないまま負荷だけを足す。)
読者のサイトにとっても、取得は通信量とサーバーの仕事になる。存在しないアドレスへの取得も、1回ずつ、サーバーが「無い」と答える仕事を生む。
自動のアクセスは、存在しないページを「それらしく」見せる
ブログには、見逃しやすい一文がある。
"We've learned, for example, how easily automated traffic can make a nonexistent page look interesting."
(訳: 例えば、自動のアクセスが、存在しないページをいかに簡単に興味深く見せてしまうかが分かった。)
これを、この記事は次のように読んだ。存在しないアドレスに自動のアクセスが何度も届くと、取得の数だけを見れば、よく求められているページに見える。だから、数だけでは「見る価値のあるページ」を選べない、ということだと思う。細部はブログに書かれていないので、これは読み方の1つであり、ブログの主張そのものではない。
見つけることと、役に立つ答えにすることは別
ブログは、アドレスを見つけるのは始まりにすぎないとも書いている。
"Finding a URL is only the start. We need to know whether it leads to a page someone can access, whether that page offers anything distinct, and what it might help someone do."
(訳: URLを見つけるのは、始まりにすぎない。そのURLが、誰かが入れるページにつながっているか、そのページに他と違うものがあるか、誰かが何をするのに役立ちうるかを、知る必要がある。)
この問いは3つの型に当たると、この記事は整理した。「誰かが入れるページか」は型1と型2に、「他と違うものがあるか」は型3に当たる。これも記事の整理であって、ブログがそう対応づけたわけではない。
03 用語 — 404、ソフト404、正規のアドレス、転送を先にそろえる
404と410
用語
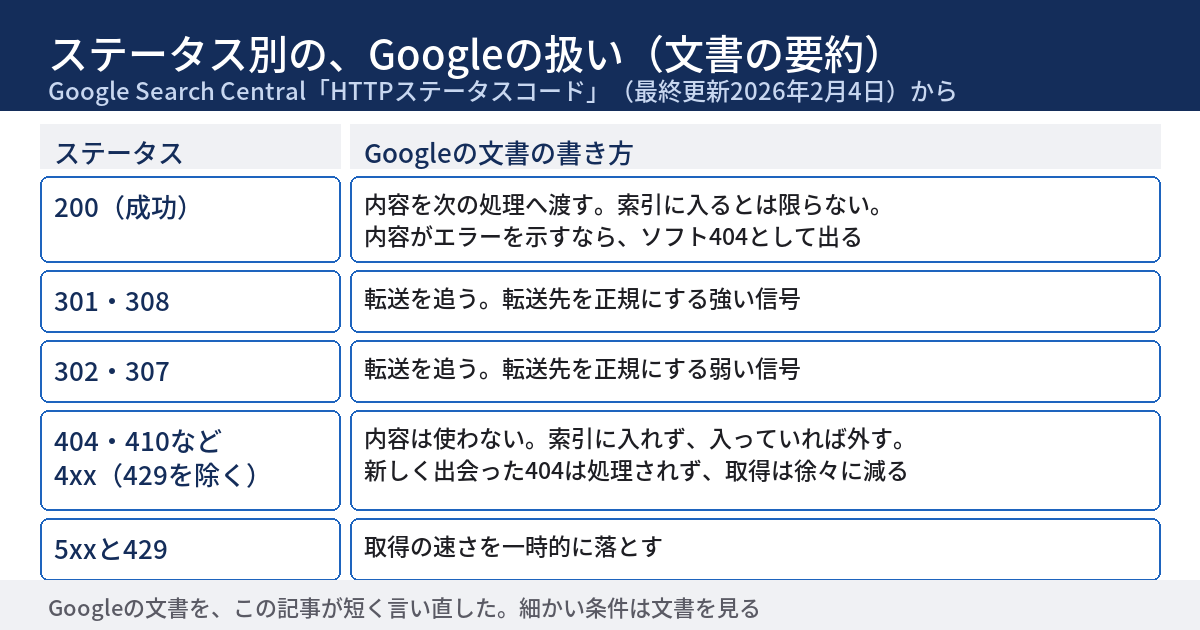
404(Not Found):サーバーが、求められたものを見つけられなかったと答える状態を表す数字である。IETFの文書(RFC 9110)は、404は一時的か永続的かを示さず、永続的だと分かっているなら410(Gone)のほうが望ましい、と書いている。Googleの文書は、429を除く4xxのエラーは、検索の面では同じように扱う(コンテンツが存在しないと次の処理に伝える)と書いている。つまり、検索エンジンにとっては404と410の差は小さく、差が出るのは、人や他の仕組みへの伝え方である。
ソフト404
用語
ソフト404:「見つかりません」という意味の画面を見せているのに、ステータスは404ではなく200(成功)を返している状態である。Search Consoleのヘルプは、これを「ユーザーに親切な『見つかりません』の画面は返すが、404のステータスは返さない」ものとして説明している。画面は人に向けて正しくても、取りに来た仕組みには、そこに内容があるように見える。型1の問題が、見えにくくなる形である。
正規のアドレス(canonical)
用語
正規のアドレス:同じ内容を複数のアドレスで開ける場合に、「このアドレスが本来の姿だ」と示す1つのアドレスである。Googleの文書は、示す方法を、転送、ページの中の指定(rel="canonical")、サイトマップへの記載の3つに分け、強さの順に並べている。型3の確かめは、この3つがそろって同じアドレスを指しているか、を見ることになる。
転送(301と302)
用語
転送:あるアドレスを開いたとき、別のアドレスへ送る仕組みである。301は「恒久的に移った」、302は「一時的に別の場所にある」を意味する。Googleの文書では、301は転送先を正規のアドレスにする強い信号、302は弱い信号と書かれている。型2は、この転送の先が、移った先の同じ内容のページか、無関係なトップページかが問題になる。
04 型別 — 3つの型を、自分のサイトの何に当て、何を、どの順で確かめるか
ブログの3つの型と、自分のサイトで確かめる場所を、先に表にした。
| 型 | 自分のサイトで起きること | Googleの文書の書き方 | 確かめる場所 |
|---|---|---|---|
| 型1 存在しないものへの取得 | 無いはずのアドレスが、ログに何度も残る。画面は「見つかりません」でも、ステータスが200のことがある | 4xxのアドレスは索引に入れない。すでに入っていれば外される。新しく出会った404は処理されず、取得の頻度は徐々に下がる | アクセスログのステータス別の行数、無いアドレスを実際に開いた結果、Search Consoleの「ソフト404」 |
| 型2 トップへの一括転送 | 古いアドレス、削除したアドレス、存在しないアドレスの行き先が、どれもトップページになる | 転送元の内容は無視され、転送先の内容が処理される。301は強い信号、302は弱い信号 | ログの3xxの転送先、旧ドメインや旧アドレスを実際に開いた結果 |
| 型3 同じ中身の複数のアドレス | 末尾のスラッシュ、大文字小文字、パラメータ、httpとhttps、wwwの有無で、同じ中身が複数のアドレスで開く | 転送、rel="canonical"、サイトマップの3つで正規のアドレスを示す。サイト内のリンクも正規のアドレスに向ける | 主要ページを4つの形で開いた結果、canonicalの宛先、サイトマップのアドレス |
型1 — 存在しないものへの取得を数える
最初にするのは、アクセスの記録(ログ)から、ステータスが404の行を数えることである。全体の行数に対する割合と、アドレスの上位を見る。ここで大事なのは、404の行が多いこと自体を、悪い兆候と決めないことだ。これはこの記事の整理で、ブログが「悪い兆候ではない」と書いているわけではない。ブログが書いているのは、ボットが無いファイルを何度も求める、という事実である。見るべきは、404が出ていることではなく、404であるべきものが404を返しているか、そして、自分のサイトの中から無いアドレスへ案内していないか、である。
後者は、ログの参照元の欄で見分けられる。参照元が自分のサイトのページになっている404は、自分のリンクが壊れている可能性が高い。自分のサイト内のリンクをまとめて調べたいときは、当サイトの無料ツール「🔧 WEBサイト内のリンク漏れ・チェックツール」が使える。
型2 — 転送の行き先を並べる
次に、3xxの行を数え、転送元と転送先を並べる。転送先が、移った先の同じ内容のページになっているものは、正しい使い方である。転送先がトップページになっているものが多いなら、型2に当たる。無関係なトップへ送ると、読む人にも取りに来る仕組みにも、行き先の意味が伝わらない。ログに転送先が残らない形式なら、転送元の上位5件を実際に開いて、行き先を目で見る。
型3 — 同じ中身の別のアドレスを、4つの形で開く
3つ目は、主要なページを、4つの形で開いて、ステータスと正規のアドレスの指定を並べることである。4つの形とは、末尾にスラッシュを付けた形、大文字を混ぜた形、パラメータを付けた形、httpの形である。どの形でも、同じ内容が見えて、正規のアドレスの指定が同じ1つのアドレスを指しているなら、重複は1つの形にまとまっている。形によって200のまま別のアドレスを正規としていたり、指定が無かったりするなら、型3が起きている。
Googleの文書は、サイトマップに書くアドレスは、同じ内容に複数のアドレスがあるときは、好みの1つを選んで書き、同じ内容に行き着くアドレスを全部書かないように勧めている。サイトマップ、ページの中の指定、サイト内のリンクの3つが同じアドレスを向いているのが、いちばん強い形である。
この確かめ方が当てはまる範囲と、当てはまらない範囲
この手順は、Cloudflareを使っているかどうかに関係なく使える。自分のサイトのアクセスの記録と、ブラウザやコマンドで開いた結果だけを使うからである。ただし、手前にCDN(配信を代行する仕組み)がある場合は、CDNが答えた分は自分のサーバーのログに残らないことがある。その場合は、CDN側の記録も見る。ログを見られない場合は、項目5から8と11、12のように、実際にアドレスを開く確かめだけでも、型2と型3の様子は分かる。
ブログが測っていないこと
ブログは、無駄な取得が全体の何%なのか、3つの型をどんな基準で判定するのか、判定されると何が起きるのか(索引に入らない、取得の順番が後になる、など)を書いていない。書いているのは、見分けられれば取得の前に無駄を減らせる、ということまでである。
注意
「ブログに書いてあるから、OpenAIの検索は、あなたのサイトの404や転送をこう扱う」とは言えない。ブログが挙げたのは、無駄な取得の例である。この記事の13項目は、どの検索エンジンが相手でも、返す答えが毎回同じで、迷わないかを、自分のサイトで確かめるためのものである。
手順の順番
順番は、ログの数え直し(項目1から4)、無いアドレスと古いアドレスを実際に開く確かめ(項目5から8)、転送の行き先(項目9から11)、同じ中身の別のアドレス(項目12と13)である。ログを先に数えるのは、見に行くアドレスを、想像ではなく記録から選ぶためである。
05 自分のサイトで確認するチェックリスト
下の13項目は、1項目5分ほどでできる作業である。ログを見られない場合は、項目1から4と9、10は「ログが無いので飛ばした」と書いて、先へ進めばよい。チェックの状態はブラウザの中にだけ保存され、サーバーには送られない。
- アクセスログから直近7日分を取り出し、全体の行数と、ステータスが404の行数を書き、404の割合を計算して書く
- 404の行を、アドレス別に数え、多い順に10件を、件数つきで書き出す
- 項目2の10件を、自分のサイトのページの下のアドレス、拡張子つきのファイルの名前、ドットで始まる名前、その他の4つに分け、それぞれの件数を書く
- 404の行のうち、参照元が自分のサイトのページになっているものを数え、上位3組の「参照元と取得先」を書く。参照元がログに無い形式なら「無し」と書く
- 意味のない名前のアドレスを3つ作り、実際に開いて、返ってくるステータスを、404か200か転送かで3つとも書く
- 項目5のうち1つで本文を取り、ページの題、robotsの指定、canonicalの有無を書く
- Search Consoleの「ページのインデックス登録」で、「ソフト404」の件数を書き出し、無ければ0と書く
- 削除した記事やページを3つ選び、それぞれを開いて、返るステータスを、404、410、301のどれかで書く
- ログの3xxの行を数え、転送元の上位5件を、転送先つきで書き出す。転送先がログに無い形式なら、5件を開いて行き先を書く
- 項目9の5件のうち、転送先がトップページのものは何件かを数えて書く
- 旧ドメイン、wwwの有無、httpの形から、アドレスを5つ選び、新しい側の同じ場所に着くか、トップに着くかを、開いて書く
- 主要なページ3つを、末尾のスラッシュ有り、大文字を混ぜた形、パラメータ付き、httpの4つの形で開き、ステータスとcanonicalの宛先を書く
- 項目12の結果と、サイトマップに書いたアドレスの形を並べ、一致する数と、一致しない数を書く
時間が限られているときは、項目1・5・9・12の4つだけでも、3つの型のどれに近いかの見当は付く。
06 代替・他の選択肢 — 見つかった問題を、どの方法で直すか
確かめた結果、直す必要のあるものが見つかったときの選択肢を並べる。どれを選ぶかは、サイトの事情で決まる。
404のまま返す
無いものは404で返すのが、基本の形である。RFC 9110は、404は「求められたものを見つけられなかった」ことを示す、と書いている。画面には「見つかりません」と案内を出しながら、ステータスも404にする。ソフト404になっていたときは、画面はそのままで、ステータスだけを404に直せば解決することが多い。
410で返す
意図して無くしたものは、410(Gone)も選べる。RFC 9110は、410は、サーバーの持ち主がそのものを意図して提供しておらず、他からのリンクを外してほしいと望んでいることを伝えるためのものだと書いている。Googleの文書は検索の面では404と同じに扱うと書いているので、410にしても検索での扱いが変わるとは限らない。変わるのは、意図の伝え方である。
301で、同じ内容の移動先へ寄せる
移動先に同じ内容のページがあるなら、301で送る。Googleの文書は、恒久的な転送では、新しい転送先が検索結果に出ると書いている。一時的な転送では、元のページが出る。送る先が無いなら、無理にトップへ送らず、404か410で返す。型2を作らないための、いちばん単純な方針である。
canonicalとサイトマップで寄せる
転送できないアドレス(パラメータ付きなど)は、ページの中の指定で寄せる。Googleの文書は、転送とページの中の指定を強い信号、サイトマップを弱い信号と書き、この3つは重ねると効果が上がると書いている。同時に、異なる方法で、同じページに別々のアドレスを指定しないことも求めている。
robots.txtで止める — 向かない場面
無駄な取得を、robots.txtで止めたくなることがある。Googleの文書は、robots.txtは主にサイトへの取得の量を管理するためのものだと書いている。一方で、同じ文書は、robots.txtを正規のアドレスを示すための手段として使わないことを求めている。理由として、robots.txtで止めたアドレスは、中身を読まれないまま索引に入ることがある、と書いている。重複を止める目的でrobots.txtを使っても、重複は片づかない。
実務のヒント
CDNやホスティングの仕組みが、検索エンジンの取得を意図せず止めていないかも、時々見る。GoogleのAI機能の文書は、基本の対策の1つとして、robots.txtだけでなくCDNやホスティングの仕組みでも、取得が許されていることを挙げている。404や転送を整えても、手前の仕組みが拒否していれば、読まれない。
07 当サイトで確かめたこと
当サイト(WEBサイトサポート)は、Cloudflareを使っていない。だから、ブログの数字は当サイトのものではない。代わりに、この記事の手順を、2026年10月16日に当サイトで実際に行った。ログは、2026年10月9日から15日までの7日間のHTTPSの記録で、アドレスとステータスだけを数えた。
7日間のアクセスログで、404は0.76%だった
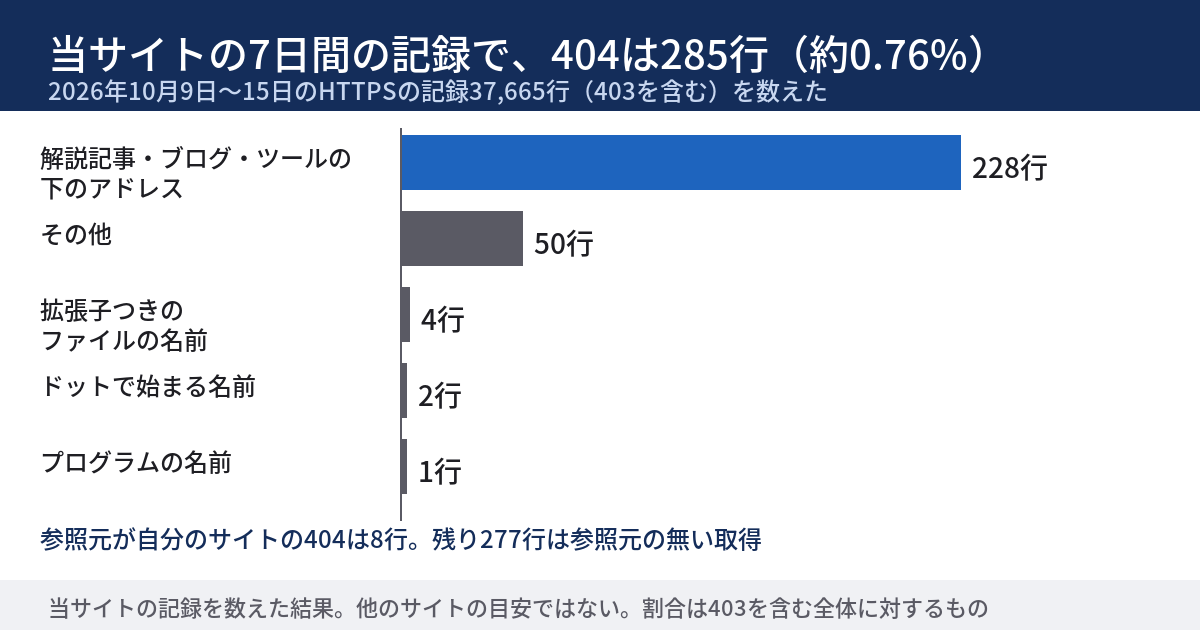
7日間で数えたHTTPSの記録は37,665行だった。ステータス別では、200が27,002行、403が10,160行、404が285行、301が57行、302が19行で、ほかに206・421などが合わせて142行ある。403はアクセスを断った記録で、この記事の対象ではないが、全体の行数37,665には含めている。404は、403を含む全体の約0.76%(285÷37,665)にあたる。403を除いた27,505行に対しては、約1.0%になる。
404の285行を、アドレスの種類で分けると次のようになった。解説記事・ブログ・ツールのどれかの下のアドレスが228行(80%)、拡張子つきのファイルの名前が4行、ドットで始まる名前が2行、拡張子つきのプログラムの名前が1行、残りの50行はその他だった。異なるアドレスは155種類である。ブログが挙げた「そこに無いファイルを何度も求める」型は、当サイトでは、少数だった。
自分のサイトの中から、無いアドレスへ行っていたものが8行あった
404の285行のうち、参照元が自分のサイトのページになっていたものは8行、参照元の無いものが277行だった。8行のうち7行は、ブログの記事ページから、アドレスの末尾が「null」の無いページへ移動したものだった。残りの1行は、ブログのタグのアドレスである。原因はまだ特定していない。記事ページの静的なHTMLと、当サイトのスクリプトの範囲では、「null」を含むリンクを見つけられなかった。見つけたら、この記事に日付つきで書き足す。
無いアドレスは、404を返していた
意味のない名前のアドレスを、5種類(トップの下、解説記事の番号、ブログの番号、ツールの名前、サイトマップの名前)で開いたところ、すべて404で、転送は0回だった。本文には「見つかりませんでした」という趣旨の案内が出ていて(文言は、解説記事・ブログ・ツールで少しずつ違う)、robotsの指定はnoindex,follow、canonicalの指定は無かった。外から取った画面が目当ての画面とは限らないことは、当サイトの記事「外から取った画面は、目当ての画面とは限らない ── 遮断の画面を404と読み、引用符の違いでnoindexを「無い」と読みかけた」で書いたので、今回も、取った画面の本文が、当サイトのエラー画面であることを確かめてから数えた。
| 開いたアドレス | ステータス | robotsの指定 | canonicalの宛先 |
|---|---|---|---|
| 意味のない名前(トップの下) | 404 | noindex,follow | 無し |
| 存在しない解説記事の番号 | 404 | noindex,follow | 無し |
| 存在しないブログの番号 | 404 | noindex,follow | 無し |
| 存在しないツールの名前 | 404 | noindex,follow | 無し |
| 存在しないサイトマップの名前 | 404 | noindex,follow | 無し |
| 解説記事の末尾にスラッシュを付けた形 | 200 | index,follow | スラッシュ無しの形 |
| ツールの名前を大文字で書いた形 | 200 | index,follow | 小文字の形 |
| 解説記事にパラメータを付けた形 | 200 | index,follow | パラメータ無しの形 |
| トップにパラメータを付けた形 | 200 | index,follow | トップ |
型3の「同じ中身を返す複数のアドレス」は、当サイトでも開く(200)。ただし、正規のアドレスの指定は、どれも1つの形に寄っていた。これは2026年10月15日に直したもので、以前は、大文字や末尾にスラッシュを付けた形が、自分自身を正規と指定していた。直したのは指定だけで、301の転送にはしていない。301で寄せるかは、まだ決めていない。
親のドメインは、ほぼ全部をトップへ転送していた
型2と形が同じものも、当サイトの近くにあった。親にあたるドメイン(usersupports.com)は、当サイトのトップへ案内する目的で、意図して転送を設定してある。トップ、意味のない名前、解説記事の番号つきのアドレス、wwwの付いた形の4つを開くと、すべて301で当サイトのトップに着いた。無い名前でも、実在する記事の番号でも、行き先が同じトップになる、ブログが書いた型2と同じ形である。ただし、案内の目的で意図した設定で、取得に無駄が出ているかは確かめていない。
例外はrobots.txtで、転送せず200で返している。2026年10月15日に直したもので、以前は、これも転送していて、Search Consoleが親のドメインのrobots.txtを取得できないと伝えていた。転送そのものを、記事ごとの転送に変えるかは、まだ決めていない。
転送の行き先は、内容の合うページだった
7日間の301は57行で、上位は、削除した解説記事3本(合わせて29行)の統合先への転送と、お問い合わせのアドレスの末尾にスラッシュを付ける正規化だった。削除した記事の行き先は、トップではなく、内容の合う記事である。302の19行は、会員画面からログイン画面への案内が中心だった。
まだ確かめていないこと
確かめていないのは、OpenAIの検索のクローラーが当サイトの404や転送を実際にどう扱っているか、Search Consoleの「ソフト404」の件数、親のドメインのログに残る取得の様子の3つである。HTTPの記録だけを見ると数が大きく外れることは、当サイトの記事「AIは331回来たと書いた。実際は11,024回だった ── HTTPのログだけを52日間 見ていた」で書いたので、今回はHTTPSの記録を数えた。終わったものから、この記事の末尾に日付つきで書き足す。
08 このテーマの、これまで
| 日付 | できごと |
|---|---|
| 2026年2月4日 | Googleの「HTTPステータスコードの扱い」の文書の最終更新 |
| 2026年4月14日 | Googleの「リダイレクト」の文書の最終更新 |
| 2026年7月 | CloudflareとOpenAIの研究の試験が始まった(ブログ) |
| 2026年7月8日 | Googleの「サイトマップの作り方」の文書の最終更新 |
| 2026年7月10日 | Googleの「正規のアドレスの指定」の文書の最終更新 |
| 2026年10月15日 | Cloudflareが、試験の最初の結果を公開した。当サイトでは、大文字や末尾のスラッシュを付けた形の正規の指定と、親のドメインのrobots.txtの転送を直した |
| 2026年10月16日 | この記事の確認の日。当サイトのログと、アドレスの結果を数えた |
この表で、試験の開始時期は、ブログの記述を要約したもので、この記事では確かめていない。
canonicalの見方は当サイトの記事「canonicalタグは『ヒント』であって『命令』ではない ── Search Consoleで、Googleが選んだ正規URLを自分のサイトで確認する15項目(2026年9月時点)」に、同じ内容の別のアドレスの考え方は「公式文書が勧めるURLは、読める言葉・ハイフン区切り・リンク内のパーセントエンコード。キーワードの順位への効果は小さく、変えるかは手間と並べて決める ── 自社のURLの付け方を確認する13項目(2026年10月時点)」にまとめてある。
現在の貴方のIPアドレス
このサイトで書いている人