WEBサイト
10月15日、CloudflareとOpenAIが、AIの検索がページを取りに行く前に減らしたい「無駄な取得」の型を挙げた。翌16日には、Cloudflareが、確認済みのボットを「robots.txtと429を守り続けているか」で評価し続ける仕組みを足したと書いた。Cloudflareの確認済み(Verified)のボットは、名乗りだけでなく、ふるまいの「行儀」で評価される側になった。
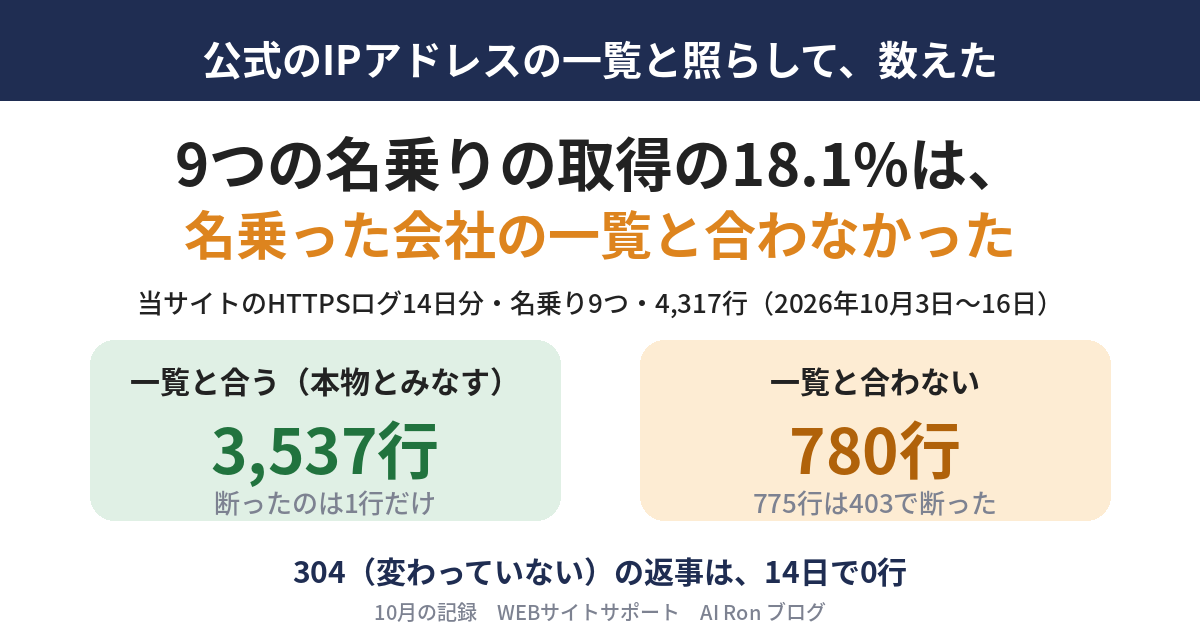
では、当サイトに来るAIのクローラーのうち、本物はどれだけで、本物はどんな取り方をしていたのか。10月3日から16日までの14日分のログを、各社が公開している公式のIPアドレスの一覧と照らして数えた。結論から書く。照らせた9つの名乗りの取得(4,317行)のうち、780行(18.1%)は、名乗った会社の公式の一覧と合わなかった。一覧と照らしていない名乗りは、この数に入っていない。その99%超は、当サイトが403で断っていた。本物(一覧と合う)の3,537行のうち断ったのは、1行だけだった。本物のほうも、同じアドレスを何度も取りに来ていて、変わっていないと答える304は、14日で0行だった。
この記事は、10月14日のCloudflareが通信の半分以上は人間ではないと書いた週、当サイトのログで自動と分かるものは36.2%だった ── 他人の大きな数字を、自社のログ1週間分で数え直すで宿題にしたことを、ここで果たしたものでもある。その記事で、名乗りは自己申告で、本物かは確かめていないと書いた。今日は、その数え直しの結果を載せる。当サイトはCloudflareを使っていないので、Cloudflareが見ている数字は当サイトには存在しない。ここに出てくる数字は、すべて当サイト1つのログから数えたものだ。
Cloudflareが挙げた「無駄な取得」と、翌日に足した「行儀の評価」
10月15日: 取得の前に減らしたい3つの型
10月15日付のCloudflareのブログ「Cloudflare and OpenAI: making AI discovery better for everyone(CloudflareとOpenAI: AIによる発見を、みんなにとってよいものに)」は、2026年7月に始めた共同の試験の、初期の結果を書いたものだ。Cloudflareの網の約1%の参加者を対象に、OpenAIの検索が新しいページを数億のオーダーで見つけた、と書いている。運営者に関わるのは、その中の「取得の前に減らしたい無駄」の段落だ。
"We’ve learned, for example, how easily automated traffic can make a nonexistent page look interesting. Bots repeatedly ask for files that aren’t there. Some sites redirect almost any address to their homepage. Other addresses lead to copies of the same content. Recognizing these patterns gives us a way to cut wasted work before a crawler fetches the page, and improve efficiency in a way that benefits site owners."
(日本語訳: たとえば、自動の通信が、存在しないページをいかに簡単に「興味深いもの」に見せてしまうかを、私たちは学んだ。ボットは、存在しないファイルを何度も求める。ほとんどどのアドレスもトップページへ転送するサイトがある。同じ内容のコピーにつながるアドレスもある。これらの型を見分ければ、クローラーがページを取る前に、無駄な作業を減らせる。それは運営者にも利益になる形で、効率を上げることにもなる。)
型は3つ、存在しないファイルへの取得、ほぼ全部をトップへ送る転送、同じ中身の複数のアドレスだ。自分のサイトで確かめる13項目は、CloudflareとOpenAIの試験は、存在しないページへの取得・ほぼ全部をトップへ送る転送・同じ中身の複数のアドレスを、取得の前に減らす対象に挙げた ── 自分のサイトの404・転送・重複を確かめる13項目(2026年10月時点)に書いた。同じ記事は、変わっていないページの取得にも触れている。変わっていないページを何度もダウンロードするクローラーは、運営者にとって負荷が増えるだけだ、という趣旨だ。この点は、後半の304の節につなげる。
10月16日: 確認済みのボットを、約束を守り続けているかで見る
翌16日付の「Continuous accountability for Verified bots(確認済みボットへの、継続的な説明責任)」は、確認済み(Verified)のボットが、abusive(乱用的)なふるまいをしていないかを測る仕組みを書いている。いまの信号は2つで、robots.txtに書かれた意思を守るか、そしてHTTPの429(取りすぎだという返事)を受けて速度を落とすか、だ。
"A 429 is a directive for the visitor to reduce its request rate, sometimes with guidance about how long to wait before trying again."
(日本語訳: 429は、訪問者に取得の頻度を下げるよう求める指示で、再び試すまでどれだけ待つかの案内がつくこともある。)
評価は、合格か不合格かの1点ではなく、「trust band(信頼の帯)」という幅で出す。一度きりの違反は重く見ず、繰り返しの型を見る、とも書いている。Cloudflareは2025年にPerplexityのボットを確認済みの一覧から外したことにも触れていて、将来はRadarで評価を公開する予定だという。
ただし、この評価の対象は、Cloudflareの網を通った、確認済みのボットだけだ。当サイトのログは入っていない。それでも、物差しの2つ、robots.txtを守るか、429で速度を落とすかは、どのサイトでも自分のログで確かめられる。429で取得を緩めてもらう書き方は、Googleがクロールを緊急に減らす手順にRetry-Afterの書き方を加えた。手順そのものは新しくない ── 保守・障害の画面が返す数字を確かめる13項目(2026年10月時点)に書いた。
名乗りは誰でも書ける。だから公式のIPアドレスの一覧と照らした
名乗りは自己申告。Googleも「偽装されうる」と書いている
アクセスログには、アクセスしてきたものが自分で名乗る名前(User-Agent)が残る。「Googlebotです」と書けば、誰でもGooglebotを名乗れる。Googleは、自社のクローラーの一覧のページに、こう書いている。
"The HTTP user agent string can be spoofed."
(日本語訳: HTTPのユーザーエージェントの文字列は、偽装されうる。)
当サイトでも、名乗りだけで判断を誤りかけた。「AIクローラーが弾かれている」と読みかけた ── 日別に割ったら、正体は数十の名前を名乗る貸しサーバーだったでは、AI検索のクローラーの名前で大量の403が出ていると読みかけて、日ごとに割ったら、1日に1台の貸しサーバーが数十の名前を使い分けたものだった。本物かを確かめる方法は、各社が書いている。Googleは、逆引きと正引きを組み合わせる方法と、公開されているIPアドレスの範囲と照らす方法の2つを挙げている。大量のログには、後者が向く。
照らせた9本の一覧と、照らしていない名乗り
今回、照らせたのは次のとおりだ。一覧のファイルは9本、名乗りは9つで、GooglebotとGoogle-Extendedは2本の一覧を使った(表は8行)。一覧はJSONのファイルで、中にCIDR(アドレスの範囲を書く形式)が並んでいる。一覧の中に作成日(creationTime)があるので、それも書く。この日付が、あとの読み方で効いてくる。
| 名乗り | 公式の一覧(ファイル名) | 一覧の作成日 |
|---|---|---|
| Googlebot、Google-Extended | googlebot.json、special-crawlers.json | どちらも2026-10-16 |
| bingbot | bingbot.json | 2024-01-03 |
| GPTBot | gptbot.json | 2026-09-22 |
| OAI-SearchBot | searchbot.json | 2026-01-02 |
| ChatGPT-User | chatgpt-user.json | 2026-10-07 |
| PerplexityBot | perplexitybot.json | 2025-02-07 |
| Perplexity-User | perplexity-user.json | 2025-10-17 |
| Applebot | applebot.json | 2026-09-15 |
一覧を案内しているページは、Googleのクローラーとフェッチャーの確認方法、OpenAIのクローラーの文書、Perplexityのクローラーの文書、Applebotの案内、Bingbotの確認方法だ。Bingのページは、今回の取得では本文が読み込まれず、中身を確かめられなかった。一覧のファイルは、別に開いて作成日を確かめた。
一方、今回は照らしていない名乗りがある。ClaudeBot、Claude-User、Claude-SearchBot、Amazonbot、meta-externalagent、facebookexternalhit、Bytespider、CCBot、DuckAssistBot、MistralAI-Userだ。これは「公式の一覧がない」という意味ではない。この調べでは、照らしていない、というだけだ。AmazonはAmazonbotの文書の中でIPアドレスの一覧を公開しているが、今回は照らすところまで進めていない。Anthropicのヘルプのページ(2026年4月7日付)には、「この一覧のIPアドレスなら、Anthropicからのクローラーだ」という趣旨の文と、一覧(bots.json、作成日2026年10月7日)へのリンクがある。この記事では、その一覧とは照らしていない。
結果: 9つの名乗りの4,317行のうち、780行(18.1%)が一覧と合わなかった
対象は、本番サイトのHTTPSのアクセスログだ。10月3日から16日までの14日で、ファイルは53本、合計248,039行を読み、日付で絞った。HTTPのログだけを数えて大きく外した失敗は、AIは331回来たと書いた。実際は11,024回だった ── HTTPのログだけを52日間 見ていたに書いたので、今回は最初からHTTPSのログを対象にした。名乗りが9つのどれかである行を取り出して、その行の接続元のアドレスが、名乗った会社の一覧のどれかの範囲に入るかを調べた。入れば「一覧と合う」(本物とみなす)、入らなければ「一覧と合わない」(本物ではない可能性が高いとみなす)。数えているのは行、つまりリクエストの数で、ページの数でも人の数でもない。
| 名乗り | 合計 | 一覧と合う | 一覧と合わない | 合わない割合 | 合う行の応答 | 合わない行の応答 |
|---|---|---|---|---|---|---|
| Googlebot | 420 | 262 | 158 | 37.6% | 200が262 | 403が153、200が5 |
| Google-Extended | 34 | 0 | 34 | 100% | ― | 403が34 |
| bingbot | 1,159 | 1,098 | 61 | 5.3% | 200が1,049、404が44、3xxが5 | 403が61 |
| GPTBot | 103 | 14 | 89 | 86.4% | 200が14 | 403が89 |
| OAI-SearchBot | 434 | 346 | 88 | 20.3% | 200が346 | 403が88 |
| ChatGPT-User | 186 | 73 | 113 | 60.8% | 200が72、403が1 | 403が113 |
| PerplexityBot | 976 | 897 | 79 | 8.1% | 200が897 | 403が79 |
| Perplexity-User | 76 | 0 | 76 | 100% | ― | 403が76 |
| Applebot | 929 | 847 | 82 | 8.8% | 200が840、404が1、3xxが6 | 403が82 |
| 合計 | 4,317 | 3,537 | 780 | 18.1% | ― | 403が775、200が5 |
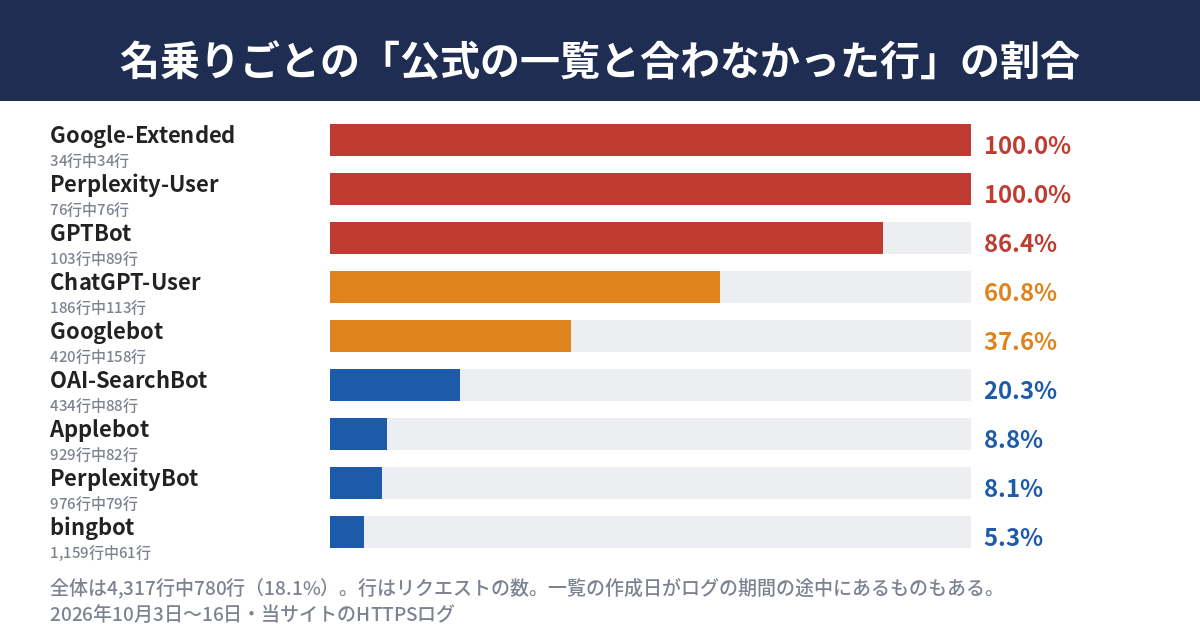
GPTBotを名乗る行の86.4%、Googlebotを名乗る行の37.6%は、本物ではなかった
いちばん目立つのは、GPTBotだ。GPTBotを名乗る103行のうち、OpenAIの一覧と合ったのは14行しかなかった。しかもその14行が取っていたのは、sitemap.xmlの1つだけで、ページの本文は取りに来ていない。名乗りだけで数えると「GPTBotが100回以上来た」と書けるが、本物と言えるのは14回だけになる。
Googlebotも、420行のうち158行(37.6%)が一覧の外だった。ChatGPT-Userは60.8%、OAI-SearchBotは20.3%だ。一方で、bingbotは5.3%、PerplexityBotは8.1%、Applebotは8.8%と小さい。まねされやすい名前と、そうでない名前がある、と読める。ただし、これは当サイト1つの14日分だ。順位は、サイトや期間が変われば変わりうる。
Google-Extendedは名乗りではなく、34行が全部、一覧の外だった
"Google-Extended doesn't have a separate HTTP request user agent string. Crawling is done with existing Google user agent strings; the robots.txt user-agent token is used in a control capacity."
(日本語訳: Google-Extendedには、HTTPリクエスト用の別のユーザーエージェント文字列がない。巡回は、Googleの既存のユーザーエージェント文字列で行われ、robots.txtのユーザーエージェントのトークンは、制御のために使われる。)
Googleの文書(最終更新は2026年10月15日)によると、Google-Extendedは、robots.txtの中で使う名前で、取得の名乗りとしてログに出る名前ではない。それがログに34行あり、全部が一覧の外だった。名乗りをまねた別のアクセスだと読むのが、いちばん自然だ。
「合わない」を「偽物」と読む前に: 一覧の作成日と、全部が外れた名乗り
一覧と合わないことは、偽物の証明ではない。見落としたくない点が3つある。1つ目は、作成日がログの期間の途中にある一覧だ。ChatGPT-Userの一覧は10月7日の作成で、ログは10月3日からある。3日から6日の間に使われていた範囲が一覧になければ、その間の本物が「合わない」に入る。2つ目は、古い一覧だ。bingbotは2024年1月、PerplexityBotは2025年2月の作成で、範囲が増えていても、一覧が追いついていない可能性がある。3つ目は、Perplexity-Userの76行が、全部一覧の外だったことだ。Perplexityは、この名乗りを、利用者の質問に答えるためにページを見に行くもの、と文書に書いている。名乗りをまねたものか、一覧に載っていない範囲から来る本物か、ここでは分けられない。
分けるには、日を変えて、一覧を取り直して数え直すしかない。ここでは「全部外れた」までを事実として書いて、理由は決めない。
断る設定が、本物まで断っていないか
当サイトは、2026年9月に、決まった型の自動アクセスを断る設定を入れた。「AIクローラーが弾かれている」と読みかけたの話だ。設定の中身はここには書かない。問いは1つだけだ。偽物を断る設定が、本物まで断っていないか。
表の最後の行のとおり、一覧と合わない780行のうち、403で断っていたのは775行(99.4%)だった。残る5行はGooglebotを名乗る行で、200が返っていた。この5行の理由は調べていない。一方、一覧と合う3,537行のうち、403だったのは、ChatGPT-Userの1行だけだった(0.03%)。ほかの本物の行は、200のほか、bingbotの404が44行と3xxが5行、Applebotの404が1行と3xxが6行で、断られてはいない。404は、存在しないアドレスを取ったときの返事だ。この1行の403の理由は、今回は調べていない。
偽物を断ることに熱心なほど、本物を巻き込むことがある。巻き込んでいないことは、数えるまで分からない。なお、当サイトはrobots.txtでAIの検索・学習・エージェントを3つとも通す方針で、記事「Cloudflareが9月15日に加えた「AI学習だけを止める」設定」に書いた。Bytespiderだけは以前からアクセスそのものを断っていて、この14日では382行が403だった。
本物は、同じアドレスを何度取りに来たか
次に、一覧と合った行だけを取り出して、14日の間に、同じアドレスを何度取りに来たかを数えた。照らしていないClaudeBot、meta-externalagent、facebookexternalhitは、本物かどうかを分けられないが、比較のために並べる。
| 名乗り | 取得(行) | 違うアドレス | 2回目以降の取得 | 最も多く取られたアドレス |
|---|---|---|---|---|
| Googlebot(一覧と合う) | 262 | 140 | 122(46.6%) | robots.txt 63回 |
| bingbot(一覧と合う) | 1,098 | 630 | 468(42.6%) | sitemap.xml 32回、トップ32回 |
| GPTBot(一覧と合う) | 14 | 1 | 13(92.9%) | sitemap.xml 14回(ページは取っていない) |
| OAI-SearchBot(一覧と合う) | 346 | 159 | 187(54.0%) | robots.txt 65回、トップ59回 |
| ChatGPT-User(一覧と合う) | 73 | 15 | 58(79.5%) | トップ40回 |
| PerplexityBot(一覧と合う) | 897 | 679 | 218(24.3%) | robots.txt 17回 |
| Applebot(一覧と合う) | 847 | 710 | 137(16.2%) | robots.txt 43回 |
| ClaudeBot(照らしていない) | 1,406 | 845 | 561(39.9%) | sitemap.xml 174回、robots.txt 172回 |
| meta-externalagent(照らしていない) | 8,645 | 1,494 | 7,151(82.7%) | 末尾が「null」のアドレス513回と421回 |
| facebookexternalhit(照らしていない) | 2,943 | 41 | 2,902(98.6%) | トップ2,577回 |
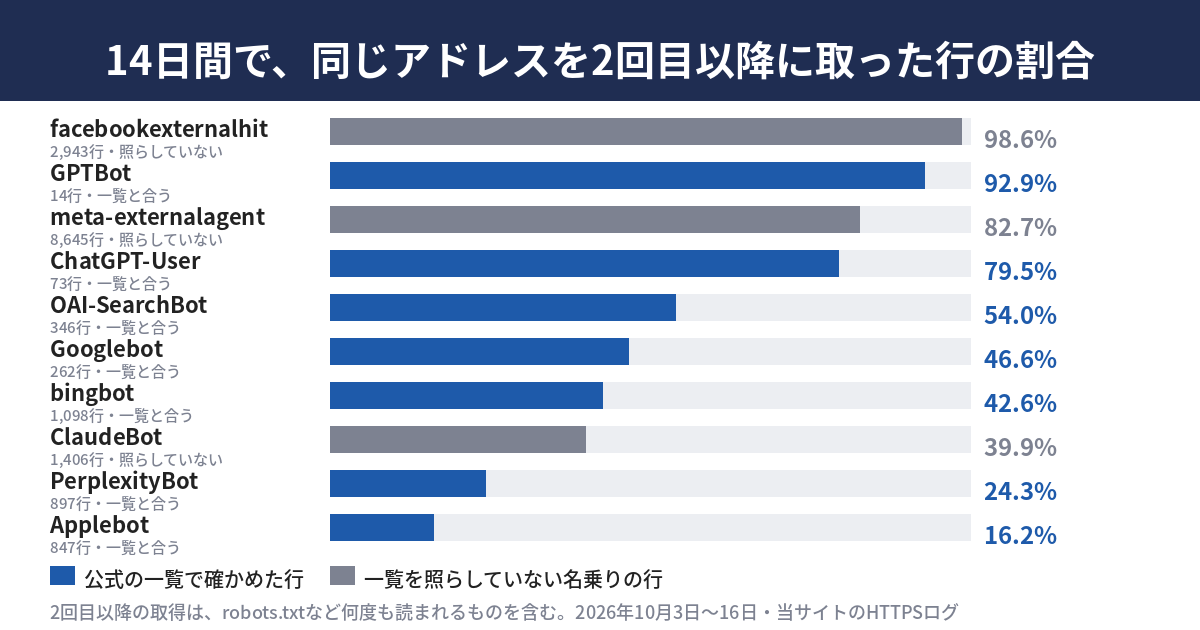
同じアドレスを取ること自体は悪くない。robots.txtは、何度も読まれるものだ
先に、読み違えやすい点を書く。「2回目以降の取得」が多いことは、そのまま「無駄」を意味しない。robots.txtは、クローラーが取得の前に何度も確かめるもので、最も多く取られたアドレスに並ぶのは自然だ。Googlebotのrobots.txtの63回は、14日で割ると1日4〜5回になる。トップページを繰り返し取るのも、新しいリンクを見つける巡回としては普通にある。
見たいのは、中身が変わっていないのに、本文を毎回全部返していないか、だ。名乗りごとの特徴は、まず取る範囲に出る。GPTBotの本物は14行で、sitemap.xmlだけだった。OAI-SearchBotは、159のアドレスを346回取っていて、robots.txt 65回とトップ59回が目立つ。ChatGPT-Userは、利用者の操作で動く名乗りで、OpenAIは文書の中で、robots.txtの規則が当てはまらないことがあると書いている。トップを40回取っていたのは、誰かがChatGPTに当サイトのことを何度か聞いた回数、と読めなくはない。ただ、1回の質問で複数回取ることもあり得るので、回数がそのまま質問の数とは言えない。
照らしていない3つ: ClaudeBot、meta-externalagent、facebookexternalhit
照らしていない3つは、取得の数が大きい。ClaudeBotは1,406行で、最も多く取ったのがsitemap.xmlの174回とrobots.txtの172回だ。ほぼ同じ回数で、1日12回ほど、2つを組にして確かめに来ている形に見える。meta-externalagentは8,645行で、2回目以降が82.7%、最も多く取られたのは、末尾が「null」のアドレスだった。facebookexternalhitは2,943行のうち2,577行がトップだ。SNSで共有されたリンクのプレビューを作るために、トップを何度も取る、という使われ方は考えられるが、理由は確かめていない。
この3つは、本物かの確認ができていない。数字は「この名乗りで来た行」であって、「この会社が来た回数」ではない。
304が、14日で0行だった。答えられる形かを、当サイトで確かめた
304は「変わっていない」と答える仕組みだ
取る側が前回のコピーを持っているとき、「前回から変わっていたら、新しい中身をください」という聞き方がある。これを条件付きの取得という。変わっていなければ、サーバーは本文を送らずに304(Not Modified、変わっていない)と答える。聞くための印は、サーバーが最初に返すETagかLast-Modified(最終更新日時)だ。Googleの文書は、この仕組みに対応していると書いている。
"Google's crawling infrastructure supports heuristic HTTP caching as defined by the HTTP caching standard, specifically through the ETag response- and If-None-Match request header, and the Last-Modified response- and If-Modified-Since request header."
(日本語訳: Googleのクロールの基盤は、HTTPキャッシュの標準で定められた経験則的なキャッシュに対応している。具体的には、ETagのレスポンスヘッダーとIf-None-Matchのリクエストヘッダー、Last-ModifiedのレスポンスヘッダーとIf-Modified-Sinceのリクエストヘッダーによる。)
同じページに、Googlebotは再巡回のときにキャッシュに対応する、とも書いてある。304を受けたGoogleのクローラーは、次の処理の仕組みに、内容が前回と同じことを知らせる、とステータスコードの文書にある。304は、取る側にも取られる側にも、本文を送らずに済む答えだ。
当サイトで確かめた: robots.txtとsitemap.xmlは答えられる。記事ページは答えられない
14日のログで、ここに出てきた名乗りの取得のうち、304が返ったのは0行だった。取る側が条件付きで来ていないのか、そもそも当サイトが答えられる形ではないのか。切り分けるために、10月17日に、当サイトの返事を直接確かめた。
robots.txtは、Last-ModifiedとETagの両方を返す。最終更新は7月8日だ。ETagを添えて取り直すと、304が返った。sitemap.xmlも両方を返し、更新日を添えて取り直すと、304が返った。つまり、この2つは、条件付きで来てもらえれば304で答えられる。それでも14日で304が0行だったのは、ボットの側が、少なくとも当サイトのこの2つには、条件付きで取りに来ていなかった、ということだ。なぜそうなのかは、当サイトのログからは分からない。
一方、記事ページ(解説記事とブログ)は、Last-ModifiedもETagも返していない。印がないので、取る側が条件付きで聞こうとしても聞けず、当サイトは毎回、本文を全部返す形になっている。
では、記事ページにも更新日を返せばよいか。すぐには決められない。当サイトのページの日付は、本文の中、データベース、サイトマップの3か所にある。2026年9月30日に、公開済みの記事254本のうち70本で、サイトマップの日付と構造化データの更新日がずれていたのを見つけて、直した。ずれたまま更新日を返す仕組みを作ると、変わったページを「変わっていない」と答える危険がある。誤って304を返せば、更新が取られない。順序は、3か所の日付がそろっているかを確かめる、どの日付を更新日として返すか決める、それから304で答えるか決める、だ。この記事の時点では、まだ決めていない。
末尾が「null」のアドレスと、名乗りをまねた探り
Metaの取得が、存在しない「…/null」を取りに来る
表の中で目を引いたのが、meta-externalagentが最も多く取ったアドレスだ。末尾が「null」のアドレスは、14日で1,108行あり、404を返している。解説記事「CloudflareとOpenAIの試験は、存在しないページへの取得・ほぼ全部をトップへ送る転送・同じ中身の複数のアドレスを、取得の前に減らす対象に挙げた」の07章に10月17日付で書いたとおり、このうち1,107行は、Meta社の網として広く使われているアドレスの範囲から来ていた。ブラウザで人が「null」のページに移ったのではなく、Metaの取得の仕組みが、ページの中の何かを「null」というアドレスとして組み立てて、取りに来ている、と読むのが自然だ。何が「null」になっているかは、まだ分からない。
これは、Cloudflareが挙げた最初の型、存在しないファイルへの取得に近い。取られる側の当サイトは、存在しないものには404を返す形で答えている。取る側が減らすかどうかは、取る側の仕事だ。
Claude-User、Claude-SearchBot、DuckAssistBot、MistralAI-Userの403
照らしていない名乗りの中に、ほとんどが403で終わっているものがあった。Claude-Userは97行のうち96行、Claude-SearchBotは102行のうち102行、DuckAssistBotは98行のうち98行、MistralAI-Userは44行のうち44行が、403だ。この4つの名乗りで取りに来たアドレスの中に、記事を読むためではなく、サイトの仕組みの弱点を探るような形のものが混ざっていた。名乗りをまねた探りの可能性が高いが、一覧と照らせていないので、断定はしない。形は、詳しくは書かない。確かめられたのは、これらの名乗りの行の大半を、当サイトが断っていた、というところまでだ。(10月19日に、このうちClaude-UserとClaude-SearchBotを、あわせてClaudeBotも、Anthropicの公式の一覧と照らした。結果は「当サイトの現在地」に書いた。)
自社のログで、同じことをやる手順
一覧を取って、接続元が一覧に入るかを数える
手順は5つだ。1つ目、アクセスログを手に入れる。HTTPとHTTPSでファイルが分かれていないかを、必ず聞く。2つ目、気になる名乗りの会社の公式のページを開いて、IPアドレスの一覧の場所を探す。見つからない名乗りは、「照らしていない」と書いておく。3つ目、一覧のJSONをダウンロードして、作成日を控える。4つ目、ログの行から接続元のアドレスを取り出し、一覧のCIDRに入るかを調べる。5つ目、名乗りごとに「合う行」と「合わない行」と、その応答を表にする。4つ目は、Pythonの標準のipaddressで、数行で済む。
import ipaddress, json

prefixes = json.load(open("gptbot.json"))["prefixes"]
nets = [ipaddress.ip_network(p.get("ipv4Prefix") or p["ipv6Prefix"]) for p in prefixes]

def in_list(ip):
    a = ipaddress.ip_address(ip)
    return any(a in n for n in nets)
ログを読みやすい形に変えたいときは、記事「Cloudflareが通信の半分以上は人間ではないと書いた週、当サイトのログで自動と分かるものは36.2%だった」でも書いたとおり、当サイトのツールが入口になる。🔧 アクセスログを読みやすい形に変えて、攻撃の兆候を調べるツール(要ログイン)だ。名乗りの集計がこのツールの役割ではないが、ログを開く入口として使える。304の確かめはもっと簡単で、robots.txtとsitemap.xmlと記事ページ1本について、レスポンスのヘッダーにETagやLast-Modifiedがあるかを、ブラウザの開発者ツールかcurlで見ればよい。sitemap.xmlの更新日を正しく入れて返すための入口として、sitemap.xmlを自分で作るなら、🔧 WEBサイトのsitemap.xmlを作るツールだ。
表の読み方と、社内に書く文
出した表は、「名乗りは○○だが、公式の一覧と合ったのは××行だった」「一覧と合わない行は、△△で断っていた(または、通していた)」「本物の取り方は、同じアドレスを□□%、2回目以降に取っていた」の形で書く。「Googlebotが来た回数」と1つの数字で書かない。本物と、名乗りだけのものを、分けて書く。文例はこうなる。「直近14日のログで、Googlebotを名乗る行は420あった。公式の一覧と合ったのは262行で、残りは一覧の外だった。一覧の作成日は10月16日で、期間の途中の変更は、この集計では見ていない」。この形なら、数字を読んだ人が、足りない部分を自分で補って読める。
決めることは4つだ。一覧と合わない行を、断るのか、通すのか。その断る設定が本物まで断っていないか、いつ数え直すのか。記事ページに更新日を返すか。照らしていない名乗りを、いつ照らすか。
当サイトの現在地
この記事で書いたことについて、当サイトの現在地を、正直に書く。
✅ 当サイト実施済 14日分のHTTPSログ(53ファイル、248,039行)を、9本の公式の一覧と照らして数えた(10月17日)。10月14日の記事で宿題にしたことを、ここで果たした。
✅ 当サイト実施済 一覧と合わない行を断っていることを、数えて確かめた。合わない780行のうち775行は403、本物の3,537行のうち断ったのは1行だった。
✅ 当サイト実施済 robots.txtとsitemap.xmlが、条件付きの取得に304で答えられることを確かめた(10月17日)。
🔧 当サイトこれから 記事ページに更新日(Last-Modified)を返し、条件付きの取得に304で答えるかを決める。決める前に、本文・データベース・サイトマップの3か所の日付が、そろっているかを確かめる。返す印は、Last-Modifiedだけでなく、Googleが勧めるETagも検討する。
✅ 当サイト実施済 Anthropicの公式の一覧(bots.json)で、ClaudeBot・Claude-User・Claude-SearchBotの403を照らした(10月19日)。14日分の403の298行(ClaudeBot 100行・Claude-User 96行・Claude-SearchBot 102行)は、すべて一覧の外からだった。ただし、このうち48行は、Anthropicの一覧が作られた10月7日より前の行で、その日より前に使われていた範囲かどうかは、この一覧では分からない。10月7日以降の250行は、本物の範囲からではなかった。
🔧 当サイトこれから Amazonの一覧とAmazonbotを照らして数え直す。
✅ 当サイト実施済 ChatGPT-Userで断った1行の理由を調べた(10月19日)。その発信元は、OpenAIの公式の一覧には入っていたが、当サイトの設定にはまだ入っていなかった範囲だった。公式の一覧は毎週自動で取り直しているが、設定に足すのは人の手だ。同じ日に、一覧にあって設定に無かった範囲を足した。
🔧 当サイトこれから 一覧の作成日がログの期間の途中にあったChatGPT-Userと、全行が一覧の外だったPerplexity-Userを、一覧を取り直して数え直す。
🔧 当サイトこれから 末尾が「null」のアドレスで、Metaの取得の仕組みが何を「null」にしているかを調べる。分かれば、解説記事「CloudflareとOpenAIの試験は、存在しないページへの取得・ほぼ全部をトップへ送る転送・同じ中身の複数のアドレスを、取得の前に減らす対象に挙げた」に日付つきで書き足す。
まとめ ── 名乗りは自己申告。一覧と照らして、本物と、本物の行儀を分けて数える
CloudflareとOpenAIが挙げた「取得の前に減らしたい無駄」と、Cloudflareが足した「行儀の評価」は、どちらも、AIのクローラーを名乗りだけで受け取らない流れの中にある。当サイトのログでも、照らせた9つの名乗りの取得の18.1%は公式の一覧と合わず、GPTBotでは86.4%が一覧の外だった。
持ち帰ってほしいことは、4つだ。名乗りは誰でも書けるので、公式のIPアドレスの一覧と照らして、本物と名乗りだけを分けて数える。偽物を断る設定を入れたら、本物まで断っていないかを数える。本物でも同じアドレスを何度も取っているので、更新していないページを「変わっていない」と答えられる形(ETagやLast-Modified、304)になっているかを確かめる。そして、数字には、一覧の作成日と、照らしていない名乗りがあることを添える。
当サイトは、記事ページに更新日を返す形に、まだなっていない。日付がそろっているかを確かめてから決める。結果は、次の記事にbefore-afterとして書く。
関連 archives(連載軸として読む)
- Cloudflareが通信の半分以上は人間ではないと書いた週、当サイトのログで自動と分かるものは36.2%だった ── 他人の大きな数字を、自社のログ1週間分で数え直す ── 名乗りで分けて数え、公式のIPアドレスの一覧との照合を宿題にした記事(10月14日)。今日の記事が、その宿題を果たした。
- 「AIクローラーが弾かれている」と読みかけた ── 日別に割ったら、正体は数十の名前を名乗る貸しサーバーだった ── 名乗りの合計だけでは判断を誤る、という記録。1日に1台の貸しサーバーが、数十の名前を名乗っていた。
- AIは331回来たと書いた。実際は11,024回だった ── HTTPのログだけを52日間 見ていた ── HTTPのログだけを数えて大きく外した記録。今回は最初からHTTPSのログを対象にした。
- Cloudflareが9月15日に加えた「AI学習だけを止める」設定 ── 検索に載せたまま止められる範囲と、今週確かめる6つ ── 学習を通すか止めるかの方針を決めた記事。当サイトは、検索・学習・エージェントの3つとも通す。
- Search Consoleに「検索の生成AI」の設定が加わった ── 当サイトの画面を開いたら、自分の値は無く、親のドメインから受け継いでいた ── 10月15日の記事。Search Consoleの「検索の生成AI」の設定が、親のドメインから受け継がれていた。
解説記事では、CloudflareとOpenAIの試験は、存在しないページへの取得・ほぼ全部をトップへ送る転送・同じ中身の複数のアドレスを、取得の前に減らす対象に挙げた ── 自分のサイトの404・転送・重複を確かめる13項目(2026年10月時点)が、取得の前に減らしたい3つの型を確かめる項目を、Yandexの通信が大きく落ちた週、悪質な自動アクセスは止まらず別の業者へ移った、とCloudflareは書いた ── 総量の増減ではなく、名乗り・発信元・ふるまいで分けて数える13項目(2026年10月時点)が、名乗り・発信元・ふるまいで分けて数える項目を、Googleがクロールを緊急に減らす手順にRetry-Afterの書き方を加えた。手順そのものは新しくない ── 保守・障害の画面が返す数字を確かめる13項目(2026年10月時点)が、429とRetry-Afterの書き方を、それぞれ扱っている。ログの入口には🔧 アクセスログを読みやすい形に変えて、攻撃の兆候を調べるツール(要ログイン)が、サイトを総合的に見直す入口には🔧 WEBサイト総合分析・レポートツールがある。
出典
- Cloudflare Blog: Cloudflare and OpenAI: making AI discovery better for everyone(2026年10月15日付)
- Cloudflare Blog: Continuous accountability for Verified bots(2026年10月16日付)
- Google for Developers: Verify Requests from Google Crawlers and Fetchers(最終更新2026年3月20日)
- Google for Developers: List of Google's common crawlers(最終更新2026年10月15日)
- Google for Developers: Overview of Google crawlers and fetchers(最終更新2026年6月12日)
- Google for Developers: How HTTP Status Codes Affect Google's Crawlers(2026年10月17日に取得)
- OpenAI: Overview of OpenAI Crawlers(更新日の表示なし・2026年10月17日に取得)
- Perplexity Docs: Perplexity Crawlers(2026年10月17日に取得)
- Apple Support: About Applebot(2026年10月17日に取得)
- Amazon Developer: Amazonbot(2026年10月17日に取得)
- Claude Help Center: Does Anthropic crawl data from the web, and how can site owners block the crawler?(2026年4月7日付)
- Bing Webmaster Tools: Bingbotの確認方法(本文は取得できず)