 WEBサイト
Googleは、robots.txtでAI学習を断る共通の書き方(__usage_ai-training)に2027年の初めに対応する予定で、仕様はまだドラフト ── 担当サイトのrobots.txtでAI学習に触れる行を数えて確かめる13項目(2026年11月時点)
Googleは、robots.txtでAI学習を断る共通の書き方(__usage_ai-training)に2027年の初めに対応する予定で、仕様はまだドラフト ── 担当サイトのrobots.txtでAI学習に触れる行を数えて確かめる13項目(2026年11月時点)
目次
- 01 何が書いてあるか — Googleは10月30日、robots.txtでAI学習を断る共通の書き方に、2027年に対応する計画を発表した
- 02 なぜ・背景 — 会社ごとの行を、目的ごとの1行にまとめたい
- 03 用語 — 出てくる言葉を、先にそろえる
- 04 型別 — 対象、確かめられないこと、確かめる手順
- 05 明日、担当サイトで確認できることチェックリスト
- 06 代替・他の選択肢 — 学習への希望を伝える方法を、並べて比べる
- 07 当サイトで確かめたこと — 学習は通す方針で、robots.txtにAIの名乗りの行は0本
- 08 このテーマは、ここまで — AIの学習と取得を、どう扱ってきたか
- 09 この記事のまとめ
01 何が書いてあるか — Googleは10月30日、robots.txtでAI学習を断る共通の書き方に、2027年に対応する計画を発表した
引用について
この記事は、Googleが2026年10月30日に公開したブログ記事「Supporting a shared AI training control for websites」と、同じ日に更新されたGoogleのクローラーの文書、その記事がリンクしているIETFのインターネットドラフトを、2026年11月2日に開いて確かめた内容を書いている。英文を引くときは、原文のまま引いて日本語訳を添える。それ以外は、記事の筆者が日本語に直した要旨で書く。原文に書かれていない筆者の読みと案は、「筆者の読み」「筆者の案」と書いて分ける。原文にはチェックリストがない。05章の13項目は、筆者が整理したものである。
2026年10月30日、Googleは、robots.txtの中でAIの学習を断る意思を、複数のAI事業者に向けて一度に示せる「共通のAI学習コントロール」に対応する計画を発表した。担当サイトを預かるWEBディレクターが先に押さえておきたいのは、これは予告であって、今日からrobots.txtに何かを書き足す話ではないという点だ。Googleの記事は、対応の時期を2027年と書いている。この記事では、予告の中身と、読み違えやすい点を整理し、担当サイトのrobots.txtにAI学習に触れる行がいくつあるかを数える13項目にまとめる。
Googleの記事が書いていること
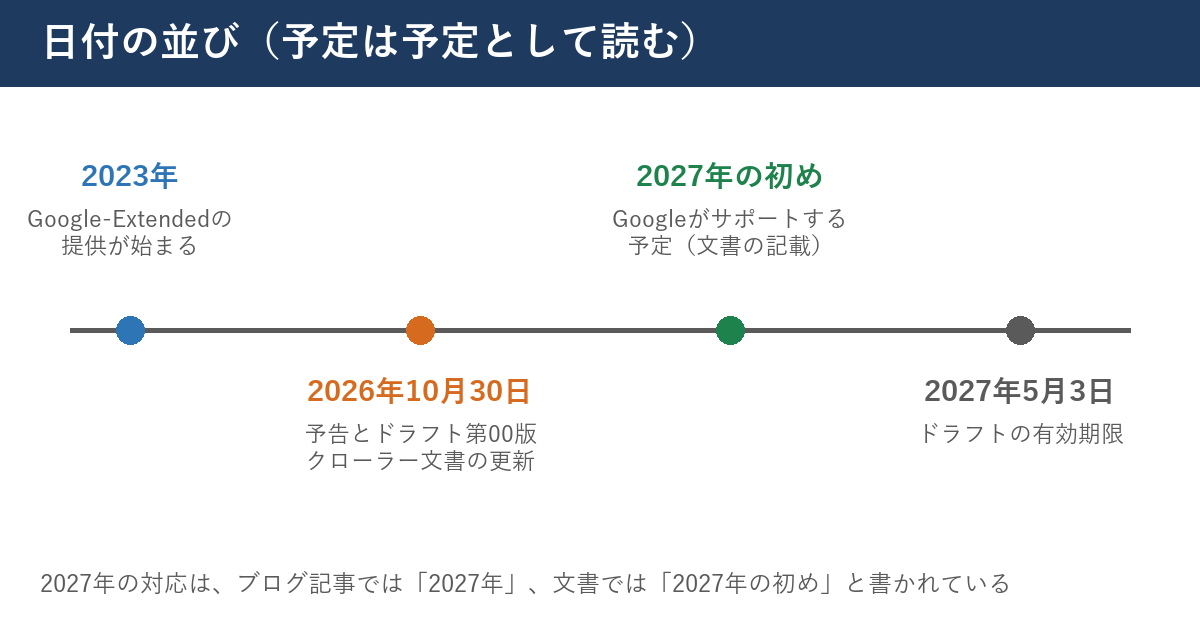
Googleの記事は、John Mueller(Google Search Advocate)の名前で、2026年10月30日(金)に出た。冒頭の要旨は次のとおりである。robots.txtで使う「共有のAI学習コントロール」をサポートする計画を発表した。複数のAI事業者に向けた好みを1回で示せる。作業のもとは、IETF(インターネットの技術の標準を決める団体)のAIPREF作業部会の仕事である。Googleは、2023年から提供してきたAI学習のコントロールであるGoogle-Extendedの上に、これを積むと書く。
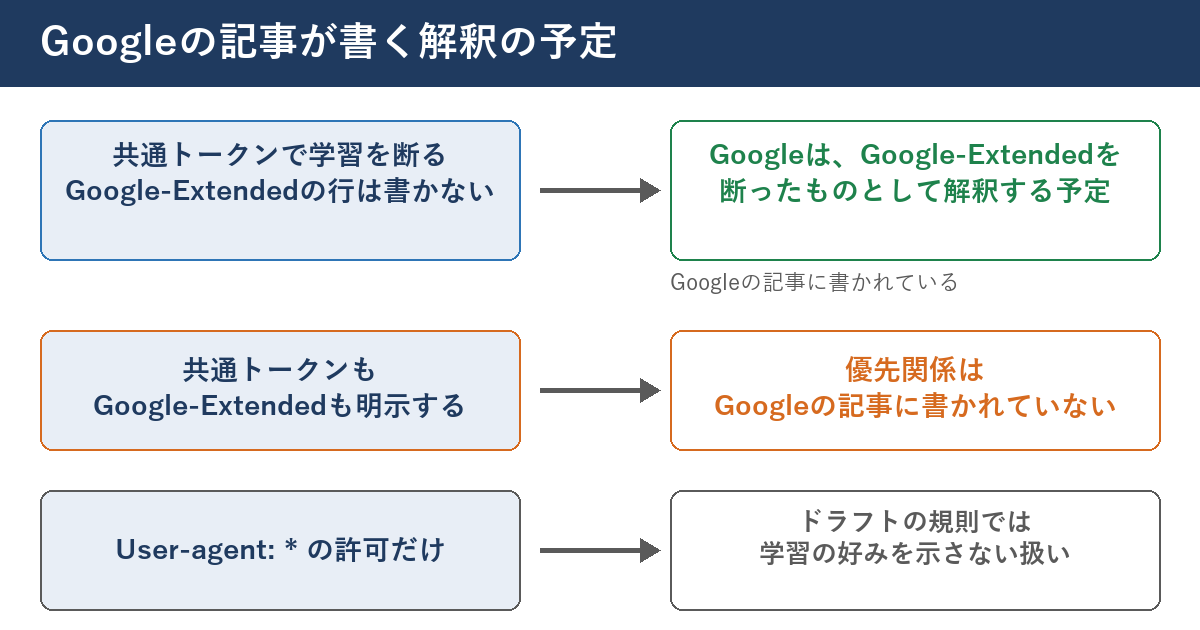
仕組みは、robots.txtの中に共有の「ポリシートークン」を置く形だと書かれている。ポリシートークンとは、特定の会社のクローラーの名前ではなく、「AI学習に使うかどうか」という目的に付けた名札のことである。記事は、サイトがこのトークンでAI学習を断り、しかもGoogle-Extendedが明示されていないときは、Googleは「Google-Extendedをdisallowした」ものとして解釈する計画だと書く。ほかのAI事業者も同じように扱えるので、すべての事業者に対して断ることも、事業者ごとに選ぶこともしやすくなる、という説明が続く。
既存のコントロールは残り、許可した場合の扱いにも一文ある
記事は、会社ごとの既存のコントロールは、新しい共通の信号と並んで引き続き働くと書く。そのうえで、次の一文を置いている。
"Websites that specifically allow Google-Extended are eligible to appear in responses and receive clicks via grounding in Gemini Apps."
(日本語訳: Google-Extendedを明示的に許可しているサイトは、Geminiアプリでの根拠づけ(グラウンディング)を通じて、回答に表示され、クリックを受ける対象になりうる。)
この文は、断る側の話ではなく、許可を明示した側に起こりうることを書いている。この一文は、明示的に許可したサイトについてだけ書いていて、許可を書かなかったサイトをどう扱うかは書いていない。当サイトの方針と、この一文の関係は07章で触れる。
Googleの文書に載った、トークンの綴り
ブログ記事には、トークンの具体的な綴りが書かれていない。ところが、同じ日(最終更新2026年10月30日UTC)に更新されたGoogleのクローラーの文書のGoogle-Extendedの欄の末尾に、注記がある。最終更新日が同じ日なので、この注記はその更新で足されたと読めるが、足された日そのものは文書には書かれていない。
"Note: Google intends to support the AIPREF shared machine-readable training preference signal (with "user-agent: __usage_ai-training") in early 2027."
(日本語訳: 注記: Googleは、AIPREFの共有の機械可読な学習の好みの信号("user-agent: __usage_ai-training"を使うもの)を、2027年の初めにサポートするつもりである。)
ここで、綴りと時期が文書に出た。時期は、ブログ記事が「2027年」、クローラーの文書が「2027年の初め」と書いている。どちらも「つもり」「計画」という言い方で、確約の日付ではない。
記事がリンクしているドラフトの中身
Googleの記事は、「a shared AI training control」という文字に、draft-kelley-aipref-training-preference-signal-00というドラフトへのリンクを付けている。このドラフトのデータトラッカーの表示は、個人名義のインターネットドラフト(著者Kevin Kelley、所属欄はAnthropic)で、2026年10月30日付、有効期限が2027年5月3日の第00版である。同じページに、次の注意が書かれている。
"This I-D is not endorsed by the IETF and has no formal standing in the IETF standards process."
(日本語訳: このインターネットドラフトはIETFが承認したものではなく、IETFの標準化の過程で正式な地位を持たない。)
中身はごく短い。要旨は、robots.txtの普通のグループを使い、User-Agentの行に目的ごとのポリシートークンを書いて、パスごとに好みを結びつける、というものだ。新しい命令の名前も、新しい文法も作らない。ドラフトの第1節の例は、次のとおりである。
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/ドラフトはこの例を、「/press-kit/の下を除くすべてのパスで、AI学習に反対する好みを示し、/press-kit/の下では賛成する好みを示す」と説明する。主な規則は3つある。1つ目、「User-Agent: *」のグループは、このトークンに一致するものとして読んではならない。2つ目、このトークンを含むグループが1つもなければ、好みは示されていないことになる。3つ目、トークンはクロールの命令ではなく、クローラーの規則とは別に読まれる。
| 資料 | 書いていること | 書いていないこと・注意 |
|---|---|---|
| Googleのブログ記事(2026年10月30日) | 共有のポリシートークンに対応する計画。2027年に他の事業者とともにサポートを目指す | トークンの綴りは本文に書かれていない |
| Googleのクローラーの文書(最終更新10月30日) | 綴りは__usage_ai-training。2027年の初めにサポートするつもり | 「つもり」であり、確約の日付ではない |
| draft-kelleyの第00版 | トークンの定義と、グループの読み方の規則 | 個人名義。IETFは承認しておらず、有効期限は2027年5月3日 |
| AIPREFの用語集のドラフト(第08版) | AI学習の定義など、好みを表す語彙 | 冒頭に「作業部会の合意を反映しない」と書かれた作業文書 |
02 なぜ・背景 — 会社ごとの行を、目的ごとの1行にまとめたい
これまでのやり方は、会社ごとに行を書く形だった
AI学習を断りたいサイトは、これまで、事業者の名前(クローラーの名乗り)ごとにrobots.txtへ行を書いてきた。GoogleならGoogle-Extended、ほかの事業者なら、それぞれの文書が決めた名乗りである。事業者が増えれば行が増え、新しい名乗りが出るたびに書き足す作業が生まれる。当サイトのブログ記事「Cloudflareが9月15日に加えた「AI学習だけを止める」設定 ── 検索に載せたまま止められる範囲と、今週確かめる6つ」は、2026年10月4日時点の主な事業者の名乗りを、各社の公式文書から整理している。名乗りの一覧は、増えたり変わったりする性質がある。
共通の1行は、その手間を減らす試みである
共通のポリシートークンは、「事業者の名前」ではなく「AI学習に使うかどうか」という目的に名札を付ける。サイトが1つのグループを書けば、そのトークンを読む事業者がまとめて受け取れる。Googleの記事は、ここに、IETFで進んでいる「AI学習の定義」を使えることの利点を挙げる。用語集のドラフトの定義(別のドラフトによる引用)によれば、AI学習とは、生成AIモデルが学習で身につけた設定値(パラメータ)を変えるために、素材を使うことである。生成をしないモデル、たとえば分類や順位付けや採点だけに使うモデルの学習は、この定義に含まれない、という趣旨である。
EUの行動規範との関係
Googleの記事は、この提案が、EUのAI法に基づく汎用AIモデルの提供者向けの行動規範と整合する、とも書く。その行動規範は、ウェブの公開者が機械可読な好みを示す主な方法として、robots.txtを認めているという。記事が書いているのは「整合する」までで、法的な義務や、サイトが何かをしなければならない、とは書いていない。
「ドラフトの提案」であることを忘れない
Googleの記事自身が、これを「draft proposal」(ドラフトの提案)と呼んでいる。リンク先のドラフトは個人名義の第00版で、用語集のドラフトも「作業部会の合意を反映しない」と冒頭に書いた作業文書である。標準になる前に、綴りや規則が変わる可能性が残る、というのが筆者の読みである。確かな点は、Googleが現時点の綴りを自社の文書に書き、2027年の初めのサポートを「つもり」として示した、というところまでだ。
注意
この記事を書いた日の時点で、Googleがこの新しい書き方を読み始めたとは、どの資料にも書かれていない。Googleの文書がこのトークンのサポートを予定しているのは、2027年の初めである。それより前に行を書いても、Googleがそれを読むとは、どの資料にも書かれていない。
robots.txtは依頼であって、アクセスの許可の仕組みではない
robots.txtの仕様であるRFC 9309は、冒頭近くでこう書く。
"These rules are not a form of access authorization."
(日本語訳: これらの規則は、アクセスの許可の一形態ではない。)
robots.txtに書いた希望を、守るか守らないかは相手のクローラーが決める。共通のトークンが入っても、この性質は変わらない。守らない相手を止めたいなら、サーバーや仲介サービスの側で止める別の手段が要る。当サイトの記事「Cloudflareは確認済みボットを、名乗りが本物かに加えて、robots.txtと429を守り続けているかでも評価し続ける仕組みを書いた ── 自分のサイトのrobots.txtと429がボットに読める形かを確認する13項目(2026年10月時点)」は、robots.txtが読める形かを確かめる方法を整理している。
03 用語 — 出てくる言葉を、先にそろえる
ポリシートークン
用語
ポリシートークンは、robots.txtのUser-Agentの行に書く名札のうち、特定のクローラーの名前ではなく、「AI学習に使うか」のような目的を表すものである。ドラフトによれば、このトークンはクローラーが送る名乗りの文字列に現れなくてもよい。
Google-Extended
Googleのクローラーの文書は、Google-Extendedを、独立したプロダクトのトークンと説明する。これを使うと、サイトからGoogleが取得したコンテンツを、将来の世代のGeminiモデルの学習に使ってよいかと、GeminiアプリなどでのグラウンディングにGoogle検索の索引のコンテンツを使ってよいかを、管理できる。専用のHTTPの名乗りはなく、既存のGoogleの名乗りで取得したものにrobots.txtのトークンだけが使われる。文書は、Google-ExtendedがGoogle検索への掲載にも順位付けにも影響しない、とも書く。
AIPREF
AIPREF(AI Preferences)は、IETFの作業部会の名前である。データトラッカーでは、「Web and Internet Transport」の分野に属する、活動中の作業部会として表示されている。AIの利用についての好みを表す語彙と、それをコンテンツに結びつける方法を作る仕事をしている。
グラウンディング
用語
グラウンディング(根拠づけ)は、Googleの文書の言い方では、AIに質問が来た時点で、Google検索の索引にあるコンテンツをモデルに渡して、答えの事実性や関連性を高めることである。学習とは別の場面だが、Google-Extendedの管理の対象に含まれている。
インターネットドラフト
インターネットドラフトは、IETFで誰でも出せる作業中の文書で、最長6か月で期限が切れる。標準そのものではない。ドラフトの冒頭にも、参考資料として引用してはならず、「作業中のもの」としてだけ引用するのが適切、という趣旨の注意が書かれている。この記事も、そう扱って書いている。
04 型別 — 対象、確かめられないこと、確かめる手順
🅰 適用範囲 — この記事が役に立つ人
robots.txtがある担当サイトを持つ人が対象である。特に当てはまるのは、AIの学習に使われるかどうかについて、会社としての方針を決めておきたい人、robots.txtを制作会社や外部のサービスが自動で書き換えている人、複数のドメインやサブドメインを預かっている人である。方針が「通す」でも「止める」でも、方針の記録と、実際のrobots.txtの行が一致しているかを確かめる意味がある。
🅱 この情報が測っていないこと
この記事は、次のことを確かめていない。Googleが2027年に実際にどう動くか。トークンとGoogle-Extendedの両方が書かれたときの優先関係(Googleの記事は、Google-Extendedが明示されていないときの解釈だけを書いている)。ほかの事業者が対応を表明したかどうか。ドラフトの最終形。さらに、robots.txtを守らないクローラーに、この書き方が効くかどうかは、仕組みの性質上、別の問題である。
🅲 手順1 — robots.txtの現物を保存して、行を数える
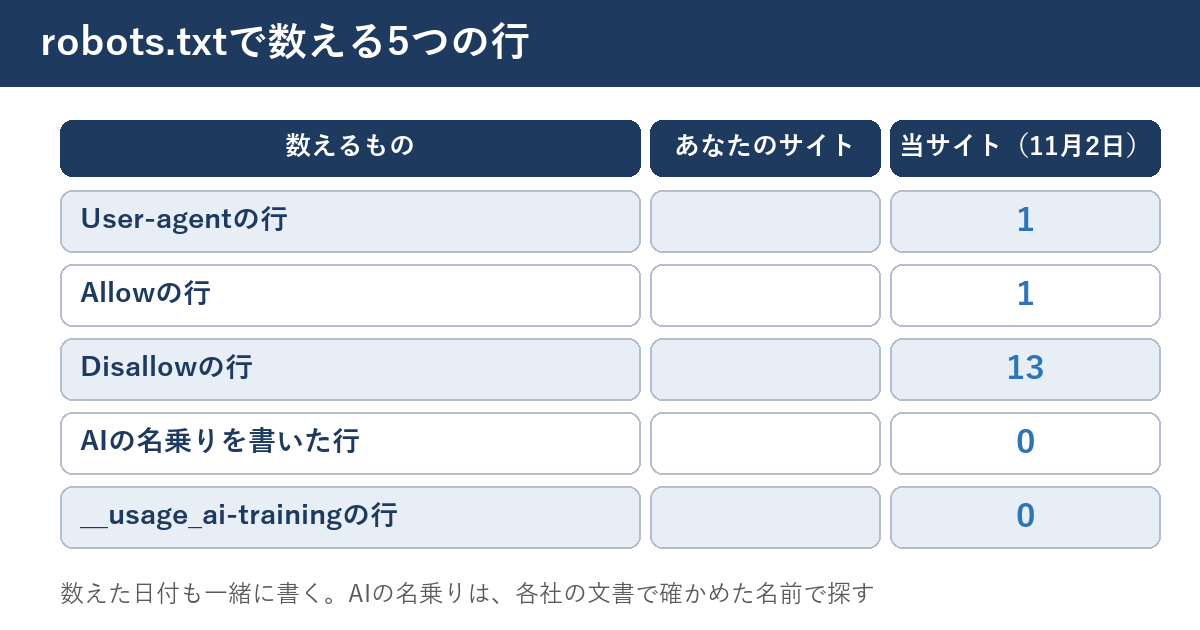
ブラウザで、担当サイトの「/robots.txt」を開く。表示された全文を、日付をつけてメモ帳に保存する。そのうえで、5つの数を書く。User-agentの行の数、Allowの行の数、Disallowの行の数、AIの名乗りを書いた行の数、__usage_ai-trainingの行の数である。数える作業は、検索機能で名前を探して数えるだけでよく、5分で終わる。図は、この5つの数を書き込む表の例である。
🅲 手順2 — 名乗りごとの行を表にする
AIの名乗りの行が1本でもあれば、名乗りと、その行が許可か禁止かを表にする。主な事業者の名乗りは、各社の公式文書で確かめる。当サイトの記事「Cloudflareが9月15日に加えた「AI学習だけを止める」設定 ── 検索に載せたまま止められる範囲と、今週確かめる6つ」に、2026年10月4日に整理した名乗りの一覧がある。名乗りは増減するので、一覧は日付つきで使う。
🅲 手順3 — 自動で書き足す仕組みを探す
robots.txtは、サイトの人が手で書いたものだけとは限らない。当サイトのブログ記事153は、Cloudflareの「Bot Preference Sync」が、該当する「学習に使わない」希望をrobots.txtに載せる、とCloudflareのブログから整理している。管理画面や外部のサービスが書き足す仕組みがある場合、手元のファイルと、外から取得した実物は別のものになりうる。実物を取得して読み、手元のファイルと見比べる。
🅲 手順4 — 会社としての方針を、1行で決める
AI学習について、「通す」「止める」「まだ決めていない」のどれかを1行で書く。決めた人と、決めた日も書く。決めていないなら、誰がいつまでに決めるかを書く。当サイトは、10月6日に「検索・学習・エージェントの3つとも通す」と決めた。決める基準は、サイトの収益の仕組み、コンテンツの性質、会社の方針などで、答えはサイトごとに違ってよい。
🅲 手順5 — 書き足す日を、今ではなく条件で決める
共通トークンの行を書き足す日は、「今日」ではなく、条件で決めるのが無理がない、というのが筆者の案である。条件は2つである。Googleのクローラーの文書の更新で、対応の開始が書かれたこと。そして、書く行の内容を決める人が決まっていること。その日まで、5つの数と方針の記録を、月に1回見直す。
05 明日、担当サイトで確認できることチェックリスト
以下は、担当サイトのrobots.txtでAI学習に触れる行を数え、方針と記録をそろえるための13項目である。1〜3番目はGoogleの資料の確認、4〜8番目はrobots.txtの現物の数え方、9〜11番目は方針と担当者、12〜13番目は確認の続け方である。1項目は5分以内でできる。チェックの状態は、お使いのブラウザに保存され、サーバーには送られない。
- Googleのブログ記事を開き、「2027」と書かれた文を探して、日付の部分をメモ帳に写す
- Googleのクローラーの文書でGoogle-Extendedの欄を開き、末尾の注記にあるトークンの綴りを1つ書き写す
- 同じ文書の下端にある最終更新の日付を書き写し、次に見る日を1か月後に決める
- 担当サイトの/robots.txtをブラウザで開き、全文を日付をつけてメモ帳に保存する
- 保存した全文で、User-agentの行の数を数えて書く
- 保存した全文で、AllowとDisallowの行の数を、それぞれ数えて書く
- 保存した全文を、GPTBot、ClaudeBot、Google-Extended、Applebot-Extendedの4つの名前で検索し、見つかった行の数を名前ごとに書く
- 保存した全文で、__usage_ai-trainingという文字を検索し、見つかった行の数を書く(無ければ0と書く)
- robots.txtを自動で書き足す機能が、管理画面や外部のサービスにあるかを、管理画面の設定の画面を1つ開いて確かめる
- AI学習の方針を「通す」「止める」「まだ決めていない」から選び、決めた人と日付を1行で書く
- 方針が「まだ決めていない」なら、決める人の名前と、決める期限の日付を書く
- ほかのドメインやサブドメインを3つまで選び、それぞれのrobots.txtでAIの名乗りの行の数を数える
- 制作会社や運用会社に、robots.txtを編集できる人の名前を聞いて、台帳の担当の欄に書く
チェックが終わったら、数を書いた表に「確認した日」を書き、次に確認する日を月に1回で決める。
06 代替・他の選択肢 — 学習への希望を伝える方法を、並べて比べる
今ある方法と、予定されている方法
AI学習に対する希望を伝える方法は、共通トークンだけではない。以下は、今回開いた資料から、筆者が整理して並べた表である。
| 方法 | 書き方・使い方 | 時期・状態 | 注意 |
|---|---|---|---|
| 事業者ごとの名乗りの行 | robots.txtに、事業者の名乗りごとのグループを書く | 今できる | 名乗りは各社の文書で確かめる。増減する |
| Google-Extended | robots.txtに、Google-Extendedのグループを書く | 今できる(2023年から) | 学習に加えて、グラウンディングにも関わる |
| 共通のポリシートークン | robots.txtに、__usage_ai-trainingのグループを書く | Googleは2027年の初めの予定 | ドラフト。綴りや規則が変わる可能性がある |
| Search Consoleの「検索の生成AI」の設定 | 管理画面で、生成AI機能に含めるかを決める | 今できる | 当サイトの記事153の追記によれば、学習とは別に決める |
| 仲介サービスの設定 | Cloudflareなどの機能が、robots.txtに希望を載せる | 使っている場合のみ | 手元のファイルと、外から見える実物が別になりうる |
「検索の生成AI」の設定は、別の画面で決める
当サイトのブログ記事153には、10月15日の訂正が足されている。Googleの生成AIの検索機能(AIによる概要・AIモード)にサイトを含めるかどうかは、Search Consoleの「検索の生成AI」の設定で別に決める、という内容である。Google-Extendedを断ることと、この設定は、別のものとして扱われる。方針を決めるときは、画面を2つ見る必要がある。AIの検索の扱いは、当サイトの記事「Googleの「Control what you share with Google Search」が10月21日に更新された。止める手段は7つ ── 止めたいものから選ぶ判断表で自社のページを確かめる13項目(2026年10月時点)」にも整理がある。
共通トークンの行を、今は書かない理由
筆者の案では、担当サイトの方針が「止める」でも、共通トークンの行は、今は書かない。理由は3つある。Googleが読むのが2027年の初めの予定であること。綴りがドラフトのまま確定していないこと。そして、ドラフトは未対応の読み手が新しいグループを無視する前提で作られているが、サイトごとの古いrobots.txtの読み手がどう動くかまでは、確かめられていないことである。止める意思がすぐに必要なら、今ある事業者ごとの行で伝える。
止めるのではなく、方針を持つ
AI学習を通すことも、立派な方針である。大事なのは、「通す」と決めた記録があり、実際のrobots.txtがその記録と食い違っていないことだ。Googleの記事が書く、Google-Extendedを明示的に許可したサイトへの一文は、「通す」側にも明示という選び方があることを示す。明示の行を足すかは、当サイトでも決めていない。07章に書く。
07 当サイトで確かめたこと — 学習は通す方針で、robots.txtにAIの名乗りの行は0本
2026年11月2日に、当サイトの/robots.txtを外から取得して、行を数えた。結果は次のとおりである。
| 数えたもの | 行数 |
|---|---|
| User-agentの行 | 1 |
| Allowの行 | 1 |
| Disallowの行 | 13 |
| AIの名乗り(GPTBot・ClaudeBot・Google-Extended・Applebotなど)を書いた行 | 0 |
| __usage_ai-trainingを書いた行 | 0 |
| 全体の行数(空行を含む) | 17 |
数えた結果
当サイトのrobots.txtは、「*」に対するグループが1つだけで、そのほかに、サイトマップの案内の行がある。AIの名乗りを個別に書いた行は、1本もない。この状態は、ブログ記事153に追記した方針、つまり検索・学習・エージェントの3つとも通すと、食い違っていない。方針はブログ記事153に10月6日に追記した。
ドラフトの規則を当てはめると
ここで、ドラフトの規則を当てはめると、1つ気づくことがある。ドラフトは、「User-Agent: *」のグループをポリシートークンに一致させてはならない、と書く。当サイトの「*」の許可は、共通トークンの読み手から見れば、学習への好みを何も示していないことになる。Googleの記事が書く、Google-Extendedを明示的に許可したサイトの一文も、当サイトには当てはまらない。当サイトは明示していないからである。
これから決めること
実務のヒント
「通す」と決めたサイトでも、「何も書かない」と「明示的に許可する」は別の状態である。Googleの記事が示す一文に魅力を感じるなら、明示の行を足すかを、方針の見直しの項目に入れておく。足すかは、足すことで失うものがないかも含めて、決める人が決める。
当サイトは、明示の行を足すかを、まだ決めていない。2027年の初めにGoogleの文書が更新され、対応が始まったと書かれた時点で、行を足すかどうかを決め、決めた内容を、この記事に日付つきで追記する。
なお、当サイトはCloudflareを通っていない(ブログ記事153が10月4日に確かめた)。AIクローラーの来訪を当サイトのログで数えた結果は、ブログ記事「llms.txt を置いて51日、正直に答え合わせ第2弾 ── Google が『効かない』と言った以上に、他の AI も読みに来ていなかった」にある。
08 このテーマは、ここまで — AIの学習と取得を、どう扱ってきたか
これまでの記事
- Cloudflareが9月15日に加えた「AI学習だけを止める」設定 ── 検索に載せたまま止められる範囲と、今週確かめる6つ — 検索・学習・エージェントを別々に決める考え方と、当サイトの方針の追記
- Cloudflareのデフォルト「AI bots ブロック」があなたのGEOを殺している — robots.txt無関係のインフラ層ブロックと、WEBディレクターが今すぐ確認すべき3つの設定 — robots.txtの外で止まる場合の話
- 「AIクローラーが弾かれている」と読みかけた ── 日別に割ったら、正体は数十の名前を名乗る貸しサーバーだった — 名乗りだけで判断しない
- 同じ条件で測っていなかった ── robots.txtは「24時間キャッシュ」のはずが、測ったら1日13.9件と152.3件。3サイトの数字を並べる前に確認すべきだったこと — robots.txtの読まれ方
- llms.txtの仕様で必須なのは先頭の見出し1つだけ。Googleは検索で使わないと書き、3社のクローラーの説明ページには、クローラーがllms.txtを読むという記述が見つからなかった ── 置くかを決め、置いたあとにログで確かめる13項目(2026年10月時点) — AI向けのファイルの考え方
今回の記事の位置
これまでの記事は、AIのクローラーに「通す・止める」を伝える方法と、実際に来ている相手の確かめ方を書いてきた。今回は、伝える方法そのものが、会社ごとの行から共通の1行へ向かい始めた、という出来事を扱った。変わったのは、Googleの文書に綴りが載ったことと、時期が2027年と書かれたことだけで、今日のサイトの状態は変わっていない。
次にこの話に続報が出たときは、Googleのクローラーの文書の最終更新の日付を先に見る。日付が動いていなければ、数えた表は更新せず、確認した日だけを書き足せばよい。日付が動いて対応の開始が書かれていたら、07章の「明示の行を足すか」を決める日になる。
現在の貴方のIPアドレス
このサイトで書いている人
