WEBサイト
Googleの「Control what you share with Google Search」が10月21日に更新された。止める手段は7つ ── 止めたいものから選ぶ判断表で自社のページを確かめる13項目(2026年10月時点)
Googleの「Control what you share with Google Search」が10月21日に更新された。止める手段は7つ ── 止めたいものから選ぶ判断表で自社のページを確かめる13項目(2026年10月時点)
目次
01 何が書いてあるか — Googleの「共有する内容を管理する」文書が更新された。変わった点は小さく、手段は7つに整理されている
引用について
この記事の「" "」で囲んだ英語の文は、Googleの公式の文書からの引用で、日本語訳は記事の筆者が付けたものである。原文は出典のページで確かめられる。各ページは2026年10月23日に開いて、本文を取り直して確かめた。
更新履歴に書かれた、2026年10月21日の項目
Google検索セントラルの更新履歴には、2026年10月21日の項目として、「Updated the control what you share with Google Search documentation」(訳: 共有する内容を管理する文書を更新した)が載っている。何を変えたかの欄は、次のように書かれている。
"to include existing options such as the robots meta tag, data-nosnippet, X-Robots-Tag, and the Search generative AI control, along with minor clarifications that the page applies to Google Search."
(訳: robots metaタグ、data-nosnippet、X-Robots-Tag、Search generative AI controlといった既存の選択肢を含めた。あわせて、このページがGoogle検索に当てはまることを、小さく明確にした。)
理由の欄は、「To keep the page fresh and reflect the current set of options available to site owners.」(訳: ページを新しく保ち、サイト所有者が使える現在の選択肢を反映するため。)である。つまり、新しい機能が加わったのではない。すでにある選択肢を、このページに並べ直した更新である。変更点が小さいことは、先に書いておく。
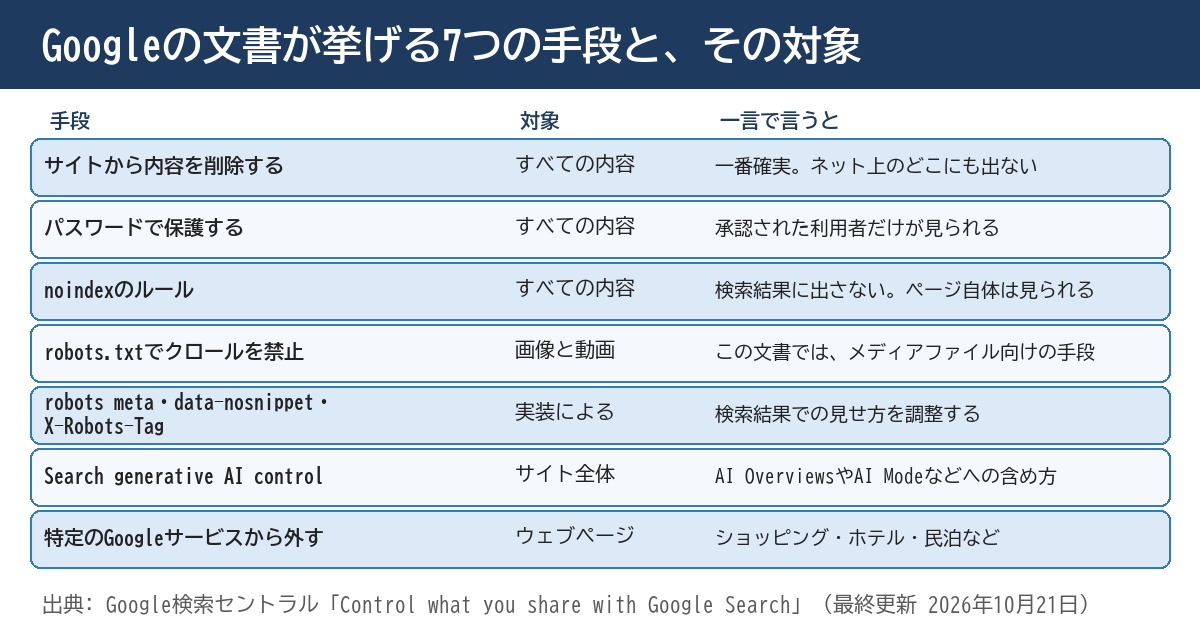
文書が挙げる、7つの手段
文書の英語版(最終更新は2026年10月21日 UTC と表示されている)は、検索に出ないようにする主な方法として、次の7つを並べる。それぞれに「対象」の欄がある。対象の書き方は、原文のままにした。
- サイトから内容を削除する — 対象は、すべての内容。
- ファイルをパスワードで保護する — 対象は、すべての内容。
- noindexのルールを使う — 対象は、すべての内容。
- robots.txtでクロールを禁止する — 対象は、画像と動画。
- robots meta・data-nosnippet・X-Robots-Tagを使う — 対象は、実装によって異なる。
- Search generative AI controlを使う — 対象は、サイト全体。
- 特定のGoogleサービスから外す — 対象は、ウェブページ。
日本語版は、まだ古い版だった(確かめた範囲)
同じ文書の日本語版(「Google と共有するコンテンツを制限する」)を、2026年10月23日に開いたところ、最終更新日は2025年12月31日 UTCと表示されていた。手段として並ぶのは、削除・パスワード・noindex・robots.txt・特定のGoogleサービスのオプトアウトの5つで、robots metaなどの項目と、Search generative AI controlの項目は、見当たらなかった。日本語版が追いついているかは、読む時点で、もう一度開いて確かめてほしい。
02 なぜ止めるのか — 文書が挙げる3つの理由
多くの人は、登録させることに注力する
文書は、まず前提から書く。
"While most people focus on getting their pages indexed, sometimes it's important to do the opposite: prevent content from appearing in Search."
(訳: ほとんどの人がページをインデックスに登録させることに注力するが、時には、その反対に、内容を検索に出さないことが重要になる。)
そのうえで、検索に出したくない理由を、3つ挙げる。
理由1 — データの表示を制限する
サイトで預かっているデータを、すでにサイトに来ている利用者にだけ見せたい場合がある。そのとき、Googleによるクロールをブロックすれば、検索結果に出ない、と文書は書く。あわせて、公開したファイルの中にあるメタデータが、検索結果に出うることも注意している。
理由2 — 価値の低い内容を隠す
利用者が内容を作れるサイトでは、その一部が、質の低いものやスパムになりうる、と文書は書く。そうした内容をインデックスに登録させると、サイトの検索順位に悪い影響が出るかもしれない、とも書く。
理由3 — 重要な内容に集中してもらう
数十万を超えるURLがある大きなサイトや、重複した内容が多いサイトでは、重複したページや重要度の低いページをクロールさせないことで、重要な内容にGoogleを集中させられる、と文書は書く。
見えない内容は、見えている
理由1に関連して、Googleには別の文書がある。「Keep redacted information out of Google Search」(訳: 墨消しした情報をGoogle検索に出さない)である。文字を小さくする、背景と同じ色にする、画像で覆う、といった方法は、人の目には見えなくなるが、検索エンジンによる登録や、見つけやすさを防ぐ墨消しにはならない、と書く。黒い四角を文字に重ねる方法も避けるように、と書かれている。止めるという目的は、手段の選び方で、成功も失敗もする。
03 この記事に出てくる用語
インデックス
検索エンジンが、ページの内容を保存して、検索結果に出せる状態にすることをいう。登録されていないページは、検索結果に出ない。
クロール
検索エンジンのプログラム(クローラー)が、ページを読みに来ることをいう。クロールを止めることと、インデックスに登録させないことは、別のことである。
noindex
「このページを検索結果に出さない」と伝えるルールをいう。HTMLのmetaタグか、HTTPの応答のヘッダーで書く。Googleが書く範囲では、ページ自体は、他のページからのリンクや、直接のURLで見られる。
robots.txt
サイトの一番上に置く、クローラーに「どのURLに入ってよいか」を伝えるファイルをいう。Googleの文書は、主にサーバーへのリクエストが多くなりすぎないようにするためのもの、と書く。
X-Robots-Tag
HTTPの応答のヘッダーで、metaタグと同じルールを伝える方法をいう。PDF・動画・画像のような、HTMLでないファイルにも使える。
スニペットとdata-nosnippet
スニペットは、検索結果に出る、ページの説明文や動画の短いプレビューをいう。data-nosnippetは、ページの中の一部の文章を、スニペットに使わせないための属性である。
Search generative AI control
Search Consoleの設定の1つで、サイトを、Google検索の生成AIの機能(AI Overviews・AI Modeなど)に含めるかを決める。この記事では「生成AIコントロール」と呼ぶ。
用語
削除リクエスト(Removals tool)とは、検索結果からページを一時的に消すよう、Search Consoleから頼む機能をいう。文書によれば、効果は約6か月で、そのあともずっと消えた状態にするには、内容の削除・パスワード保護・noindexのいずれかが要る。
04 型別 — 7つの手段を、止めたいものから選ぶ
🅰 適用範囲 — 手段ごとに、何に効くか
内容を消す・パスワードで保護する
この2つは、対象が「すべての内容」である。そのうち、文書が「最良の方法(the best way)」と書くのは、内容の削除である。パスワード保護については、そうは書いていない。文書は、削除を、次のように書く。
"Removing content from your site is the best way to ensure that it won't appear in Google Search and anywhere else on the Internet."
(訳: サイトから内容を削除することは、それがGoogle検索にも、インターネット上のほかのどこにも出ないようにする、最良の方法である。)
パスワードで保護すると、承認された利用者だけが見られる。すでに検索に出ている場合も、いずれ検索結果から消える、と文書は書く。ここで、見落としやすい点がある。パスワードで守ったページの手前に出る、ログイン画面そのものである。墨消しの文書は、認証でアクセスを制限するときは、表示されるログイン画面にnoindexのmetaタグを付けて、登録を止めるように、と書く。
noindex — 検索に出さず、ページは見られる
noindexは、Googleがページを読んで、タグやヘッダーを見つけたときに、そのページを検索結果から外す。文書は、動かすための条件を、重要な注意として書く。
"For the noindex rule to be effective, the page or resource must not be blocked by a robots.txt file, and it has to be otherwise accessible to the crawler."
(訳: noindexのルールが効くためには、そのページやリソースが、robots.txtでブロックされていてはならず、そのほかの面でも、クローラーが入れる状態でなければならない。)
書き方は、metaタグとヘッダーの2通りで、効果は同じと書かれている。robots.txtの中にnoindexを書く方法は、Googleでは対応していない。
robots.txt — この文書では、画像と動画の手段
robots.txtは、この文書では、画像と動画の手段として挙がる。Googleは、Googlebotがクロールを許されている画像と動画だけを、登録するためである。一方、HTMLのページを隠す手段としては、別の文書が、強い言葉で止めている。
"This is used mainly to avoid overloading your site with requests; it is not a mechanism for keeping a web page out of Google."
(訳: これは主に、サイトがリクエストで過負荷にならないようにするために使うもので、ウェブページをGoogleに出さないための仕組みではない。)
robots.txtで止めたページでも、他のページからの説明つきのリンクがあれば、URLが説明なしで検索結果に出ることがある、と同じ文書は書く。
見せ方を調整する — robots meta・data-nosnippet・X-Robots-Tag
この手段は、検索結果で、内容をどう見せるかを調整する。出すかどうかではなく、出し方である。nosnippetは、テキストのスニペットや動画のプレビューを出さない。文書は、この指定が、AI Overviews・AI Modeを含む検索結果のあらゆる形に当てはまり、さらに、次の効果もあると書く。
"will also prevent the content from being used as a direct input for AI Overviews and AI Mode."
(訳: その内容が、AI OverviewsとAI Modeの直接の入力として使われることも、防ぐ。)
max-snippetは、スニペットの最大の文字数を指定する。0はnosnippetと同じである。ページの中の一部の文章だけを外したいときは、data-nosnippetを、span・div・sectionの要素に付ける。矛盾する指定がある場合は、より厳しい方が効く、と文書は書く。
生成AIコントロール — サイト全体で、AIの機能への含め方を決める
Search Consoleのヘルプによれば、この設定は、2026年8月31日の時点で、全世界のすべてのサイトに展開された。対象は、AI Overviews、AI Mode、Google Discoverの生成AIの機能である。選べるのは、含める(既定)、除外する、親のプロパティから継承する、の3つである。除外の効果は、設定が有効になってから、1〜2日以内に出るが、キャッシュなどで、もっと長くかかる内容もある、と書かれている。
特定のGoogleサービスから外す
Googleショッピング、Googleフライト、Googleホテルと民泊、ローカル検索の結果に、サイトの内容を出さない設定をいう。ヘルプによれば、この設定は、サブドメインやディレクトリだけには指定できず、ドメイン名の単位で効く。すでに出ている内容は、設定から30日以内に消える、と書かれている。
🅱 この文書が書いていないこと
文書の本文を読んで、書かれていないことが、いくつかあった。確かめた範囲で、整理する。
- max-snippetの記述 — この文書の本文には、max-snippetという語が出てこない。詳しい説明は、別の文書(robots meta・data-nosnippet・X-Robots-Tagの仕様)にある。
- AIの学習を止める方法 — この文書には書かれていない。Search Consoleのヘルプが、生成AIコントロールはAIの学習には影響しないと書き、別の仕組み(Google-Extended)を案内している。
- 他の検索エンジンでの扱い — この文書は、Googleの扱いを書く。noindexについて、別の検索エンジンは、違う解釈をする場合がある、と別の文書は書く。
- どの手段を選ぶべきかの判断の順番 — 手段は並ぶが、状況ごとの選び方の表は、書かれていない。次の🅲で、止めたいものから選ぶ表にする。
🅲 手順 — 止めたいものから手段を選ぶ判断表
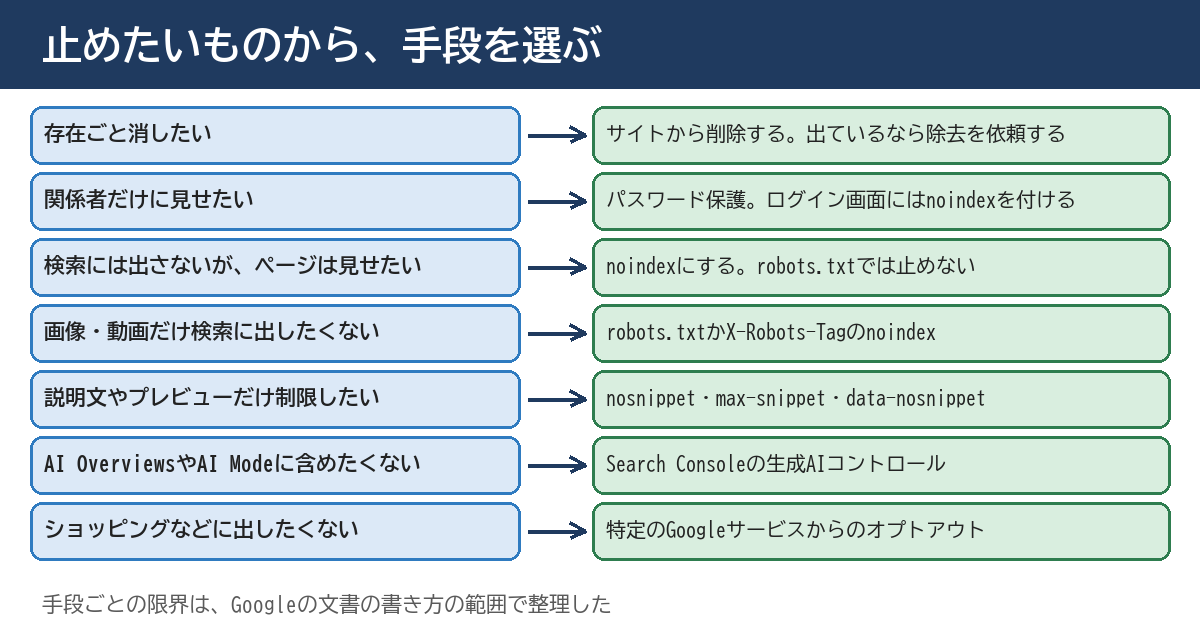
| 止めたいもの | 選ぶ手段 | 文書が書く注意 | 確かめる場所 |
|---|---|---|---|
| 存在ごと消す | サイトから削除する | すでに出ているなら、除去を依頼できる(効果は約6か月) | URLを開き、404や410になるか |
| 関係者だけに見せる | パスワード保護 | ログイン画面にはnoindexを付ける | ログアウトの状態で開く |
| 検索に出さない | noindex | robots.txtで止めない。クローラーが入れる状態にする | Search ConsoleのURL検査 |
| 画像と動画を出さない | robots.txt、またはX-Robots-Tag | Googlebot-Imageを指定できる。両方を同時に使う意味はない | robots.txtの該当の行 |
| 見せ方を減らす | nosnippet・max-snippet・data-nosnippet | より厳しい指定が効く。JavaScriptで付け外ししない | ページのソース |
| AIの機能に含めない | 生成AIコントロール | AIの学習は対象外。検索から完全に消すならnoindex | Search Consoleの設定 |
| 特定のサービスに出さない | オプトアウト | ドメイン名の単位。30日以内に消える | Search Consoleの設定 |
組み合わせると効かなくなるもの
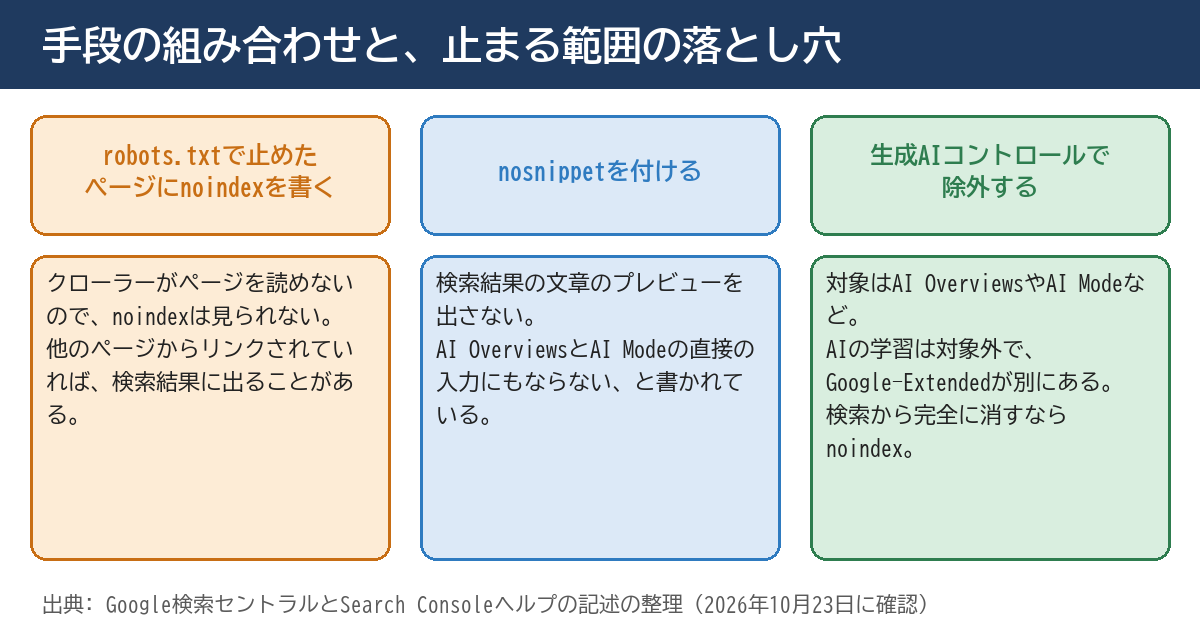
表の手段は、重ねるほど安全になるとは限らない。robots.txtで止めたページに、noindexを書くと、noindexは読まれない。画像の文書も、robots.txtとX-Robots-Tagのnoindexを、同時に使う意味はない、と書く。Googlebotがページに入れなければ、ヘッダーも取れないためである。
生成AIコントロールは、noindexの代わりにならない
Search Consoleのヘルプは、除外しても、AIの学習は対象外であり、検索から完全に消すなら別の手段が要る、と書く。
"This control doesn't affect AI training; to limit training of the models used to generate responses in Search generative AI features, use Google-Extended. To block your content from appearing in Google Search completely, use noindex."
(訳: このコントロールは、AIの学習に影響しない。検索の生成AIの機能で回答を作るモデルの学習を制限するには、Google-Extendedを使う。内容がGoogle検索に全く出ないようにするには、noindexを使う。)
この設定が、ランキングや他の検索の部分に使う信号ではない、とも書かれている。
注意
URLの別の形も、止める対象に入れる。除去の文書は、「example.com/puppies」「example.com/PUPPIES」「example.com/petchooser?pet=puppies」のように、同じページへ別のURLでたどり着ける場合は、すべてのURLを保護するか消すように、と書く。止めたつもりのURLが1つだけだと、別の形のURLが残る。
05 明日、自社のサイトで確認できることチェックリスト
以下は、止めたいものと、実際に使っている手段が合っているかを確かめる13項目である。1〜2番目で表を作り、3〜6番目でnoindex、7番目でパスワード保護、8番目で見せ方の指定、9番目で生成AIコントロール、10〜12番目で画像・削除済みのページ・オプトアウト、13番目で記録を残す。1項目は5分以内でできる。チェックの状態はブラウザに保存され、サーバーには送られない。
- 検索に出したくないページを3つ書き出し、それぞれを、削除・パスワード・noindex・robots.txt・見せ方の指定・生成AIコントロール・オプトアウトのどれで止めているかを、表の1行ずつに書く
- 表で「robots.txt」と書いた行のうち、HTMLのページ(画像・動画ではないもの)の数を数え、あれば、別の手段にするかを書く
- noindexを付けたページを3つ開き、ページのソース(またはHTTPのヘッダー)にnoindexが出ているかを、1つずつ確認する
- robots.txtを開き、3番目の3つのURLが、Disallowの行で止められていないかを確認する
- Search ConsoleのURL検査で、noindexのページを1つ選び、Googlebotが受け取ったHTMLにnoindexが見えているかを確認する
- Search Consoleのページのインデックス登録のレポートで、noindexのルールが見つかったページの件数を控える
- パスワードで保護したページを1つ、ログインしていないブラウザで開き、ログイン画面かエラーになることと、その画面にnoindexがあるかを確認する
- nosnippet・max-snippet・data-nosnippetを使うページを3つ探し、ソースで、同じページにnosnippetとmax-snippetの両方がないかを確認する
- Search Consoleで、生成AIコントロールの設定を開き、値(含める・除外・継承)と継承元を書き写す
- 画像や動画で検索に出したくないものを3つ書き出し、robots.txtのGooglebot-Imageの行か、X-Robots-Tagのnoindexのどちらで止めているかを書く
- 検索結果から消したい、削除済みのページを5つ書き出し、内容の削除・パスワード・noindexのどれを済ませたかを、1つずつ一覧にする
- ショッピングやホテルなどに内容を出しているサイトは、Search Consoleのオプトアウトの設定を開き、値を書き写す
- 確認した日、数えた数字(手段ごとのページ数・noindexの件数)、次に見直す日を、記録に書く
5〜6番目の確認で、Search Consoleから書き出した「登録されなかった理由」の一覧を、URLごとに見たいときは、当サイトの無料ツールの1つ、🔧 Search Consoleのエクスポートを読み込んで詳しく見るツールが使える。ツールのページによれば、Search Consoleの「ページがインデックスに登録されなかった理由」の一覧のCSVを読み込み、URLの今の状況を調べる。noindexやrobots.txtの組み合わせを、自動で判定するとは、ページに書かれていない。
3番目の確認の前に、ページの基本の設定をまとめて見たいときは、🔧 WEBサイト総合分析・レポートツールが使える。ページによれば、title・meta description・canonical・OGPタグの設定と、見出し、リンク、セキュリティヘッダーを点検する。ページの説明には、robots metaの判定は書かれていないので、noindexの確認は、ソースを見る方法で行う。
06 代替・他の選択肢 — 各手段の「できないこと」を並べる
次の表は、Googleの文書に書かれた範囲で、各手段ができないことを並べたものである。文書が書かないことは、空欄にせず、「書かれていない」と書いた。
| 手段 | できないこと(文書の書き方) | 書かれていないこと |
|---|---|---|
| noindex | 他のページからのリンクや、直接のURLでの訪問は止まらない。ほかの検索エンジンが、同じ解釈とは限らない | 止まるまでの日数(クロールの頻度による) |
| robots.txt | HTMLのページを検索結果から隠せない。URLだけ出ることがある。他のクローラーが従うとは限らない | URLが出る割合 |
| 見せ方の指定 | ページを検索から外さない。構造化データの値は、一部を除いて制限できない | 他の検索エンジンでの扱い |
| 生成AIコントロール | AIの学習は対象外。検索から完全に消さない。他の公開の選択を上書きしない | 除外後に、実際に出なくなるまでの正確な日数 |
| オプトアウト | サブドメインやディレクトリだけでは指定できない | 書かれていない |
| 削除リクエスト | 効果は約6か月で切れる。ずっと効く手段ではない | 書かれていない |
「何もしない」という選択
止めない、という選択も、手段の1つである。文書の冒頭にあるとおり、大半のサイトは、むしろ、登録されることに注力する。止めるのは、公開したくない理由が、はっきりしているページだけにするほうが、後から、止めた理由を説明しやすい。これは筆者の考えで、文書の内容ではない。
この判断表と、これまでの記事の分担
手段ごとの細かい説明は、当サイトの過去の記事にある。noindex・nofollow・robots.txtの違いは、noindex・nofollow・robots.txtは、それぞれ何を止めているのか ── 混同しやすい3つの設定を確認する15項目に、robots metaとX-Robots-Tagの12種類の指定は、robots meta タグ・X-Robots-Tagのディレクティブ ── nosnippet・max-snippetなど12種類を確認する14項目(2026年9月時点)に、生成AIコントロールの継承は、Search Consoleの生成AIコントロールは、親プロパティの設定を子が引き継ぎ、子が上書きできる ── 自社のプロパティごとの設定と継承を書き出して確認する13項目(2026年10月時点)にある。この記事の新しさは、更新されたページを、止めたいものから選ぶ1枚の表にしたことだけである。
実務のヒント
止める手段を決める会議では、最初の10分で、判断表の1列目(止めたいもの)だけを埋める。手段の名前から話し始めると、「とりあえずnoindex」「とりあえずrobots.txt」と決まり、止めたい理由が後から消える。
07 当サイトで確かめたこと — 確かめていないことの範囲
当サイトでは、過去に、止める手段の確認で、読み違えかけたことがある。AI Ronのブログの外から取った画面は、目当ての画面とは限らない ── 遮断の画面を404と読み、引用符の違いでnoindexを「無い」と読みかけたは、noindexを、外から調べるときの落とし穴を書いた。また、「リンク切れ0本」を確認して、安心しかけた ── 自社ブログの内部リンク、59.2%はnoindexへの飛び先だったは、noindexのページへのリンクが多かったことを数えた記録である。
Search Consoleの生成AIコントロールについては、Search Consoleに「検索の生成AI」の設定が加わった ── 当サイトの画面を開いたら、自分の値は無く、親のドメインから受け継いでいたに、当サイトの画面で確かめた結果を書いた。
この記事の判断表は、公式の文書の整理であり、当サイトの設定の値や、サーバーの中身は書かない。当サイトの各ページが、表のどの手段で止まっているかは、この記事では確かめていない。確かめるのは、読者が、05章の13項目で、自社のページに行う。
08 このテーマは、ここまで
2025年3月 — AI Modeの記述と、ページの注釈の削除
Google検索セントラルの更新履歴によれば、2025年3月5日に、robots metaタグなどの仕様の文書へ、AI Modeについての情報が加わった。同年3月7日には、この「共有する内容を管理する」文書から、ページの注釈(Page Annotations)の機能の記述が削除された。機能が使えなくなったためである。
2025年12月 — 関連ページの更新と、日本語版
noindex、robots.txtの概要、墨消しの情報の文書は、2025年12月10日が最終更新と表示されている。この文書の日本語版は、2025年12月31日が最終更新である。
2026年3月〜8月 — 見せ方の仕様と、生成AIコントロール
robots metaなどの仕様の文書は、2026年3月24日が最終更新である。生成AIコントロールは、Search Consoleのヘルプによれば、2026年8月31日に、全世界のすべてのサイトに展開された。
2026年10月21日 — この文書の更新
この文書が更新され、robots metaタグ・data-nosnippet・X-Robots-Tag・生成AIコントロールが、手段の一覧に加わった。更新履歴は、これを小さな明確化と書く。
2026年10月23日 — この記事の確認日
この記事の内容は、2026年10月23日に、Google検索セントラルとSearch Consoleヘルプの各ページを開いて確かめた時点のものである。出典のページが更新されたときは、この記事に日付つきで追記する。
現在の貴方のIPアドレス
このサイトで書いている人