 WEBサイト
Cloudflareは、利用者の代わりに来る個人用AIエージェントを、分析の専用の区分と、エージェントごとの許可・ブロックで扱えるようにした ── 自社のログで代理の取得を分けて数え、通すかを決める13項目(2026年11月時点)
Cloudflareは、利用者の代わりに来る個人用AIエージェントを、分析の専用の区分と、エージェントごとの許可・ブロックで扱えるようにした ── 自社のログで代理の取得を分けて数え、通すかを決める13項目(2026年11月時点)
目次
- 01 何が起きたか — 11月4日、Cloudflareは個人用AIエージェントのアクセスを、分析の専用の区分と、エージェントごとの方針で扱えるようにした
- 02 なぜ・背景 — 「自動の通信」が、3つの理由で来るようになった
- 03 用語 — 出てくる言葉を、先にそろえる
- 04 型別 — 適用範囲、この発表が測っていないこと、確かめる手順
- 05 明日、担当サイトで確認できること
- 06 代替・他の選択肢 — 代理の取得への対応を、並べて比べる
- 07 当サイトで確かめたこと — 当サイトはCloudflareを使っていないので、画面ではなくログで見る
- 08 このテーマは、ここまで — 来訪の分け方と、名乗りの確かめ方を、どう積み上げてきたか
- 09 この記事のまとめ
01 何が起きたか — 11月4日、Cloudflareは個人用AIエージェントのアクセスを、分析の専用の区分と、エージェントごとの方針で扱えるようにした
引用について
この記事は、Cloudflareの公式ブログ(2026年11月4日付)、同社の開発者向けの変更履歴、同社の文書(AI Crawler and Agent access policies、Verified bots、Account Abuse Protection)、OpenAIのクローラーの説明ページ、robots.txtの仕様(RFC 9309)を、2026年11月6日に開いて確かめた内容を書いている。英文を引くときは原文のまま引き、日本語訳を添える。それ以外は、記事の筆者が日本語に直した要旨で書く。原文に書かれていない筆者の読みは「筆者の読み」と書いて分ける。05章のチェックリストは、筆者が整理したものである。
担当サイトのアクセスログを開くと、「人ではない誰かが、ページを取りに来ている」行が並んでいる。その中に、検索のために索引を作る来訪とも、AIの学習のためにまとめて集める来訪とも違う、利用者に頼まれて、その場でページを読みに来る来訪がある。Cloudflareは2026年11月4日、この種類の来訪を「個人用エージェント(Personal agents)」と呼び、見える化と、エージェントごとの制御を出した。WEBディレクターが先に押さえたいのは、新しいのは「見分けて数えること」と「エージェントごとに通すかを選べること」の2つで、ログインと会員登録の保護は先行利用の別枠で加わった。この種類の来訪が増えているかどうかは、この発表からは分からないという点だ。
この記事では、発表の中身を、原文に書かれたことと書かれていないことに分けて整理する。そのうえで、Cloudflareを使っていないサイトでも同じ問いを自社のログに当てられるように、代理で来る取得を分けて数える手順を13項目にした。
分析: Security Analyticsに「Personal Assistants」の区分が加わった
ブログによると、Security Analyticsの「Bot Analysis」の図に、新しく「Personal Assistants」の区分が加わった。これまでの「Verified Bot」「Likely Human」「Likely Automated」「Automated」と並ぶ5つ目の区分で、選ぶと個人用エージェントの通信だけの推移を見られる。さらに「Top statistics」には、どのエージェントが何回要求したかを並べるウィジェットが加わった。1つのエージェントで絞り込むと、ほかの表示もそのエージェントの通信だけになり、取得したパス、返したステータスコード、元のネットワークが分かる。
ブログは、この見える化の価値を、次の1文で言い表している。
"Knowing which agent is behind a request turns unexplained automated traffic into traffic you can act on with confidence."
(日本語訳: どのエージェントが要求の背後にいるかが分かれば、説明のつかない自動の通信が、自信を持って対応できる通信に変わる。)
方針: 全体の「Agents」方針の下で、エージェントごとに選べる
設定の名前は、これまでの「Configure AI bot policies」から「AI Crawler and Agent access policies」に変わった。セキュリティ設定で、全体のAgents方針を決めたうえで、対応している個人用エージェントごとに、Allow(ブロックしない)、Block on pages with ads(広告のあるページでブロック)、Block(ブロック)のどれかを選べる。ブログの例は、全体を「広告のあるページでブロック」にして、歓迎したい1つのエージェントだけを「ブロックしない」にする、という使い方である。検索(Search)と学習(Training)の方針は、これまでのまま変わらない。
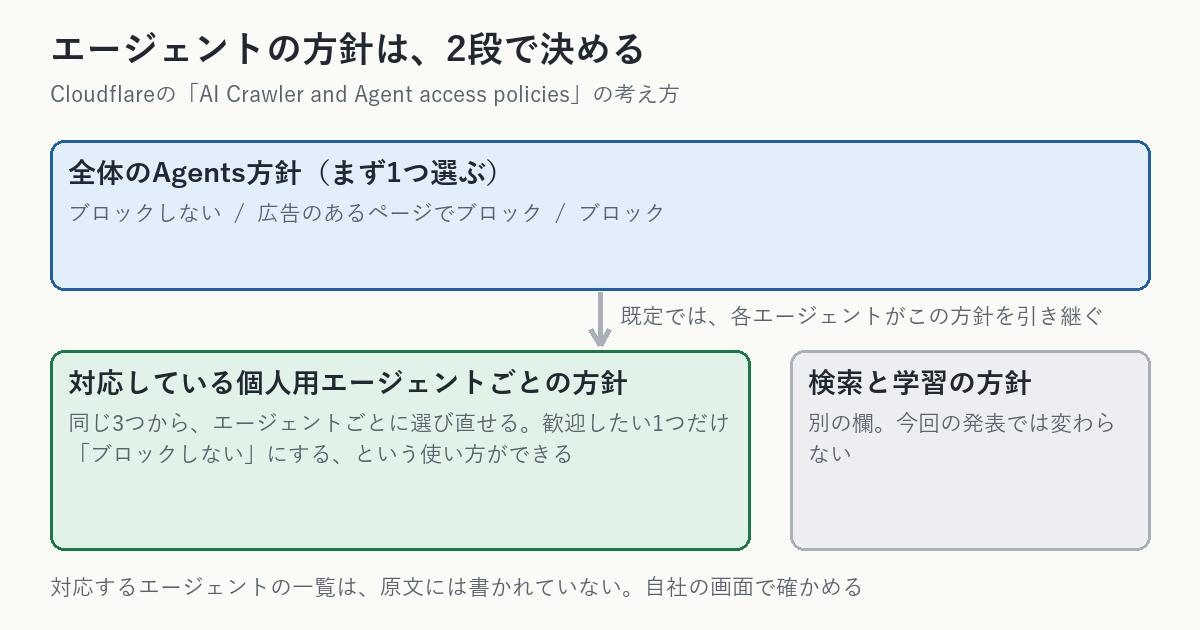
Cloudflareの文書(2026年11月2日更新と表示されたページ)には、さらに2点が書かれている。個人用エージェントは、既定では全体のAgents方針を引き継ぐこと。そして、Cloudflareは個人用エージェントに対して「Allow(ブロックしない)」を勧めていることである。
アカウント保護: ログインと会員登録の要求に、エージェントの名前が付く
ログインや会員登録を守る機能「Account Abuse Protection」では、個々のログインと会員登録の記録に、個人用エージェントが送った要求かどうか、どのエージェントかが表示される。ブログは、利用者のアカウントを不正に使おうとする者がエージェントを使っている疑いがあるときは、そのアカウントのハッシュ化された利用者IDにWAFのルールをかけて、そのエージェントを頼りにしているほかの人を止めずに、そのアカウントだけを制限できると書いている。Cloudflareの文書によると、この機能は先行利用(Early Access)の段階で、Bot Managementの企業向け契約の顧客が対象である。
原文に書かれていないこと
ブログと変更履歴には、次のことが書かれていなかった。記事の筆者が書き足していないことを、先に並べておく。
- 対応している個人用エージェントの名前の一覧(原文は「上位の個人用エージェント」とだけ書く)
- 個人用エージェントの来訪数や割合などの数字
- エージェントを見分ける技術的な方法(ブログは「世界最大の検証済みボットの一覧」を使うと書くだけである)
- robots.txtでエージェントごとに指定する書き方
- 対応プランと料金(Account Abuse Protectionが企業向けの先行利用であることは文書にある)
02 なぜ・背景 — 「自動の通信」が、3つの理由で来るようになった
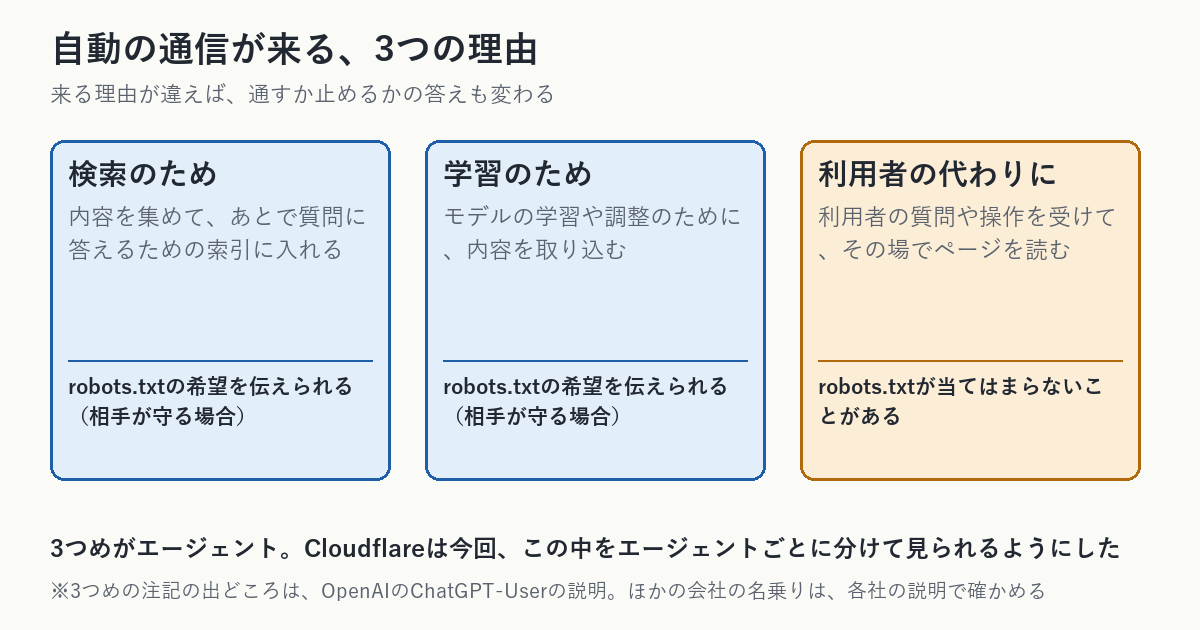
アクセスログの「自動」を、ひとつの塊として数えていると、判断を誤る。同じ自動でも、来る理由が違えば、通すか止めるかの答えも変わるからだ。Cloudflareはこの発表で、来訪を振る舞いで分ける考え方を、さらに進めた。
検索・学習・エージェントは、別々に決める
Cloudflareの文書は、AIの来訪を3つの振る舞いに分けている。検索(Search)は、あとで質問に答えるために内容を集めたり索引に入れたりするもの。学習(Training)は、モデルの学習や調整のために内容を取り込むもの。エージェント(Agent)は、人に代わってリアルタイムで何かを済ませる自動の動きで、文書は「チャットの取得ボットや、ブラウザを操作するエージェント」を例に挙げる。この3分類と、9月15日に加わった設定の細かい違いは、当サイトのCloudflareが9月15日に加えた「AI学習だけを止める」設定 ── 検索に載せたまま止められる範囲と、今週確かめる6つに書いた。今回の発表は、その3分類のうち「エージェント」の中を、さらにエージェントごとに分けたものと読める(筆者の読み)。
利用者の質問で来る取得は、robots.txtの対象外になることがある
代理で来る取得で気をつけたいのは、robots.txtが想定通りに効かないことがある点だ。OpenAIは、ChatGPT-Userという名乗りについて、クローラーの説明ページに次のように書いている。
"Because these actions are initiated by a user, robots.txt rules may not apply."
(日本語訳: これらの動作は利用者が始めるものなので、robots.txtの規則が当てはまらないことがある。)
同じページは、ChatGPT-Userを「ウェブを自動で巡回するためには使われない」ものと説明し、検索の掲載の可否を決める用途にも使われないと書いている。検索の掲載を管理したいときの名乗りは、OAI-SearchBotである。つまり、robots.txtで「ChatGPT-Userを止める」と書いても、止まるとは限らない。ここが、検索用や学習用の来訪と、代理で来る取得の大きな違いである。
全部を止めると、顧客も止まるかもしれない
ブログは、エージェントを全部ブロックするのが安全に思えても、それは顧客を失うことにつながりうる、と書いている。たとえば、利用者が個人用エージェントに「この店の商品を比べて」「サポート記事を探して」「購入を済ませて」と頼むとき、サイト側から見ると、3つとも自動の通信として届く。見分けがつかないまま止めると、役に立つ来訪も、リスクのある来訪も、まとめて止まる。見分けることが先で、通すかどうかの判断はそのあとになる。
robots.txtは、アクセスを許可する仕組みではない
robots.txtの仕様であるRFC 9309は、冒頭近くに次の1文を置いている。
"These rules are not a form of access authorization."
(日本語訳: これらの規則は、アクセスを許可する仕組みではない。)
Cloudflareの文書も、「robots.txtの指示は任意で、クローラーは無視できる」という趣旨のことを書いている。robots.txtに書いた希望は、相手が守ることを前提にした「お願い」である。代理で来る取得に対して、お願いが届くのか、届いても守られるのかは、サイトの側からは分からない。分かるのは、ログに残った事実だけだ。
03 用語 — 出てくる言葉を、先にそろえる
この記事で繰り返し使う言葉を、先に3つ整理する。英語の名前は、画面の表示と照らせるように、そのまま残した。
用語: 個人用エージェント(Personal agents)
人の指示を受け取り、その人に代わってサイトに要求を送り、操作する自動のしくみ。ブログは「人とインターネットの間に立つ仲介者」と説明している。サイトから見ると、人ではなくエージェントが来る。
確認済みボット(Verified bot)
Cloudflareの文書によると、確認済みボットは、自分が誰で何をするかについて透明だとCloudflareが確かめた、ボットやエージェントである。条件は2つあり、自分の名乗りを暗号の署名、公開されたIPアドレスの一覧、逆引きなどで確実に示すこと、そして、robots.txtやクロールの指示を守り、取得の頻度が妥当で、サイトの希望を回避する様子が観察されていないことである。文書は、2026年7月1日から、署名つきのエージェントも確認済みになったと書く。
ハッシュ化された利用者ID(Hashed User ID)
Account Abuse Protectionの文書によると、これはゾーンごとの、暗号的にハッシュ化した識別子である。利用者が入力する主な認証情報を暗号化して、そのゾーンだけで通用する意味の分からない識別子に変える。個人を特定する情報をそのまま分析に使わずに、アカウントごとの動きを追うための仕組みである。
代理の取得
この記事では、利用者の指示に応じてその場で来る取得を、まとめて「代理の取得」と呼ぶ。Cloudflareの「Personal agents」と同じ範囲とは限らない。Cloudflareの区分は、同社の確認済みボットの一覧に基づくもので、ログから名乗りで数えた結果とは、一致しないことがある(筆者の読み)。
04 型別 — 適用範囲、この発表が測っていないこと、確かめる手順
適用範囲: 使っているサイトと、使っていないサイト
今回の機能は、Cloudflareの管理画面で動くものである。分析の区分と、エージェントごとの方針は、Cloudflareにドメインを置いているサイトが対象になる。Account Abuse Protectionは、前に書いたとおり、企業向け契約の先行利用である。Cloudflareを使っていないサイトには、画面そのものが存在しない。ただし、「代理で来る取得を分けて数える」「歓迎する相手と、そうでない相手を決める」という考え方は、どのサイトにも当てはまる。
| 機能 | 何ができるか | 対象と段階 | 原文に書かれていないこと |
|---|---|---|---|
| Security Analyticsの「Personal Assistants」 | 個人用エージェントの通信だけの推移、エージェントごとの要求数、取得パス、返したステータス、元のネットワーク | Cloudflareの管理画面(ブログの説明) | 対応プラン、エージェントの一覧 |
| AI Crawler and Agent access policies | 全体のAgents方針と、エージェントごとの許可・広告ページでブロック・ブロック | 管理画面のセキュリティ設定。新しいドメインの追加時にも選べる | エージェントごとの既定値(文書は全体の方針を引き継ぐと書く) |
| Account Abuse Protectionの表示 | ログインと会員登録の要求に、エージェントの有無と名前が付く。利用者IDでの制限 | 先行利用。Bot Managementの企業向け契約の顧客 | 一般提供の時期 |
この発表が測っていないこと
発表は、新しい機能の紹介で、個人用エージェントがどれだけ来ているか、どれだけ売上や損失に関わるかは、数字として示していない。ブログは、通信の増減の大きさではなく、見分けがつくようになること自体を価値として書く。したがって、「エージェントの来訪が急増している」という前提は、この記事の根拠にならない。自社のログで数えるのが、唯一の確かめ方である。
もう1つ、識別の精度も書かれていない。名乗りを見分ける方法はブログに書かれず、見分けられなかったエージェントがどれだけあるかも分からない。画面に出ない分は、「いない」ではなく「見分けられていない」と読む必要がある。
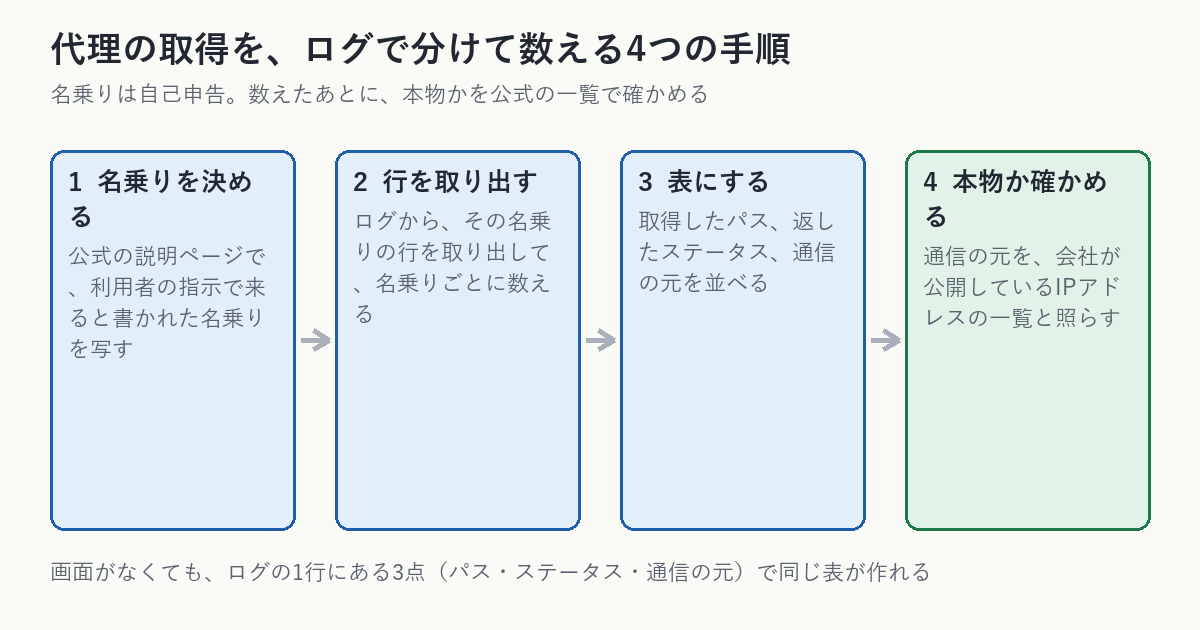
確かめる手順1: 代理で来る名乗りを決める
まず、担当サイトのログで探す名乗りを決める。OpenAIの説明ページでは、ChatGPT-Userが、利用者の質問や操作で動く名乗りとして書かれている。ほかの会社の名乗りは、それぞれの公式の説明ページで「利用者の指示で来る」と書かれたものを、1つずつ確かめて決める。当サイトのCloudflareが通信の半分以上は人間ではないと書いた週、当サイトのログで自動と分かるものは36.2%だった ── 他人の大きな数字を、自社のログ1週間分で数え直すでは、名乗りを6つに分け、その1つを「AIでユーザーの指示で動くもの」とした。分け方の参考になる。
実務のヒント
名乗りの一覧は、会社ごとの公式ページから写す。報道や他社のまとめの一覧は、古かったり、本物でない名乗りが混ざっていたりする。写した日付と、写した先のページの名前を、一覧の隣に書いておくと、あとで見直しやすい。
確かめる手順2: 取得したパスとステータスを並べる
名乗りごとに、どのパス(ページのアドレス)を取りに来たか、サーバーが何のステータスコードを返したか、通信の元はどこかを並べる。Cloudflareの画面が見せるのと同じ3点である。ログの1行にはこの3つが残っている。画面がなくても、同じ表は作れる。
確かめる手順3: 名乗りが本物かを確かめる
名乗りは、誰でも書ける。Cloudflareの確認済みボットの条件にも、IPアドレスの一覧や逆引きなどで自分の名乗りを確実に示すことが挙がっていた。担当サイトのログで同じことをするなら、OpenAIが説明ページで公開しているIPアドレスの一覧など、各社の公式の一覧と照らす。当サイトのCloudflareが確認済みのボットを「行儀」で評価し始めた週、当サイトの9つの名乗りの取得(4,317行)の18.1%は、公式のIPアドレスの一覧と合わなかった ── 14日分のログで数え直したは、その照らし方の記録である。
確かめる手順4: 通す相手を、3つの答えから選ぶ
数えた結果を見て、通すか止めるかを決める。Cloudflareの選択肢を借りるなら、「全部通す」「広告のあるページだけ止める」「全部止める」の3つである。広告で収益を得ているサイトと、そうでないサイトで、答えは変わる。ブログも、同じ代理のエージェントを、ある出版社は全体で歓迎し、別の出版社は広告を載せたページで止める、どちらも自社にとって正しい選び方になりうる、と書いている。
確かめる手順5: 決めたことを書き残す
決めた内容は、日付と理由を付けて残す。担当サイトの方針が書かれていないと、数か月後に「なぜこの設定なのか」が分からなくなる。当サイトでは、検索・学習・エージェントの3つとも通す方針を決めた日と理由を、ブログの末尾に追記してある。
05 明日、担当サイトで確認できること
以下は、担当サイトに来る代理の取得を、ログと設定で確かめて、方針を書き残すための13項目である。1〜4番目は名乗りの準備、5〜8番目はログでの数え方、9〜11番目は設定と方針、12〜13番目は残し方と見直しである。1項目は5分以内でできる。チェックの状態は、お使いのブラウザに保存され、サーバーには送られない。
- OpenAIの「Overview of OpenAI Crawlers」を開き、利用者の操作で来る名乗り(ChatGPT-User)の説明を書き写す
- Anthropic、Perplexityなど、担当サイトで気になる会社の公式の説明ページを2つ開き、利用者の質問で来る名乗りを書き写す
- 書き写した名乗りの隣に、ページの名前と開いた日付を書く
- 担当サイトを預かる会社が、Cloudflareを使っているか、管理画面を見られる人は誰かを確認する
- 直近7日分のアクセスログで、決めた名乗りの行が何行あるかを、名乗りごとに数える
- 名乗りごとに、取得したパスを上位10件並べる
- 名乗りごとに、返したステータスコード(200、403、404など)の件数を並べる
- 名乗りごとに、通信の元のIPアドレスを3つ選び、会社の公式の一覧に載っているかを確認する
- Cloudflareを使っているなら、セキュリティ設定の「AI Crawler and Agent access policies」を開き、Agentsの欄の値を書き写す
- 個人用エージェントごとの値が、全体のAgents方針と同じか違うかを、画面で確認する
- ログインや会員登録の画面があるなら、その画面への要求に代理の名乗りが混ざっていないかを、ログで3日分探す
- 通す・広告のあるページだけ止める・止めるの3つから、担当サイトの答えを選び、理由を1行書く
- 次に確認する日を決め、確認した日付と一緒に、方針の記録に書く
チェックが終わったら、名乗りごとの数と、選んだ方針の理由を1枚にまとめて、担当サイトの記録に残す。数字が1つもなくても、「数えて0だった」と日付つきで書くことが、次に見直す人への手がかりになる。
06 代替・他の選択肢 — 代理の取得への対応を、並べて比べる
代理の取得に対して、Cloudflareの設定以外にも選べる方法がある。それぞれの向き不向きを、次の表に整理した。比べ方は、筆者の整理である。
| 方法 | 向いている場面 | 注意 |
|---|---|---|
| Cloudflareの方針を使う | Cloudflareにドメインを置いていて、エージェントごとに通す・止めるを選びたい | 対応しているエージェントの範囲は、画面で確かめる。原文に一覧はない |
| robots.txtに書く | 相手が守ると公式に書いている名乗りに、希望を伝える | 利用者の操作で来る名乗りには、適用されないことがある。守るかは相手次第である |
| サーバーやCDNの規則で、名乗りとIPアドレスを見て通す・止める | 数えた結果を見て、はっきり止める相手を決めたとき | 名乗りは自己申告で偽装されうる。名乗りだけで決めず、公式の一覧と照らす |
| ログを数えるだけで、設定は変えない | まず現状を知りたい。方針が決まっていない | 数えて終わりにせず、次に見直す日を決める |
| 利用者向けの画面を、ログインの内側に置く | ログインが必要な内容を、代理の取得から守りたい | ログインの要求にも代理が混ざりうる。ログイン後の画面の保護は別に確かめる |
名乗りだけで決めない: 当サイトの過去の記事より
名乗りで判断することの危うさは、当サイトのログで確かめた経験がある。「AIクローラーが弾かれている」と読みかけた ── 日別に割ったら、正体は数十の名前を名乗る貸しサーバーだったは、AIの名乗りで大量の403が出ていると読みかけた日を、日ごとに割ったところ、1日に1台の貸しサーバーが多数の名前を使い分けたものだった、という記録である。名乗りは便利な手がかりだが、名乗りだけでは、人にもAIにも、本物かどうかを決められない。
解説記事で扱った近い話題
ログインと会員登録の異常を調べる同じ機能の考え方は、Cloudflareは、ログインと会員登録の異常をアカウント単位で調べる画面を先行利用の顧客に出した ── 同じ問いを自社の記録に当てて確認する13項目(2026年10月時点)に書いた。確認済みボットの評価は、Cloudflareは確認済みボットを、名乗りが本物かに加えて、robots.txtと429を守り続けているかでも評価し続ける仕組みを書いた ── 自分のサイトのrobots.txtと429がボットに読める形かを確認する13項目(2026年10月時点)で扱った。
ログインが必要な画面を守る手段の1つとして、当サイトには🔧 【セキュリティ】WEBサイトの 外からできるセキュリティ対策監査ツール★ミエルン — 外から見える設定を確かめるというツールがある(利用には無料の会員登録が必要です)。
07 当サイトで確かめたこと — 当サイトはCloudflareを使っていないので、画面ではなくログで見る
この記事のために、当サイトの設定は変えていない
当サイトはCloudflareを使っていないため、今回の分析の区分も、エージェントごとの方針の画面も、当サイトには存在しない。この記事の手順は、担当サイトで確かめる手順として書いた。当サイトの検索・学習・エージェントの3つを通す方針は、ブログCloudflareが9月15日に加えた「AI学習だけを止める」設定 ── 検索に載せたまま止められる範囲と、今週確かめる6つの末尾に書いたとおりで、今回の発表を読んでも変えていない。
以前のログの数え方と、この記事の関係
当サイトは、ブログ156で10月5日から12日までのHTTPSのログ46,929行を、名乗りで6つに分けて数えた。その中の「AIでユーザーの指示で動くもの」(ChatGPT-User、Claude-User、Perplexity-User、MistralAI-User)は232行で、全体の0.5%だった。ただしこれは、名乗りだけで分けた数字で、名乗りが本物かは確かめていない。Cloudflareの「Personal agents」とも、範囲が一致するとは限らない。この記事のために、当サイトのログを新しく数え直してはいない。
次に数えるときは、ブログ156の手順に加えて、取得したパスと返したステータスを名乗りごとに並べたい。その結果は、この記事に日付つきで追記する。
08 このテーマは、ここまで — 来訪の分け方と、名乗りの確かめ方を、どう積み上げてきたか
これまでの記事
- Cloudflareは、ログインと会員登録の異常をアカウント単位で調べる画面を先行利用の顧客に出した ── 同じ問いを自社の記録に当てて確認する13項目(2026年10月時点) — 同じ先行利用の、ログインと会員登録を調べる画面
- Cloudflareは確認済みボットを、名乗りが本物かに加えて、robots.txtと429を守り続けているかでも評価し続ける仕組みを書いた ── 自分のサイトのrobots.txtと429がボットに読める形かを確認する13項目(2026年10月時点) — 確認済みボットの条件
- Googlebotの名乗りは誰でも書ける。通す・止めるを名乗りだけで決めず、接続元で確かめる ── 自分のサイトの判定を点検する13項目(2026年10月時点) — 名乗りを接続元で確かめる考え方
- CloudflareのPay Per Useは「申し出を受けるか決める」仕組みで、サーバー側の変更は要らない ── 判断の前にAIボットの設定と来訪を確認する13項目(2026年10月時点) — 通す・止めるを決める前の確かめ
- Cloudflareの「Agents aren’t humans」は、代理で動くAIの課題14個を挙げ、顧客が今日使える3つの手順と、これから出る提案を分けて書いた ── 提案と出荷済みを分けて読み、担当サイトで変えることを決める13項目(2026年11月時点) — 今回の発表の背景にある、提案と出荷済みの読み分け
- 「守る」から「見分ける」へ ── Cloudflare Precursor GAが変えるbot対策と、WEBディレクターが今週確認すべき3点 — 守るから見分けるへの流れ
注意
この記事は、2026年11月6日に確かめた内容に基づく。Cloudflareの画面や文書は変わりうる。設定を変える前に、自社の画面と、最新の文書で確かめること。
現在の貴方のIPアドレス
このサイトで書いている人
