WEBサイト
AIに引用される記事の書き方 ── 公式情報で確かめる、効くこと・効かないこと(2026年8月時点)
AIに引用される記事の書き方 ── 公式情報で確かめる、効くこと・効かないこと(2026年8月時点)
目次
01 いま最新版は何か — Googleは「別のランキングは無い」と明言した
2026年7月更新の公式ガイド
「AIに引用されやすい書き方」を調べようとすると、数字を伴う解説記事に数多く出会います。ですが、まず確認すべき一次情報があります。Google Search Centralは2026年5月、AI検索機能への最適化を専門に扱うページを新設しました(A new resource for optimizing for generative AI in Google Search(訳: 生成AI向け最適化のための新リソース))。このガイドは2026年8月時点で7月10日付の更新が最新版です。本記事は、この公式ガイドと、OpenAI・Anthropicが公開しているクローラー仕様という一次情報だけを土台に、「記事の書き方」として実際に確認できることを整理します。
「AI専用のランキング」は存在しない
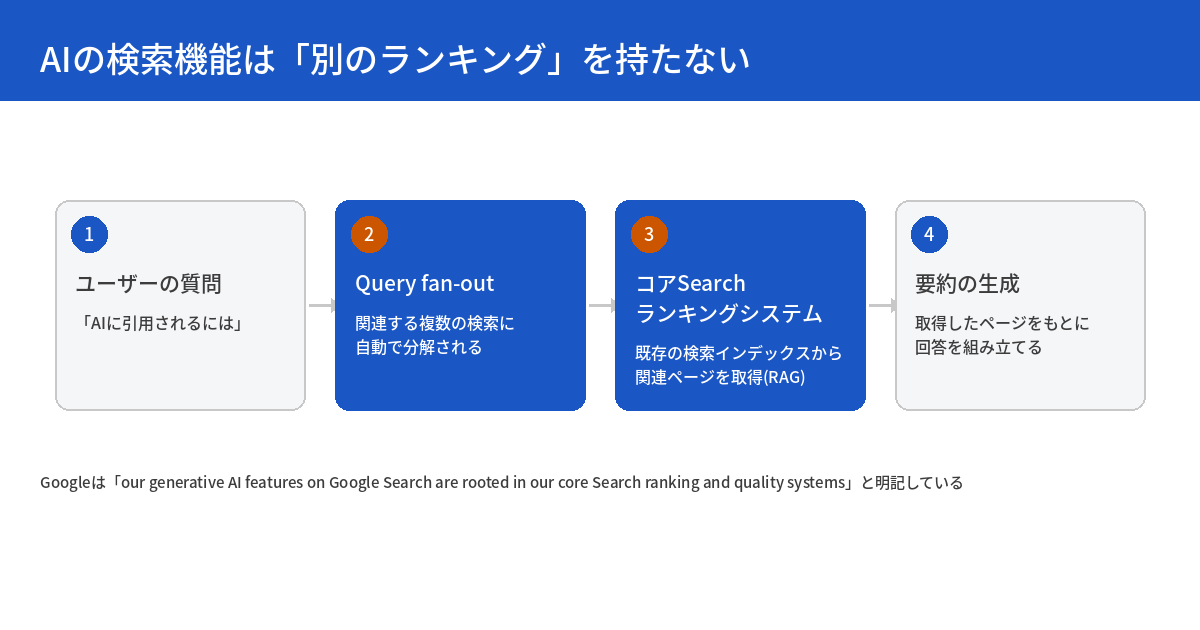
このガイドがまず明記しているのが、AI検索機能の仕組みです。「our generative AI features on Google Search are rooted in our core Search ranking and quality systems(訳: Google検索における生成AI機能は、当社のコアとなる検索ランキング・品質システムに根ざしている)」と書かれており、AI Overviews・AI Modeが通常の検索結果とは別に独自のランキングを持っているわけではないことがわかります。技術的な仕組みはRAG(検索拡張生成)と呼ばれる方式です。ユーザーの質問は1つの検索語に固定されるのではなく、関連する複数の検索クエリに自動で分解されます。この仕組みはクエリのファンアウト(query fan-out)と呼ばれ、ガイドは「a set of concurrent, related queries generated by the model to request more information and fetch additional relevant search results(訳: モデルが生成する、追加情報を要求し関連する検索結果をさらに取得するための、同時並行的な関連クエリの集合)」と定義しています。当サイトでは、ChatGPTが1回の質問あたりに実行する検索回数(ファンアウトクエリ)とsite:検索の利用率が急増している実測を以前まとめていますが(ChatGPTのsite:検索が急増 — 公式ドメインとして正しく認識されるために確認する14項目)、同じ仕組みがGoogle側の一次情報としても確認できたことになります。1つの質問に対して裏側で複数の検索が走るということは、記事が引用されるかどうかは「その1問にどう答えるか」だけでなく、「派生する周辺の質問にも答えられているか」に左右される、ということでもあります。
02 なぜ・背景 — 「AI向けの裏技」が成立しにくい理由
業界で語られる数字と、公式の記述の隔たり
「AIに引用されやすくなる書き方」を検索すると、「構造化データを追加すると引用率が上がる」「見出しをQ&A形式にすると選ばれやすい」といった、具体的な数字を伴う主張に多く出会います。こうした主張の多くは、SEO事業者や解析ツールベンダーが独自に集計した調査にもとづくもので、調査そのものが誤りとは限りません。ただし、01章で確認したGoogle公式ガイドの記述と照らし合わせると、断言できることと、まだ断言できないことの境界がはっきり見えてきます。
出典
Google Search Centralの公式ガイドは、構造化データについて「Structured data isn't required for generative AI search, and there's no special schema.org markup you need to add(訳: 構造化データは生成AI検索において必須ではなく、追加すべき特別なschema.orgマークアップは存在しない)」と明記しています。同様に、機械可読ファイルについても「You don't need to create new machine readable files, AI text files, markup, or Markdown to appear in Google Search (including its generative AI capabilities)(訳: Google検索(その生成AI機能を含む)に表示されるために、新しい機械可読ファイル・AIテキストファイル・マークアップ・Markdownを作成する必要はない)」と述べています。
「必須ではない」は「無意味」ではない
ここで注意したいのは、Googleの「required(必須)ではない」という表現の射程です。これは「schema.orgマークアップを追加しなくてもAI検索機能の対象になれる」という意味であって、「構造化データがまったく評価されない」という意味ではありません。当サイトが以前整理したとおり、Googleは2026年5月の一次文書で、コンテンツの細分化(chunking)・機械可読ファイルの量産・構造化データの乱造といった、非推奨のGEO施策をまとめて否定しています(archives/79)。機械可読ファイル単体についても、Googleが「不要」と断言した経緯を別途まとめたことがあります(archives/60)。本記事はその続きとして、「では何を書けば良いのか」という書き方の側に焦点を当てます。
「73%高い選択率」「引用率が◯%上がる」のような数字を見かけたときの確認手順は単純です。まず、その数字の出所が一次情報(サービス提供元の公式発表)か、第三者による独自調査かを見分けます。次に、第三者調査であれば、調査対象の件数・期間・測定方法が明記されているかを確認します。これらが明記されていない数字は、参考程度に留め、記事の主張の根拠として引用しないのが安全です。
| よく語られる主張 | 公式ガイドで確認できること |
|---|---|
| 構造化データを足すと引用率が上がる | 「必須ではない」と明記。効果の数値は公式には示されていない |
| 機械可読ファイルを設置すべき | 「作成する必要はない」と明記 |
| コンテンツを細かく分割(chunking)すべき | 特別な分割は不要とされる(archives/79参照) |
| 見出しと段落で構造化する | 「organized by paragraphs and sections」と明記。推奨されている |
03 この記事で出てくる用語
RAG(検索拡張生成)とは
用語
RAG(検索拡張生成):AIが回答を生成する際、あらかじめ学習した知識だけに頼らず、検索によって取得した外部情報を参照しながら回答を組み立てる方式です。01章で触れたとおり、Google検索の生成AI機能はこの方式で動いており、既存の検索インデックスに載っていないページは、そもそも参照される対象になりません。
E-E-A-Tとは
用語
E-E-A-T:Experience(経験)・Expertise(専門性)・Authoritativeness(権威性)・Trustworthiness(信頼性)の頭文字です。Google公式ガイド(Creating Helpful, Reliable, People-First Content(訳: 役に立ち、信頼でき、人を第一に考えたコンテンツを作成する))は、この基準にもとづいたコンテンツ作成を、生成AI機能を含む検索全般の前提として求めています。
この4要素を記事の書き方に落とし込むと、次のようになります。Experience(経験)は、03章で触れた一次体験の記述として、「実際に確認した」「当サイトで測定した」といった一人称の言葉で表れます。Expertise(専門性)とAuthoritativeness(権威性)は、著者情報や監修者情報を記事内に明示することで示せます。Trustworthiness(信頼性)は、本記事がここまで行ってきたように、主張の一つひとつに一次情報への出典リンクを添えることで担保します。05章のチェックリスト7番目・8番目の項目は、この4要素のうち著者情報と更新日という、記事単位で確認できる部分に対応しています。
「一次情報」と「まとめ」の違い
Googleのガイドが特に強調しているのが、一次体験と要約の違いです。原文では「a first-hand review provides a unique perspective based on personal experience, whereas a summary of existing content simply restates information(訳: 一次レビューは個人の経験にもとづく独自の視点を提供するが、既存コンテンツの要約は単に情報を焼き直しているにすぎない)」と述べられています。他サイトの内容を言い換えただけの記事と、自分で確認した事実・数字・手順を書いた記事は、AIにとって別の価値を持つという指摘です。
構造化データとは
用語
構造化データ:ページの内容が何であるかを、検索エンジンが機械的に読み取れる形式で明示するマークアップです(Intro to How Structured Data Markup Works(訳: 構造化データマークアップの仕組み入門))。02章で確認したとおり、生成AI機能への表示を目的とした特別な追加は不要とされていますが、リッチリザルト表示など従来の検索結果における効果は別に存在します。
クローラーとファンアウトクエリ
01章で触れたファンアウトクエリのほか、本記事ではクローラーという言葉が繰り返し出てきます。クローラーとは、検索エンジンやAIサービスがWebページを巡回して内容を取得するプログラムのことです。06章で扱う3社のクローラーは、この「巡回して取得する」役割を担っています。クローラーが取得できないページは、01章のRAGの土台となる検索インデックスにそもそも載らないため、書き方以前の前提条件として押さえておく必要があります。
04 型別 — 適用範囲・限界・手順
🅰 適用範囲 — このガイドが当てはまるサイト・当てはまらないサイト
本記事の内容は、記事型のコンテンツ(解説記事・ハウツー・レビュー等)を継続的に発信しているサイトに当てはまります。ECサイトの商品ページのように、ページ内容が価格や在庫といった短い事実の集合である場合、03章の「一次情報」「一次体験」という観点はそのままでは適用しにくく、構造化データによる商品情報の明示のほうが優先度は高くなります。まずは自分のサイトが「記事でAIに知ってもらいたい情報」を発信しているかどうかを、最初に確認しておく価値があります。逆に、社内マニュアルや業務ノウハウのように、自社にしか無い一次情報を持つ立場のサイトほど、本記事の内容がそのまま効きます。
🅱 Googleが「不要」と明言したこと一覧
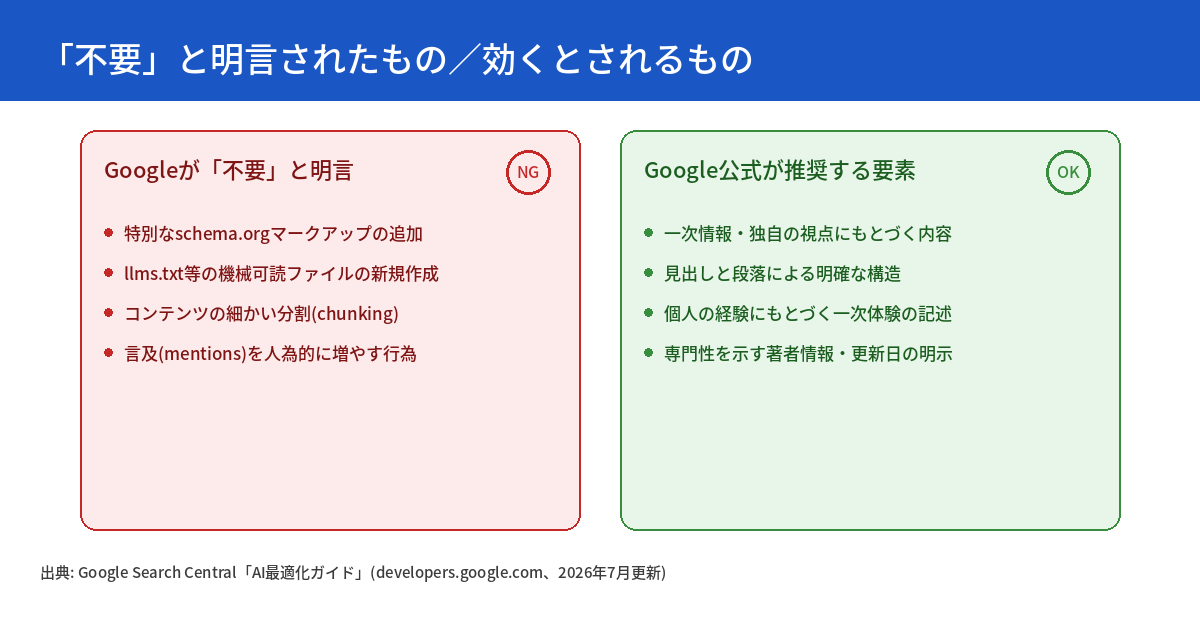
02章の一次情報を踏まえ、記事を書く前に「やらなくていい」と判断できることをまとめます。特別なschema.orgマークアップの新規追加、機械可読ファイルの新規作成、コンテンツを細切れに分割する構成、そして言及(mentions)を人為的に増やす行為の4点です。これらに時間を使う前に、05章のチェックリストにある「一次情報の明記」「見出しと段落の構造化」に時間を使うほうが、公式ガイドの記述に沿った優先順位になります。
「GEO対策」と「従来のSEO対策」を別物として比較したくなりますが、ここまでの一次情報を整理すると、両者の境界は次の3種類に分けられます。
| 分類 | 該当する施策 |
|---|---|
| 両者に共通 | 一次情報・専門性の明示、見出しと段落による構造化、E-E-A-T |
| GEOとして 語られるが未実証 | 構造化データ追加による引用率向上、コンテンツのchunking、機械可読ファイルの設置 |
| 従来SEO 固有の効果 | リッチリザルト表示のための構造化データ、robots.txtによる学習用クローラーの個別制御 |
注意
「不要」は「効果がゼロ」を意味しません。構造化データは検索結果のリッチリザルト表示など、AI検索機能とは別の効果を持つため、意味が無いわけではありません。あくまで「AIに引用されるために特別な対応をする必要はない」という優先順位の話です。
🅲 手順 — 一次情報の提示から見出し設計までの4段階
実際の執筆は、次の4段階で進めると02章・03章の観点を漏れなく反映できます。第一に、記事のテーマについて自分(または自社)が確認できる一次情報・一次体験を洗い出す段階。第二に、その一次情報を裏付ける出典(公式ドキュメント・一次データ)を明記する段階。第三に、見出しと段落を、質問とその答えが1つの見出しの中で完結するように設計する段階。第四に、05章のチェックリストで著者情報・更新日・出典の3点が揃っているかを確認する段階です。
よくある失敗パターン
実務でよく見られる失敗が、結論を書かずに情報を並べるだけで終わる記事です。「A社の調査によるとX%、B社の調査によるとY%」という数字の羅列で終わり、「では自分のサイトはどちらを信じて、何を確認すればよいか」という着地点が書かれていないケースです。03章で触れた「一次体験」の観点に立てば、複数の情報を集めた上で自分なりの結論(あるいは「まだ分からない」という誠実な結論)を書くところまでが、一次情報としての価値になります。もう1つの失敗が、見出しだけを質問形式にして、直後の段落に答えを書かずに背景説明から始めてしまうパターンです。読者にとってもAIにとっても、見出しの直後の1〜2文に結論が無いと、その見出しが何を答えているのか判断しづらくなります。
05 自分の記事で確認するチェックリスト
チェックリストの4つの観点
ここまでの内容を、執筆時に手を動かせる作業に翻訳しました。観点は、一次情報・出典の明記、見出しと段落の構造、著者情報・更新日、クローラーの許可設定の4つに分かれます。チェックの状態はブラウザ内にのみ保存され、サーバーには送信されません。
実務のヒント
構造化データを整備したい場合は、当サイトの🔧 構造化データ自動作成ツールでたたき台を作成できます。02章で確認したとおり必須ではありませんが、リッチリザルト表示等の副次効果は残ります。
- 公開しようとしている記事の主題について、自分(または自社)が実際に確認した事実・数字が1つ以上含まれているか確認する
- 記事中に挙げた数字・主張について、一次情報(公式ドキュメント・公式発表)へのリンクが貼られているか確認する
- 他サイトの内容を要約しただけの段落が無いか、記事を上から通しで読んで確認する
- 各見出し(h2・h3)を声に出して読み、それ単体で「何についての節か」が分かるか確認する
- 各h3見出しの直後の段落に、その見出しに対応する結論が書かれているか確認する
- 記事内の主要な情報を3行以内の表または箇条書きに変換できる箇所が無いか見直す
- 記事ページに著者情報(または監修者情報)が表示されているか確認する
- 記事ページに公開日・更新日が明示されているか確認する
- 記事の結論として「何をすべきか」が最後の見出しに書かれているか確認する
- robots.txtを開き、GPTBot・OAI-SearchBot・ClaudeBot・Claude-SearchBotを個別にDisallowにしていないか確認する
- 記事ページをHTTPで取得し、本文の主要な文章がHTML内にテキストとして存在するか確認する
- Search Consoleの「検索結果」レポートを開き、生成AI機能内の表示状況を確認できるか確かめる
- 1年以上前に公開した記事を1本選び、出典リンクが今も生きているか確認する
13項目の内訳とかかる時間
最初の3項目は一次情報・一次体験の有無、次の5項目は見出しと構造の設計、続く2項目は著者情報と結論、最後の3項目はクローラーとデータの技術的な確認に対応しています。すべてに目を通す時間の目安は1記事あたり20分程度です。新規記事の執筆時はもちろん、過去記事の見直しにもそのまま使えます。特に10番目の項目(クローラーの許可設定)は、記事単体では変えられない設定であることが多いため、月に1回まとめて確認する運用が現実的です。
06 検索AI 3社、クローラーの役割比較
「学習用」と「検索用」は別のクローラー
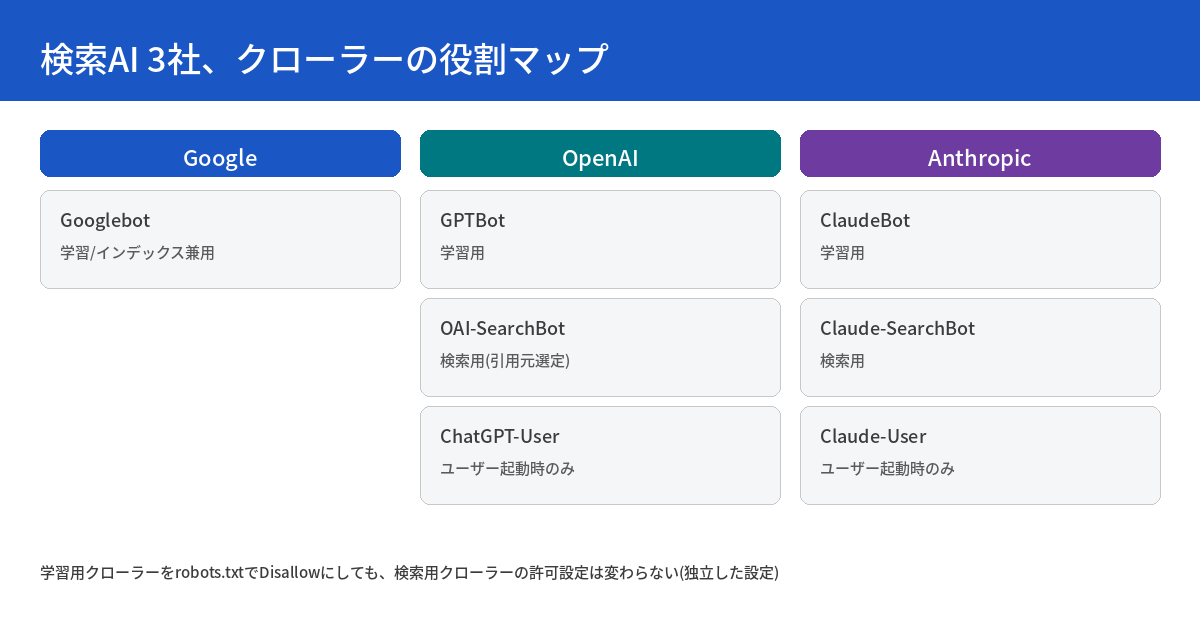
05章のチェックリストで触れたとおり、AI各社は学習用と検索用のクローラーを分けて運用しています。この区別を知らずに「AIクローラーは全部同じ」と考えて一律にDisallowにすると、意図せず検索機能からの引用も止めてしまうことがあります。OpenAIの公式クローラー仕様(Overview of OpenAI Crawlers(訳: OpenAIクローラーの概要))は、この違いを明確に切り分けています。
| クローラー名 | 提供元 | 役割 |
|---|---|---|
| Googlebot | 学習・検索インデックス兼用 | |
| GPTBot | OpenAI | モデルの学習データ収集用 |
| OAI-SearchBot | OpenAI | ChatGPT検索機能での引用元選定用 |
| ChatGPT-User | OpenAI | ユーザーが質問した際にその場で1ページを取得 |
| ClaudeBot | Anthropic | モデルの学習データ収集用 |
| Claude-SearchBot | Anthropic | Claude検索機能での引用元選定用 |
| Claude-User | Anthropic | ユーザーが質問した際にその場で1ページを取得 |
robots.txtで個別にブロック・許可できる
OpenAIの公式仕様は「Disallowing GPTBot indicates a site's content should not be used in training generative AI foundation models(訳: GPTBotをDisallowにすることは、そのサイトのコンテンツを生成AI基盤モデルの学習に使用すべきでないことを示す)」とし、学習用クローラーの拒否と「Sites that are opted out of OAI-SearchBot will not be shown in ChatGPT search answers, though can still appear as navigational links(訳: OAI-SearchBotをオプトアウトしたサイトはChatGPTの検索回答には表示されなくなるが、ナビゲーション用のリンクとしては表示されうる)」とする検索用クローラーの拒否を、明確に別の設定として扱っています。Anthropicも同様に、ClaudeBot・Claude-SearchBot・Claude-Userをそれぞれ個別のuser-agentとして公開しており(Crawling Claude bots(訳: Claudeボットのクロールについて))、「学習には使ってほしくないが、検索の引用元としては表示されたい」という設定も技術的には可能です。逆に、検索用クローラーを許可したからといって、そのコンテンツが自動的にモデルの学習データに使われるわけではありません。学習用と検索用は、公開されているuser-agent名からして別物であり、片方の許可・拒否がもう片方に影響することはありません。
ユーザー起動型クローラーはrobots.txtの対象外になりうる
ChatGPT-UserとClaude-Userには、共通する特徴があります。OpenAIの仕様は「Because these actions are initiated by a user, robots.txt rules may not apply(訳: これらの動作はユーザーによって開始されるため、robots.txtのルールが適用されない場合がある)」と明記しています。ユーザーが「このURLの内容を教えて」とAIに直接貼り付けた場合、robots.txtの設定に関わらずページが取得されうるという意味です。robots.txtは「巡回して集める」段階を制御する仕組みであり、「ユーザーが個別に指定したURLを開く」動作までは制御できません。
07 当サイトの実測
robots.txtは各社のAIクローラーを個別にDisallowしていない
このガイドを書く過程で、当サイトのrobots.txtを実際に確認しました。GPTBot・OAI-SearchBot・ChatGPT-User・ClaudeBot・Claude-SearchBot・Claude-Userのいずれについても、user-agentを指定した個別のDisallow行は存在せず、全クローラーに対して同一のAllow設定が適用されています。06章で整理した「学習用と検索用を分けて設定できる」という選択肢自体は使わず、「まず許可して、実測して判断する」という方針を取っている状態です。
05章のチェックリストを自己適用した結果
05章のチェックリストを当サイトの直近記事に当てはめると、出典へのリンク・著者情報・更新日の明示・見出し単体での完結性という項目はテンプレート側で機械的に満たされる設計になっている一方、「一次情報・一次体験が1つ以上含まれているか」という最初の項目だけは、記事ごとに手作業で確認する必要がある項目として残りました。テンプレートで担保できる項目と、執筆のたびに人が判断する項目が分かれていることが、実際に当てはめてみて初めてはっきりしました。「型で担保できる部分」と「毎回書く人が確かめる部分」を分けて考えることは、05章のチェックリストを他のサイトで運用する際にも応用できる視点です。
出典
Search Consoleには、生成AI機能内での表示状況を確認できるレポートが用意されています。Google Search Central Blogは2026年6月、「Search Generative AI performance reports」という名称でこの機能の提供開始を告知しました(Introducing Search Generative AI performance reports in Search Console(訳: Search ConsoleにおけるAI検索パフォーマンスレポートの提供開始))。05章のチェックリスト12番目の項目は、このレポートの存在を前提にしています。
08 このテーマの、これまで
Googleが公式に否定したGEO施策を整理した回
02章で触れたとおり、Googleが2026年5月にchunking・機械可読ファイルの量産・構造化データの乱造を否定した経緯は、以前まとめたことがあります(archives/79)。本記事は、その「やらなくていいこと」の先にある「では何を書けばいいか」を扱っています。
Cloudflareのデフォルト設定が意図せずAIクローラーを遮断していた回
06章で扱ったクローラーの許可設定は、robots.txtだけで完結しない場合があります。Cloudflareの新規ドメインでは「AI botブロック」がデフォルトでONになる仕様変更があり、robots.txtとは無関係のインフラ層でAIクローラーが遮断されていた事例を検証したことがあります(archives/86)。07章の「当サイトの実測」も、robots.txtの確認だけでなくこの層まで含めた点検が本来は必要です。
大手メディアのクローラー遮断検討を追った回
07章で「まず許可して、実測して判断する」という当サイトの方針に触れましたが、この方針の背景にある議論を以前まとめたことがあります(archives/121)。大手メディアがGoogleクローラーの遮断を検討する一方で、遮断しなかったメディアのトラフィックが伸びていた事例です。
現在の貴方のIPアドレス
このサイトで書いている人