WEBサイト
ChatGPTのsite:検索が急増 ── 公式ドメインとして正しく認識されるために確認する14項目(2026年8月時点)
ChatGPTのsite:検索が急増 ── 公式ドメインとして正しく認識されるために確認する14項目(2026年8月時点)
目次
01 いま何が起きているか — ChatGPTのsite:検索が急増している
「GPT 5.6」採用後、1回の質問で検索する回数が倍以上に増えた
2026年8月18日、海外SEO情報ブログを運営する鈴木謙一氏が、ChatGPTの挙動の変化について実測を伴う記事を公開しました。ChatGPTがGPT 5.6を採用した最新モデルへの切り替えを機に、1つのプロンプトに対して裏側で実行する検索回数(ファンアウトクエリ)が劇的に増えているという内容です。
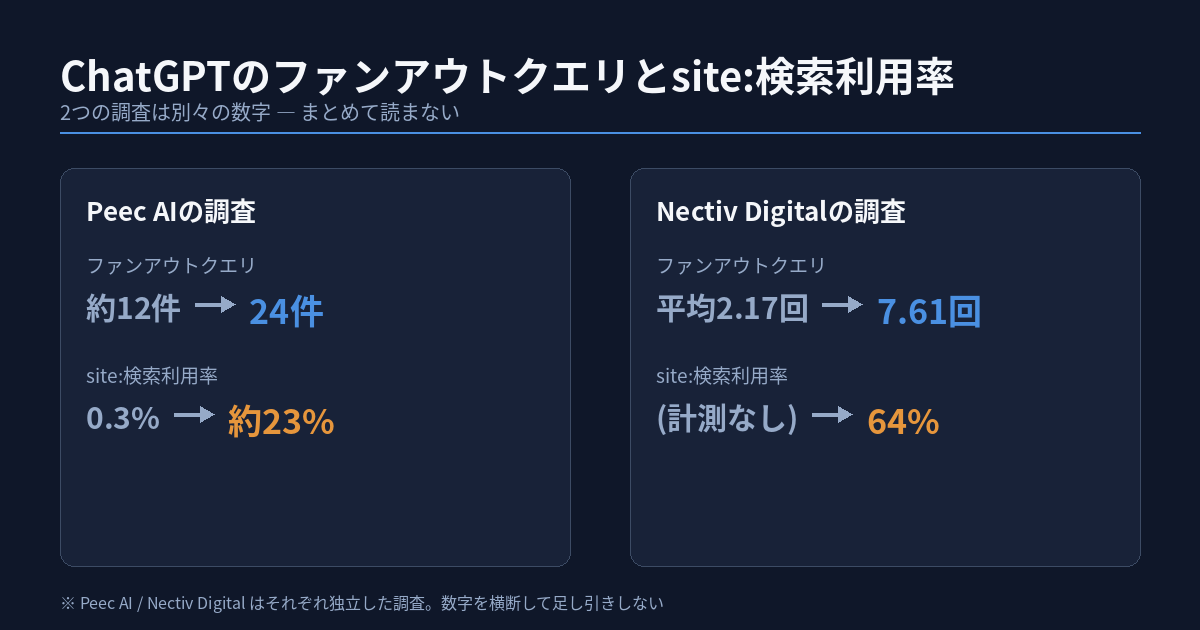
複数の分析機関がそれぞれ独立に数値を報告しています。Peec AIの調査では、ファンアウトクエリの回数が約12件から24件へ倍増したとされます。Nectiv Digitalの調査では、平均2.17回から7.61回まで増えたと報告されています。どちらも「同じ現象」を指していますが、調査対象や測定方法が異なるため、この2つの数字をそのまま足し引きして比較することはできません。別々の調査が、別々の切り口で同じ方向の変化を報告している、という読み方が正確です。
site:検索の利用率も跳ね上がった
回数が増えただけでなく、その検索の中身も変わりました。ファンアウトクエリのうち、特定のドメインに絞り込むsite:検索演算子が使われる割合について、Peec AIの調査は0.3%から約23%へ、Nectiv Digitalの調査は64%に達したと報告しています。この2つの数字も別の調査であり、単純に並べて「0.3%から64%になった」と読むのは誤りです。ただし方向性は共通しており、ChatGPTが「どこを調べるか」を自分であらかじめ絞り込む挙動を強めていることは、複数の独立した観測から裏づけられています。
引用されるドメインの数は、むしろ減っている
検索の回数が増える一方で、実際に回答へ引用されるドメインの種類は絞り込まれる方向に動いています。Resoneoの調査では、1つの回答が参照するユニークなドメイン数が19から15へ減少したと報告されています。検索する範囲は広がっているのに、最終的に選ばれる情報源は少数に集約される。ここに、この記事で扱う本題があります。探される回数が増えることと、選ばれる可能性が上がることは、別の話だということです。
用語
ファンアウトクエリ:AIが1つの質問に答えるために、内部で自動生成して実行する複数の検索クエリのことです。利用者には見えない処理ですが、AIモードやAI Overviewsと同様、ChatGPTの回答生成でもこの仕組みが使われていると各社の分析で報告されています。1回の質問の裏側で、実際には10件を超える検索が行われることも珍しくありません。
実際に引用されるのは、取得したページの一部だけ
SEOコンサルタントのSuganthan Mohanadasan氏による分析では、ChatGPTが取得(フェッチ)したページのうち、実際に回答の根拠として引用される割合は約3.1%にとどまるとされています。検索して見つかった情報のほとんどは、回答の材料として取得されても、最終的な引用リンクとしては採用されていない計算になります。取得されることと、引用されることの間には、大きな落差があります。
02 なぜ・背景 — ChatGPTは何を基準にサイトを絞り込むのか
クエリの種類によって「先に信頼する場所」が変わる
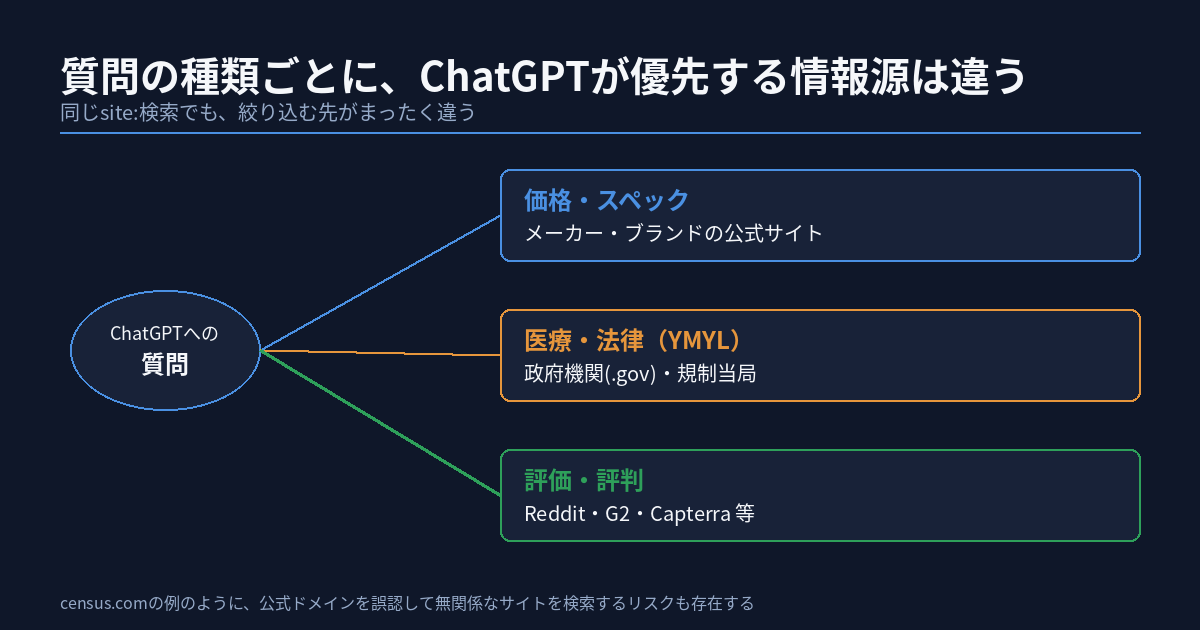
鈴木氏の記事によれば、ChatGPTは質問の種類に応じてあらかじめ信頼しているソースへ検索対象を絞り込む挙動を見せています。価格やスペックを尋ねる質問では、メーカーやブランドの公式サイトが優先されます。医療や法律などYMYL(お金や人生に影響する)領域の質問では、政府機関(.govドメイン)や規制当局のサイトが優先されます。評価や評判を尋ねる質問では、Reddit・G2・Capterra・Consumer Reportsといった第三者の口コミサイトが優先の対象になります。同じ「site:検索」でも、質問の性質によって絞り込む先がまったく違う、という点が実務上の要点です。
ブランド名は、指定していなくても自動で挿入される
もう1つ見落とせないのが、利用者がプロンプトの中でブランド名を指定していなくても、ChatGPTが最初の検索クエリに主要ブランド名を自発的に挿入するという挙動です。「おすすめのCRMツール」のような一般名詞だけの質問でも、内部的には特定のブランド名を含んだ検索が最初に実行される可能性があります。そして、この最初のクエリにブランド名が含まれていた場合の引用率は68.9%に達する一方、後から取得されただけのページが引用される確率は2.1%にとどまると報告されています。ブランドとして早い段階で認識されるかどうかが、最終的な引用の可否を大きく左右しています。
ドメインを誤認するリスクが実在する
ここに、公式サイト運営者にとって見過ごせないリスクがあります。ChatGPTがブランドの正確な公式ドメインを把握していない場合、同名のパーキングドメイン(取得だけされて使われていないドメイン)や無関係なドメインに対してsite:検索を実行してしまう危険性があると、鈴木氏の記事は指摘しています。実例として挙げられているのが、スタートアップ企業「Census」に対して、無関係なcensus.comというドメインを検索してしまうケースです。企業名とドメイン名が一致しない、あるいは似た名前の別サイトが存在する場合、この種の誤認は起こり得ます。
注意
この誤認リスクは、企業側が対策を怠っているから起きるわけではありません。ドメイン名とブランド名が異なる歴史的経緯を持つ企業や、社名変更・ブランド刷新を経た企業では、AI側が古い呼称や類似名で検索してしまう可能性があります。次の04章で、この誤認が自分のサイトで起きていないかを確認する方法を扱います。
Google検索の仕組みとの共通点
この「取得した情報を根拠に回答を組み立てる」という設計は、ChatGPT特有のものではありません。Google Search Centralの公式ガイドGoogle's Guide to Optimizing for Generative AI Features on Google Search(訳: Google検索における生成AI機能の最適化に関するGoogleガイド)も、AIモードやAI Overviewsの回答が、あらかじめ検索・取得した外部情報を根拠に生成される仕組み(RAG)で作られていると説明しています。検索してから答えを組み立てるという設計思想そのものは、Google・OpenAIを問わず共通しており、「検索される前に、信頼できる情報源として認識されているか」が、各社共通の分岐点になっています。
興味深いことに、GoogleのAI機能に関する公式ドキュメント「AI Features and Your Website」(訳: AI機能とあなたのウェブサイト)は、AI OverviewsやAI Modeへの掲載に追加の最適化要件は必要ないと明記しています。一方、鈴木氏の記事が伝えるChatGPTの挙動は、公式ドメインとしての認識というブランド側の準備が引用可否を左右することを示しています。同じ「検索して答える」設計でも、各社が何を重視するかには違いがある、という点は覚えておく価値があります。
03 この記事で出てくる用語
ファンアウトクエリとsite:検索演算子
用語
ファンアウトクエリ:AIが1つの質問に答えるために内部で自動生成・実行する複数の検索クエリ(01章参照)。site:検索演算子:特定のドメインやURLプレフィックスに絞り込んで検索する演算子です。Google公式ドキュメントSearch operators you can use with Google Search(訳: Google検索で使用できる検索演算子)は、サイト運営者がインデックス状況を確認する用途で使われるものだと説明しています。ChatGPTが内部処理として同じ演算子を使っている点が、この記事のテーマです。
「site:検索が0件」は、未掲載の証明にならない
ここで、当サイトが以前扱った内容と接続しておく必要があります。archives/130で検証したとおり、Google公式はsite:演算子について"The site: operator doesn't necessarily return all the URLs that are indexed under the prefix specified in the query."
(訳: site:演算子は、クエリで指定されたプレフィックス配下でインデックスされている全てのURLを、必ずしも全て返すとは限りません。)と明記しています。
注意
この注意点は、Google検索のsite:演算子について書かれたものですが、ChatGPTが内部処理で使うsite:検索にも同じ道具的な限界が及ぶ可能性があります。「site:自社ドメインで0件だったから、AIに存在を認識されていない」と即断するのは早計です。05章のチェックリストで、断定する前に確認すべき手順を扱います。
公式ドメインの認識(ブランドエンティティ)
用語
公式ドメインの認識:ある企業名・ブランド名と、特定のドメインが「同一のものである」とAIや検索エンジンに正しく結びつけて理解されている状態を指します。この記事では、Organization構造化データのurl・sameAsプロパティ、フッターや会社概要ページの明記など、この結びつきを補強する具体的な手段を07章で扱います。
パーソナライゼーション
ChatGPTでの手動確認には、利用者のアカウント状態や過去の会話履歴によって回答内容が変わる可能性がある点にも注意が必要です。同じ質問を1回試しただけで「引用された/されなかった」と判断せず、複数回、可能であれば別アカウントや別ブラウザでも試すことをおすすめします。この点は、当サイトが以前archives/19で扱った、検索結果のパーソナライゼーションと同じ構造の注意点です。
04 何が確認でき、何がまだ確認できないか
🄰 適用範囲 — どのクエリで・どの程度起きているか
今回扱った実際に測った値は、複数の第三者機関が独自に集計したサンプルに基づくものです。鈴木氏の記事自身が明記しているとおり、これはChatGPTのGPT 5.6モデルにおける挙動の観測であり、今後のモデル更新で挙動が変わる可能性があります。また、site:検索への絞り込みが強まる傾向は価格・仕様、YMYL、評判といった特定の質問タイプで顕著に報告されていますが、すべての質問タイプで同じ強さで起きているとは述べられていません。自社の業種・扱う情報の性質によって、影響の大きさは変わります。
🄱 この調査が測っていないこと
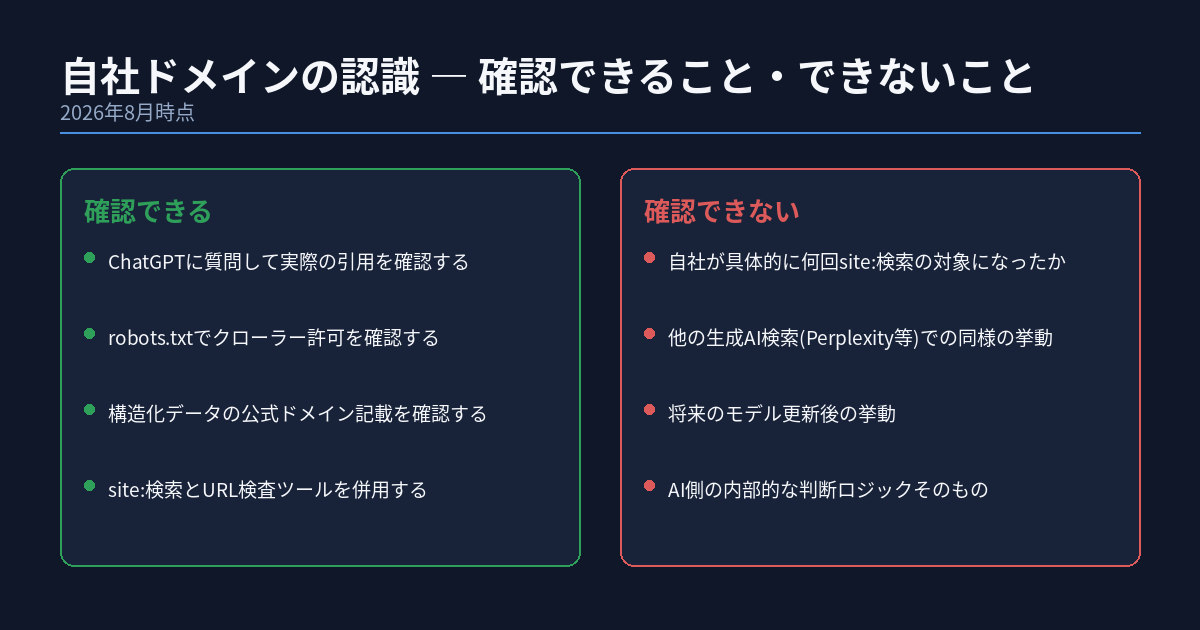
各社の調査が示しているのは回数・利用率・引用率といった集計値であり、「自社サイトが具体的にどのクエリで、何回、site:検索の対象になったか」という個別の内訳ではありません。自社サイトへの影響を知るには、後述する05章の手動確認を、自社のブランド名・主要サービス名で個別に行う必要があります。また、これらの調査はChatGPTを対象としたものであり、Perplexity・Google AI Mode等、他の生成AI検索での同種の挙動を直接示すものではありません。
注意
他社の生成AI検索にも、それぞれ固有のクローラーと文書があります。OpenAIはOpenAI crawlers(訳: OpenAIのクローラー)で、ChatGPT検索向けのOAI-SearchBotを説明しています。実際にユーザーの質問へ応答する際にページを取得するのはChatGPT-Userという別のエージェントで、公式ドキュメントは「ユーザーからのリクエストによるものなので、robots.txtのルールが必ずしも適用されない可能性がある」と説明しています。Perplexityも同様にPerplexity Crawlers(訳: Perplexityのクローラー)で、検索表示用のPerplexityBotと、利用者の質問に応答するためのPerplexity-Userを区別しています。同じ提供元でも、クローラーの種類によってrobots.txtへの向き合い方が異なる点は、自社のrobots.txtを点検する際に見落としやすいところです。
🄲 手順 — 誤認の有無を自分で確かめる方法
手順は大きく2つに分かれます。ひとつはChatGPTに実際に質問して、自社が引用元として表示されるか、表示された場合どのドメインへリンクしているかを目視で確認する方法です。もうひとつは、自社の構造化データ・robots.txt・会社概要ページを点検し、公式ドメインとして認識されるための材料が揃っているかを確認する方法です。02章で触れた「census.com」のような誤認は、後者の点検だけでは見つかりません。前者の手動確認を必ず併用する必要があります。
誤認を見つけたときの優先度
手動確認でドメインの誤認(自社と無関係なサイトへの誘導、あるいは自社の旧ドメインへの誘導)を見つけた場合、これは通常のSEO順位の問題より優先度が高いと考えるべきです。順位が低ければ「見つかりにくい」だけで済みますが、誤ったドメインに誘導されると、読者が競合や無関係なサイトへ流れてしまいます。誤認が見つかった場合の対処は07章で扱います。
05 自分のサイトで確認するチェックリスト
14項目の観点
ここまでの内容を、今日から自分の手で確認できる動作に翻訳しました。観点は大きく3つです。ひとつはChatGPTに実際に質問して引用状況を目視で確認する、ふたつめは公式ドメインとして認識されるための材料が揃っているかを点検する、みっつめはドメインの誤認が起きていないかを確認することです。チェックの状態はブラウザ内にのみ保存され、サーバーには送信されません。
- ChatGPTを開き、自社の主力サービス名で質問し、回答内に自社の公式ドメインへのリンクが表示されるか確認する
- 同じ質問を、社名を含めない一般的な言い回しで3回試し、自社が候補に挙がった回数を数える
- 自社ブランド名だけで質問し、回答が参照したリンクのドメインが自社の正しいドメインと一致するか確認する
- 同業他社を3社選び、それぞれについて同じ質問をChatGPTに投げ、どのドメインが引用されているかを書き出す
- Search Consoleで自社の主要ページ5件を選び、site:自社ドメインの検索結果に含まれているか確認する
- site:検索で見つからないページがあれば、URL検査ツールで「登録済み」と表示されるか個別に確認する
- フッターまたは会社概要ページに「〇〇の公式サイトです」という一文があるか確認する
- Organization構造化データのurlプロパティが、自社の正しいドメインを指しているか確認する
- Organization構造化データのsameAsプロパティに、自社の公式SNS・Wikipedia等のURLが3件以上登録されているか数える
- robots.txtを開き、OAI-SearchBot・PerplexityBotがDisallowされていないか確認する
- 価格・仕様を扱うページで、価格や仕様が画像だけでなく本文のテキストとして書かれているか確認する
- 自社に評判・レビューが関わる場合、Reddit等の第三者サイトに自社の言及があるか検索して確認する
- 直近1週間分のアクセスログを開き、ChatGPT-Userのユーザーエージェントによるアクセス件数を数える
- 4番目の項目で見つけた同業他社の中に、自社と紛らわしいドメイン名を持つ企業がないか確認する
手を動かす順番の目安
最初の6項目はChatGPTでの実際の引用確認とsite:検索の点検、7番目から10番目は公式ドメインの認識を補強する材料の点検、11番目から13番目は自社側の準備状況とアクセスの実態確認、最後の14番目は02章で扱ったドメイン誤認の再確認です。すべてに20分程度かかります。まずは自社の代表的なサービス1つを選び、1番目から順に手を動かしてみることをおすすめします。パーソナライゼーションの影響を減らすため、質問は時間を空けて複数回試すとよいでしょう。
06 自社ドメインの認識状況を確認する方法の比較
4つの確認手段、それぞれの向き不向き
05章のチェックリストで使った確認方法を、確認できることとできないことで整理すると、以下のようになります。
| 方法 | 確認できること | 確認できないこと |
|---|---|---|
| ChatGPTへの 手動での質問 | 実際に引用されるか・どのドメインが表示されるか | サイト全体の傾向・過去の推移 |
| site:検索 Search Console | インデックス状況の目安 | 全URLの網羅・AI側の認識状況 |
| 構造化データの 手動点検 | 公式ドメインを示す材料の有無 | その材料がAIに実際に使われたか |
| 当サイトの (🔧 構造化データ自動作成ツール・無料) | Organization等のマークアップ叩き台を自動生成 | 公開後にAIへ実際に認識されたかの検証 |
それぞれの方法が測っていないこと
4つを組み合わせても埋まらない空白があります。ChatGPTへの手動での質問は、その瞬間の回答を見られる一方、パーソナライゼーションの影響を受けます。site:検索は、03章で確認したとおり全URLを網羅する保証がありません。構造化データの点検は、材料が揃っているかを確認できても、その材料がAI側の判断に実際に使われたかどうかまでは検証できません。当サイトの🔧 構造化データ自動作成ツールは、Organization・Article・FAQ等の叩き台を作成できますが、公開後にAIへどう認識されたかを追跡する機能ではありません。
掲載・非掲載を切り分ける際の注意
ChatGPTの回答に自社が表示されなかった場合、原因は複数考えられます。公式ドメインとして認識されていない、site:検索の対象から外れている、質問の性質上、他の情報源が優先されるのいずれかです。原因を1つに決めつけず、07章で扱う対処を、優先度の高いものから順に試すことをおすすめします。
07 公式ドメインの認識を補強するときの確認先
Organization構造化データのsameAsを増やす
Google Search Centralの公式ガイドOrganization (Organization, LocalBusiness, Restaurant, Store)は、"Adding organization structured data to your home page can help Google better understand your organization's administrative details"
(訳: 組織の構造化データをホームページに追加することで、Googleが組織の管理情報をより深く理解できるようになります。)と説明しています。特にsameAsプロパティは、公式SNSアカウントやWikipediaページなど、自社を確実に指し示す複数のURLをまとめて登録できるプロパティです。この記事のテーマに引きつけて言えば、ブランド名と公式ドメインの結びつきを、構造化データという機械可読な形で補強する手段にあたります。
実務のヒント
当サイトでは、以前archives/66でWikidataのQID取得からsameAs実装までを実際に行った記録を残しています。エンティティ(実体)としての結びつきを固める作業は、一度やれば終わりではなく、SNSアカウントの追加・改称のたびに見直す継続的な作業です。
フッター・会社概要ページに一文を足す
02章で触れたとおり、鈴木氏の記事は「フッターや『運営会社』ページで『〇〇の公式サイト』と明記し、ウェブ全体で公式ドメインとしての認識を固める」ことを対処として挙げています。実装コストの低さの割に効果が見込める対処です。構造化データのような機械可読なマークアップと、フッターの明記のような人が読む文章表現の両方を揃えることが、公式ドメインとしての認識を固める上で重要になります。
ドメイン誤認が見つかった場合の対処
04章の手順で、自社と無関係なドメイン、あるいは旧ドメインへの誤誘導が見つかった場合は、まず自社の正しいドメインを示す一次情報(公式SNS、プレスリリース、Wikipedia等)を増やすことが基本的な対処になります。AI側の内部的な検索対象の判断ロジックは公開されていないため、「この対処をすれば必ず直る」と断言できる方法はありません。継続的に一次情報を増やし、時間を置いて再確認するという地道な作業が、現時点で取れる現実的な手段です。
注意
ドメインを新規に移転・変更した直後は、この誤認リスクが特に高まります。ドメイン移転を予定している場合は、移転前後で旧ドメイン・新ドメインの両方についてこの記事のチェックリストを実施し、移行が完了するまで定期的に再確認することをおすすめします。
本文のテキスト情報を充実させる
02章で確認したとおり、価格・仕様に関する質問では公式サイトが優先されますが、その情報が画像や表のスクリーンショットだけになっていると、AIが取得しても本文として認識できない可能性があります。価格・仕様・スペックといった情報は、画像に加えて本文のテキストとしても明確に記載することをおすすめします。この考え方は、当サイトが以前扱ったAI検索最適化の基本方針とも一致しています。
08 このテーマの、これまで
被リンクからブランドメンションへ、移行を追った回
AIに引用されるための土台が、従来の被リンクから「ブランドメンション(言及)」へと重心を移している流れを、当サイトの実践とともに記録した回があります(archives/73)。本記事02章で扱った「最初のクエリにブランド名が含まれると引用率が上がる」という構造は、この回で扱ったブランドメンションの重要性と地続きの内容です。
Preferred Sourcesという別の仕組みとの違い
Google検索が導入したPreferred Sources(選ばれた情報源)の仕組みについて、守る側の設計思想として記録した回(archives/85)と、フィルターバブルの懸念を扱った回(archives/92)があります。これらはGoogle検索内での「選ばれる情報源」を扱ったものであり、本記事で扱ったChatGPTのsite:検索とは別の仕組みですが、「AIにあらかじめ信頼される情報源になる」ことの重要性という点で、共通のテーマを扱っています。
エンティティSEOを実際に実装した回
07章で紹介したWikidataのQID取得からsameAs実装までの全記録は、こちら(archives/66)にまとめてあります。構造化データを「入れて終わり」にせず、実際にどう検証したかまで含めた記録です。
site:検索の限界を数字で検証した回
03章で引用した「site:検索の0件は未掲載の証明にならない」という論点を、実測とともに詳しく検証した回があります(archives/130)。本記事のチェックリスト6番目・7番目の項目(site:検索とURL検査ツールの併用)は、この回の実測結果を踏まえた手順です。
現在の貴方のIPアドレス
このサイトで書いている人