WEBサイト
ChatGPTは検索する前にブランドを決めている? 名指しされるかどうかで引用率が33倍変わる仕組みを確認する(2026年8月時点)
ChatGPTは検索する前にブランドを決めている? 名指しされるかどうかで引用率が33倍変わる仕組みを確認する(2026年8月時点)
目次
01 何が起きたか — ChatGPTは、検索を始める前にブランドを選んでいる
「クエリを書く時点」で、もう選別は始まっている
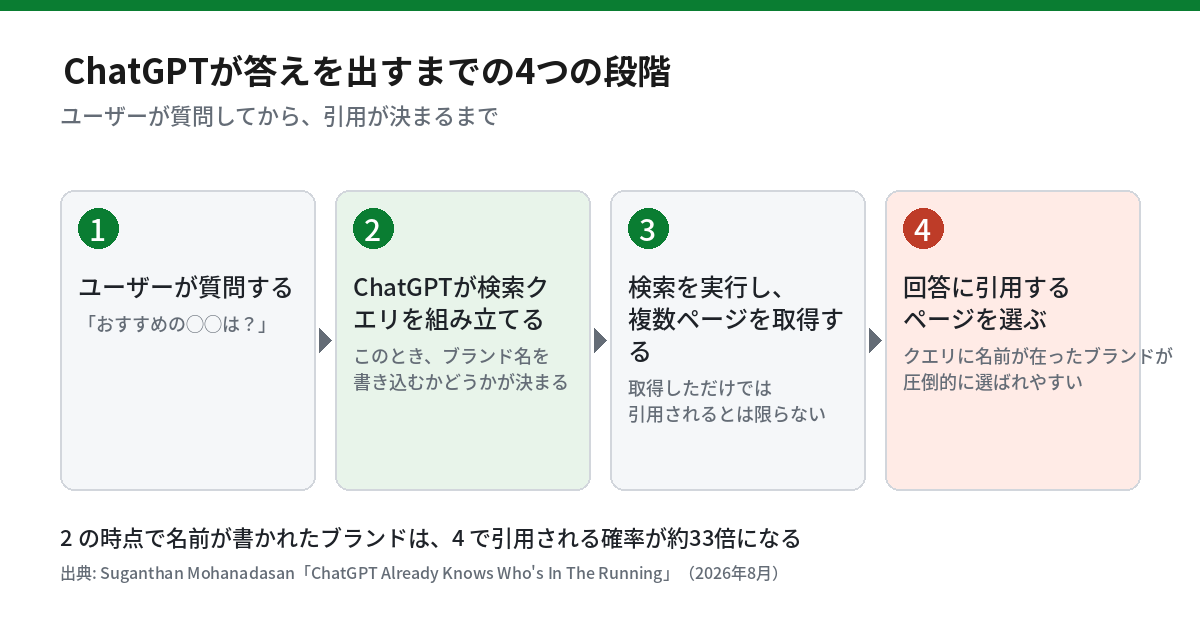
SEOの世界では長らく、検索結果に表示された後の話、つまり検索順位やクリック率が主な関心事でした。しかし生成AIの回答は、検索結果ページという中間物を経由せず、AI自身が取得したページから直接組み立てられます。だからこそ、AIが検索を実行するその前の瞬間に何が起きているかが、これまでとは違う形で重要になってきています。ChatGPTに「おすすめの◯◯は?」と聞くと、ChatGPTはすぐには答えず、内部で検索クエリを組み立ててから検索を実行します。
この記事では、その組み立ての瞬間に注目した一次分析を確認し、そこから、自分のブランドが「名指しされる」側に入っているかを、実際に手を動かして確かめる方法までを整理します。
このクエリを組み立てる瞬間に、ChatGPTがどのブランド名を書き込むかが、最終的にどのブランドが回答に引用されるかを大きく左右している——という分析結果が、2026年8月に公開されました。ノルウェーの検索コンサルタント、Suganthan Mohanadasan氏による実測で、ドバイのログイン済みChatGPT Plusアカウントから60件のChatGPT会話のネットワークトラフィックをキャプチャし、そこから抽出したデータを分析したものです(ChatGPT Already Knows Who's In The Running(訳: ChatGPTは、探す前から候補を決めている))。
68.9%と2.1% — クエリに名前が入るかどうかで生まれる差
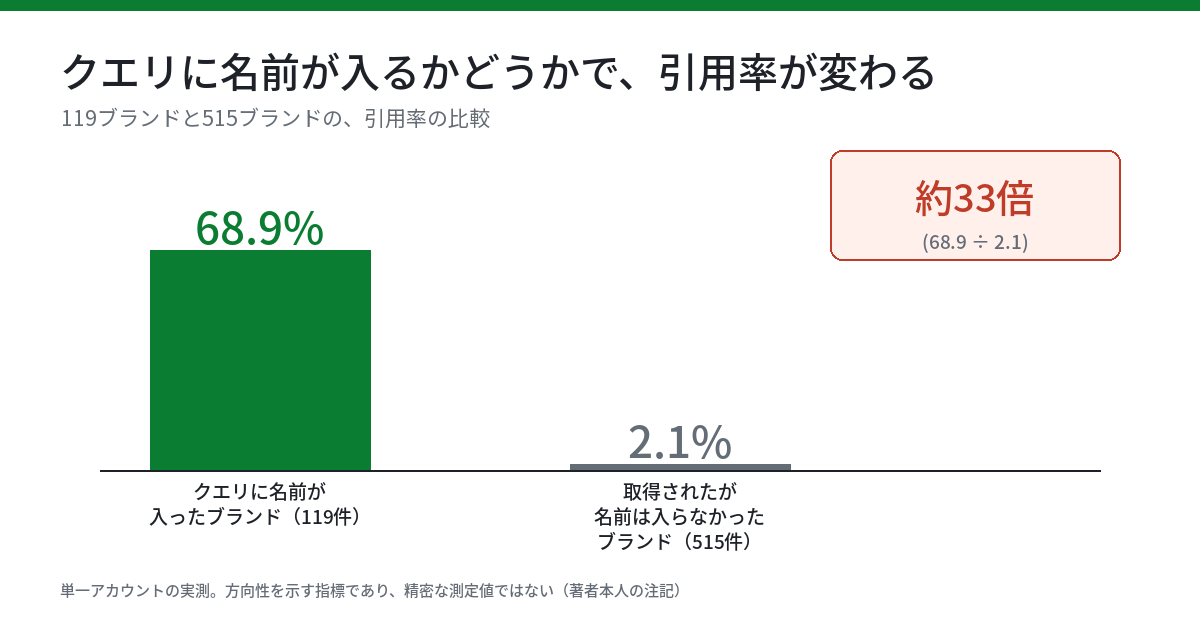
分析の柱になっているのが、クエリに名前が書き込まれたかどうかによる引用率の差です。ChatGPTが自分自身の検索クエリにブランド名を書き込んでいた119ブランドのうち、最終的な回答に引用されたのは68.9%でした。一方、検索の結果として取得はされたものの、クエリには名前が書かれていなかった515ブランドが引用された割合は、わずか2.1%にとどまりました。この119/515ブランドの分析が何件の会話・何ページを対象にしたものかは、元記事に明記されていません。これとは別に、57件の会話から取得した3,554ページを対象にした引用率の分析(02章で後述する3.1%という数字)も行われていますが、この2つは同じデータセットではありません。
「33倍」という数字は、どう計算されたか
記事タイトルにある約33倍という数字は、68.9%を2.1%で割った値です(68.9 ÷ 2.1 ≈ 32.8)。Mohanadasan氏自身、この倍率について「事前に名前が記入されたブランドが引用される確率は、単に検索で取得されただけのブランドよりも約33倍高いことを示唆している」と述べる一方、「これらの割合はすべて単一アカウントから得たもので、方向性を示す指標であり、精密な測定値ではない」とも明記しています。パーソナライゼーションの影響を完全には排除できないため、より確度の高い結論には複数アカウントでの追試が必要だという限界も、著者本人が示しています。
出典
この分析は2026年8月10日に初版が公開され、8月17日にタイトルが改訂されています。改訂理由についてMohanadasan氏は「元のタイトルは、検索が実行される前に結果が決まっていると主張しているように読める可能性があった」と説明し、「before it searches(訳: 探す前に)」から「in the running(訳: 候補に入っている)」へと表現を弱めています。データの取得期間は2026年7月24〜25日(UAE時間)です。
02 なぜ・背景 — ブランド名は、どこで書き込まれているのか
search_queriesというJSONキーが教えてくれること
Mohanadasan氏の分析は、特別な内部情報ではなく、ブラウザの標準機能だけで再現できる手順に基づいています。Chrome DevToolsを開き、Networkタブで「conversation」を含む通信をフィルタリングし、レスポンスの中からsearch_queriesというJSONキー(旧称はsearch_model_queries)を探すと、ChatGPTがそのやり取りのために実際に組み立てた検索クエリの一覧が確認できます。氏は27件の会話について、最初のユーザーメッセージと最初の検索クエリをタイムスタンプ順に照合し、27件中21件で、ユーザーが一度も入力していないブランド名がクエリに含まれていたことを確認しました。
訓練データの中で、ブランドはどう覚えられているか
この現象を、Mohanadasan氏は2つの異なる競争(ゲーム)に分けて説明しています。1つ目はGame 1(カテゴリ語彙への組み込み)で、ChatGPTがそのブランドをカテゴリの構成語彙として記憶し、検索クエリに自発的に書き込むかどうかを決める段階です。この段階に入れなかったブランドが最終回答に引用される確率は2%未満にとどまります。氏はこの段階について「スキーママークアップやllms.txtファイルでは影響を受けない」とし、業界全体での言及・比較・議論の積み重ねによって形成されるものだと位置づけています。2つ目はGame 2(引用の獲得)で、すでにクエリに名前が入ったブランドが、実際に引用されるかどうかを競う段階です。分析では、約600ページが読まれる中でおよそ30ページが引用される、3.1%という水準が示されています。
| テスト | 対象 | 目的 |
|---|---|---|
| 引用分析 | 57会話・3,554ページ | クエリ内での順位・取得ページ数と引用率の関係を測る |
| 初回クエリ テスト | 27会話 | ユーザーが入力していないブランド名が、最初のクエリに現れるかを確認する |
| 追加カテゴリ テスト | 12新規カテゴリ+3反復実行 | カテゴリを変えても同じ傾向が再現するかを確認する |
大手ブランドだけが有利、とも言い切れない
この分析だけを見ると、すでに知名度のあるブランドほど有利な仕組みに見えるかもしれません。しかし別の一次情報として、Semrushが5万以上のブランド・1,094カテゴリ・22万以上のドメインを対象に行った調査(AI visibility is a topic-level game: A study of 50,000 brands in ChatGPT(訳: AI可視性はトピック単位のゲームだ))では、「明確なブランドリーダーが存在するカテゴリは、わずか15.2%にとどまる」と報告されています。残りの多くのカテゴリでは、まだ突出した1社が決まっていない、いわば空席の状態です。これは、Game 1に入り込む余地が、必ずしも大企業だけに閉じているわけではないことを示唆しています。
03 この記事で出てくる用語
Fan-Outクエリ(ファンアウトクエリ)とは
用語
Fan-Outクエリ(ファンアウトクエリ):1つの質問に対して、生成AIが内部で複数の検索クエリに分解し、並行して情報を取得する仕組みを指します。ユーザーが1つの質問しか入力していなくても、AI側は関連する複数の角度からクエリを組み立てて検索するため、どのクエリが生成されるか自体が、回答の材料集めの範囲を決めることになります。本記事で扱うsearch_queriesキーの中身は、まさにこのFan-Outクエリの実体です。
引用率とカテゴリ想起
用語
引用率:このジャンルの分析では、検索で取得されたページの中から、実際に最終回答の中で言及・参照されたページの割合を指します。カテゴリ想起は、AIが特定のカテゴリ(「CRMツール」「ノートPC」など)を考えるときに、そのブランド名を思い出せる状態を指す非公式な言い方です。カテゴリ想起がなければ、そもそも検索クエリに名前が書き込まれる段階(Game 1)に進めません。
04 型別 — 適用範囲・限界・手順
🅰 適用範囲 — この分析が当てはまる場面
この分析が特に関係するのは、「おすすめの◯◯」「◯◯の選び方」のような比較・推薦を求める質問に対して、自社ブランドが候補として挙がってほしい業種です。BtoB向けのSaaS、専門ツール、地域性のあるサービスなど、カテゴリに対して複数の競合が存在する市場ほど、Game 1(クエリに名前が入るかどうか)の重要性が高くなります。逆に、ブランド名そのもので検索されることがほとんどの指名検索中心のビジネスでは、この分析の優先度は相対的に下がります。地域名+業種名のような、検索する側が具体的な事業者名を持たずに質問を組み立てる場面ほど、ChatGPT側がクエリに何を書き込むかの影響が大きくなると考えられます。
🅱 この調査が測っていないこと
この分析を読む際に押さえておきたい限界がいくつかあります。第一に、単一アカウントからのデータである点です。著者自身が「これらの割合はすべて方向性の指標であり、精密な測定値ではない」と明言しています。第二に、地域・利用履歴によるパーソナライゼーションの影響を排除できていません(著者はUAE在住のアカウントで検証しています)。第三に、初回クエリのテストは「best X」形式の質問に偏っており、他の質問形式(比較質問、トラブル解決型の質問など)では異なる傾向が出る可能性があります。第四に、著者は分析の過程で「SaaS」という一般名詞をブランド名として誤って集計してしまった事例があったことも記録しており、自動抽出には一定の誤りが混ざりうることを認めています。
🅲 手順 — Game 1とGame 2、それぞれへの向き合い方
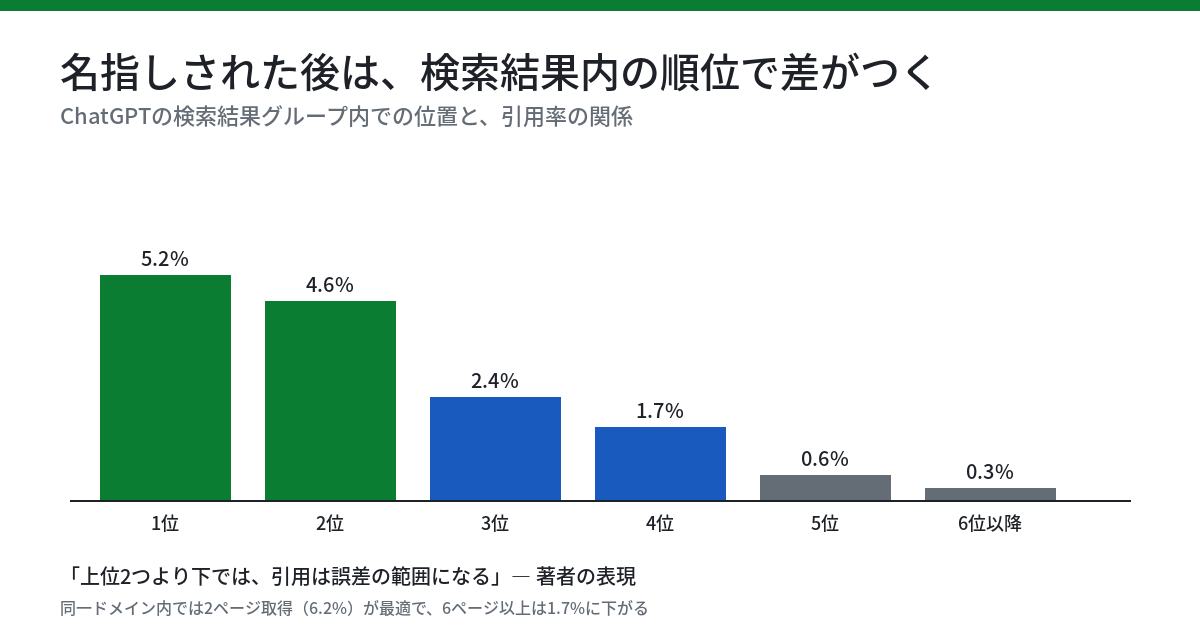
著者の整理に沿うと、対策は2段階に分かれます。Game 1(クエリに名前が入るための対策)は、技術的な監査だけでは動かせません。デジタルPR、レビューサイトへの掲載、業界メディアでの言及・比較記事への露出など、時間のかかる「遅いが実質的な」手段が、ブランドの認知そのものを広げる方向に効きます。Game 2(すでにクエリに入っているブランドが、引用を獲得するための対策)は、より実務的な改善が可能な領域です。分析では、検索結果グループ内の位置が1位・2位に近いほど引用率が高く、同一ドメインから取得するページ数は2ページ前後が最も引用されやすいことが示されています。1つの意図に対して1つのページで明確に答え、その回答をページ上部のプレーンなHTMLテキストとして置く(画像やJavaScriptに埋め込まない)ことが、Game 2側でできる具体的な工夫です。
実務のヒント
Game 1に入れているかどうかは、DevToolsで自分のブランド名を含む質問を実際に投げてみれば、ある程度確認できます。ただし個人のアカウント・地域・過去の会話履歴によって結果が変わりうるため、1回の確認で「入っていない」と断定しないことが大切です。複数の質問文言・複数のアカウントで試し、傾向として捉える方が実態に近づきます。
注意
Game 1の対策として、実態の無いレビューや、自作自演の言及を増やそうとする誘惑が生まれやすい領域です。しかし虚偽のブランドメンションは、後述する第三者評価の信頼性そのものを損ない、発覚すればGoogleのスパムポリシー上も問題になりえます。デジタルPRやレビュー獲得は、あくまで実際の顧客・実際の利用実績を土台にした、時間のかかる取り組みとして進める必要があります。
05 自分のブランドで確認するチェックリスト
3つの観点 — 想起・引用構造・第三者評価
ここまでの内容を、今日から手を動かせる作業に翻訳しました。観点は、自社ブランドがカテゴリ語彙に入っているかの確認、ページ側の引用されやすさの点検、第三者評価の有無の3つに分かれます。チェックの状態はブラウザ内にのみ保存され、サーバーには送信されません。
- ChatGPTで「おすすめの[自社のカテゴリ]は?」という質問を3パターンの言い回しで投げ、回答に自社ブランド名が出るか確認する
- DevToolsのNetworkタブで「conversation」をフィルタリングし、レスポンス内のsearch_queriesキーに自社ブランド名が含まれているか確認する
- 自社ブランド名を、ユーザーとして一度も入力していない状態で上記の質問を送り、クエリへの自発的な書き込みの有無を確認する
- Google検索で自社ブランド名を含む第三者の比較記事・レビュー記事が何件ヒットするか数える
- Trustpilot・G2・Captera等のレビューサイトに自社の掲載ページが存在するか確認する
- 自社サイトのトップページに設置しているJSON-LDのOrganizationスキーマを開き、sameAsプロパティが存在するか確認する
- sameAsに指定しているURLを3本開き、すべてが正しく自社の公式ページを指しているか確認する
- 自社の主力ページ1本を選び、そのページが「1つの意図に対して1つの明確な回答」になっているか読み直す
- そのページの回答部分が、画像やJavaScriptではなくプレーンなHTMLテキストとして書かれているか、ソースを表示して確認する
- 直近3ヶ月で、業界メディア・比較サイトに自社ブランドが言及された実績が何件あるか書き出す
- 競合ブランド3社について、同じ質問をChatGPTに投げ、自社との引用のされ方の違いを比較する
- 自社に関する第三者の言及のうち、事実と異なる記述が無いか1件でも確認する
- Search Consoleの「ページ」レポートで、自社ブランド名を含む検索クエリの表示回数の推移を確認する
13項目の内訳と、かかる時間の目安
最初の3項目はChatGPT側での自社の扱われ方の確認、4番目から9番目はカテゴリ想起と構造化データの点検、10番目から13番目は第三者評価と自社の検索露出の確認に対応しています。すべてに目を通す時間の目安は1ブランドあたり30分程度です。ChatGPT側の確認(1〜3番目)は個人アカウントの状態に左右されるため、1回で結論を出さず、複数回・複数の言い回しで試すことをおすすめします。
06 ブランド可視性を測る手段の比較
手段ごとに、測れる範囲が違う
AIにおけるブランドの扱われ方を確認する手段は複数あり、どれか1つで全体像がつかめるわけではありません。以下は、それぞれの手段が「何を確認でき、何を確認できないか」を整理した表です。
| 手段 | 確認できること | 確認できないこと |
|---|---|---|
| DevToolsでの 手動確認 | 自分のアカウントでの実際のsearch_queriesの中身 | 他のユーザー・地域での傾向。無料で今日から可能 |
| 専門の AI可視性ツール | 複数アカウント・複数クエリの継続的な傾向 | 多くが有料。ツールごとに計測方法が異なる |
| 当サイトの (🔧 Search Console お助けツール・無料) | Google検索での自社ブランドクエリの表示回数・推移 | ChatGPT等、Google以外のAIでの引用状況 |
| 構造化データ テストツール | Organizationスキーマの構文エラー・必須項目の欠落 | そのマークアップが実際にAIの訓練・引用に使われているか |
組み合わせて使うのが前提
DevToolsでの手動確認は無料で今日から始められますが、個人のアカウント状態に依存するため継続的な傾向はつかみにくく、専門ツールや複数アカウントでの検証と組み合わせる必要があります。Google検索での指名検索の状況を継続的に見たい場合は、当サイトの🔧 Search Console お助けツールで、Search Consoleの数値をもう少し詳しく確認する方法を整理しています。構造化データについては、正しい構文で書けていることと、それがAIの引用に実際に使われているかは別の話である点に注意が必要です。
もう一つ、見落としやすい観点としてGoogle自身のAI機能との差があります。ChatGPTでの引用の仕組みと、AI OverviewやAI Modeでの引用の仕組みは、別のシステムです。ChatGPT向けにGame 1・Game 2を意識した施策を行っても、それがそのままGoogleの生成AI機能での扱われ方に反映されるとは限りません。両方を1つの指標で管理しようとせず、プラットフォームごとに別々に確認する姿勢が必要です。
07 当サイトの実測
自社のOrganizationスキーマに、sameAsは入っているか
このガイドを書く過程で、当サイト自身のOrganizationスキーマも確認しました。トップページのJSON-LDを実際に取得したところ、sameAsプロパティにはFacebookページ・X(旧Twitter)アカウント・Wikidataのエンティティページの3件が設定されており、knowsAboutプロパティにはSEO・GEO・AEOなど、当サイトが扱う専門領域が複数登録されていることを確認しました。これは02章で触れたGame 1、つまり「AIがブランドをカテゴリの一員として記憶する」段階に関わる要素の一つです。
実装しているからといって、確実に効くとは限らない
ただし、この記事の04章🅱で触れたとおり、構造化データの実装とAIでの引用は、直接結びついているとは限りません。Wikidataへのqid取得とsameAsの実装を実際に行った経緯は、別記事(archives/66)で記録していますが、その効果をChatGPTのsearch_queriesへの反映という形で直接検証したことはまだありません。「実装した」ことと「AIに認識され、引用の候補になった」ことの間には、まだ確認していない距離があります。
この距離を正直に書くのは、Game 1の対策が「これをやれば入る」という即効性のある作業ではないからです。02章で触れたとおり、Game 1はスキーママークアップやllms.txtでは動かず、業界全体での言及の積み重ねによって形成されます。構造化データの整備は、AIがブランドを一意に識別しやすくするための土台であって、それ単体でカテゴリ想起を保証する仕組みではない、という位置づけで捉えておく方が実態に近いはずです。
08 このテーマの、これまで
Wikidata QID取得からsameAs実装までを記録した回
当サイトが実際にWikidataのQIDを取得し、Organizationスキーマにsameas実装するまでの過程を、失敗も含めて記録した回があります(archives/66)。本記事の07章で触れたsameAsの実装は、この回で行った作業がベースになっています。
被リンクではなく「ブランドメンション」を増やす取り組みを記録した回
被リンクに代わって、AIに引用される土台としての「ブランドメンション」(リンクを伴わない言及)を、当サイトがどう増やしてきたかを記録した回もあります(archives/73)。本記事の04章🅲で触れたGame 1対策(デジタルPR・レビューサイト掲載)は、この回で扱った考え方と地続きです。
検索順位と引用の無関係さを検証した回
検索結果でTop10に入っていても、AIには引用されない事例が増えていることを検証した回もあります(archives/63)。本記事の01章で示した「クエリに名前が入るかどうか」という別の軸は、検索順位だけでは説明できないこの現象への、一つの補助線になります。
AI OverviewとAI Modeの引用URLが重複していなかった回
AI OverviewとAI Modeが、実は別々の引用URLの集合を持っており、単純な重複率は13.7%にとどまるという実測を記録した回もあります(archives/81)。本記事のGame 2(引用の獲得)で触れた「取得はされても引用されるとは限らない」という構造は、生成AI機能ごとに個別に確認する必要があることを、この回も裏づけています。
4本の回を通して見えてくるのは、ブランドがAIに扱われる過程は、単一の指標では説明できないという点です。エンティティとしての認識(archives/66)、言及量の積み重ね(archives/73)、検索順位との無関係さ(archives/63)、生成AI機能ごとの引用集合の違い(archives/81)。今回紹介した「クエリに名前が入るかどうか」という切り口は、これらの積み重ねの先に位置する、比較的新しい観測点だと捉えられます。
現在の貴方のIPアドレス
このサイトで書いている人