WEBサイト
エンティティSEOとは? 検索エンジンが企業や人を「同一のもの」と認識する仕組みを整理する
エンティティSEOとは? 検索エンジンが企業や人を「同一のもの」と認識する仕組みを整理する
目次
01 エンティティSEOとは何か、いま何が求められているか
「文字列」ではなく「モノ」として扱われる
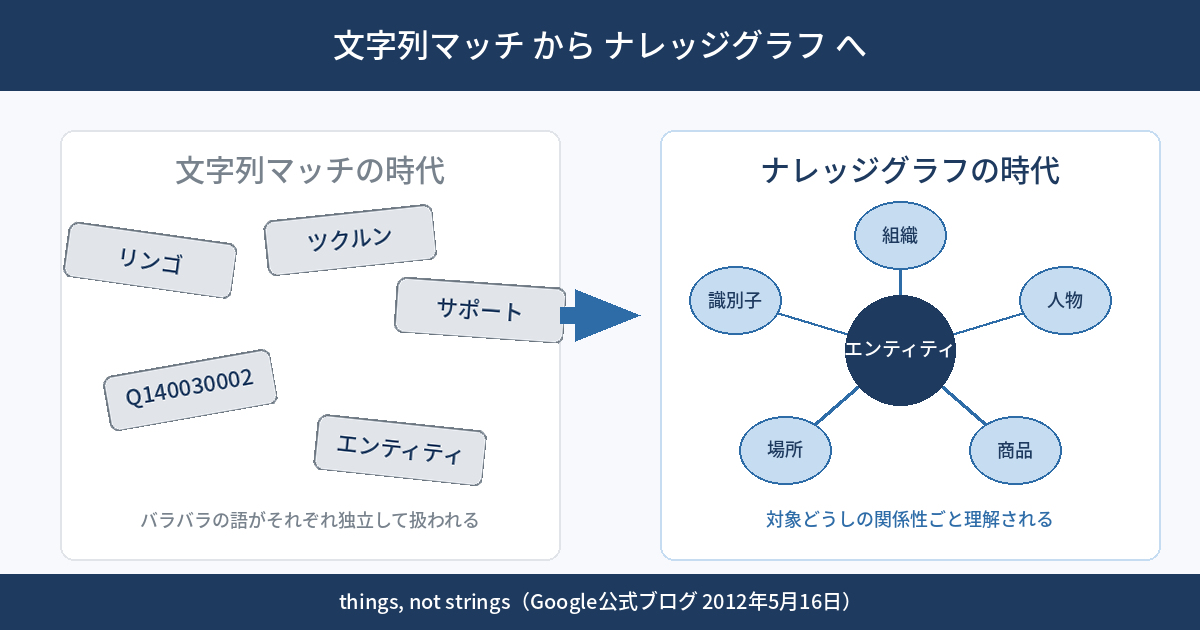
エンティティSEOとは、検索エンジンに対して「この会社・この人物・この商品は何者か」を、単なる文字の並び(文字列)ではなく、実在する対象(エンティティ)として認識させるための取り組みです。この考え方の出発点は、2012年5月16日にGoogleが公開した記事にあります。そこでは、検索エンジンが目指す仕組みを「things, not strings(文字列ではなくモノ)」という一文で説明しています。原文では「an intelligent model―in geek-speak, a 'graph'―that understands real-world entities and their relationships to one another: things, not strings」と述べられており、現実世界に存在する対象どうしの関係性を理解するモデル、という位置づけが示されています。
実務でやることは、構造化データとsameAs
この「モノとして認識させる」作業を、サイト運営者が実際に手を動かせる形に翻訳すると、大きく2つになります。ひとつは構造化データを使って、ページが何についてのページかをGoogleに明示すること。もうひとつは、sameAsというプロパティを使って、そのエンティティを説明している他のページ(Wikipedia、Wikidata、公式SNSなど)と紐づけることです。Google検索セントラルの構造化データ概要ページでは、「Structured data is a standardized format for providing information about a page and classifying the page content(構造化データは、ページに関する情報を提供し、ページのコンテンツを分類するための標準化された形式)」と定義されています。
形式は3種類、Google推奨はJSON-LD
構造化データの記述形式には、JSON-LD・Microdata・RDFaの3種類がサポートされています。このうちGoogleは明確にJSON-LDを推奨しており、「Google recommends using JSON-LD for structured data if your site's setup allows it, as it's the easiest solution for website owners to implement and maintain at scale(サイトの構成が許すなら、実装と維持がもっとも容易であるという理由でJSON-LDの使用を推奨する)」と述べています。効果の実例として、同ページではRotten Tomatoesが10万ページに構造化データを追加してクリック率が25%向上した事例、Nestléが82%のクリック率向上を記録した事例が挙げられています。ただし、これらは特定サイトの実例であり、すべてのサイトで同じ倍率の効果が出ることを保証するものではありません。
出典
本章の記述はGoogle公式ブログ「Introducing the Knowledge Graph: things, not strings」(2012年5月16日)およびGoogle検索セントラル「構造化データの仕組みについて」(2025年12月10日更新)に基づいています。
02 なぜ、いまサイト側の対応が必要なのか
ナレッジグラフからAI検索へ、13年間の連続性
2012年のナレッジグラフ発表から、2026年現在のAI検索(生成AIによる要約・引用)まで、「モノとして正確に認識されているエンティティほど、扱いやすい」という基本構造は変わっていません。ナレッジグラフが検索結果の右側にナレッジパネルを表示する仕組みだったのに対し、いまのAI検索は同じエンティティ理解の仕組みを使って、要約文の中に企業名や人物名を引用します。入口が検索結果のパネルからAIの回答文に移っただけで、認識のさせ方そのものは13年前から地続きです。この「AIの回答文に引用されるかどうか」という観点については、Princeton大学の研究データをもとに統計の扱い方を整理した記事(archives/80)でも取り上げています。
構造化データは、ランキングの直接要因ではない
ここで誤解しやすい点があります。構造化データを追加すること自体は、検索順位を直接押し上げる要因ではありません。Google検索セントラルの構造化データ一般ガイドラインには、「Google does not guarantee that your structured data will show up in search results, even if your page is marked up correctly(ページが正しくマークアップされていても、構造化データが検索結果に表示されることをGoogleは保証しない)」と明記されています。それでも取り組む理由は、順位そのものではなく、検索エンジンやAIが自社を正しく識別できるかどうかという、もっと手前の段階に効くからです。識別を誤られたまま順位だけを上げようとしても、間違った名前・間違った所在地で引用される事態は防げません。
ナレッジパネルは「自動生成」であり、申請して得るものではない
もうひとつの誤解が、ナレッジパネルは申請すれば表示されるという理解です。Googleのナレッジパネルヘルプでは、「Knowledge panels are automatically generated(ナレッジパネルは自動生成される)」と明記されており、情報源についても「information that appears in a knowledge panel comes from various sources across the web(ナレッジパネルに表示される情報は、ウェブ上のさまざまな情報源から集められる)」とされています。サイト運営者にできるのは、この「さまざまな情報源」のひとつとして、正確で一貫した情報を提示することまでです。表示を直接コントロールする手段は、公式には存在しません。
注意
「構造化データを入れればナレッジパネルが出る」「sameAsを設定すればAIに引用される」という因果関係を断定する記述は、いずれもGoogleの公式文書には見当たりません。できるのは、認識される確率を上げる材料を揃えることまでで、結果を保証する手段ではないという前提を、まず押さえておく必要があります。
03 この記事で出てくる用語
本文で繰り返し使う5つの用語を、先に整理しておきます。
用語
エンティティ(Entity):人・組織・場所・物事など、現実に存在する対象そのものを指します。同じ名前でも文脈によって別の対象を指すことがあるため(例:「リンゴ」という文字列は果物にも人名にも企業名にもなりうる)、検索エンジンは文字列だけでなく、周辺の情報から「どのエンティティを指しているか」を判定しようとします。
用語
ナレッジグラフ(Knowledge Graph):エンティティどうしの関係性をデータベース化した仕組みです。2012年のGoogle公式ブログでは「a 'graph' that understands real-world entities and their relationships to one another」と説明されており、単体のエンティティ情報だけでなく、エンティティ間の繋がり(例:ある人物がどの組織に所属しているか)を扱う点が特徴です。
用語
構造化データ(Structured Data):ページの内容を検索エンジンが理解しやすい標準化された形式で記述したコードです。schema.orgという共通の語彙(ボキャブラリ)に沿って、JSON-LD・Microdata・RDFaのいずれかの形式で記述します。
用語
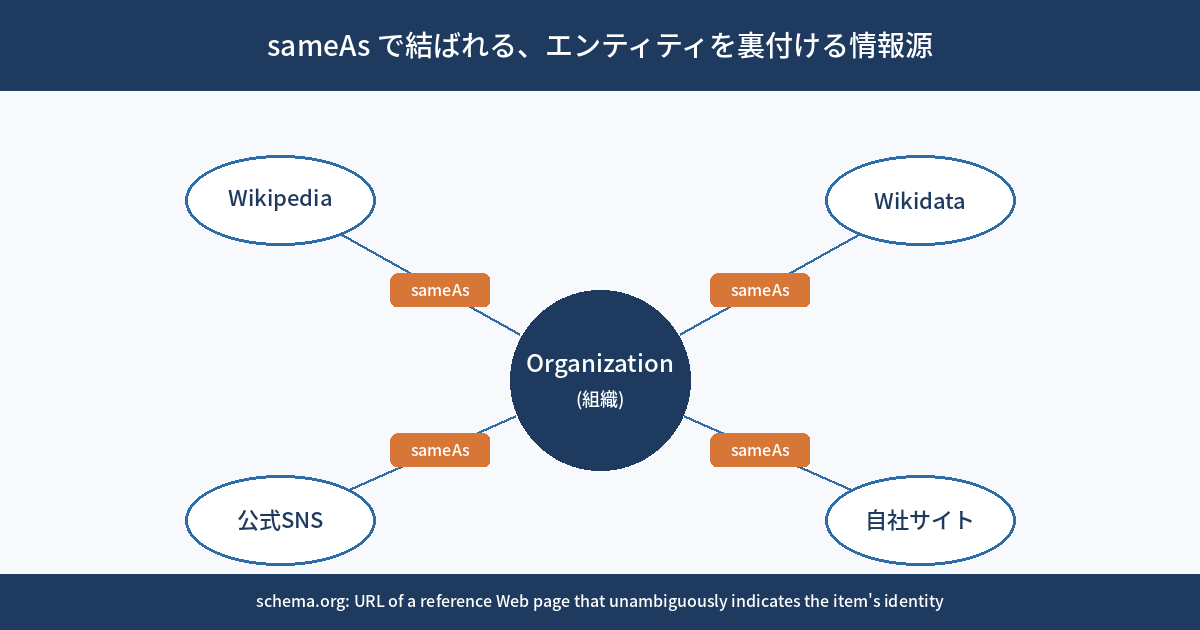
sameAs:あるエンティティについて、その身元を裏付ける別のページのURLを指定するプロパティです。schema.orgでの定義は「URL of a reference Web page that unambiguously indicates the item's identity. E.g. the URL of the item's Wikipedia page, Wikidata entry, or official website.(その項目の身元を一意に示す参照ページのURL。例として、Wikipediaのページ、Wikidataの項目、公式サイトのURLなど)」となっています。この定義はOrganization型・Person型など、多くの型で共通して使われる、Thing型から継承されたプロパティです。
識別子(Identifier):あるエンティティを他と混同しないよう一意に特定するための番号やコードです。Wikidataの解説ページでは、識別子プロパティを「values that are external identifiers pointing to authority control systems or databases(権威あるデータベースや管理システムを指し示す外部識別子)」と説明しており、2026年8月時点で8,946種類の識別子プロパティが登録されています。書籍のISBN、映画のIMDb IDなどが代表例です。
04 型別に見る、対応の範囲・限界・手順
🅰 適用範囲 ── どのサイトに何の型が当てはまるか
エンティティとして扱う対象がサイトによって異なるため、使う構造化データの型も変わります。組織そのものを表す場合はOrganization型、著者や代表者など個人を表す場合はPerson型、実店舗を持つ事業者の場合はLocalBusiness型(Organizationのサブタイプ)を使うのが基本です。schema.orgの定義上、Organization型もPerson型も、名前(name)・URL(url)・sameAsといったプロパティは、どちらも共通の親であるThing型から継承しています。つまり「組織か個人か」で使う型は変わっても、身元を示す仕組み自体は共通です。
🅱 この記事が扱っていないこと・保証しないこと
本記事で扱っているのは、あくまで「エンティティとして認識される確率を上げる、公式に確認できる材料」の整理です。以下は扱っていません。第一に、特定のキーワードでの検索順位への直接的な影響度。構造化データはランキングシグナルそのものではないと02章で述べたとおり、影響の大きさを数値化した公式データはありません。第二に、AI検索での引用確率がどれだけ上がるかという定量的な保証。生成AIがどの情報を引用するかのアルゴリズムは公開されておらず、sameAsの有無と引用確率の因果関係を示す一次情報も見当たりません。第三に、ナレッジパネルの表示タイミングや表示条件。09章でも述べたとおり自動生成であり、いつ・どの条件で表示されるかは公式に明示されていません。なお、エンティティとして正しく認識されることと、E-E-A-T(経験・専門性・権威性・信頼性)の観点でコンテンツそのものの質が評価されることは、重なる部分はあっても同じ話ではありません。後者を中心に扱った記事(archives/3)は別に用意しています。
🅲 実装の手順 ── 4ステップ
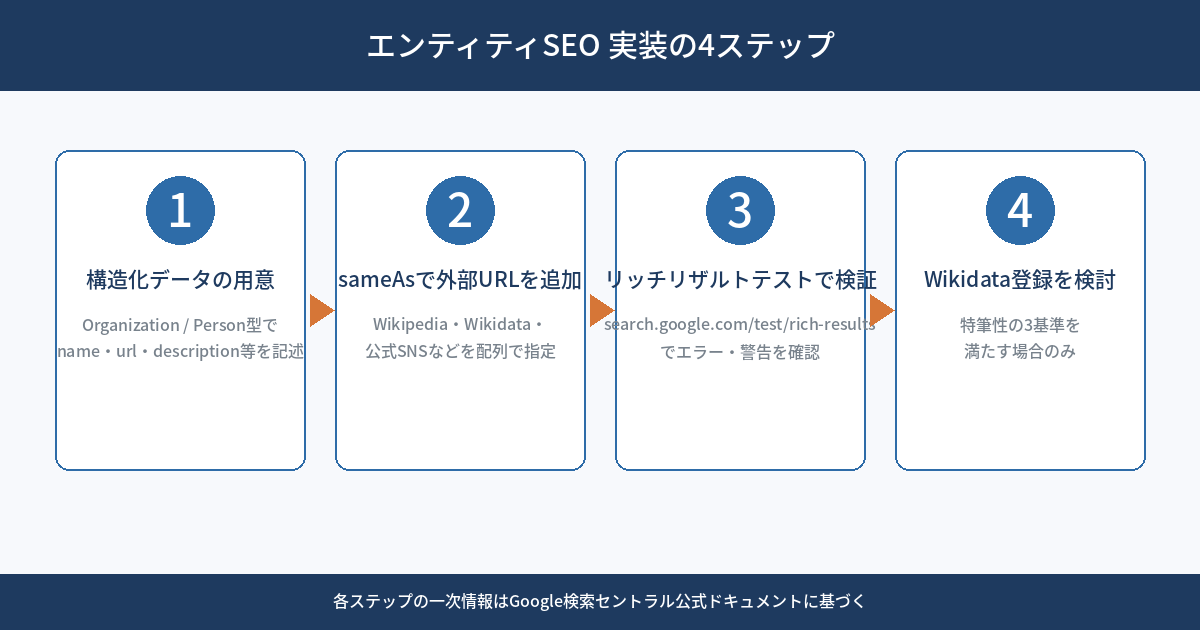
実装の手順は、公式ドキュメントを踏まえると次の4段階に整理できます。①組織(または人物)を表すJSON-LDを、Organization型(またはPerson型)で用意する。name・url・description・logoなど、該当するプロパティをできる限り埋める。②sameAsプロパティに、その組織・人物を示す外部ページのURLを配列で追加する。公式サイトの記述では「a URL to your organization's profile page on a social media or review site(SNSやレビューサイト上のプロフィールページのURL)」が例として挙げられている。③Googleのリッチリザルトテスト(search.google.com/test/rich-results)にページのURLを入力し、構造化データが正しく検出されるか、エラーや警告が出ていないかを確認する。④該当する場合は、Wikidataへの項目登録を検討する(06章で扱う特筆性の基準を満たす場合のみ)。この確認は、当サイトが提供している🔧 WEBサイト総合分析・レポートツールでも代用できます。
実装例
Organization型でsameAsを含める場合、JSON-LD内の記述はおおよそ次の形になります。"@type": "Organization"の下に"name"・"url"を置き、"sameAs"には配列で外部URLを複数指定します。例:"sameAs": ["https://www.wikidata.org/wiki/Q番号", "https://x.com/アカウント名", "https://www.facebook.com/ページ名"]という並びです。07章で検証した実例も、この構造に沿ってWikidata・X・Facebookの3件を配列で指定していました。
05 自分のサイトで確認するチェックリスト
14項目・3つの観点
以下のチェックリストは、公式ドキュメントで確認できる要件を、公開済みのページに対して今日から確認できる動作に翻訳したものです。大きく3つの観点で構成されています。ひとつは「構造化データが実際に入っているか」、ふたつめは「sameAsの中身が正確で生きているか」、みっつめは「表記が複数の場所で一致しているか」です。チェックの状態はブラウザ内にのみ保存され、サーバーには送信されません。
- トップページのソースを開き、application/ld+jsonの中に「@type":"Organization"」が含まれているか確認する(未設置なら🔧 構造化データ自動作成ツールでたたき台を作れる)
- そのOrganizationに sameAs プロパティがあり、外部URLが1つ以上入っているか確認する
- sameAs に入っている外部URLをすべて実際に開き、リンク切れ(404など)が無いか確認する
- 会社名の表記を、サイト内・SNSプロフィール・Googleビジネスプロフィールの3箇所で見比べ、完全に一致しているか確認する
- Googleのリッチリザルトテスト(search.google.com/test/rich-results)に自サイトのURLを入力し、検出されたスキーマの種類を控える
- Organizationの logo プロパティが指定されているか確認し、指定されていれば画像が112×112px以上か確認する
- Wikidataで自社名・自分の名前を検索し、既存の項目(Q番号)が無いか確認する
- サイト内に「会社概要」または「運営者情報」ページがあり、トップページから2クリック以内で辿れるか確認する
- サイト内の複数ページに登場するOrganizationマークアップを3ページ以上見比べ、ページによってsameAsの項目数が異なっていないか確認する
- 著者・執筆者情報がある場合、そのPersonマークアップに sameAs があるか確認し、無ければ追加候補のURLを1つ書き出す
- 直近1年で社名・URL・代表者名に変更があった場合、sameAs先の外部プロフィールが更新済みか確認する
- Googleビジネスプロフィールに登録している場合、そこに記載した名前・住所・電話番号とサイト内の記載を1文字ずつ比較する
- リッチリザルトテストで警告(warning)が表示された場合、その項目名を1つ書き出す
- 構造化データが説明している内容が、同じページの本文にも実際に書かれているか(非表示情報のマークアップになっていないか)確認する
かかる時間の目安と、優先順位
14項目すべてに目を通すのにかかる時間の目安は、1サイトあたり20〜30分程度です。優先順位をつけるなら、まず1〜3番目(構造化データとsameAsの有無・リンク切れ)を先に確認してください。この3項目は「そもそも土台があるか」を確認するもので、無ければ他の項目を確認する意味がありません。4番目・9番目・12番目(表記の一致確認)は、構造化データを追加した後で発生しやすい抜け漏れです。ページごとに別々の担当者が更新していると、同じ組織を指しているはずのOrganizationマークアップが、ページによって項目数や表記が異なるということが起こります。14番目(非表示情報のマークアップ)は、構造化データ一般ガイドラインが明確に禁止している「Don't mark up content that is not visible to readers of the page(ページの読者に見えない内容をマークアップしない)」という規定に対応する項目で、違反するとスパムポリシー上の問題になり得ます。
06 sameAsに指定する先の候補と、それぞれの制約
候補は複数あり、それぞれ性質が異なる
sameAsに指定できる外部URLにはいくつかの種類があり、それぞれ示せる内容と制約が異なります。以下は、各候補について公式ドキュメントで確認できる特徴を整理した表です。
| 候補 | 何を示せるか | 確認できた制約 |
|---|---|---|
| Wikipedia | 第三者による百科事典的な記述。エンティティの実在性を第三者視点で裏付ける | 各言語版ごとに独自の削除基準・出典要件があり、schema.orgの説明でも「Wikipediaのページ」がsameAsの例として挙げられている |
| Wikidata | 構造化された識別子(Q番号)。他の外部データベースとの相互リンクの起点になる | 特筆性の3基準(有効なサイトリンク/明確に識別可能な実体/構造的必要性)のいずれか1つを満たす必要がある。業種や職業ごとの個別基準は、公式ページには明記されていない |
| 公式SNS X・Facebook等 | 運営主体が自ら発信していることを示す、一次情報としてのプロフィール | Google側の構造化データガイドは「social media or review site」の例として挙げているのみで、認証バッジの有無を条件とする記載は見当たらない |
| Googleビジネスプロフィール | 実店舗・所在地情報との紐付け。地図検索・ローカル検索との接続 | LocalBusiness構造化データの公式ガイドを確認した限り、sameAsとの直接的な連携についての記載は無い(2026年8月時点) |
Wikidataの特筆性は「業種」では判定されない
ここで見落とされやすいのが、Wikidataの掲載基準です。「企業ならこの条件を満たせば載る」「有名人ならこの条件」といった業種別・職業別の基準を紹介する記事も見かけますが、Wikidataの特筆性(Notability)方針を実際に開いて確認すると、掲載基準は3つの普遍的な基準だけで、業種や職業ごとの個別条件は明記されていません。3つの基準は、「有効なサイトリンクを1つ以上持つこと」「公開されている信頼できる情報源で説明できる、明確に識別可能な実体であること」「他の項目をより有用にするなど、構造的な必要性を満たすこと」のいずれかです。企業であっても人物であっても、判定される軸はこの3つに集約されます。
NAP情報の一貫性は、Googleビジネスプロフィールのガイドにも表れている
sameAsの話とは別に、名前・住所・電話番号(NAP情報)の一貫性そのものも、Googleが繰り返し重視している点です。Googleビジネスプロフィールのヘルプページには、「Represent your business as it's consistently represented and recognized in the real world across signage, stationery, and other branding.(看板・便箋・その他のブランディング全体を通じて、実世界で一貫して表記・認識されている通りに事業を表記すること)」という記述があります。複数拠点を持つ事業者向けには「Maintain consistent names and categories across all of your business locations(すべての事業拠点で名称とカテゴリを一貫させる)」とも明記されており、「一貫性」という言葉そのものが、Googleのガイドラインの中で繰り返し使われているキーワードであることがわかります。この「一貫性」は、被リンクを介さない外部での言及(ブランドメンション)がAIの引用にどう関わるかを扱った記事(archives/73)で触れた考え方とも重なります。sameAsによる公式な紐付けと、第三者による自然な言及は別物ですが、どちらも同じ名前・同じ組織を指し示しているかどうかが土台になる点は共通しています。
07 実際に検証してみると
Organization型のsameAsは実装されていたが、抜けもあった
本記事の公開に合わせて、website.usersupports.com のトップページに実際に出力されている構造化データを検証しました。ページ内には3つのJSON-LDブロックがあり、そのうち1つにOrganization型のマークアップが含まれています。中身を確認すると、name・legalName・alternateName・url・email・description・foundingDate・areaServed・knowsAbout・founder(Person型)に加えて、sameAsプロパティに3件のURL(Facebook・X・Wikidataの項目ページ)が実際に指定されていました。Wikidataの項目には固有のQ番号が割り振られており、04章・06章で扱った「識別子による紐付け」がそのまま実装されている形です。
一方で、logoプロパティは指定されていなかった
ただし、同じOrganizationブロックを見ていくと、logoプロパティは指定されていませんでした。Google検索セントラルのOrganization構造化データガイドは、logoについて最小112×112pxでクロール・インデックス可能であることを推奨事項として挙げています。sameAsという「外部との紐付け」は実装されている一方で、logoという「自身の視覚的な識別情報」は空欄のままだった、という状態です。
ページ内の別の箇所では、sameAsを持たないOrganization記述も混在していた
さらに同じページを見ていくと、ブログ記事一覧などを示す別のJSON-LDブロックの中にも、author(著者)としてOrganization型が繰り返し登場していました。こちらは name と url だけの簡略な記述で、sameAsは含まれていません。同じサイトの同じページの中に、sameAsを持つ本体のOrganizationと、sameAsを持たない簡略なOrganizationが混在している状態です。これは05章のチェックリストにある「サイト内の複数ページに登場するOrganizationマークアップを3ページ以上見比べ、ページによってsameAsの項目数が異なっていないか確認する」という項目が、同一ページ内でも当てはまりうることを示す実例といえます。
実務のヒント
この検証は、構造化データを「一度入れて終わり」にできない理由を示しています。ページを追加・改修するたびに、新しく生成されるOrganizationやAuthorの記述が、本体の記述と同じ水準の情報を持っているとは限りません。05章のチェックリストにある確認作業を、実装した直後だけでなく、サイトが更新されるたびに繰り返す運用が必要です。以前、別の種類の構造化データ(FAQPageスキーマ)が意図せず壊れていたことに気づき、原因の切り分けから修正・展開までを記録した回(archives/70)もあります。今回のOrganization型の抜けと同じく、「実装したはずのマークアップが、実際には欠けている」というケースは繰り返し起こりうるということです。
08 このテーマの、これまで
「次の入口」として提示した回
エンティティSEOというテーマは、以前の記事(archives/64)で、検索順位が1位であってもAIには引用されない現象を扱う中で、「次に取り組むべき入口」として初めて取り上げられました。当時はまだ着手前の段階で、方針の提示にとどまっていました。
Wikidataの項目取得からsameAs実装までを記録した回
その後の記事(archives/66)で、実際にWikidataへ新規の項目を登録し、QID(Q140030002)を取得したうえで、Facebook・X・Wikidataの3件をsameAsに設定するまでの過程が記録されました。その記事の中では、「Knowledge Graphの再処理には4〜8週間かかる」という所要期間の見通しや、出典として第三者メディア掲載・プレスリリース・法人登記・公式サイトという優先順位が扱われていたことも記されています。本記事の07章で確認した3件のsameAs URLは、この時に設定されたものがそのまま現在も稼働している状態です。
一次資料に照らして、今回あらためて分かったこと
本記事の執筆にあたって、Wikidataの特筆性方針・schema.orgの型定義・Googleの各種公式ガイドを、あらためて一次情報から確認し直しました。その過程で、06章で扱った「Wikidataの特筆性は業種で判定されない」という点、07章で扱った「logoプロパティが未設定である」という点は、いずれも過去の記事の時点では明示的に扱われていなかった内容です。エンティティSEOは、一度実装すれば完了するものではなく、公式ドキュメントを読み直すたびに、抜けている項目が見つかる作業であることが、今回の検証からもあらためて確認できました。
現在の貴方のIPアドレス
このサイトで書いている人