WEBサイト
Googleの生成AIガイダンスは、公開前の人による事実確認を「重要」と明記した ── タイトル・説明文・構造化データ・altまで確認する13項目(2026年10月時点)
Googleの生成AIガイダンスは、公開前の人による事実確認を「重要」と明記した ── タイトル・説明文・構造化データ・altまで確認する13項目(2026年10月時点)
目次
01 何が起きたか — 公式文書が10月1日に更新され、公開前の事実確認が「重要」と書かれた
2026年10月1日に、生成AIのガイダンスが更新された
Google検索セントラルの更新履歴には、2026年10月1日の項目として「Updated guidance on using generative AI content」(訳: 生成AIコンテンツの使用に関するガイダンスを更新)が載っている。内容欄には、「Updated the using generative AI content guide with information from the Search Quality Raters guidelines.」(訳: 生成AIコンテンツの使用ガイドを、検索品質評価者向けガイドラインの情報で更新した)とある。理由欄には、開発者向けイベントで使っている発表資料と、文書の内容をそろえるため、という趣旨が書かれている。
対象の文書は、英語版の題名が「Google Search's guidance on using generative AI content on your website」(訳: ウェブサイトで生成AIコンテンツを使うためのGoogle検索のガイダンス)で、ページ下部の最終更新日は2026-10-01と表示されている。この記事は、その英語版を2026年10月2日に開いて読み、確かめた範囲だけを書く。
追加されたとされる3つの文
今回の更新で目立つのは、「公開前に人が確認する」ことを強い言葉で求めた点である。英語版の本文には、次の3つの文が並んでいる。
"Keep in mind that generative models don't retrieve facts, but predict a likely sequence of words based on their training data. Because of this, generative AI outputs may contain inaccuracies (also known as hallucinations). It is critical to manually factcheck and review all AI-generated content for accuracy and trustworthiness before publishing."
(訳: 生成モデルは事実を取り出すのではなく、学習データに基づいて、もっともらしい語の並びを予測するものだと心に留めてください。そのため、生成AIの出力には、不正確な内容(ハルシネーションとも呼ばれます)が含まれることがあります。AIが作ったコンテンツは、公開前に、正確さと信頼できるかどうかを、すべて人の手で事実確認し、見直すことが重要です。)
語の選び方に注目したい。「critical」は「重要」よりも強い、欠かせないという意味の語であり、「すべて(all)」「人の手で(manually)」「公開前に(before publishing)」の3つが、1文にそろっている。確認の担当者、確認の範囲、確認のタイミングが、1文で決まっている。
確認の範囲は、本文の外にも及ぶ
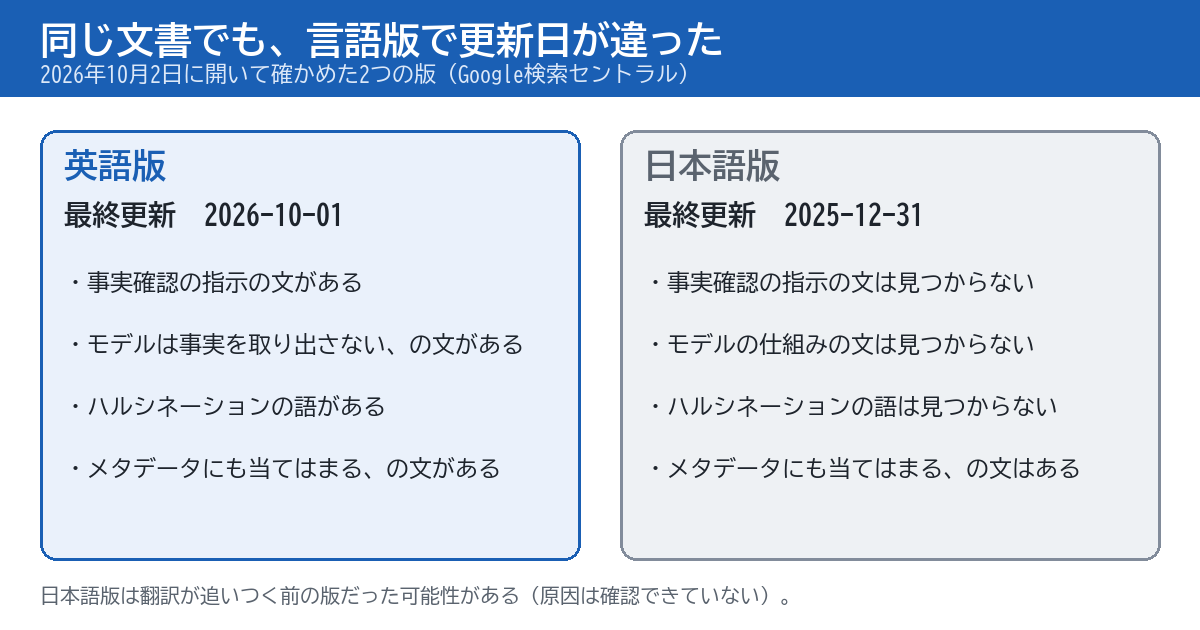
3つの文のすぐ後ろには、確認の対象を広げる文が続く。
"This review also applies to metadata like <title> elements, meta description elements, structured data, and alternate texts for images, which can appear in Search results."
(訳: この見直しは、検索結果に表示されうるメタデータにも当てはまります。たとえばtitle要素、メタディスクリプション要素、構造化データ、画像の代替テキストです。)
本文の事実確認だけでなく、検索結果で読者が最初に目にする場所も、人が見直す対象に入っている。この記事の軸は、ここにある。
報道は「範囲が広がった」と伝えるが、差分は自分で確かめられていない
Search Engine Journalは、今回の更新で3つの文が加わり、確認の対象がメタデータにも広がった、と伝えている。一方、日本語版を同じ日に開くと、メタデータに触れた文は既に載っていた(詳しくは02章の図で示す)。このため、「メタデータが今回、新しく対象になった」とは、この記事では断定しない。旧版との行ごとの差分は、取得できていない。
公式情報
更新履歴:Documentation updates(訳: ドキュメントの更新)(Google Search Central)。対象の文書:Google Search's guidance on using generative AI content on your website(訳: ウェブサイトで生成AIコンテンツを使うためのGoogle検索のガイダンス)。
この記事が扱うこと
扱うのは、AIに書かせた原稿を公開する前に、本文とメタデータの両方を、人が確かめる手順である。本文だけの確認は、別の記事(AIで作った原稿は、公開前に人が5つ確かめる ── 引用・固有名詞・実体験・重複・責任者を確認する13項目(2026年9月時点))が5つの確認にまとめている。今回はそれを繰り返さず、10月1日の更新で前面に出た「更新日の確かめ方」と「本文以外の場所」に絞る。
02 なぜ・背景 — AIの文章は「正しいから出る」のではなく「もっともらしいから出る」
生成モデルは、事実を引き出す仕組みではない
公式の文は、生成モデルの仕組みを一言で述べている。事実を取り出す(retrieve)のではなく、学習データに基づいて、もっともらしい語の並びを予測する、という説明だ。この仕組みでは、文章の体裁と内容の正確さは、別々に決まる。文体が整っていても、数字や日付が合っているとは限らない。
読み手の側から見ると、困るのはここである。体裁が整った文章ほど、間違いが目に入りにくい。制作の現場では、読みやすく仕上がった原稿に安心して、確認を省く場面が起きやすい。公式が「すべて」の原稿に確認を求めた理由は、この性質にあると読める。ただし、公式がそこまで書いているわけではない。
2023年の方針は、変わっていない
Googleは2023年2月に、検索ブログで「Google Search's guidance about AI-generated content」(訳: AIが生成したコンテンツに関するGoogle検索のガイダンス)を公開している。その中の見出しは「Rewarding high-quality content, however it is produced」(訳: 高品質なコンテンツを、どのように作られたかにかかわらず評価する)である。
本文には、ランキングシステムは、専門性・経験・権威性・信頼性を示す、独自で質の高いコンテンツを評価しようとしている、という趣旨が書かれている。作り方ではなく、質を見るという基本線は、今回の更新でも保たれている。変わったのは、AIを使うなら人が確認することを、公式が前面に出した点である。
大量生成の線引きは、スパムポリシーに残っている
今回の文書にも、「using generative AI tools or other similar tools to generate many pages without adding value for users may violate Google's spam policy on scaled content abuse」(訳: 生成AIツールなどを使って、ユーザーに価値を加えないまま多数のページを作ると、大量生成されたコンテンツの不正使用に関するスパムポリシーに違反することがある)と書かれている。
この線は、AIを使うかどうかではなく、価値を加えているかで引かれている。価値を加える作業の中に、人による事実確認が含まれる、と考えるのが自然だろう。このスパムポリシーの読み方は、別の記事(自動生成ページは「量」では裁かれない ── スケールされたコンテンツの悪用に当てはまるかを確認する13項目(2026年9月時点))で13項目にまとめている。
品質評価者向けガイドラインは、順位を直接動かさない
今回の更新は、検索品質評価者向けガイドラインの情報を取り込んだものだと、更新履歴に書かれている。文書の中では、ガイドラインの4.6.5節(大量生成されたコンテンツの不正使用)と、4.6.6節(「main content created with little to no effort, little to no originality, and little to no added value」(訳: ほとんど手間をかけず、ほとんど独自性がなく、ほとんど付加価値のない、主要なコンテンツ))が案内されている。
同じ箇所には、これらのガイドラインは検索で上位に出るための手引きではなく、評価者がランキングシステムの性能を評価するために使うもので、その評価はランキングに直接は影響しない、とも書かれている。順位を動かす仕組みと混同しないように、確認しておきたい。
日本語版は、同じ日にはまだ古い版だった
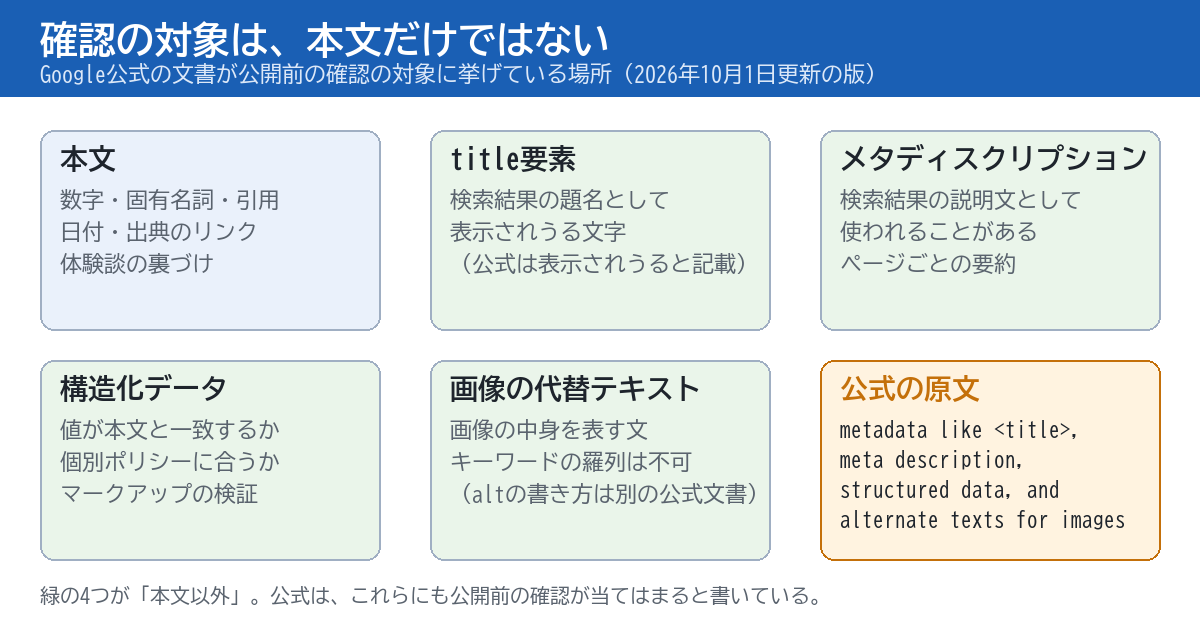
2026年10月2日に日本語版を開くと、最終更新日は2025-12-31と表示されていた。本文には、「正確性、品質、関連性を優先する」という見出しと、title要素・メタディスクリプション要素・構造化データ・画像の代替テキストといったメタデータに触れた文がある。一方、事実確認を求める文、生成モデルの仕組みを述べた文、ハルシネーションの語は、日本語版では見つからなかった。
翻訳が追いつく前の版だった可能性があるが、原因は確認できていない。日本語版だけを読んでいると、今回の強い表現を見落とす。公式文書は、英語版の最終更新日も一緒に確かめるのが安全である。
03 この記事で出てくる用語
ハルシネーションとメタデータ
用語
ハルシネーションは、公式の文では「inaccuracies (also known as hallucinations)」(訳: 不正確な内容(ハルシネーションとも呼ばれる))と書かれている。生成AIが、事実ではない内容を、もっともらしく出力することを指す。メタデータは、ここでは、ページの本文ではなく、title要素・メタディスクリプション要素・構造化データ・画像の代替テキストなど、検索結果に表示されうる付随情報を指す。
構造化データと代替テキスト
用語
構造化データは、ページの内容を、検索エンジンが読み取りやすい決まった形式で書いたもので、記事の日付や著者、商品の価格などを機械向けに示す。代替テキスト(alt)は、画像の中身を文字で説明する属性で、画像を見られない人や、画像を読み取れない機械のために使われる。
大量生成されたコンテンツの不正使用
用語
大量生成されたコンテンツの不正使用は、Googleのスパムポリシーの項目名で、英語では「scaled content abuse」と呼ばれる。ユーザーの役に立つことではなく、検索順位の操作を主な目的に、多数のページを作る行為を指す。生成AIはその手段の一例として、公式文書で名前が挙がっている。
デジタルソースの種類(IPTC)
用語
デジタルソースの種類は、画像などが、どのように作られたかを示すメタデータの規格で、国際的な報道メタデータの団体であるIPTCが定義している。公式文書は、ECサイト向けに、AIが作った画像にはこのメタデータの「TrainedAlgorithmicMedia」を入れる必要がある、というMerchant Centerの方針に触れている。
04 型別 — 適用範囲・この記事が測っていないこと・手順
A. この記事が当てはまる範囲
対象は、AIに下書き、または全文を書かせた記事やページを、自分たちのサイトで公開する場面である。ブログ記事、サービス紹介のページ、お知らせ、商品の説明文まで、考え方は変わらない。公式文書は「ウェブサイトで生成AIコンテンツを使う場合」と範囲を切っている。この記事も、その範囲に合わせる。
B. この記事が測っていないこと
次の3点は、範囲外である。第一に、確認をすれば順位が上がるかどうかは、測っていない。公式が書いているのは正確さと信頼の話であり、順位の話ではない。第二に、10月1日の更新で何行が足されたか、旧版との行ごとの差分は、取得できていない。第三に、検索結果に表示される文字が、実際にtitleや説明文からどれだけ作られているかは、サイトごとに違うため測っていない。
注意
「公式が確認を求めている」ことと、「確認すれば検索で有利になる」ことは別の話である。この記事のチェックリストは、不正確な内容を公開してしまう事故を減らすためのもので、順位を約束するものではない。
C-1. 本文の更新日と版の確かめ方
最初の確認は、AIが書いた「公式は〜と述べている」という文が、今も正しいかどうかである。公式文書は更新されるため、AIが学習した時点の内容と、現在の内容が違うことがある。ページ下部の最終更新日を開き、英語版と日本語版の両方を見る。日付が違うなら、英語版の該当箇所を先に読む。
C-2. titleの確認
Googleは、検索結果に出す題名(タイトルリンク)を、title要素のほか、見出し要素、og:titleなど複数の情報から決めている。公式は「Write descriptive and concise text for your <title> elements」(訳: title要素には、内容を表す簡潔な文を書く)と述べている。AIが作ったtitleは、本文にない数字や、強すぎる断定を含んでいないかを見る。titleの決まり方は、別の記事(検索結果のタイトルは、titleタグだけで決まらない ── Googleが参照する9つの情報源を確認する13項目(2026年9月時点))でも整理している。
C-3. メタディスクリプションの確認
公式は、「A meta description tag generally informs and interests users with a short, relevant summary of what a particular page is about」(訳: メタディスクリプションは通常、そのページが何についてかを示す、短く関連性のある要約で、ユーザーに情報を伝え、興味を持たせる)と述べている。さらに、ページごとに違う説明を書くよう勧めている。AIに複数ページの説明文を一度に書かせると、似た文が並びやすい。使い回しがないかを見る。説明文は、検索結果に必ず採用されるわけではない(meta descriptionは書いても書き換えられる ── Googleが採用する条件と、確認する13項目)。
C-4. 構造化データの確認
構造化データについて、公式の方針文書は「Your structured data must be a true representation of the page content」(訳: 構造化データは、ページの内容を正しく表したものでなければならない)と書き、見えない内容のマークアップや、誤解を招く内容のマークアップを禁じている。AIに構造化データを書かせると、本文にない日付や著者名が入ることがある。画面に見えている値と、一致しているかを見る(手動による対策の条件は構造化データは、構文が正しくても消えることがある ── 手動による対策の条件を確認する14項目)。
C-5. 画像の代替テキストの確認
画像の公式ガイドは、altについて、「Focus on creating useful, information-rich content that uses keywords appropriately and is in context of the content of the page」(訳: 役に立つ情報量のあるaltを、キーワードを適切に使い、ページの内容の文脈に合わせて書く)と述べている。同じガイドは、キーワードを詰め込むことを避けるよう求めている。AIが画像のaltを大量に作ると、同じ語の羅列になりやすい(画像の基本は画像SEOの基本 ── alt属性・次世代フォーマット・遅延読み込みを、公式ガイドで確認する14項目(2026年9月時点))。
C-6. 作り方を読者に伝える
公式文書の最後の節は、確認ではなく「Give users context」(訳: ユーザーに文脈を伝える)である。コンテンツの作り方の情報を共有することが、読者の助けになるとして、自動生成した場合は「consider adding information on how your content was created」(訳: コンテンツがどのように作られたかの情報を加えることを考えてみる)と書かれている。義務ではなく、検討を促す書き方である。
05 明日、自分のサイトで確認できること(13項目)
まず13項目を通して見る
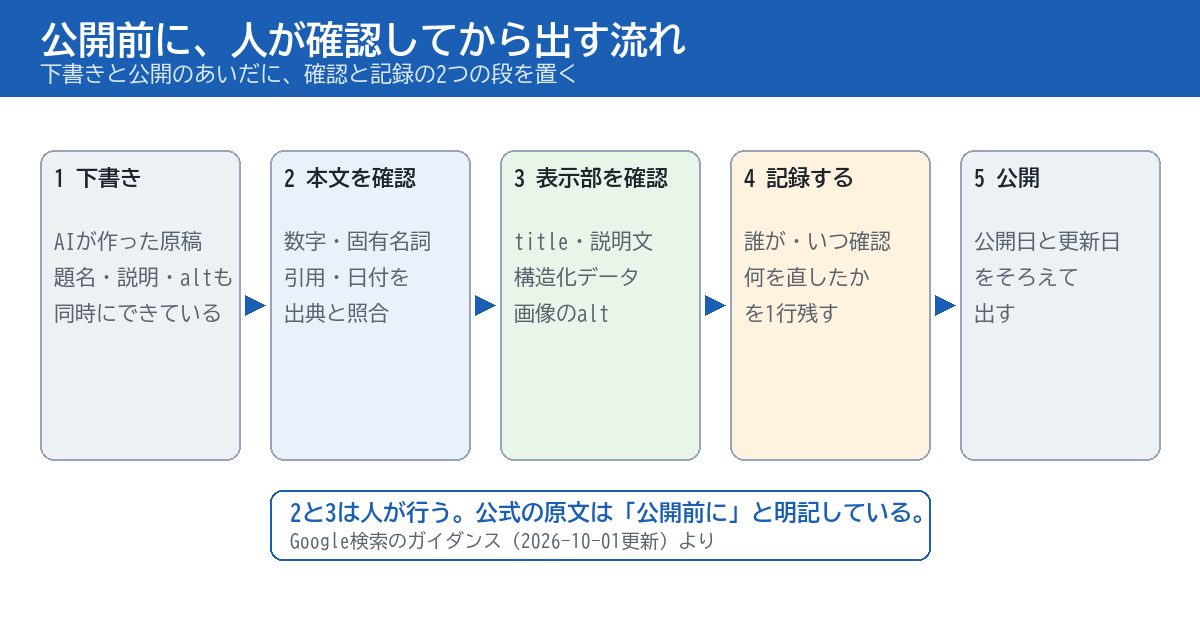
以下は、AIに書かせた記事を1本、手元に置いて、ブラウザだけで確認できる項目である。チェックの状態はブラウザに保存され、サーバーには送信されない。本文の事実確認(数字・引用・固有名詞・体験談)は、AIで作った原稿は、公開前に人が5つ確かめる ── 引用・固有名詞・実体験・重複・責任者を確認する13項目(2026年9月時点)の5つの確認で行う前提とし、ここでは公式文書の更新日と、本文以外の場所に絞っている。
実務のヒント
ページのtitle、メタディスクリプション、構造化データの有無を一度に見たいときは、当サイトの🔧 WEBサイト総合分析・レポートツールが使える。結果は、人が画面と見比べて判断する材料として使う。
- 記事で参照した公式文書を1本開き、ページ下部の最終更新日が記事の執筆日より新しくないか確認する
- 日本語版と英語版がある公式文書は、両方の最終更新日を並べ、日付が違えば英語版の該当箇所を読んで確認する
- 「公式は〜と書いている」と書かれた文を3つ選び、公式の原文を開いて同じ意味か確認する
- ページのtitleを書き出し、本文の結論と食い違う語や、本文に出てこない数字が入っていないか確認する
- ページのソースを開いてメタディスクリプションを探し、本文に書いてある内容だけで書かれているか確認する
- 同じサイトの別の3ページとメタディスクリプションを並べ、文の使い回しがないか確認する
- 構造化データの値(日付・著者・価格など)を3つ選び、画面に見えている本文の値と同じか確認する
- Rich Results TestにページのURLを入れて実行し、エラーと警告の件数を書き留める
- 画像のaltを5つ選び、画像を見ずにaltだけを読んで、何の画像か分かるか確認する
- 同じ5つのaltに、会社名や用語だけが並んだ文がないか確認する
- AIで作った画像が1枚でもあれば、作り方を読者に伝える文やメタデータが付いているか確認する
- 記事の末尾に、AIを使った範囲と確認した人の名前を書いた文が、読者に見える形で載っているか確認する
- 確認した日付・確認した人・直した箇所を、社内の記録に1行書き残す
観点別の内訳と、かかる時間
| 確認する場所 | 該当する項目 | 目安時間 |
|---|---|---|
| 公式文書の更新日 | 1〜3番目(3項目) | 5〜10分 |
| title | 4番目(1項目) | 3分 |
| メタディスクリプション | 5〜6番目(2項目) | 5分 |
| 構造化データ | 7〜8番目(2項目) | 5〜10分 |
| 画像のalt | 9〜11番目(3項目) | 5分 |
| 読者への表示と記録 | 12〜13番目(2項目) | 5分 |
すべてに目を通す時間の目安は、1本の記事あたり25〜40分である。構造化データの確認は、ツールの読み込みに時間がかかることがある。サイト全体のtitleや説明文を見直す場合は、1ページずつ行わず、数ページを選んで同じ手順を繰り返すとよい。
5分で終わらない項目があったとき
公式文書が見つからない、日付が読み取れない、といった項目は、その場で「確認できなかった」と書き残す。そのうえで、確認できなかった内容は、記事から外すか、断定をやめて書き換える。確認できないものを、そのまま公開してはいけない、というのが公式文書の趣旨に沿った扱いである。
06 代替・他の選択肢(表で)
確認の手段は、場所によって違う
05章のチェックリストは、人が画面を見ることを中心にしている。同じ「確かめる」でも、場所ごとに向く手段が違う。検索ツールは速いが、意味が合っているかまでは判断しない。自動のツールは、抜けの発見に向くが、正しさの判断は人に残る。
手段ごとに、できないことも知っておく
| 確認したいこと | 使う手段 | どう使うか | この手段だけでは分からないこと |
|---|---|---|---|
| 公式文書の更新日 | 公式ページを開く | ページ下部の最終更新日を、英語版と日本語版の両方で見る。 | どの文が更新されたかは、日付だけでは分からない。 |
| 構造化データの構文 | Rich Results Test | URLを入れて実行し、エラーと警告の件数と内容を見る。 | 値が本文と合っているかは判断しない。人が見比べる。 |
| titleと説明文の有無 | 当サイトの総合分析ツール | メタタグまわりの状態を一覧で見て、抜けているページを探す。 | 文の内容が事実と合っているかは、人が読んで決める。 |
| リンク先の存在 | 当サイトのリンク確認ツール | ページ内のリンクと画像のアドレスを走らせ、アクセスの状態をまとめて見る。 | リンク先に、書いたとおりの内容があるかは分からない。 |
| 構造化データの下書き | 当サイトの構造化データ作成ツール | 指定したURLの内容から、たたき台を作る。 | 作ったものを、そのまま公開してよいかは、人が確認する。 |
公式が書いていること、書いていないこと
| 場所 | 公式が述べていること | 公式文書で確認できなかったこと |
|---|---|---|
| title | 内容を表す簡潔な文を書く。同じ語の繰り返しを避ける。 | AIが作ったtitleの採用率や、書き換えられる割合。 |
| 説明文 | ページごとに、正確に内容を表す説明を書く。 | AIが作った説明文の評価の違い。 |
| 構造化データ | ページの内容を正しく表す。見えない内容を書かない。 | AIが書いた場合の誤りの発生率。 |
| 画像のalt | 役に立つ情報を、文脈に合わせて書く。語の詰め込みを避ける。 | AIが作ったaltの扱いが、人が書いたものと違うかどうか。 |
右の列が空欄に近いことが、この更新の読み方の要点になる。公式はAIが作ったかどうかで評価を変える、とは書いていない。書いているのは、AIが作ったものは間違いを含みうるから、人が見直せ、という確認の話である。
07 AIに任せてよいところ・人が最後に見るところ
AIに任せてよいところ
公式文書は、生成AIが、あるテーマを調べるときや、オリジナルのコンテンツに構成を与えるときに役に立つ、という趣旨を述べている("to add structure to original content"、訳: オリジナルのコンテンツに構成を加えること)。実務では、見出し案の洗い出し、長い資料の要約、構造化データの下書き、altの下書きのような、叩き台を速く作る作業に向く。AIに下書きを作らせること自体を、公式は止めていない。
人が最後に見るところ
人が最後に見るのは、叩き台が事実と合っているかである。数字・日付・固有名詞に加えて、検索結果に出うるtitle・説明文・構造化データ・altを、公開の直前にもう一度見る。読者が最初に目にする場所ほど、間違いの影響が大きい。本文の隅にあった間違いは、読者が気づかないかもしれないが、titleの間違いは、検索結果の画面で全員の目に入る。
確認した人の名前を、記録に残す
公式文書は、確認者の記録そのものを求めてはいない。ただ、公開後に間違いが見つかったとき、誰がいつ、何を見たのかが残っていないと、直す手がかりが失われる。社内の記録に1行残す運用は、AIを使う記事が増えるほど効く。当サイトで、書き手が同じでも文章の書き方が変わることを数えて確かめた記録が、同じ書き手なのに、仲間への手紙だけが崩れていた ── 7か月分の文章を数えたら、記号は約100倍。公開記事は変わっていなかったにある。
実務のヒント
確認の記録は、凝った書式にしなくてよい。「日付・確認者の名前・確認した場所・直した箇所」の1行で足りる。
タイトルは、公式の見出しのままにしない
AIに記事のtitleを書かせると、参照した公式文書の見出しが、そのまま出てくることがある。中身は書き直されているのに、看板だけが公式の見出しのままだった例は、チェックリストに、タイトルは無かった ── 中身は書き直されていたのに、看板だけが公式ドキュメントの見出しのままだったに記録した。titleの確認は、本文より後回しになりやすいので、チェックリストに入れておく価値がある。
08 このテーマの、これまで
公式の方針は、3つの時点で読み取れる
AIが作ったコンテンツへの公式の姿勢は、時点ごとに読み取れる。2023年2月の検索ブログは、作り方ではなく質で評価するという線を示した。2024年3月のブログでは、大量生成されたコンテンツの不正使用が、スパムポリシーの項目として案内された。そして2026年10月1日の文書の更新では、公開前に人が事実を確認することが、「critical」の語で前面に出た。
3つを並べると、一貫しているのは「質を見る」という点で、強まったのは、AIを使う側の確認の責任の書き方である。どの時点の文書も、AIの使用そのものを禁じてはいない。
当サイトの過去の記事から
AIで作る記事の扱いは、当サイトの記事でも繰り返し取り上げてきた。公式の立場を確認した記事(AI生成コンテンツは検索でどう評価されるのか ── Googleの公式見解と、品質評価ガイドラインの実際の記述(2026年8月時点)、Googleは「AIコンテンツ」を罰していない ── 33.1万ページの調査が示した「品質」基準を確認する13項目(2026年9月時点))、公開前に人が確かめる5つの項目(AIで作った原稿は、公開前に人が5つ確かめる ── 引用・固有名詞・実体験・重複・責任者を確認する13項目(2026年9月時点))、AIに指示するときの曖昧さの問題(曖昧な指示は、AIに渡すと大量に繰り返されうる ── 書かせる前に社名・商品名・用語のゆれを確認する13項目(2026年9月時点))がある。品質評価ガイドラインの改訂の流れは、検索品質評価ガイドラインは2025→2026でこう変わった — AIに評価される時代、WEBディレクターが読むべき“Googleの設計図”で整理した。
今回の記事は、それらが「検索でどう扱われるか」「書かせる前の準備」「本文の確認」を扱っていたのに対し、本文の外にある、検索結果に出る場所の確認に絞っている。同じ内容の記事が複数にならないよう、役割を分けている。
数字と文言は、確認した時点のものとして扱う
この記事で引用した公式の文言と最終更新日は、2026年10月2日に確認したものである。公式の文書は、数か月のうちに書き換わることがある。日本語版の更新が追いつけば、今回確認できなかった文も載るかもしれない。引用するときは、公式ページを開いて、その時点の文言を確かめてほしい。
現在の貴方のIPアドレス
このサイトで書いている人