WEBサイト
AIで作った原稿は、公開前に人が5つ確かめる ── 引用・固有名詞・実体験・重複・責任者を確認する13項目(2026年9月時点)
AIで作った原稿は、公開前に人が5つ確かめる ── 引用・固有名詞・実体験・重複・責任者を確認する13項目(2026年9月時点)
目次
01 何が起きたか — AIで制作は速くなった。良くなったかは、別の話として残っている
制作の速度は上がった。しかし「良くなったか」の議論は追いついていない
生成AIを使えば、記事の下書き、広告文、メールマガジン、商品説明が数分で出てくる。制作の現場では、この「速さ」がすでに前提になった。一方で、速く作れるようになったことと、作ったものが以前より良くなったことは、別の話である。速度は時計で測れるが、品質は「誰が、何を基準に、いつ確かめたか」がなければ測れない。
この記事は、AIで作った原稿を公開する前に、人が確かめるべきことを、WEBディレクターが5分ずつ実行できる形にまとめたものである。Google検索の公式文書に書かれていることと、書かれていないことを分けたうえで、最後に13項目のチェックリストを置く。
素材にした論説は、統計ではなく現場の観察である
出発点にしたのは、マーケティング業界の専門メディアMarTechに掲載された、Kath Pay氏(メールマーケティングの専門会社の経営者)の論説「AI made marketing faster than it made marketing better」(訳: AIはマーケティングを速くしたが、良くはしなかった)である。要旨は、ボトルネックが「書くこと」から「何を書くかを決めること」に移ったという指摘だ。下書きが速く出てきても、承認の流れが詰まる問題や、方針が弱いという問題は消えない。むしろ弱い指示から、もっともらしい文章が素早く出てくる分だけ、弱さが見えにくくなる、という主張である。
確認できた範囲では、この論説は外部の統計や調査を引用していない。書き手の職業経験にもとづく観察と意見であり、数字で証明された結論ではない。したがって、この記事はその主張をそのまま事実として扱わず、「速さの陰で確認が抜けやすい」という論点だけを借りる。確認の中身は、Googleの公式文書に当たり直して組み立てた。
公式情報
素材にした論説:AI made marketing faster than it made marketing better(訳: AIはマーケティングを速くしたが、良くはしなかった)(MarTech)。統計は引用されておらず、意見として読む。
Google公式の立場は、AIの使用そのものを問うていない
WEB担当者が最初に気にするのは、「AIで作った原稿は検索で不利になるのか」という点だろう。Googleは、生成AIをコンテンツ制作に使うことについて専用のガイダンスを公開している。そこには、生成AIは「あるトピックを調査したり、オリジナル コンテンツに構造化データを追加したりする際に特に便利です」という趣旨が書かれている。同時に、ユーザーにとっての価値を付加することなく大量のページを生成すると、スパムポリシーに違反しうるとも書かれている。
つまり、問われているのはAIを使ったかどうかではなく、価値があるか、正確か、責任の所在が分かるかである。この3点を、公開ボタンを押す前に人が確かめる作業が、次章以降のテーマになる。
02 なぜ・背景 — Googleが問うのは「AIか」ではなく「価値と責任」である
Googleが「AI」ではなく「価値」を問う理由
Googleのスパムポリシーは、大量生成されたコンテンツの不正使用を次のように定義している。「大量生成されたコンテンツの不正使用とは、ユーザーをサポートすることではなく、検索ランキングの操作を主な目的として大量のページを生成することを指します。」定義の中心は「主な目的」と「大量」であり、使った道具の種類ではない。
具体例のひとつには、「生成 AI ツールまたはその他の同様のツールを使用して、ユーザーにとっての価値を付加することなく大量のページを生成すること」が挙がっている。ほかにも、複数のページの内容を価値を加えずにつなぎ合わせること、検索キーワードを含むだけで読者にとってほとんど意味のないページを大量に作ることなどが並ぶ。AIで作ること自体は例に入っておらず、価値を伴わない量産が例に入っている。該当するコンテンツを自分のサイトに置いている場合は、検索から除外できる、と公式は説明している。
「誰が・どのように・なぜ」という3つの問い
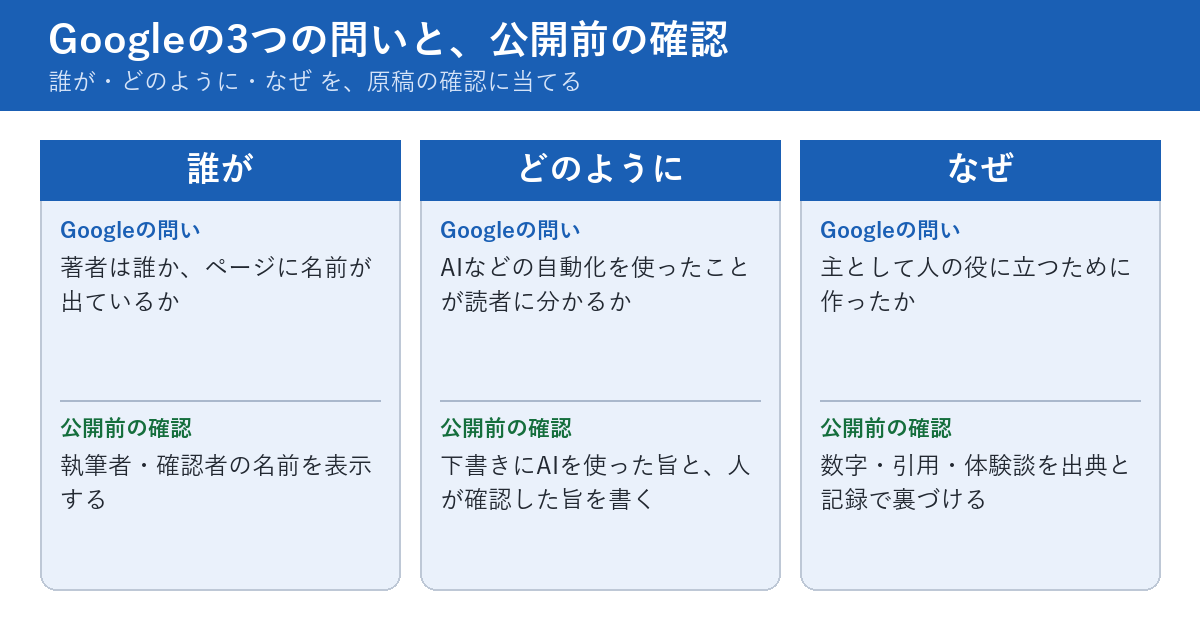
もうひとつの公式文書は、役に立つ信頼できるユーザー第一のコンテンツを作るための自己点検として、「誰が」「どのように」「なぜ」という3つの問いを置いている。「誰が」については、「コンテンツの著者が誰であるかを明確にしていますか」と問い、ページの然るべき場所にバイライン(著者の表示)があるかも問う。英語版では、"Is it self-evident to your visitors who authored your content?"(訳: 訪問者にとって、コンテンツの著者が誰かは自明ですか)という形で書かれている。
「どのように」については、「AI による生成などの自動化を使用していることを、開示などの方法でユーザーに対して明確にしていますか」と問う。自動化を使うこと自体は禁じられていないが、使ったことが読者に分かる形になっているかが点検項目になっている。「なぜ」は、主として人々の役に立つコンテンツを作ることが目的か、という問いである。
品質評価ガイドラインの2つの節
Googleの生成AI向けガイダンスは、品質評価者向けのガイドライン(Search Quality Rater Guidelines)にも触れている。大量生成されたコンテンツの不正使用が4.6.5節、主要なコンテンツが「little to no effort, little to no originality, and little to no added value」(訳: ほとんど手間をかけず、ほとんど独自性がなく、ほとんど付加価値がない)で作られた場合が4.6.6節として案内されている。
この2つの節が示すのは、評価の観点が「手間・独自性・付加価値」にあることだ。AIで速く作った原稿に、その3つが残っているかどうかは、原稿を最後に読む人が判断するしかない。品質評価者は検索順位を直接決める存在ではないが、Googleがどんな品質を良し悪しとして見ているかを知る手がかりになる。
公式が書いていないことも、確認しておく
公式文書には、「AIで書いた原稿の事実確認は、何割の項目を人が見ればよい」といった具体的な割合や手順は書かれていない。確認した3つの文書(生成AIのガイダンス、役に立つコンテンツ、スパムポリシー)に、そうした数値は見当たらなかった。この記事の「5つの確認」「各5分」という区切りは、公式の基準ではなく、実務で回しやすいようにこの記事が組み立てた目安である。公式の手順ではなく、公式の問いを作業に落とした案として読んでほしい。
03 この記事で出てくる用語
大量生成されたコンテンツの不正使用(scaled content abuse)
用語
大量生成されたコンテンツの不正使用(scaled content abuse):ユーザーの役に立つことではなく、検索ランキングの操作を主な目的として、大量のページを作ること。Googleのスパムポリシーの項目のひとつ。作り方(人か、AIか)ではなく、目的と価値で判断される。
よくある誤解は、「AIを使うと、この項目に自動的に当たる」というものである。公式の書き方では、1本ずつ丁寧に確認して公開する運用は、この項目の主旨とは別の話になる。
バイライン(byline)
記事の冒頭や末尾に置く、執筆者・監修者の表示を指す。公式は、ページに著者情報を表示することを強く推奨している。構造化データで著者を示す場合は、記事の構造化データのauthorに、名前とその人を識別できるページへのリンクを添える形が案内されている。
事実確認と校正の違い
校正は誤字・表記ゆれ・文体を整える作業で、文章の中で完結する。事実確認は、原稿に書かれた数字・引用・日付・固有名詞が、原稿の外にある出典と合っているかを照らす作業である。AIが作る原稿は文章としては整っていることが多いため、校正で問題が出にくい。そのぶん、事実確認は「文章を読むだけでは見つからない」ことを前提に、出典を開いて行う。
Googleは生成AIコンテンツをどう扱っているか — ガイダンスの原文から
ここまでの要点を、公式のガイダンスの原文で確かめておく。Googleの生成AI向けガイダンスは、まず問題になる場合を、こう書いている。
"However, using generative AI tools or other similar tools to generate many pages without adding value for users may violate Google's spam policy on scaled content abuse."
(訳: ただし、生成AIツールやそれに似たツールを使って、ユーザーにとっての価値を付け加えないまま多数のページを作ることは、Googleの「大量生成されたコンテンツの不正使用」に関するスパムポリシーに違反する可能性がある。)
同じガイダンスには、日本語版で「生成 AI は、あるトピックを調査したり、オリジナル コンテンツに構造化データを追加したりする際に特に便利です」という趣旨の記述もある。使うこと自体は否定されておらず、価値を付け加えないまま数だけを増やすことが問題として書かれている。また、コンテンツの作り方の情報を読者と共有することについても、次のように触れている。
"Sharing information about how a piece of content was created can help give your readers more context."
(訳: あるコンテンツがどのように作られたかについての情報を共有することは、読者により多くの背景を伝える助けになる。)
バイラインと構造化データの author プロパティについて、公式が言っていること
著者の表示については、役に立つコンテンツの解説に、次の一文がある。
"We strongly encourage adding accurate authorship information, such as bylines to content where readers might expect it."
(訳: 正確な著者情報を、たとえば読者が期待しそうな場所のコンテンツにバイラインを付けるなどして、加えることを強く推奨します。)
記事の構造化データの文書は、author に作成者を個別に書くこと、種類(Person か Organization)と名前、その人や組織を識別できるページへのリンク(url または sameAs)を添えることを案内している。公式が「推奨」と書いているのは、著者情報の表示と、その書き方までである。ランキングにどれだけ影響するかについて、確認した文書は数値も断定も示していない。
04 型別 — 適用範囲・この記事が測っていないこと・手順
A. この記事が当てはまる範囲
対象は、AIに下書き、または全文を書かせた原稿を、自社サイトや自社の媒体で公開する場面である。記事、ランディングページの文章、商品説明、メールマガジン、プレスリリースまで、考え方はほぼ同じだ。検索から集客する原稿でも、既存顧客に送る文書でも、数字と引用の確認、実体験の有無、重複、責任者の表示という5つの確認は共通して必要になる。
B. この記事が測っていないこと
次の3点は、この記事の範囲外である。第一に、5つの確認をすれば検索順位が上がるかどうかは測っていない。確認は品質と信頼を守るための作業であり、順位を保証する手順ではない。第二に、景品表示法・薬機法・著作権のような法律面の適否は、専門家の判断が要る領域なので扱わない。第三に、特定の生成AIサービスの誤りやすさや、サービス間の精度の比較も測っていない。
注意
「確認した」と「正しかった」は別である。出典を開いて数字が一致したとしても、その出典自体が古い場合や、二次情報の孫引きである場合がある。この記事のチェックリストは、原稿と出典の食い違いを見つけるためのもので、出典そのものの正しさまでは保証しない。
C. 手順の全体像 — 5つの確認を、5分ずつ
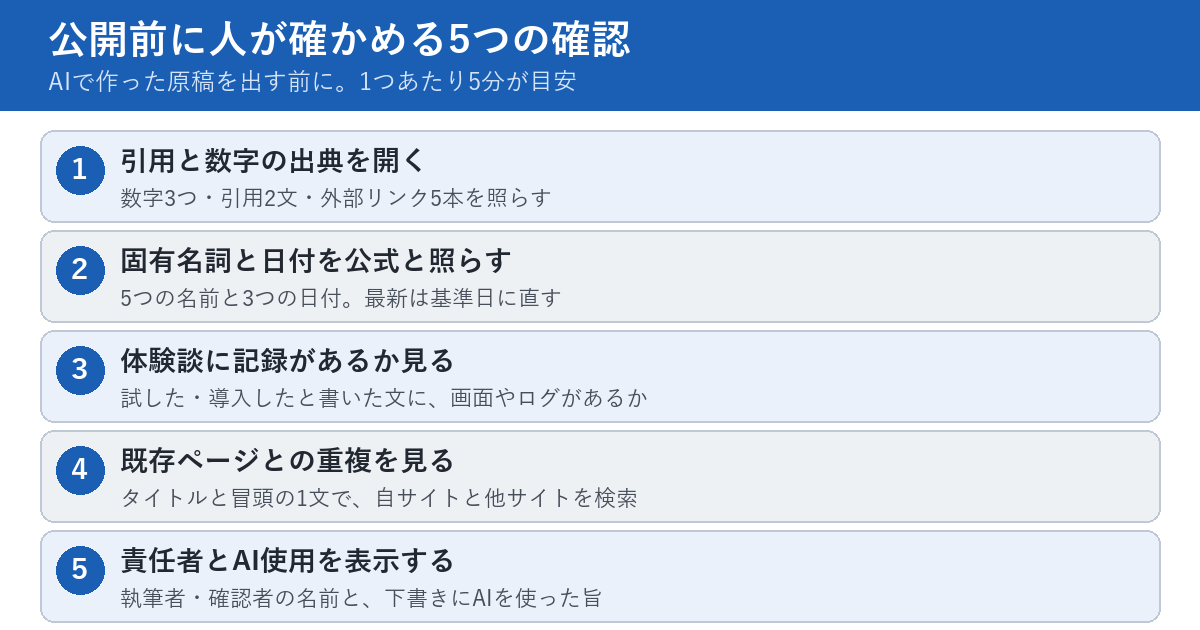
確認は次の5つに分ける。1つ目は引用と数字の出典を開くこと、2つ目は固有名詞と日付を公式の表記と照らすこと、3つ目は「試した」「使った」という体験談に本当の記録があるかを見ること、4つ目は同じ内容の既存ページと重なっていないかを見ること、5つ目は誰が責任を持つかをページに表示することである。1つあたり5分を目安にすれば、1本の原稿で25分前後で一巡できる。
なぜ「5つ」に絞るのか
確認項目を増やせば安全になるとは限らない。項目が多すぎると、毎回すべてを行う運用が続かなくなり、結局は抜けが出る。5つに絞ったのは、AIが作る原稿に特に出やすい弱点を選んだためである。数字や引用のもっともらしい間違い、日付とバージョンのずれ、経験していない体験談、似た記事の重複、そして誰の責任か分からない状態。この5つは、文章の出来栄えとは無関係に発生する。
05 明日、自分の原稿で確認できることチェックリスト
まず13項目を通して見る
以下は、明日、AIで作った原稿1本を手元に置いて、ブラウザと検索窓だけで確認できる項目である。チェックの状態はブラウザに保存され、サーバーには送信されない。5つの確認ごとに、項目が並んでいる。
実務のヒント
サイト内のリンク漏れを一度に確認したいときは、当サイトの🔧 WEBサイト内のリンク漏れ・チェックツールが使える。AIが原稿中に入れた内部リンクの行き先が、実際に存在するかを見るときの補助になる。
- 原稿に出てくる数字を3つ選び、それぞれの出典ページを開いて、原稿と同じ数字が書かれているか確認する
- 原稿の中で「」で引用した文を2つ選び、出典ページの原文と一字一句照らし合わせて確認する
- 原稿にある外部リンクを上から5本開き、ページが表示されるか、書かれた内容が出典に実際にあるか確認する
- 原稿の固有名詞(人名・社名・製品名・サービス名)を5つ書き出し、公式サイトの表記と1文字ずつ照らして確認する
- 原稿に出てくる日付とバージョン番号を3つ選び、公式の更新履歴やリリースノートで確認する
- 「最新」「現在」「今年」と書かれた箇所を全部探し、「2026年9月時点」のような基準日つきの書き方に直す
- 原稿の「試した」「導入した」という記述を3つ選び、自社で実際に行った記録(画面・ログ・メモ)があるか確認する
- 記録が見つからない体験談の文は、一般論の言い方に直すか削除する
- 原稿のタイトルで自サイト内を検索し、似た内容の記事が上位10件に既にないか確認する
- 原稿の冒頭の1文を引用符で囲んで検索窓に貼り、他のサイトに同じ文が出ないか確認する
- 公開ページに、執筆者または監修者の名前が表示されているか確認する
- 記事の末尾に、AIを下書きに使ったことと、誰が確認したかを書いた1文があるか確認する
- 公開日から7日後と30日後に、原稿の数字を出典と見直す予定を、カレンダーに2件入れる
観点別の内訳と、かかる時間
| 確認 | 該当する項目 | 目安時間 |
|---|---|---|
| 1 引用と数字 | 1〜3番目(3項目) | 5〜10分 |
| 2 固有名詞と日付 | 4〜6番目(3項目) | 5〜10分 |
| 3 体験談 | 7〜8番目(2項目) | 5分 |
| 4 重複 | 9〜10番目(2項目) | 5分 |
| 5 責任者の表示 | 11〜13番目(3項目) | 5分 |
すべてに目を通す時間の目安は、1本の原稿あたり25〜35分である。外部リンクの確認は、出典ページの読み込みに時間がかかるため、余裕を見ておくとよい。サイト全体のタイトルや説明文の状態を確認したいときは、当サイトの🔧 WEBサイト総合分析・レポートツールで、公開済みページの技術的な状態をまとめて見ることもできる。
5分で終わらない項目があったとき
出典が有料の資料である場合や、公式の更新履歴が見つからない場合は、その項目を「確認できなかった」と原稿の脇に書き残す。そのうえで、確認できなかった数字は原稿から外すほうが安全である。確認できないまま残す場合は、「〜とされている(出典未確認)」のように、確かめていないことが読者に分かる書き方にする。5分で終わらないことを理由にチェックを飛ばすと、確認そのものが形だけになる。
06 代替・他の選択肢(表で)
確認手段は1つではない
05章のチェックリストは、人が出典を開くことを中心にしている。ただ、同じ「確かめる」でも、手段によって見えるものが違う。検索窓での重複確認は速いが、他サイトの本文の言い換えまでは拾えない。出典を開く確認は確実だが、原稿1本あたりの時間がかかる。1つの手段だけで「公開してよい」と判断せず、複数を重ねることで、それぞれの死角を補える。
それぞれの手段が「できないこと」も知っておく
| 確認したいこと | 使う手段 | どう使うか | この手段だけでは分からないこと |
|---|---|---|---|
| 数字・引用の一致 | 出典ページを人が開いて照らす | 原稿の数字を1つずつ声に出して読み、出典の同じ箇所に同じ数字があるかを見る。見つからない数字は原稿から外す。 | 出典自体が古い場合や、孫引きの場合は見抜けない |
| 既存の検証記事の有無 | Googleのファクトチェック検索(Fact Check Explorer) | 原稿の中の主張を短い言葉にして検索し、第三者の検証記事があれば出典として開く。なければ「検証は見つからなかった」と控えておく。 | 検証されていない主張は、ヒットしないだけで正しいとは限らない |
| 自サイト内の重複 | サイト内検索・site:検索 | 原稿のタイトルと主要な語で、自サイトの既存記事を上位10件まで開き、同じ結論の記事があれば統合するか書き分ける。 | 言い換えられた同じ内容は、キーワードが違うと出てこない |
| 内部リンクの行き先 | 当サイトのリンク漏れ確認ツール | 公開前後に走らせて、原稿に入れた内部リンクのうち、行き先が表示されないものを洗い出す。 | 行き先の内容が、アンカーの文言と合っているかは判定できない |
| 著者の構造化データ | 記事の構造化データ(Article)の書き方を見て、たたき台を作る | 執筆者の種類と名前、その人を識別できるページのリンクを埋め、公開日時と更新日時も添える。 | 構造化データがあっても、検索結果での表示までは保証されない |
公式の構造化データのガイドは、日付について、公開日時と更新日時を国際規格のISO 8601の形で書き、タイムゾーンの情報も添えることを勧めている。著者情報の整備については、当サイトの🔧 WEBサイト・構造化データ自動作成ツールで、たたき台のファイルを作るところから始められる。
校正ツールと人の事実確認は、見つけるものが違う
AIで作った原稿は、文章が整っていることが多い。そのため、誤字や表記を見る校正ツールを通しただけで「確認した」と感じやすい。校正ツールと人の事実確認は、見つけられるものが重ならない。特定の製品の優劣ではなく、手段の種類ごとに何が見つかり、何が見つからないかを表にまとめる。
| 見たいこと | 校正ツール(誤字・表記を見る) | 人の事実確認(出典を開く) |
|---|---|---|
| 誤字・脱字 | 見つけられる | 読めば気づくが、見落としも出る |
| 表記ゆれ | 見つけられる | 基準を決めていないと揃わない |
| 数字が出典と合うか | 見つけられない(文として正しければ通る) | 出典を開けば見つけられる |
| 引用が原文と一致するか | 見つけられない | 原文と照らせば見つけられる |
| 存在しない出典 | 見つけられない | リンクを開けば気づける |
| 体験談の裏づけ | 見つけられない | 記録の有無を書き手に確かめて見つける |
| 時点の古さ | 見つけられない | 公式の更新履歴と照らして見つける |
校正ツールは不要ではない。機械で文章の乱れを拾ってから人が出典を開く順番なら、人の5分を、機械では見つからない部分に集中できる。
数える手段と読む手段を分ける
確認の手段は、大きく「数える」と「読む」に分かれる。リンクが生きているか、同じタイトルの記事がいくつあるか、著者名が表示されているか、といった項目は、機械的に数えられる。一方で、引用が文脈を歪めていないか、体験談が本当にその人の経験か、といった項目は、人が読んで判断するしかない。数える作業はツールに任せ、読む作業に人の時間を残す、という配分が現実的である。
07 AIに任せてよいところ・人が最後に見るところ
AIに下書きを任せてよいところ
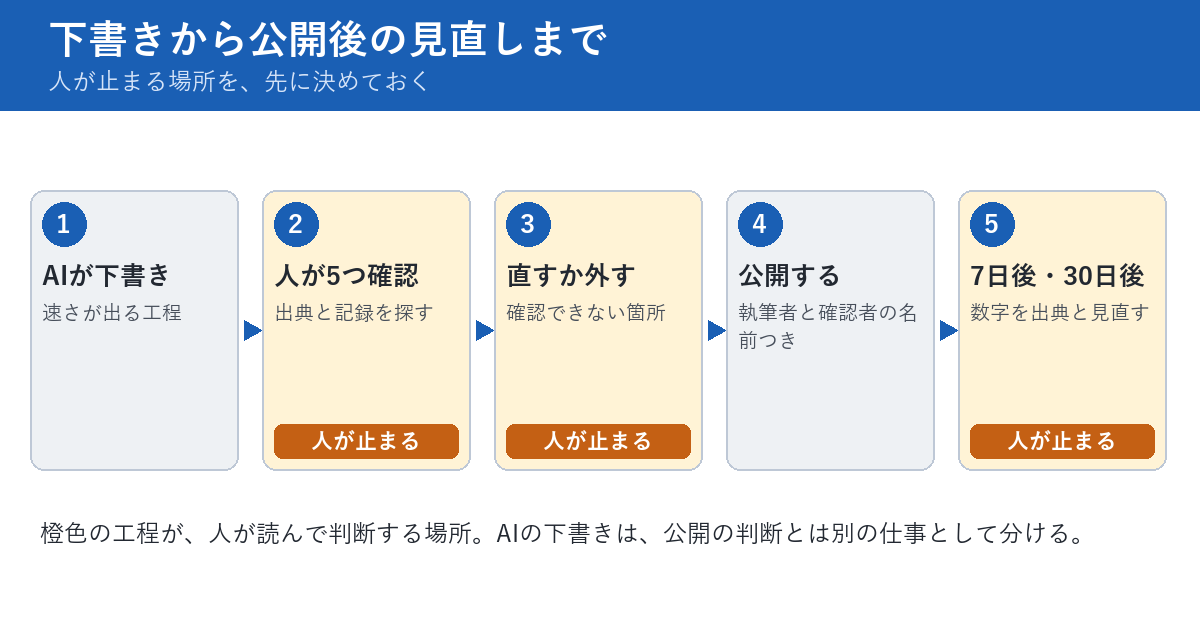
Googleの生成AIのガイダンスが述べるとおり、生成AIは調べ物や、構造化データの下書きに向いている。実務では、構成案の作成、見出し候補の洗い出し、長い資料の要約、表記ゆれの検出などを任せやすい。下書きを速く作ることと、公開してよいと判断することは、別の仕事として分けておくと、責任の所在が曖昧にならない。
人が最後に見るところ
人が最後に見るのは、5つの確認のうち「読んで判断する」部分である。数字が出典と合っているか、引用が文脈を歪めていないか、体験談に記録があるか、誰の名前で公開するか。この4つは、AIが「もっともらしく」書いてしまう領域でもある。AIは、経験していないことも、経験したかのような文体で書ける。読者が体験談として受け取る文には、書き手の側に必ず実体験の記録が要る。
注意
商品画像や商品データは、検索結果とは別のルールがある。Google Merchant Centerでは、AI生成の画像には IPTC の DigitalSourceType というメタデータを含める必要があると、生成AIのガイダンスに書かれている。原文は "AI-generated images must contain metadata using the IPTC DigitalSourceType TrainedAlgorithmicMedia metadata."(訳: AI生成の画像には、IPTCのDigitalSourceType TrainedAlgorithmicMedia のメタデータを含めなければならない)である。商品ページの原稿を扱う場合は、この点も別途確認する。
企業ブログで公開するときの、承認の順番
企業のブログでAIの原稿を出す場合は、確認を1人で抱えず、順番を決めておくと止まりにくい。たとえば、書き手が05章の13項目を一巡し、確認できなかった箇所に印を付けて渡す。次に、編集者や広報が数字と固有名詞の照合結果を読む。最後に、公開の可否を決める責任者が、執筆者と確認者の表示を含めて承認する。誰が何を確認したかを、承認の記録として残すと、公開後に数字を直すときの連絡先が分かる。
書き手が複数いるときの表示
AIが下書きを作り、複数の人が手を入れる場合は、記事に載せる名前の決め方でつまずく。公式の考え方は、著者が誰かがページで分かることにある。実務では、最終的な責任を持つ人を執筆者または監修者として表示し、AIを下書きに使った旨は別の1文で書く。AIの名前を著者欄に並べるのではなく、責任を持つ人の名前を表示すると、読者が「誰に責任があるか」を迷わない。構造化データの author も、同じ人に揃えておく。
法務や専門家の確認に回すもの
05章の13項目は、事実と出典の確認である。次のような内容は、この確認では判断できないので、社内の法務担当や外部の専門家に回す。効能や効果をうたう表現、他社との比較、価格や割引の表示、他者の文章や画像の利用、契約や個人情報に関する記述。迷ったものは、公開前に専門家へ渡すと決めておくとよい。
当サイトでの実際
当サイトの記事は、AIが下書きを作り、運営者が読んで確認してから公開する流れで作られている。その過程で、書いた数字が後から食い違っていた記録が、ブログにいくつも残っている。たとえば「AIは331回来たと書いた。実際は11,024回だった ── HTTPのログだけを52日間 見ていた」、「「AIからの流入60件」を数え直したら、60件ともAIが自分の名前を名乗った文字列だった ── ログを行全体で探すと、正反対の2つが混ざる」がある。
タイトルの付け方についても、「チェックリストに、タイトルは無かった ── 中身は書き直されていたのに、看板だけが公式ドキュメントの見出しのままだった」という記録がある。文章が整っていることと、数字や看板が正しいことは、別の確認になる。同じことは、どの媒体のAI原稿にも当てはまる。
08 このテーマの、これまで
公式ガイダンスの更新の跡
ここまでに引用した公式文書は、それぞれ更新の時期が異なる。日本語版に表示された最終更新日は、生成AIのコンテンツに関するガイダンスが2025年12月31日、役に立つ信頼できるコンテンツの解説が2025年12月18日、スパムポリシーが2026年9月2日、記事の構造化データが2026年9月12日である。基本の考え方は続いているが、細部の文言は今も更新され続けている。
特にスパムポリシーは直近の更新なので、大量生成に関する記述を引用するときは、公式ページを開いて現在の文言を確かめるのが確実である。
当サイトの過去の記事から
AIと品質をめぐる論点は、当サイトの記事でも繰り返し扱ってきた。Googleは「AIコンテンツ」を罰していないという公式の立場を確認した記事(Googleは「AIコンテンツ」を罰していない ── 33.1万ページの調査が示した「品質」基準を確認する13項目(2026年9月時点))、品質評価ガイドラインの記述を確認した記事(AI生成コンテンツは検索でどう評価されるのか ── Googleの公式見解と、品質評価ガイドラインの実際の記述(2026年8月時点))、量産が問題になる条件を整理した記事(自動生成ページは「量」では裁かれない ── スケールされたコンテンツの悪用に当てはまるかを確認する13項目(2026年9月時点))がある。
これらは「検索でどう扱われるか」を中心にしていた。今回の記事は、その手前にある、公開ボタンを押す前に人が何を見るかに絞っている。同じ内容の記事が2本にならないよう、既存の記事に書いたことは繰り返さず、確認の作業に寄せた。サイト内に同じ内容の記事が2本ないかの確かめ方は、ブログでも整理している(「自分のサイトに、同じ記事が2本ないか」を5分で確かめる ── タイトルで探すと45組、元記事で探すと139組。3倍 違った)。
大量生成コンテンツの「違反件数」に、公式の数字はあるか
「AIで大量に作ったページは、実際にどれだけ違反と判定されているのか」を知りたくなるが、確認した範囲では、公式の件数は見つからなかった。Google検索セントラルのブログで、大量生成されたコンテンツの不正使用という項目が発表されたのは2024年3月5日で、同じ日に「2024年3月のスパムアップデート」も始まっている。この告知は、新しい3つのスパムポリシー(期限切れドメインの不正使用、大量生成されたコンテンツの不正使用、サイトの評判の不正使用)を紹介しているが、違反したページの件数や割合は載せていない。
告知の中には、AIの扱いを確認する問い合わせに答える形の文がある。"Our long-standing spam policy has been that use of automation, including generative AI, is spam if the primary purpose is manipulating ranking in Search results."(訳: 私たちの長年のスパムポリシーは、生成AIを含む自動化の利用は、主な目的が検索結果での順位の操作であるならスパムである、というものです。)また、この項目は「no matter whether content is produced through automation, human efforts, or some combination of human and automated processes」(訳: 自動化で作られたか、人の手で作られたか、両者の組み合わせで作られたかを問わず)適用される、とも書かれている。問われるのは作り方ではなく、目的と価値である。
同じブログには、過去のスパム対策の年次報告(2015年から2022年までの各年の報告)も掲載されているが、確認した一覧に、大量生成されたコンテンツの不正使用を対象にした年次報告は見当たらなかった。第三者が出す件数は公式の数字ではないため、この記事では件数を書かない。
公式情報
大量生成されたコンテンツの不正使用の発表:What web creators should know about our March 2024 core update and new spam policies(訳: 2024年3月のコアアップデートと新しいスパムポリシーについて、ウェブ制作者が知っておくべきこと)(Google Search Central ブログ・2024年3月5日)
数字は確認した時点のものとして扱う
この記事で引用した公式の文言と最終更新日は、2026年9月に確認したものである。MarTechの論説は、その後に修正・追記されている可能性がある。公式ガイドも、数か月のうちに書き換わることがある。基準日を書かない原稿は、時間が経つほど誤りに近づく。05章の6番目の項目に基準日の書き換えを入れたのは、そのためである。この記事を使うときも、必要に応じて公式ページを直接開き、最新の記載を確かめてほしい。
現在の貴方のIPアドレス
このサイトで書いている人