WEBサイト
AIエージェントが作ったサイトでも、Googleが見る土台はたった3つ ── 公開前に確認する13項目(2026年9月時点)
AIエージェントが作ったサイトでも、Googleが見る土台はたった3つ ── 公開前に確認する13項目(2026年9月時点)
目次
01 何が起きたか — AIエージェントが作ったサイトが増え、公開前チェックの記事も増えている
生成AIエージェントに指示するだけで、サイトが1本できる時代
生成AIエージェントに指示を出すだけで、コーポレートサイトやランディングページ(LP)を丸ごと組み立てる使い方が、2026年になって珍しくなくなった。業界メディアのAINOWは2026年9月13日付で「AIエージェントでサイトを制作する7ステップとおすすめツール10選」を、続けて「AIエージェントでLPを制作する6ステップとおすすめツール8選」を公開している。どちらの記事にも「公開前チェック」を独立した章として置いているという共通点があり、制作の手順そのものより、この「公開前に何を見るか」という部分に、WEBディレクターが確認すべき論点が集まっている。
「見た目が整っているLPほど確認が甘くなる」という指摘
LP制作を扱った記事は、公開前チェックの章をこう始めている。
「見た目が整っているLPほど確認が甘くなり、公開後の指摘につながります。」
(AINOW「AIエージェントでLPを制作する6ステップとおすすめツール8選」より)挙げられている確認項目は、訴求ロジックの一貫性・景品表示法や薬機法にあたる表現の有無・生成した画像やフォントの利用条件・タイトルタグやメタディスクリプション・表示速度など、多岐にわたる。もう一方のサイト制作を扱った記事は、制作手順の段階(ステップ5:CMSと問い合わせ導線を組み込む)でも、フォームについて次のように注意を促している。
「問い合わせフォームは送信テストまで行い、迷惑メール判定で届かない事態を防いでください。」
(AINOW「AIエージェントでサイトを制作する7ステップとおすすめツール10選」より)
これらは二次情報。確認は公式ドキュメントに当たり直す
上の2つの指摘は実務上重要である一方、AINOWという業界メディアがまとめた二次情報である。景品表示法・薬機法の該当性は法律の専門知識が要る領域であり、本記事の範囲外とする(04章で改めて明記する)。ここから先は、Google検索が公式に定めている技術要件を、公式ドキュメントに当たり直しながら確認する。Search Essentialsは、検索結果に表示するための条件を、こう説明している。
「技術要件は、ウェブページが Google 検索の検索結果に表示されるために満たすべき最低限の要件です。実際には、ウェブページに技術的な変更を加える必要はほとんどありません。多くのサイトは、そのままでも技術要件を満たしています。」
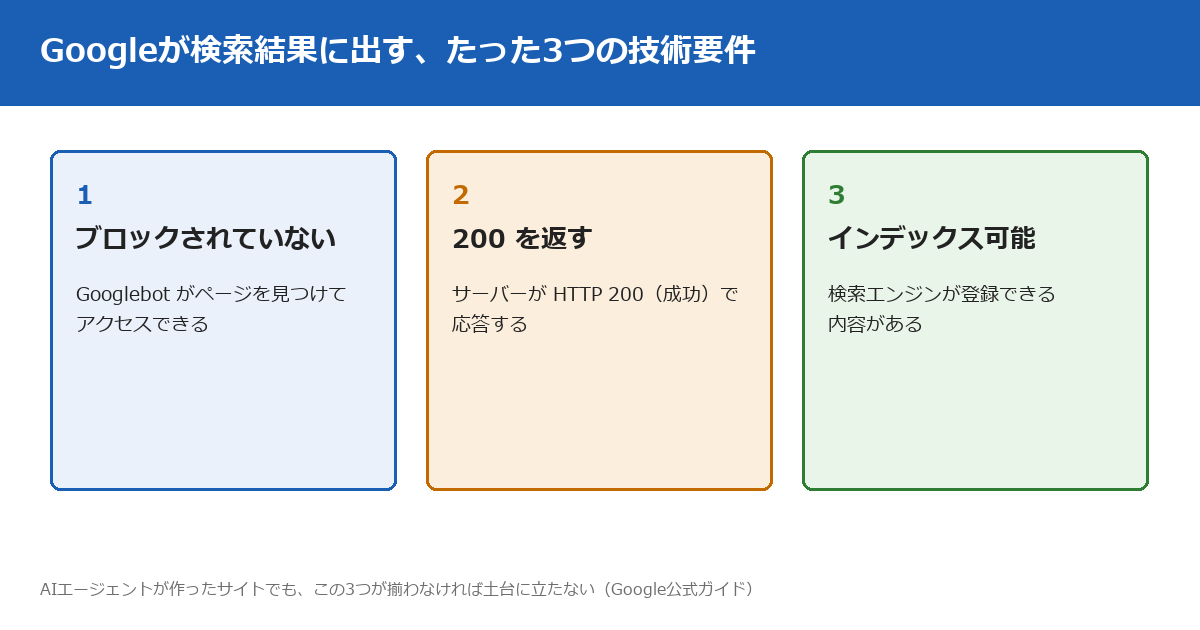
この「最低限」の中身は、公式ガイドによればたった3つである。見た目がどれだけ整っていても、この3つが揃わなければ、検索結果に出る土台にすら立てない。02章で1つずつ確認する。
02 なぜ・背景 — 3つの技術要件と、AIによる量産が問われる理由
3つの技術要件を、1つずつ確認する
Googleの技術要件ガイドは、この3つをこう定義している。「Googlebot がブロックされていないこと」「ページが機能していること(Google に HTTP 200 (success) ステータス コードが返される)」「インデックス登録可能なコンテンツがページに含まれていること」。そして続けて、こう釘を刺している。
「これらの要件を満たしているページが、すべてインデックスに登録されるとは限りません。インデックス登録は保証されているものではありません。」
AIエージェントが自動生成したページでも、この3つは人が作ったページとまったく同じ基準で判定される。見た目の完成度は、この3つのどれにも含まれていない。
大量に作ったページは、スパムポリシーの対象になりうる
AIエージェントを使えば、似た構成のページを短時間で何本も作れる。この「量産のしやすさ」自体は問題ではないが、Googleのスパムポリシーには、量産の目的を問う項目がある。
「大量生成されたコンテンツの不正使用とは、ユーザーをサポートすることではなく、検索ランキングの操作を主な目的として大量のページを生成することを指します。」
この項目の具体例のひとつに、「生成 AI ツールまたはその他の同様のツールを使用して、ユーザーにとっての価値を付加することなく大量のページを生成すること」が挙げられている。AIで作ったこと自体は違反ではない。ユーザーの役に立つ内容が伴わないまま数だけを増やすことが、違反として定義されている。当サイトの別記事では、33.1万ページ規模の調査をもとに、この「品質」基準がどう扱われているかを確認している(自動生成ページは「量」では裁かれない)。
注意
「AIで作った」ことと「量産した」ことは、それぞれ別の軸で判断される。1ページだけをAIエージェントで作る場合、この項目に直接は当てはまらない。当てはまるのは、価値のない似たページを大量に並べたときである。
自動化の使用を、隠さない
検索品質に関する別の公式ガイドは、コンテンツ制作で自動化を使う場合の自己点検として、こう問いかけている。
「AI による生成などの自動化を使用していることを、開示などの方法でユーザーに対して明確にしていますか。」
検索順位の操作を目的とせず、訪問者に価値を提供する目的で自動化を使うのであれば、その事実を隠す必要はない、という考え方である。AIエージェントで作ったサイトだと明記すること自体は、評価を下げる要因にはならない。
JavaScriptで描画されたページは、3段階を経てからインデックスされる
AIエージェントが生成するサイトの中には、React・Vueなどのフレームワークをベースにした、いわゆるシングルページアプリケーション(SPA)型の構成も含まれる。この形式では、公式ガイドが説明する処理の順番を理解しておく必要がある。
「Google は、JavaScript ベースのウェブアプリを 3 つの主要なフェーズで処理します。」その3つとは、クロール・レンダリング・インデックス登録である。続けて公式ガイドはこう説明している。「Googlebot は、クロールとレンダリングの両方のフェーズで、ページをキューに入れます。」
レンダリングが完了するまでは、JavaScriptが生成する見出しや本文は、Googleにまだ見えていない状態にある。この処理を説明する公式ガイドの最終更新は2026年3月5日で、今も更新され続けている。
03 この記事で出てくる用語
用語
レンダリング—ブラウザやクローラーがHTML・CSS・JavaScriptを実行し、実際に画面へ表示される状態を組み立てる処理。ページの「ソースを表示」で見えるのは実行前のHTML、開発者ツールの「検証」(Elementsパネル)で見えるのはレンダリング後のHTMLで、この2つは同じページでも内容が異なることがある。
「ソースを表示」と「検証」は別のものを見せている
記事のタイトルや本文がJavaScriptで後から挿入される構成の場合、「ページのソースを表示」では空の骨組みしか見えず、開発者ツールの「検証」を開いて初めて、実際に組み立てられた内容が見える。この2つを見比べることが、AIエージェントが作ったSPA型サイトの点検で最初にやることになる。
用語
noindex—特定のページを検索結果に表示させないための指示。metaタグまたはHTTPレスポンスヘッダー(X-Robots-Tag)で指定する。robots.txtによるクロール制御とは別の仕組みで、両方を同時に使うと、noindexの指示自体がクローラーに読まれず、目的を達成できないことがある。
noindexとrobots.txtは、目的が違う
robots.txtについて、公式ガイドはこう説明している。
「robots.txt ファイルとは、検索エンジンのクローラーに対して、サイトのどの URL にアクセスしてよいかを伝えるものです。これは主に、サイトでのリクエストのオーバーロードを避けるために使用するもので、Google にウェブページが表示されないようにするためのメカニズムではありません。」
一方noindexは、クロールを許可したうえで「検索結果に出すな」と伝える仕組みである。この2つを同時に使う設定について、noindexの解説ページはこう警告している。
「noindex ディレクティブを有効にするためには、robots.txt ファイルでページやリソースをブロックせず、クローラがページにアクセスできるようにする必要があります。robots.txt ファイルでページがブロックされている場合、またはクローラがページにアクセスできない場合、クローラは noindex ルールを認識しません。そのため、たとえばそのページが他のページからリンクされていれば、検索結果に引き続き表示される可能性があります。」
noindexを入れたつもりでも、robots.txtが先にクローラーを止めていれば、そのnoindexは読まれない。noindex・nofollow・robots.txtという3つの設定の違いは、別記事で詳しく整理している。
用語
構造化データ—ページの内容を検索エンジンが理解しやすい形式(JSON-LDなど)で補足する追加情報。正しく実装しても、検索結果の見た目(リッチリザルト)に反映される保証はない。
構造化データのエラーが0でも、表示は保証されない
構造化データの検証には、Googleが無料で提供する「Rich Results Test」が使われる。公式ガイドはこのツールをこう紹介している。
「リッチリザルト テストは構造化データの有効性をチェックするうえで使いやすい便利なツールです。構造化データを検証でき、場合によっては Google 検索の機能をプレビューすることもできます。」
その一方で、別のページではこう釘を刺している。
「重要: 構造化データが検索結果に表示されるとは限りません。リッチリザルト テストに沿ってページを正しくマークアップしても表示されない場合があります。」
エラーが0件であることと、実際に表示されることは別だと理解しておく必要がある。
WCAGの4原則
アクセシビリティの国際的な基準には、W3Cの「WCAG」(Web Content Accessibility Guidelines)がある。原則は知覚可能・操作可能・理解可能・堅牢の4つ(頭文字を取ってPOURと呼ばれる)で、達成基準には画像の代替テキスト(達成基準1.1.1・レベルA)や、文字と背景のコントラスト比4.5:1以上(達成基準1.4.3・レベルAA)などが含まれる。
注意
本記事の作成時、w3.org側のアクセス制御によって、WCAGの原文をこちらの手元では機械的に取得できなかった。そのため原文の逐語引用はせず、公開されている基準名・番号のみを案内している。詳細は出典欄のリンク先で直接確認してほしい。
URL検査ツールと「実際のURLをテスト」
Search Consoleに搭載されているURL検査ツールは、公開前の確認にも使える機能を持つ。公式ヘルプはこう説明している。
「URL 検査ツールには、Google のインデックスに登録されたページの情報が表示されます。また、URL がインデックスに登録できるどうかをテストすることもできます。」
ページが外部からアクセスできる状態であれば、「実際のURLをテスト」機能で、その時点のレンダリング結果を確認できる。ただし同じヘルプはこうも明記している。
「URL 検査ツールでは、Google に表示されるためのすべての要件が考慮されているわけではありません。」
このツール1つで「公開してよい」と判断しきれるわけではない。
04 型別 — 適用範囲・この記事が測っていないこと・手順
🅰 適用範囲 — どんなサイトに関係するか
本記事の確認項目は、生成AIエージェントで作ったコーポレートサイト・LP・キャンペーンページ全般に当てはまる。特に、テンプレートを使い回すノーコード型のAIツールや、React・Vueなどのフレームワークをベースにしたツールで組んだサイトでは、03章で触れたレンダリングの確認が特に重要になる。人が1ページずつ手で作る場合に比べ、AIエージェントは短時間で複数ページを一括生成できる分、1ページごとの目視確認が省略されやすいという性質がある。
🅱 この記事が測っていないこと・分からないこと
本記事はGoogle検索の公式ドキュメントを中心に確認しており、他の検索エンジンやAI検索エンジンが同じ基準をどこまで厳密に適用しているかは、それぞれの公式資料を個別に確認しておらず、範囲外である。景品表示法・薬機法など広告表現の適法性の判定は法律の専門知識が要る領域であり、本記事では扱わない。生成AIツールが作った画像やフォントの利用規約は、ツールごとに条件が異なるため、一般化した記述はしていない。WCAGの原文についても、03章で触れたとおり本記事作成時に直接確認できておらず、基準名・番号の案内にとどめている。
注意
分からないことを、分かるふりで埋めない。上記の範囲外は確認を省略してよいという意味ではなく、本記事とは別に確認が必要という意味である。
🅲 手順 — 4段階で確認する
実際の確認は、次の4段階で進める。
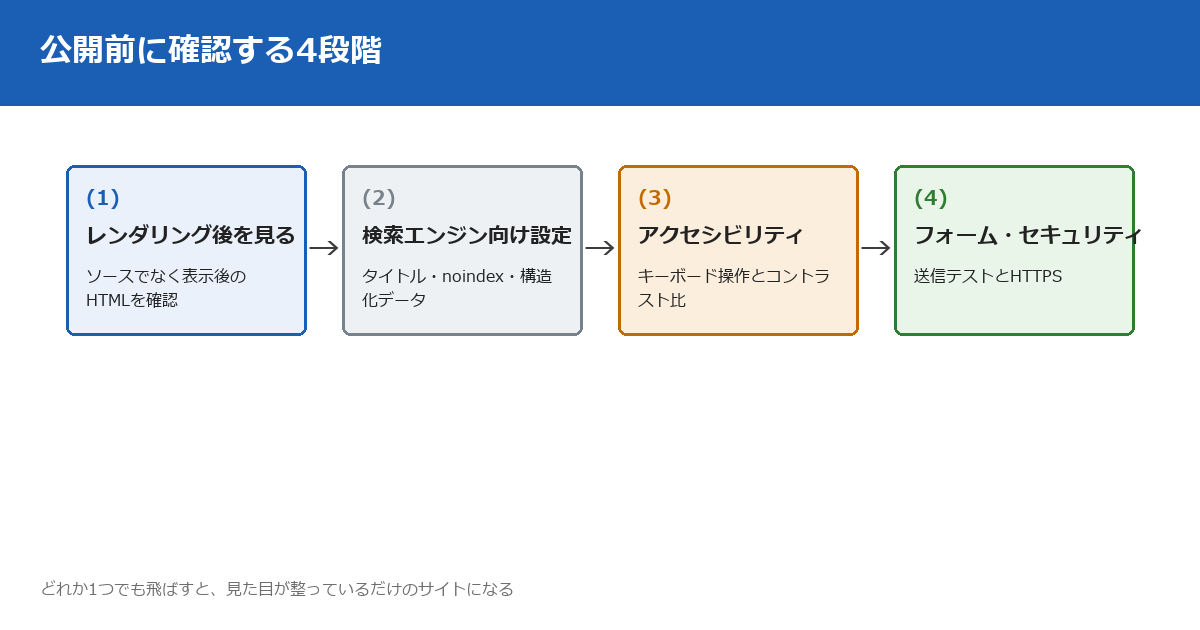
この4段階のうち、最初の「レンダリング後を見る」を飛ばすと、後続の確認がすべて「実行前のHTML」に対する確認になってしまい、実際に読者やクローラーが見ている画面とズレたまま進むことになる。JavaScriptで描画したページはいつ読まれるのかを確認する記事とあわせて読むと、レンダリングとクロールの関係がより具体的につかめる。
05 明日、自分のサイトで確認できることチェックリスト
以下は、今日からブラウザとGoogleの無料ツールだけで確認できる項目である。チェックの状態はブラウザに保存され、サーバーには送信されない。
実務のヒント
表示速度をLighthouseでまとめて計測したいときは、当サイトの🔧 WEBサイトのLighthouse監査・チェックツールで最大3ページまで計測できる(利用には無料の会員登録が必要です)。
- ページを開いて「ページのソースを表示」を確認し、見出しや本文がレンダリング前のHTMLに含まれているか確認する
- Search ConsoleのURL検査ツールで対象ページの「実際のURLをテスト」を実行し、レンダリング後のタイトルとmeta descriptionが表示されているか確認する
- robots.txtを開き、公開したいページのパスがDisallowに含まれていないか確認する
- 主要ページ3〜5件のソースを開き、noindexタグの消し忘れがないか確認する
- 主要ページ3〜5件のtitleタグとmeta descriptionが、ページごとに異なる文言になっているか確認する
- Rich Results Testに主要ページのURLを入力し、構造化データのエラーが0件か確認する
- 開発者ツールで画像3ページ分の代替テキスト(alt属性)が入っているか確認する
- PageSpeed Insightsでモバイル版を計測し、Core Web Vitals(LCP・CLS・INP)が「良好」の範囲か確認する
- キーボードのTabキーだけを使い、フォームの入力欄とCTAボタンまで到達できるか確認する
- 本文とボタンの文字色・背景色のコントラスト比を、ブラウザの拡張機能で4.5:1以上あるか確認する
- サイトのURLがhttps://で始まっているか確認する
- お問い合わせフォームから実際に1件送信し、指定した宛先にメールが届くか確認する
- sitemap.xmlに載っているURL数と、実際に公開したページ数が一致しているか確認する
| 観点 | 該当する項目 | 目安時間 |
|---|---|---|
| レンダリング・クロールの土台 | 1〜4番目(4項目) | 20分 |
| 検索結果の表示 | 5〜6番目(2項目) | 10分 |
| 画像・表示速度 | 7〜8番目(2項目) | 15分 |
| アクセシビリティ | 9〜10番目(2項目) | 10分 |
| フォーム・セキュリティ | 11〜12番目(2項目) | 10分 |
| 一覧の整合性 | 13番目(1項目) | 5分 |
すべてに目を通す時間の目安は1サイトあたり60〜70分程度である。PageSpeed Insightsは計測に数十秒かかるため、複数ページを測る場合は待ち時間を見込んでおくとよい。サイト全体のtitleタグやmetaタグをまとめて確認したいときは、当サイトの🔧 WEBサイト総合分析・レポートツールで技術的な状態を一括で見ることもできる。
06 代替・他の選択肢(表で)
確認手段は1つではない
05章のチェックリストは複数の確認手段を組み合わせている。同じ「構造化データが正しいか」を確認するにも、Rich Results TestとURL検査ツールでは見ているものが違う。公式ガイドはこの2つのツールについて、こうまとめている。
「技術に関するガイドラインを遵守しているかどうかは、リッチリザルト テストや URL 検査ツールを使用してテストできます。このテストで技術的なエラーのほとんどを検出できます。」
「ほとんど」であって「すべて」ではない、という書き方に注意しておきたい。
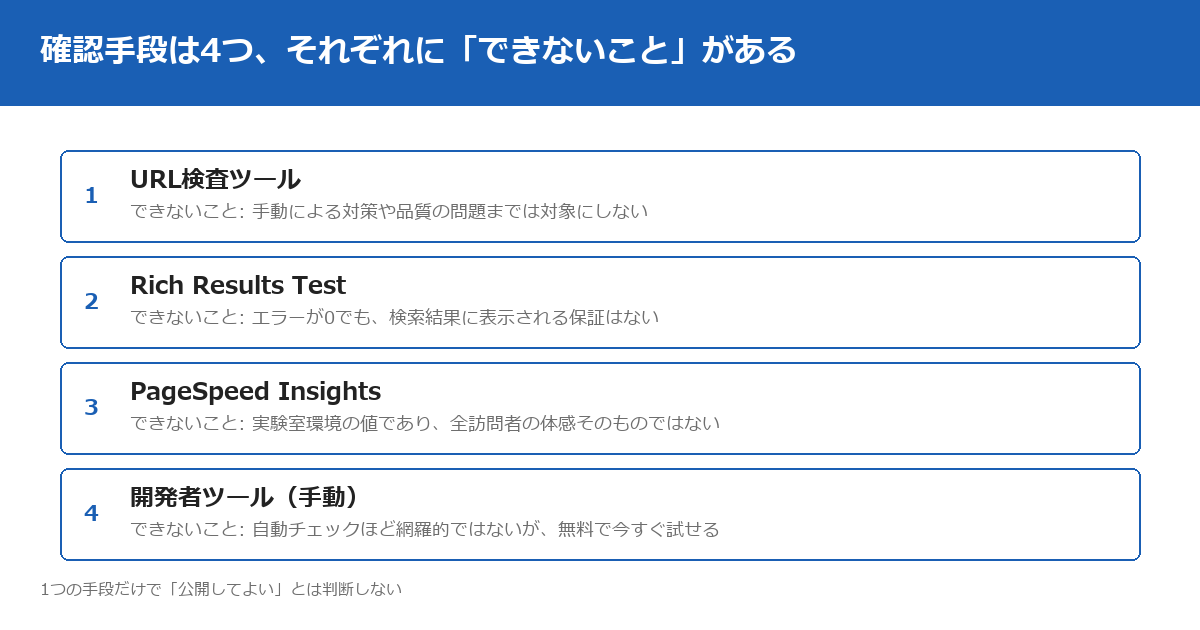
それぞれの手段が「できないこと」も知っておく
| 確認したいこと | 使う手段 | この手段だけでは分からないこと |
|---|---|---|
| レンダリング後の見た目 | URL検査ツールの「実際のURLをテスト」 | 手動による対策・品質面の問題は対象外 |
| 構造化データの構文 | Rich Results Test | エラー0件でも、実際に表示されるかは別 |
| 表示速度 Core Web Vitals | PageSpeed Insights | 実験室環境の値で、全訪問者の体感そのものではない |
| キーボード操作 コントラスト比 | ブラウザの開発者ツール(手動) | 自動チェックほど網羅的ではない |
| サイト全体の技術状態 | 当サイトのWEBサイト総合分析ツール | 1ページごとの深掘りには向かない |
PageSpeed Insightsが計測するCore Web Vitalsについて、公式ガイドはこう説明している。「Core Web Vitals are a common set of performance signals critical to all web experiences.」(訳: Core Web Vitalsは、あらゆるウェブ体験にとって重要な、共通のパフォーマンス指標のセットである。)どれか1つの手段だけで「公開してよい」と判断せず、複数の手段を重ねて使うことで、それぞれの死角を補い合える。
07 AIに任せてよいところ・人が見るところ
数えられることは、AIに任せてよい
05章のチェックリストのうち、「ある/ない」「一致する/しない」を機械的に数えられる項目は、AIエージェント自身や自動チェックツールに任せやすい。noindexタグの有無、titleタグの重複、alt属性の欠落、URL数の一致などは、いずれも人が1件ずつ目視するより、ツールで網羅的に数えたほうが漏れが少ない。実際、05章のチェックリストの半分近くは、この「数える」作業に当たる。
「意味が合っているか」は、人にしか判定できない
一方で、titleタグの文言がページの内容と合っているか、CTAボタンの文言が本文の主張とかみ合っているか、といった「意味の一致」は自動チェックの対象になりにくい。02章で見たとおり、AIエージェントは短時間で構成の似たページを量産できる。量産そのものは問題ではなく、量に見合った価値がページごとにあるかどうかを最後に確かめるのは、公開ボタンを押す人の役目として残る。数えられることはAIに任せ、意味が合っているかは人の目で見る、という役割分担が、AIエージェントが作ったサイトの公開前チェックでは特にはっきりする。
08 このテーマの、これまで
自動化の開示を求める文言は、2025年12月に今の形に更新されている
02・03章で引用した「自動化の使用は自明か」という一文を含む公式ガイドは、2025年12月18日に最終更新されている。この考え方自体はそれ以前から存在していたが、AIエージェントによるサイト・コンテンツ生成が実務として広がったタイミングで、あらためて参照される機会が増えている。
2026年、スパムポリシーは「生成AIツール」を名指しした
02章で確認した「生成AIツールなどを使用して多数のページを生成する」という一文を含む現行のスパムポリシーは、2026年9月2日に最終更新されている。AIを使うこと自体を禁じるのではなく、ユーザーへの価値を伴わない量産を禁じる、という立場は一貫している。
当サイト自身も、「土台」より先の確認で何度もつまずいてきた
当サイトのブログでは、技術要件そのものではなく、その先の確認でつまずいた記録がいくつも残っている。noindexの解除忘れが1,238記事の8割に及んでいたことに気づいた回(archives/98)、内部リンクの59.2%がnoindexへの飛び先になっていた回(archives/134)、sitemap・canonical・内部リンクの4層が食い違っていないかをcurlで確認する手順を整理した回(archives/39)は、いずれも「公開できている」ことと「公開後も正しく機能している」ことが別だと教えてくれた記録である。公開してから検索エンジンに再クロールされるまでの待ち時間についても、当サイトで実際に測った記録がある(archives/108)。datePublished・og:type・sitemapなど、値そのものが小さく違っているだけの穴を4つ見つけた回(archives/128)や、noindexを1,000件単位で一括解除した際の記録(archives/105)も、AIが作ったか人が作ったかに関わらず、公開前後の確認が必要であることを示している。
この記事の数字も、確認した時点のものとして扱ってほしい
本記事で引用したGoogle公式ガイドの最終更新は、技術要件のページが2025年12月18日、robots.txtの解説ページが2025年12月18日、noindexの解説ページが2025年12月31日、JavaScript SEOの基本が2026年3月5日、構造化データの一般ガイドラインが2026年9月16日、スパムポリシーが2026年9月2日と、それぞれ異なる。基準そのものは大きく変わっていなくても、解説の細部は今も更新され続けている。本記事の内容も、確認した時点(2026年9月)のものとして扱い、必要なら公式ガイドを直接開いて最新の記載を確認してほしい。
現在の貴方のIPアドレス
このサイトで書いている人