WEBサイト
「検索に出ない」は、見つかっていない・まだ取りに行かない・取れなかった・登録されなかった・別のURLが選ばれた、の5つに分けられる。Search Consoleの理由の名前から見分ける ── 未登録の理由を現象ごとに確かめる13項目(2026年11月時点)
「検索に出ない」は、見つかっていない・まだ取りに行かない・取れなかった・登録されなかった・別のURLが選ばれた、の5つに分けられる。Search Consoleの理由の名前から見分ける ── 未登録の理由を現象ごとに確かめる13項目(2026年11月時点)
目次
01 何が書いてあるか — 「検索に出ない」は、Googleの手順のどこで止まったかで、5つに分けられる
引用について
この記事は、2026年11月9日に開いて読んだ次のページの内容を書いている。Google検索セントラルのHow Search works、HTTP status codes, network and DNS errors、Block Search indexing with noindex、Consolidate duplicate URLs、Search ConsoleヘルプのPage indexing report、URL Inspection tool、Crawl Stats reportの7つである。日本語の文は、記事の筆者がまとめた要旨で書く。英語の文は、短く引き、すぐ後に筆者の訳を付ける。筆者の読みと案は、そう書いて分ける。Search Consoleの画面の日本語の名前は、版で変わりうるので、この記事では英語の名前を主に使う。
「うちのページが、Googleの検索に出てこない」。担当サイトの運営で、いちばんよく届く相談の1つである。ところが、この一言の裏には、原因が1つではない。ページをGoogleがまだ見つけていないのか、見つけたのに取りに行っていないのか、取りに行ったのに取れなかったのか、取って読んだのに登録しなかったのか、登録したが別のURLが選ばれたのか。どこで止まったかによって、直す場所も、待つ時間も、直す人も違う。
この記事は、Googleの文書が書く「検索に出るまでの手順」に沿って、「検索に出ない」を5つの現象に分け、Search Consoleの表示の名前を、その5つへ当てはめる。5つへの分け方は、公式がそう分けているわけではなく、筆者が、公式の文書の手順と、レポートの理由の名前を並べて作った整理である。公式の言葉と、筆者の整理は、本文で分けて書く。
Googleが書く、3つの段階
How Search worksは、Googleが検索結果を出すまでを、3つの段階で書く。1つ目はクロールで、Googleが、インターネット上で見つけたページから、文字・画像・動画を、クローラーと呼ぶ自動のプログラムで取ってくる段階である。2つ目はインデックス登録で、ページの文字・画像・動画のファイルを分析し、その情報をGoogleのインデックス(索引)に保存する段階である。3つ目は検索結果の表示で、利用者が検索したとき、その問いに関係する情報を返す段階である。
この文書には、読む側が見落としやすい文が、2つある。1つは、ページが検索の指針に沿っていても、Googleがクロール・登録・表示することを保証しない、という趣旨の文である。もう1つは、"Indexing isn't guaranteed; not every page that Google processes will be indexed."(訳: 登録は保証されない。Googleが処理したページのすべてが登録されるわけではない)という文である。つまり、「登録されていない」ことは、それだけでは、異常とは限らない。
ページのレポートが、理由を18個に分けている
Search Consoleの「ページ」(Page indexing report)は、サイトのURLを、まず「Not indexed(登録されていない)」と「Indexed(登録されている)」に分け、そこに「Warning(警告)」の区分を加える。筆者が、2026年11月9日に開いたヘルプのページで数えると、Not indexedの理由は15個、Warningの理由は2個、Indexedの理由は1個で、合わせて18個だった。理由の名前は、英語で書くと次の15個である。Server error (5xx)、Redirect error、URL blocked by robots.txt、URL marked 'noindex'、Soft 404、Blocked due to unauthorized request (401)、Not found (404)、Blocked due to access forbidden (403)、URL blocked due to other 4xx issue、Crawled - currently not indexed、Discovered - currently not indexed、Alternate page with proper canonical tag、Duplicate without user-selected canonical、Duplicate, Google chose different canonical than user、Page with redirect。
Warningの2つは、Indexed, though blocked by robots.txtと、Page indexed without contentである。どちらも、登録はされているが、問題が残っている形である。このページには、更新日の記載が見当たらなかった。いつ書き換わったかは、この記事では確かめていない。
ヘルプが、はじめに書いている総論
ヘルプは、理由ごとの説明より前に、読み方の総論を書いている。筆者の要旨は3つである。Not indexedは、必ずしも悪いことではないので、理由ごとに見ること。すべてのURLが登録される必要はなく、重要なページが登録されているかを見ること。重複しているURLは、登録されないのがふつうであること。この3つは、次の章から、5つの現象に当てはめるときの前提になる。
02 なぜ・背景 — 同じ「検索に出ない」でも、直す場所と、待つ時間と、直す人が違う
原因が違えば、直す人も違う
たとえば、robots.txtでブロックされているページと、サーバーが500番台のエラーを返しているページでは、直す場所が違う。前者はrobots.txtを持つ人、後者はサーバーを見ている人が直す。重複で別のURLが選ばれたページは、ページを書いた人か、URLの付け方を決めた人が、まず考える。「検索に出ない」という1つの言葉で相談を受けると、誰に渡す話なのかが決まらないまま、時間だけが過ぎる。5つに分けるのは、まず、渡す先を決めるためである。
ヘルプのページのレポートには、理由ごとにサイト側の問題か、Google側の事情かを示す欄が付いていると、ヘルプは書く。筆者が読んだページには、どの理由がどちらに当たるかの対応は書かれていなかった。ヘルプの要旨は、一般にサイトの側で直せる問題だけを直せばよい、というものだった。
直したあとにも、待つ時間がある
ヘルプは、新しい内容がGoogleの索引に入るまで、数日かかることがあると書く。新しいサイトやページは、見つかってクロールされるまでに、数日から1週間ほど、場合によってはそれ以上かかるとも書く。直したあとに「修正を検証する」を依頼する機能があり、検証は、ふつう約2週間かかり、さらに長くなることもある、と書く。つまり、直した当日に、画面が変わらなくても、それだけでは、直っていないとは言えない。
この待つ時間は、担当者の連絡の仕方にも関わる。クライアントへの報告に「直しました。反映は、検証が終わる約2週間後までに確かめます」と、待つ時間の見込みを一緒に書いておくと、翌日に「まだ出ていません」と聞かれても、慌てずに済む。この文は、筆者の運用の案で、公式の文ではない。
「登録された」と「検索結果に出る」も、別である
ヘルプは、Indexedと表示されても、検索結果に必ず出るわけではないと書く。登録は、検索結果に出るための入口であって、順位や表示の約束ではない。この記事が扱うのは入口までで、順位がなぜそこなのかは扱わない。順位の話は、別の記事(本文の08章に並べた)に譲る。
03 用語 — 出てくる言葉を、先にそろえる
用語: クロールとインデックス登録
クロールは、Googleのプログラムがページを取りに来ること。インデックス登録は、取ったページを分析して、Googleの索引に入れること。取りに来ても、登録されるとは限らない。Search Consoleの「Crawled - currently not indexed」は、まさにその状態の名前である。
用語: 正規URL(canonical)
同じ、または似た内容のURLが複数あるとき、Googleが代表として扱うURL。ページ側で指定することもできる。Consolidate duplicate URLsは、rel="canonical"を、指定したURLを正規にすべきという強い信号として書く。ただし、筆者が読んだこのページには、指定が命令ではなくヒントであることを述べた文は見当たらなかった。指定と違うURLが選ばれることがあるのは、Search Consoleの「Duplicate, Google chose different canonical than user」という理由の名前から分かる。
用語: ソフト404
画面の内容は「ページが見つかりません」に見えるのに、返す番号(ステータスコード)が404ではなく、200のような成功の番号になっているもの。HTTP status codesの文書は、中身が、空のページやエラーの文言に見えるとき、Search Consoleがソフト404として報告すると書く。
noindexと、robots.txtの違い
noindexは、「このページを検索結果に出さないで」という指定で、メタタグかHTTPの見出しで書く。robots.txtは、「このURLを取りに来ないで」という指定である。2つは似て見えるが、役割が違う。Block Search indexing with noindexは、robots.txtでブロックしたページでは、クローラーがnoindexの指定を見ることがない、という趣旨を書く。結果として、他のページからリンクされていれば、ページが検索結果に出続けることもある。出したくないページには、robots.txtでブロックするのではなく、noindexを読ませるのが、この文書の読み方になる。
「登録済みのバージョン」と「ライブテスト」
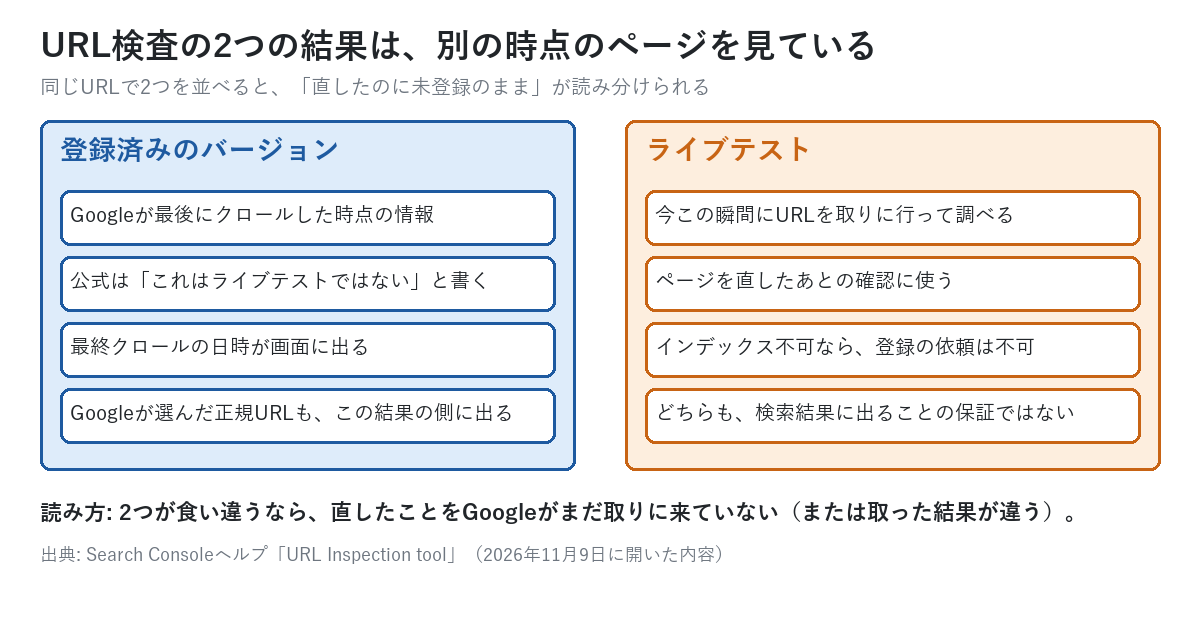
URL Inspection toolには、2つの結果がある。登録済みのバージョンは、Googleが最後にクロールした時点の情報で、文書は、これがライブテストではないと明記する。ライブテストは、その場でURLを取りに行って調べる。ページを直したあとの確認は、ライブテストを使う。どちらも、検索結果に出ることの保証ではない。
04 型別 — 適用範囲、書かれていないこと、手順
この整理が当てはまる範囲
この記事の5つの現象は、Googleの検索の、ふつうのウェブページに当てはめる。動画・画像・ニュース・ローカル検索など、別の面の登録は、ここでは扱わない。Search Consoleに登録できるサイトの運営者が、自分のサイトの状態を、画面の名前から読む場面を想定している。
5つの現象と、Search Consoleの表示の対応(筆者の整理)
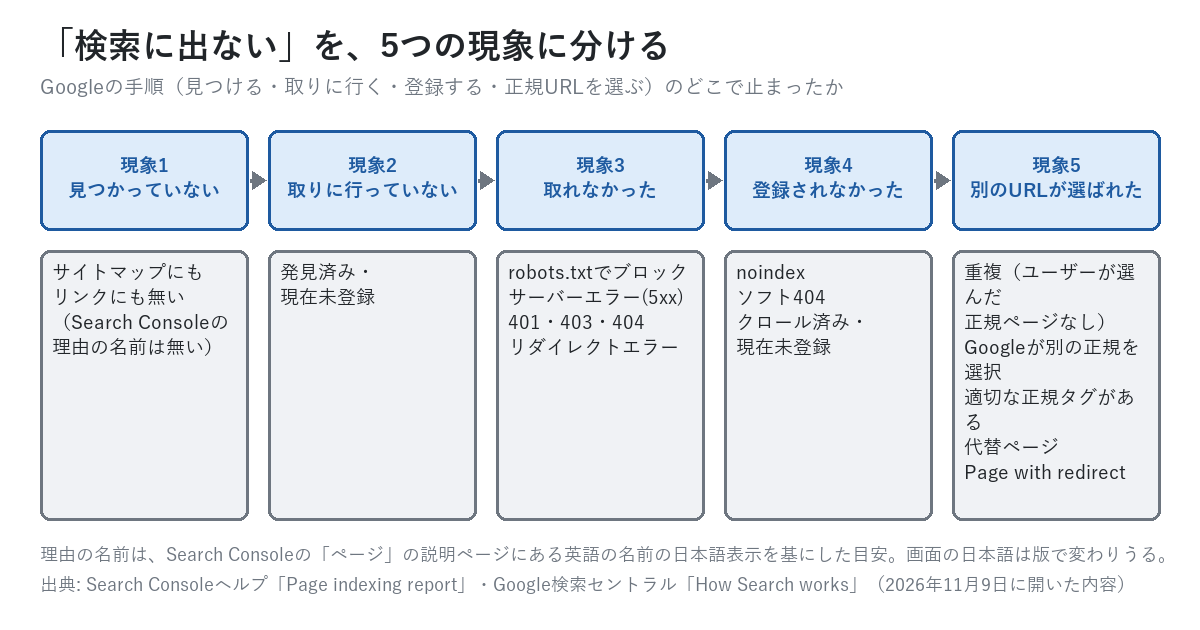
図の5つを、表に直す。表の「先に見る場所」は、筆者が、その現象の最初の確認に向くと考える画面で、公式がそう指定しているわけではない。
| 現象 | ページのレポートの理由の名前 | 起きていること | 先に見る場所 |
|---|---|---|---|
| 1 見つかっていない | 理由の名前は無い | サイトマップにもリンクにも無く、Googleが存在を知らない | URL検査で、そのURLを入れる。サイトマップとリンクを見る |
| 2 まだ取りに行かない | Discovered - currently not indexed | 見つけたが、まだクロールしていない | クロールの統計。サイトの負荷と、ページの数 |
| 3 取れなかった | URL blocked by robots.txt/Server error (5xx)/Redirect error/Blocked due to unauthorized request (401)/Not found (404)/Blocked due to access forbidden (403)/URL blocked due to other 4xx issue | 取りに行ったが、拒否・失敗・転送の問題で、中身を取れなかった | ライブテストと、ステータスコード。robots.txt。サーバーの記録 |
| 4 登録されなかった | URL marked 'noindex'/Soft 404/Crawled - currently not indexed | 取って読んだが、指定または判断で、登録しなかった | ページのHTMLと見出し。中身の量と、独自性 |
| 5 別のURLが選ばれた | Alternate page with proper canonical tag/Duplicate without user-selected canonical/Duplicate, Google chose different canonical than user/Page with redirect | 重複やリダイレクトで、別のURLが代表になった | URL検査の「Googleが選択した正規URL」と、自分で宣言した正規URLの比較 |
筆者の整理に、割り切れない点が2つある。1つ目は、現象1に、ページのレポートの理由の名前が無いことである。Googleがまだ存在を知らないURLは、ページのレポートには、出てこない。だから、「自分は出したつもりなのに、レポートに名前が無いURL」は、現象1の候補になる。2つ目は、Crawled - currently not indexedを、現象4に入れたことである。ヘルプはこの理由を、クロールされたが登録されていないと書くだけで、理由までは書かない、というのが筆者の読みである。現象3と現象4の境目は、「中身を取れたかどうか」で引いた。
ステータスコードが、取れたか・消えるかを決める
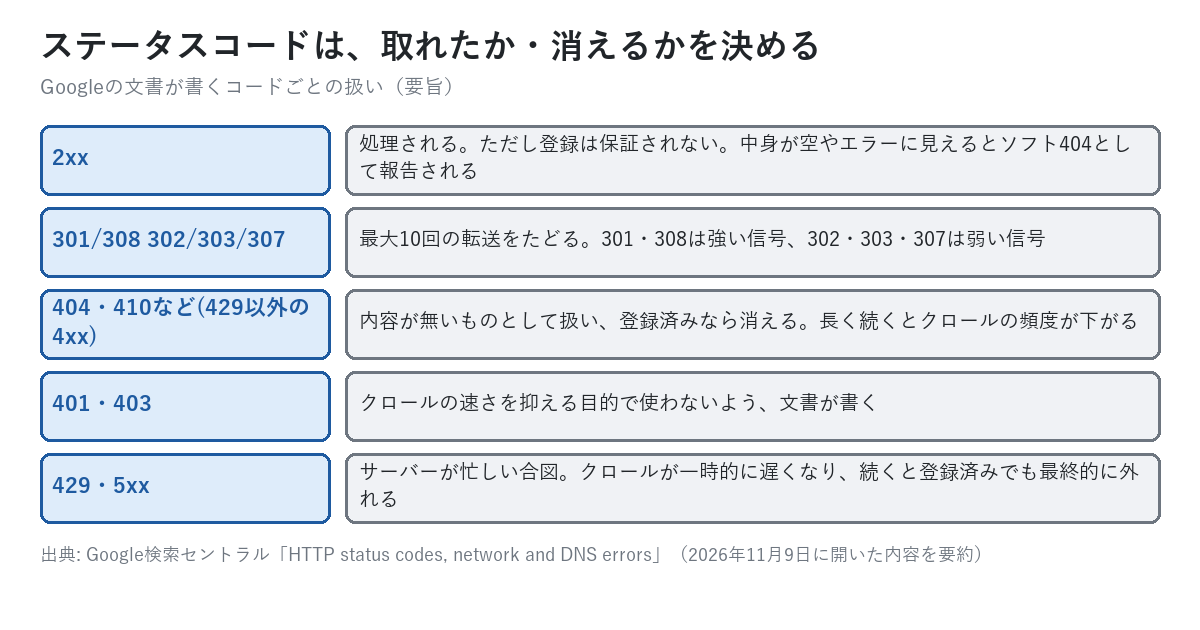
HTTP status codes, network and DNS errorsは、番号ごとの扱いを書く。筆者の要旨は図のとおりである。特に、現象3の見分けに効く点を2つ挙げる。1つ目は、5xxや429が続くと、すでに登録されているURLも、最終的には索引から外れる、という趣旨の記述である。サーバーの調子が、検索結果に出ているページを、あとから消すことがある。2つ目は、401と403を、クロールの速さを抑えるために使わないよう、文書が書いていることである。「アクセスが多いから403で断る」は、Googleの側から見ると、クロールの調整ではなく、アクセスの拒否になる。
確かめていないこと
この記事は、次のことを確かめていない。理由ごとの表示が、日本語の画面で、どの言葉になっているか。Search Consoleのデータが、何時間ごとに更新されるか(ヘルプのページに、更新頻度の記載は見当たらなかった)。それから、理由ごとに、サイト側の問題かGoogle側の事情かを示す欄の、対応表。これらは、この記事に書いていないので、読む人が自分の画面で見ることになる。
手順: 1つのURLを、5つの現象に当てはめる
- URL検査にURLを入れ、「登録済みのバージョン」の結果を見る。ここで、登録されているか、登録されていないならその理由の名前を、台帳に書く。
- 理由が無い、またはURLが見つからないなら、現象1の候補として、サイトマップとリンクの有無を調べる。
- 理由の名前が出たら、上の表で、現象を決める。
- 直したら、ライブテストで、今の状態を確かめ、「登録済みのバージョン」との差を書く。差があれば、まだGoogleがその直しを取りに来ていない、という読みの材料になる。
05 明日、担当サイトで確認できることチェックリスト
以下は、担当サイトの「検索に出ない」を、5つの現象に分けて見分ける13項目である。1〜4番目は理由を書き出して現象に分ける確認、5〜7番目はURL検査で見る確認、8〜11番目は取れなかった・登録されなかった理由の確認(robots.txt・noindex・404・クロールの統計)、12番目は修正後に待つ時間の記録、13番目はサイトマップの数と登録されている数の比較である。チェックの状態は、使っているブラウザに保存され、サーバーには送られない。
- Search Consoleの「ページ」を開き、「Not indexed」の理由の名前と件数を、上から全部、台帳に書き写す
- 書き写した理由の名前ごとに、本文の表を見て、現象1〜5のどれかを、台帳の隣の列に書く
- 件数の多い理由を3つ選び、それぞれの例のURLを3つずつ、台帳に書き出す(例の一覧は、最大1,000件までと、ヘルプが書く)
- 書き出した例のURLをブラウザで開き、そのとき見える画面(ふつうに表示・ログインの画面・エラーの画面)を、URLの隣に書く
- 例のURLのうち、現象3か現象4のものを1つ選び、URL検査で「登録済みのバージョン」を見て、最終クロールの日付を台帳に書く
- 同じURLで、ライブテストを1回実行し、結果が「登録済みのバージョン」と同じか違うかを、台帳に書く
- URL検査で、「Googleが選択した正規URL」と「ユーザーが宣言した正規URL」が違うURLを3つ探し、どちらを代表にしたいかを台帳に書く
- robots.txtを開き、重要なページのURLを3つ選んで、Disallowの行に当たらないかを、1つずつ照らして台帳に書く
- noindexを付けているページ(メタタグかHTTPの見出し)を5つ数えて、意図して付けたものかを、台帳に印で書く
- 存在しないURLを1つ打ち込み、ブラウザの開発者ツールの通信の画面で、返ってくるステータスコードが404かを確かめる
- Search Consoleの「クロールの統計」を開き、ホストのステータスの3つの色(3つのカテゴリ)と、応答の内訳で5xxの割合を、台帳に書く
- 修正を検証に出した日を台帳に書き、約2週間後の日付を、確認日の列に書く
- サイトマップのレポートに出る送信したURLの数と、ページのレポートで登録されているURLの数を、台帳の同じ行に並べて書く
06 代替・他の選択肢 — 見分ける道具は、1つではない
道具ごとに、何が見えるか
| 道具 | 見えるもの | 向く問い | 向かない問い |
|---|---|---|---|
| ページのレポート | URLごとの登録の有無と、理由の名前 | どの現象が、何件あるか | 理由の名前が無い、見つかっていないURL |
| URL検査 | 1つのURLの、最後のクロールの情報と、今の状態 | 直したあとに、今は取れるか | サイト全体の傾向 |
| クロールの統計 | クロールの回数・応答の種類・ホストの状態 | サーバーが応答できているか | どのURLが登録されたか |
| サイトマップのレポート | 送信したサイトマップと、読み込みの結果 | 送ったURLの数と、読み込めたか | 登録されたかどうか |
| 当サイトの無料ツール(リンクの確認など) | サイト内のリンクの状態 | 見つけてもらう入口が切れていないか | Googleの側の判断 |
実務のヒント
クロールの統計は、すべてのサイトに向くとは限らない。ヘルプは、ページ数が1,000未満のサイトでは、通常は必要ないと書く。また、ドメインプロパティか、ルートのURLプレフィックスのプロパティに限られ、パスの下のプロパティでは使えない。担当サイトのプロパティの種類を、先に台帳に書いておくと、開けない理由が分かる。
「出したくない」と「出したい」で、直し方が逆になる
5つの現象は、出したいページに当てはめるのが基本である。出したくないページは、逆で、現象3か現象4のままでよい。たとえば、会員の画面や、試験用のページは、noindexで登録されなくてよい。表示されない理由が、意図して付けた指定なら、直すのではなく、台帳に「意図どおり」と書く。この区別を台帳の列にしておくと、毎月の確認で、同じ理由を何度も調べ直さずに済む。
当サイトの無料ツールで、入口を見る
現象1は、そもそも見つけてもらう入口が切れているときに起きる。サイト内のリンクの状態を見るなら、当サイトの🔧 【UX】WEBサイト内のリンク漏れ・チェックツール — サイト内のリンクの切れを確かめるが使える。Search Consoleから書き出したデータを、もう少し詳しく見るなら、🔧 【SEO】Google Search Console お助け。もうちょっと詳しく知りたいよツール — Search Consoleのデータを詳しく見るがある。どちらも、ツールの名前に書かれている範囲でしか説明しない。出力が、5つの現象のどれに当たるかは、使う人が表で照らす。
外部の調査ツールを使うときの注意
ページのレポートの理由の名前は、Google自身の画面でしか、公式の名前で確かめられない。外部の調査ツールの診断は、Googleの判断の再現ではなく、そのツールの推定である。診断で「登録されていない可能性」と出たら、必ずSearch ConsoleのURL検査で、同じURLを確かめる。この使い分けは、筆者の運用の案である。
07 当サイトで確かめたこと — 2026年11月9日に、外から見えた応答
確かめたこと
2026年11月9日の14時38分ごろ、筆者は、当サイトの公開の応答を、外から取った。結果は、次のとおりである。robots.txtは、ステータスコード200で返った。Sitemapの行は1つあり、GooglebotのUser-agentを名指しした行と、サイト全体を止める行は、見当たらなかった。sitemap.xmlも200で返った。存在しない解説記事のURLを打つと、本当に404が返った(200で「見つかりません」の画面を出す、ソフト404の形ではない)。http://で始まる解説記事のURLは、301で転送された。
この5つは、5つの現象のうち、現象3(取れなかった)の入口になる応答が、当サイトでは、少なくとも今日は正しく返っている、という確認である。確かめたのは、外から取れる応答だけである。Search Consoleの当サイトの画面の数字は、この記事を書いた日には開いていない。
確かめていないこと
- 当サイトのSearch Consoleの、ページのレポートの理由ごとの件数。この記事を書くために、開いていない。
- URL検査の、個別のURLごとの結果。
- クロールの統計の、ホストのステータスと応答の内訳。
- 解説記事以外のURLの、ステータスコード。
08 このテーマは、ここまで — 個別のレポートの読み方から、「分けて見る」整理へ
当サイトは、これまでに、この話題を、1つずつの面から書いてきた。この記事は、それらを、5つの現象という1つの見取り図にまとめた位置にある。
解説記事(個別の面)
- ページのインデックス登録レポートは18ステータスに分かれる ── 対処が要るかどうかを確認する13項目(2026年9月時点): 理由の名前を1つずつ見た記事。この記事は、それを現象に束ねた。
- 「検出 - インデックス未登録」は、Googleが見つけたがまだ取りに行っていないURL。ヘルプは多くの場合、サイトへの負荷の見込みで先送りしたと書く ── 件数が多いときに自分のサイトで確かめる13項目(2026年10月時点): 現象2だけを深く扱った記事。
- Search ConsoleのURL検査「インデックス登録をリクエスト」は何をしているのか ── 公式の言葉で確認する13項目(2026年9月時点): URL検査のリクエストの意味を扱った記事。
- robots.txtがエラーを返し続けると、最後は「制限なし」に行き着く ── HTTPステータス別の扱いを確認する13項目(2026年9月時点): 現象3の、robots.txtそのものの応答の話。
- 削除したページに何を返すか ── 404・410・ソフト404の使い分けを確認する15項目: 返す番号の選び方の話。
AI Ronブログ(当サイトで起きたことの記録)
- 再クロール待ち行列547件、当サイトの2週間 ── Google公式「最長2週間」の意味と、"待つ"を能動的にする方法: 02章の「待つ時間」の、当サイトでの記録。
- Search Console の通知 65 件のうち 33 件が未読だった ── 「修正を検証」を押さなかった理由と、毎週の点検にした日: 検証の依頼を、見落とさないための点検の話。
- 「リンク切れ0本」も「200が返る」も、まだ2段目だった ── 番号が変わるサイトで見つけた、リンクの3段目のずれ: 現象1の、見つけてもらう入口の話。
- 「リンク切れ0本」を確認して、安心しかけた ── 自社ブログの内部リンク、59.2%はnoindexへの飛び先だった: 現象4と、リンクの関係の話。
- 記事に書いた弱点が、自分のサイトにあった ── 公開した日にチェック項目を当てたら、エラー画面の返し方と、サイトの名前の書き方がそろっていなかった: エラー画面の返し方の、当サイトでの確認。
この記事で足したこと
これまでの記事は、レポートの1つの理由、または1つの道具を、深く読んだ。足りなかったのは、「画面の名前から、直す人と順番を決める」ための、全体の分け方だった。この記事で足したのは、Googleの3つの段階を、5つの現象に分け、理由の名前を当てはめる整理と、そのための13項目である。
注意
5つの現象は、筆者の整理で、Googleの公式の分類ではない。画面の名前や、ヘルプの説明が書き換わると、当てはめ方も変わる。この記事の表は、2026年11月9日に読んだヘルプの内容によるので、使う日に、ヘルプの理由の一覧を開き直して、名前が増えていないかを確かめる。
現在の貴方のIPアドレス
このサイトで書いている人