WEBサイト
「検出 - インデックス未登録」は、Googleが見つけたがまだ取りに行っていないURL。ヘルプは多くの場合、サイトへの負荷の見込みで先送りしたと書く ── 件数が多いときに自分のサイトで確かめる13項目(2026年10月時点)
「検出 - インデックス未登録」は、Googleが見つけたがまだ取りに行っていないURL。ヘルプは多くの場合、サイトへの負荷の見込みで先送りしたと書く ── 件数が多いときに自分のサイトで確かめる13項目(2026年10月時点)
目次
01 何が書かれているか — 「検出 - インデックス未登録」は、Googleが見つけたがまだ取りに行っていないURLで、ヘルプは多くの場合「サイトに負担がかかりそうなので先送りした」と書く
引用について
この記事の「" "」で囲んだ英語の文は、公式のヘルプや文書からの引用で、日本語訳は記事の筆者が付けたものである。原文は各出典のページで確認できる。各ページは2026年10月19日に開いて確かめた。
ヘルプの説明
Search Consoleの「ページのインデックス登録」のレポートには、登録されなかった理由が一覧で出る。そのなかの「検出 - インデックス未登録」(英語の画面ではDiscovered - currently not indexed)について、ヘルプは次のように説明している。
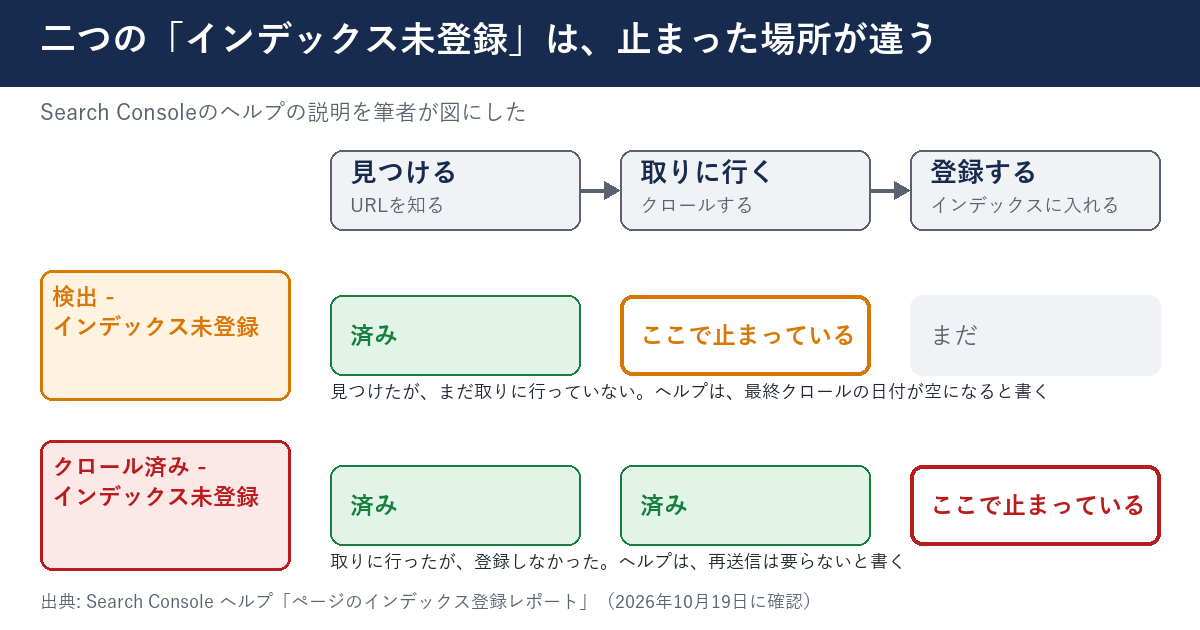
"The page was found by Google, but not crawled yet. Typically, Google wanted to crawl the URL but this was expected to overload the site; therefore Google rescheduled the crawl. This is why the last crawl date is empty on the report."
(訳: そのページはGoogleに見つけられたが、まだクロールされていない。通常、GoogleはそのURLをクロールしたかったが、サイトに負荷をかけすぎると見込まれたため、クロールを予定し直した。これが、レポートで最終クロールの日付が空になっている理由である。)
読み取れることは3つある。見つけたが、まだ取りに行っていないこと。最終クロールの日付が空になること。そして、先送りの理由として、サイトへの負荷の見込みが「通常(Typically)」の理由として挙げられていることである。「通常」は、常にそうだという意味ではない。どのURLが、どの理由で先送りされたかを、この画面だけで知ることはできない。
隣の「クロール済み - インデックス未登録」との違い
似た名前のステータスに、「クロール済み - インデックス未登録」がある。こちらについて、ヘルプは次のように書く。
"The page was crawled by Google but not indexed. It may or may not be indexed in the future; no need to resubmit this URL for crawling."
(訳: そのページはGoogleにクロールされたが、インデックスには登録されなかった。将来、登録されるかもしれないし、されないかもしれない。このURLをクロール用に再送信する必要はない。)
2つの違いは、止まった場所である。「検出」は取りに行く前、「クロール済み」は取りに行ったあとで止まっている。最終クロールの日付が空かどうかが、見分けるための手がかりになる。ステータスの18種類の一覧は、ページのインデックス登録レポートは18ステータスに分かれる ── 対処が要るかどうかを確認する13項目(2026年9月時点)に書いた。この記事では、そのうちの「検出 - インデックス未登録」だけを深く扱う。
未登録は、それだけで問題とは限らない
同じヘルプのページは、レポートの冒頭で、未登録のURLがあることを問題と決めつけないよう書いている。
"Non-indexed URLs can be fine. Read and understand the specific reason for each non-indexed URL to confirm that the page shouldn't be indexed."
(訳: インデックスに登録されていないURLは、問題ない場合がある。登録されていないURLごとの具体的な理由を読んで、そのページが登録されるべきでないことを確かめる。)
さらに、「見るべきでないもの」として、すべてのURLが登録される「100%の網羅」と、新しい内容がすぐ登録されることを挙げている。前者は、次のように書く。
"100% coverage: You should not expect all URLs on your site to be indexed, only the canonical pages, as described above."
(訳: 100%の網羅: サイトのすべてのURLが登録されることを期待してはならない。登録されるのは、上で説明した正規のページだけである。)
この説明から、「全部が登録されていない」ことと、「登録したいページが登録されていない」ことは別の話だと分かる。件数を見て慌てる前に、登録したいページがどれだけ含まれているかを、先に分ける必要がある。
クロールバジェットの文書での位置づけ
Google検索セントラルの「クロールバジェットの管理」(Optimize your crawl budget)は、非常に大きなサイト向けの文書である。対象の1つとして、「検出 - インデックス未登録」に分類されるURLが全体の大きな割合を占めるサイトを挙げている。
"Sites with a large portion of their total URLs classified by Search Console as Discovered - currently not indexed"
(訳: 全体のURLのうち、Search Consoleで「検出 - インデックス未登録」に分類されたものが大きな割合を占めるサイト。)
同じ文書は、そうでないサイトには読む必要がないとも書く。
"If your site doesn't have a large number of pages that change rapidly, or if your pages seem to be crawled the same day that they are published, you don't need to read this guide. For Google Search specifically, keeping your sitemap up to date and checking the Page Indexing report regularly is adequate."
(訳: 急速に変わるページが多くない場合、またはページが公開した当日にクロールされているように見える場合、このガイドを読む必要はない。Google検索に限れば、サイトマップを最新に保ち、ページのインデックス登録レポートを定期的に確認すれば十分である。)
この文書は、数字の目安も添えている。100万ページ以上で週に1回ほど内容が変わる大きなサイトと、1万ページ以上で内容が毎日変わる中規模以上のサイト。ただし、「これらは正確な境目ではない」とも書く。件数が多いと感じても、まず自分のサイトが、この文書の対象に当たるかを確かめる。
02 なぜ・背景 — 件数に慌てて押して回る前に、どこで止まったかを知る
見つける・取りに行く・登録するの3段
Googleが検索結果に出すまでの流れは、「どのページがあるかを知る」「取りに行く」「登録する」の順に進む。Google検索セントラルの「Google検索のしくみの詳しい解説」は、見つけたURLをすべて取りに行くわけではないと書く。
"However, Googlebot doesn't crawl all the pages it discovered."
(訳: ただし、Googlebotは、見つけたすべてのページをクロールするわけではない。)
また、取りに行ったページがすべて登録されるわけでもない。
"Indexing isn't guaranteed; not every page that Google processes will be indexed."
(訳: 登録は保証されていない。Googleが処理したすべてのページが登録されるわけではない。)
3段のどこにも、「全部が次へ進む」という約束はない。「検出」で止まっているURLがあるのは、仕組みの上でありうることである。問題は、登録したいURLが、いつまでも止まっているかどうかにある。
取りに行く量を決める2つの要素
クロールバジェットの文書は、サイトごとに取りに行く量には上限があると説明している。その量は、2つの要素で決まる。
"A site's crawl budget is determined by two main elements: crawl capacity limit and crawl demand."
(訳: サイトのクロールバジェットは、2つの主な要素で決まる。クロールの許容量の上限と、クロールの需要である。)
許容量は、サーバーが無理なく応えられる量である。文書によれば、サイトの応答が安定して速ければ上がり、遅くなったり、サーバーのエラーが出たりすると下がる。需要は、サイトの大きさ、更新の頻度、ページの質、ほかのサイトと比べた関連性で変わる。需要のうち、運営者が最も動かしやすいのは、Googleが知っているURLの量である。
"Without guidance from you, Google tries to crawl all or most of the URLs that it knows about on your site."
(訳: あなたからの案内がなければ、Googleは、サイトについて知っているURLのすべてか、そのほとんどをクロールしようとする。)
重複したURLや、不要になったURLが多いと、その分のクロールの時間が使われる。文書は、これが運営者が最も良い方向に動かせる要素だと書いている。
サーバーの返事は、取りに行く量に響く
サーバーが429や5xxのエラーを返すと、Googleは取りに行く速さを落とす。HTTPステータスの文書は、次のように書いている。
"5xx and 429 server errors prompt Google's crawlers to temporarily slow down with crawling."
(訳: 5xxと429のサーバーエラーは、Googleのクローラーに、クロールを一時的に遅くさせる。)
サーバーが落ちていた日や、アクセスが多すぎて断った日があれば、その後の取りに行く量が減りうる。サーバーの返事は、Search Console クロールの統計情報レポート ── 90日分のGooglebotの動きから読める8指標を確認する14項目(2026年9月時点)で見られる。
押して回っても、解決する保証はない
件数が多いと、URL検査の「インデックス登録をリクエスト」を、1本ずつ押したくなる。ヘルプは、押しても登録は保証されず、1日の上限があると書いている。
"Submitting a request does not guarantee that the page will appear in the Google Index."
(訳: リクエストを送っても、そのページがGoogleのインデックスに表示されるとは限らない。)
Google検索セントラルの「ウェブサイトの再クロールをGoogleにリクエストする」(Ask Google to Recrawl Your Website)も、同じことを別の言い方で書いている。
"Requesting a crawl does not guarantee that inclusion in search results will happen instantly or even at all."
(訳: クロールをリクエストしても、検索結果への掲載がすぐに起きる、あるいは起きること自体が、保証されるわけではない。)
リクエストの意味は、Search ConsoleのURL検査「インデックス登録をリクエスト」は何をしているのか ── 公式の言葉で確認する13項目(2026年9月時点)で整理した。ここで押さえるのは、多くのURLに効かせたいときは、リクエストを繰り返すより、サイトマップや内部リンクで知らせるという公式の方向である。
実務のヒント
件数を前の週と並べるとき、Search Consoleの「最終更新日」を一緒に書く。画面の数字が更新されていない週は、増減がなくても、変化がなかったとは言えないからである。
03 この記事に出てくる用語
クロールとインデックス登録
クロールは、Googlebotがページの内容を取りに行くことである。インデックス登録は、取りに行った内容を処理して、検索結果に出せる状態にGoogleのデータベースへ入れることである。「検出 - インデックス未登録」は、クロールの前で止まっている状態を指す。
クロールバジェット
用語
クロールバジェットは、Googleがサイトに対して、取りに行ける量と、取りに行きたい量の組み合わせである。文書は、取りに行ける量を「クロールの許容量の上限」、取りに行きたい量を「クロールの需要」と呼んでいる。Googleがサイトを区別する単位は、ホスト名である。たとえばwww.example.comとcode.example.comは、別々のバジェットを持つ。
最終クロール
URL検査ツールに出る項目の1つで、そのページをGoogleが最後に取りに行った日時である。ヘルプは、「このツールに出る情報は、すべてこの最後に取りに行ったときの版から得られる」と書く。「検出 - インデックス未登録」では、この日付が空になる。
ソフト404
用語
ソフト404は、中身が無い・見つからないページなのに、ステータスが404ではなく200で返っているページである。クロールバジェットの文書は、ソフト404のページは取りに行かれ続けて、バジェットを無駄にすると書く。存在しなくなったページは、404か410を返すよう勧めている。
04 型別 — 適用範囲・公式が書いていないこと・確かめる順番
🅰 適用範囲 — 件数が多いと感じたときの確かめ方
ここで扱うのは、Search Consoleに「検出 - インデックス未登録」の件数が出ていて、その件数が多いか、増えているかが気になるサイトの運営者である。1万ページ未満の、ほぼ変化のないサイトで、件数がごく少ない場合は、クロールバジェットの文書の言うとおり、サイトマップを最新に保ち、レポートを定期的に見るだけで足りる。
🅱 公式が書いていないこと
今回開いたヘルプと文書のなかには、次のことは書かれていなかった。
- 何件から「多い」と言えるか。件数の基準も、全体のURLに対する割合の目安も、見つからなかった。クロールバジェットの文書は、「大きな割合」としか書いていない
- 先送りされたURLが、何日で取りに行かれるか。「通常」先送りの理由が負荷の見込みだとは書くが、日数の目安は書いていない。ヘルプは、新しいページは数週間かかることがあるとだけ書く
- どのURLが、どの理由で先送りされたか。レポートの画面から、URLごとの理由を知ることはできない
- 件数の増減が、サイトの品質の評価を表すかどうか。「検出」は取りに行く前の状態なので、品質の評価の話としては扱われていない
この4つは、各サイトの記録から、自分の言葉で判断するしかない。公式が書いていない部分を、推測で埋めない。判断の材料として、確かめる順番を次に並べる。
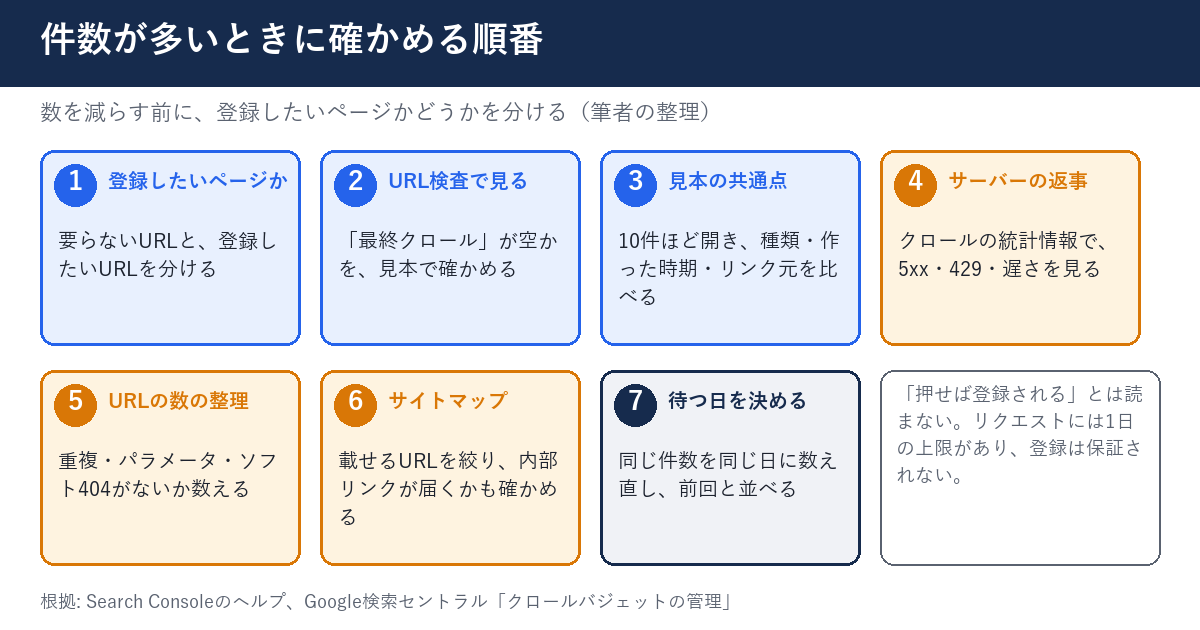
🅲 手順 — 確かめる7段
手順1 — 登録したいページかを分ける
最初に、一覧のURLを、登録したいものと、登録しなくてよいものに分ける。ヘルプは、重複したページ、フィルターを変えた別版のページ、転送されるURLは、Googleが登録しないものだと書く。件数を減らす目的で作業を始める前に、登録したいURLが何件あるかを数える。レポートの例の一覧には、次の制限がある。
"The list does not necessarily show all URLs with that issue, and is limited to 1,000 rows."
(訳: その一覧は、その問題のあるすべてのURLを出すとは限らず、1,000行までに限られる。)
手順2 — URL検査で、最終クロールが空かを見る
一覧から数件を選んで、URL検査を開く。「最終クロール」が空なら、「検出」の説明に合う。日付が入っていれば、取りに行かれたあとで登録されなかった状態で、「クロール済み」の側の話になる。
手順3 — 見本を10件ほど開いて、共通点を探す
10件ほどのURLを開いて、共通点を探す。ページの種類(記事・一覧・パラメータ付きなど)、作った時期、リンクされている場所、サイトマップに載っているかを書き出す。共通点が見つかれば、その種類を1つの塊として扱える。URL検査の「参照元ページ」と「サイトマップ」の欄が、手がかりになる。
手順4 — サーバーの返事を見る
クロールの統計情報の「ホストのステータス」は、直近90日のあいだに、Googleがサーバーの利用可否に問題を見つけたかを示す。ヘルプは、緑が望ましく、赤なら詳細を見るよう書く。5xxや429の返事が多かった日、応答が遅い日がないかを、この画面で確かめる。
手順5 — URLの数を整える
重複、パラメータ付きのURL、ソフト404、長い転送の連なりがないかを数える。クロールバジェットの文書は、重複の統合、不要なURLのrobots.txtでのブロック、削除したページへの404・410、ソフト404の解消、長い転送の連なりを避けることを、取りに行く効率を上げる方法として挙げている。
手順6 — サイトマップと内部リンクを確かめる
サイトマップには、登録したいURLだけを載せる。ヘルプは、サイトマップが、載せたURLのすべてが取りに行かれて登録されることを保証するものではないと書いている。
"A sitemap helps search engines discover URLs on your site, but it doesn't guarantee that all the items in your sitemap will be crawled and indexed."
(訳: サイトマップは、検索エンジンがサイトのURLを見つけるのを助けるが、サイトマップに載せたすべての項目がクロールされ登録されることを保証するものではない。)
内部リンクは、登録したいページから、トップや一覧のページからたどれるかを確かめる。リンクをクロール可能にする ── href属性が無ければ、Googleには読まれない13項目(2026年9月時点)に、リンクの書き方の条件がある。
手順7 — 待つ日を決めて、同じ日に数え直す
手順1から6で手を入れたあとは、すぐには数字が変わらない。ヘルプは、リクエストを出しても、登録はすぐには起きないと書く。
"Indexing is never instant, even when you submit a crawl request directly."
(訳: クロールのリクエストを直接送っても、登録がすぐに起きることはない。)
次に件数を数える日を決め、同じ曜日・同じ画面で数え直して、前回と並べる。待つ日数の目安は、ヘルプにある「数週間」までを上限に、自分で決める。
注意
robots.txtは、取りに行く量を管理するためのものである。ページを検索結果から隠す方法としては使わない。Google検索セントラルのrobots.txtの説明は、検索結果に出したくないときは、パスワードやnoindexなど別の方法を使うよう書いている。件数を減らしたいという理由だけで、登録したいページまでブロックしない。
05 明日、自社のサイトで確認できることチェックリスト
以下は、「検出 - インデックス未登録」の件数が多いときに、自社のサイトで確かめるための13項目である。1〜3番目は件数と一覧、4〜7番目は見本の確認、8〜11番目はサーバー・URL・サイトマップ、12〜13番目は到達と次の数え直しである。チェックの状態はブラウザに保存され、サーバーには送られない。
- Search Consoleの「ページのインデックス登録」を開き、「検出 - インデックス未登録」の件数と、画面の最終更新日を書き留める
- 同じ画面で「クロール済み - インデックス未登録」の件数を書き留め、2つの件数を並べて、比率を1行にまとめる
- 「検出 - インデックス未登録」の行を開いて例の一覧をエクスポートし、保存した行数と、画面の件数を並べて書き留める
- 一覧から10件を選び、URL検査で開いて、「最終クロール」が空かどうかを1件ずつ書き留める
- 10件を、登録したいページと、重複や不要なURLに分けて、それぞれの件数を書き出す
- 10件のURL検査の「参照元ページ」と「サイトマップ」の欄を見て、どちらも空の件数を数える
- 一覧のURLを、記事・一覧・パラメータ付きなどの種類に分け、いちばん多い種類を書き留める
- クロールの統計情報を開き、ホストのステータスと、直近90日の5xxの日数を書き留める
- 自分のサイトで、同じ中身が複数のURLで開くものを3組探して、書き出す
- サイトマップを開いて、載せているURLの数と、登録したいページの数を並べ、差を書き出す
- サイトマップの更新日が、実際の更新日と合っているかを、3つのURLで確かめて書き留める
- 登録したい未登録の1本を選び、トップのページから3回までのクリックで内部リンクをたどって届くかを確かめる
- 次に件数を数える日を、2週間後の同じ曜日に決め、カレンダーに入れる
06 代替・他の選択肢 — 件数への向き合い方は、5つに分かれる
向き合い方ごとの向き不向きと、公式が書いていること
「検出 - インデックス未登録」の件数に向き合う方法は、待つ、リクエストする、サイトマップを整える、URLの数を減らす、サーバーの返事を良くする、の5つがある。公式の文書が書いていることを、表に並べる。
| 向き合い方 | 向く場面 | 公式の文書が書いていること |
|---|---|---|
| 待つ | 公開してまもないページが少しある | 新しいページが取りに行かれるまで、数日から数週間かかることがある。リクエストしても登録はすぐに起きない |
| 個別にリクエストする | 重要な数本だけ | 1日に出せる数に上限がある。登録は保証されない |
| サイトマップを整える | 新しいページや更新したページが多い | 多数のURLには、サイトマップが最善の方法とされる。ただし、すべてが取りに行かれて登録されるとは限らない |
| URLの数を減らす | 重複・パラメータ付き・不要なURLが多い | 重複の統合、ブロック、404・410、ソフト404の解消が、効率を上げる方法に挙がる |
| サーバーの返事を良くする | 5xxや429、遅い応答がある | 応答が安定して速ければ許容量が上がり、遅い・エラーが出れば下がる |
表の読み方は、「どれが最も効くか」ではなく、件数の原因に合わせて選ぶことである。重複が多いサイトでリクエストを重ねても、取りに行く量は変わらない。手順2から5で原因の見当をつけてから、選ぶ。
当サイトの無料ツールとの使い分け
一覧をエクスポートしたあとの確認には、🔧 Search Consoleのエクスポートを読み込んで詳しく見るツール — 未登録のURLの一覧を読み込ませて、今の状態を調べるが使える。エクスポートした「表.csv」をアップロードし、サイトのURLを入れると、一覧のURLが今どう返るか、どこからリンクされているかを調べられる。ツールの画面には、上限として最大1,000件の件数が示されている。一覧が1,000行までなので、エクスポートの上限とそろう。
内部リンクの確認には、🔧 サイト内のリンク漏れ・アクセスステータスを調べるツール — Excelに出力できるが使える。サイトの中のリンクが開くかを調べるので、手順6で内部リンクの先が壊れていないかを確かめる補助になる。登録したいページにリンクが届いているかを見るツールではない。どちらも、Googleの判断を知るツールではなく、自分のサイトの状態を確かめるツールである。
robots.txtでの整理を選ぶとき
クロールバジェットの文書は、重複や不要なページを、robots.txtでブロックする方法を挙げている。noindexは、この目的では勧めない、と書く。
"Don't use noindex, as Google will still request, but then drop the page when it sees a noindex meta tag or header in the HTTP response, wasting crawling time."
(訳: noindexは使わない。Googleは、それでもそのページを取りに行き、HTTPの応答のnoindexのメタタグやヘッダーを見て、ページを外すため、クロールの時間を無駄にする。)
noindexとrobots.txtとnofollowの違いは、noindex・nofollow・robots.txtは、それぞれ何を止めているのか ── 混同しやすい3つの設定を確認する15項目にまとめた。取りに行く量を減らしたいときと、検索結果に出したくないときでは、選ぶ方法が違う。
07 当サイトの例 — 件数は115件に増えたが、増えた理由は確かめていない
2026年10月9日時点の件数
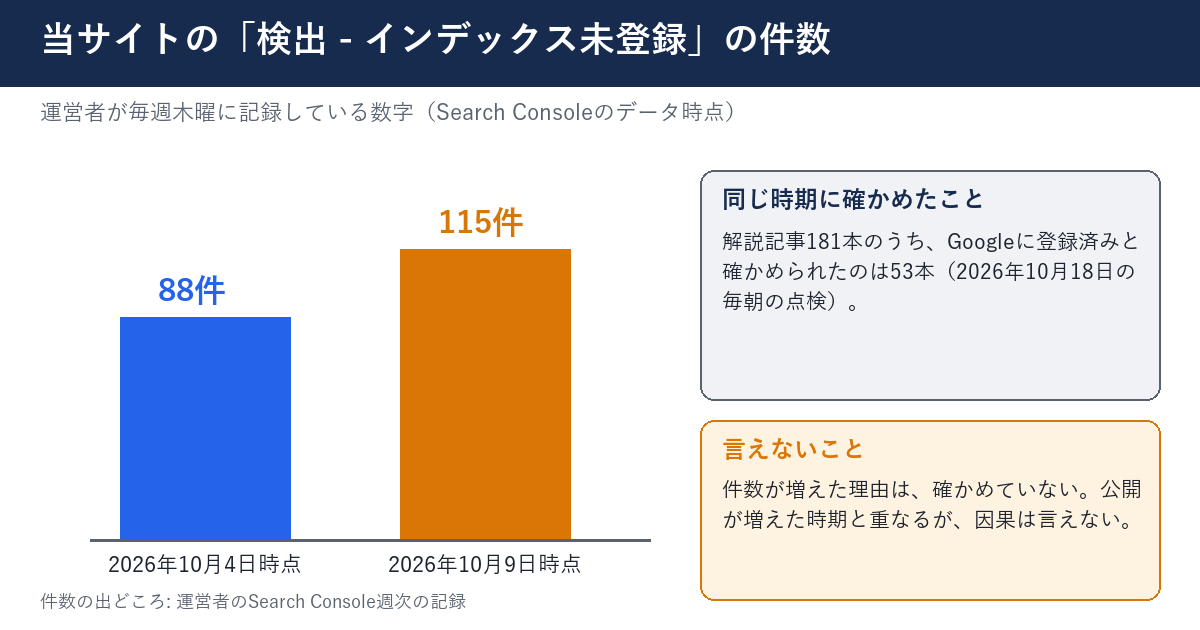
当サイトの運営者は、毎週木曜にSearch Consoleの「ページのインデックス登録」の件数を記録している。「検出 - インデックス未登録」は、2026年10月9日のデータの時点で115件だった。前回の点検は、2026年10月4日のデータの時点で88件だった。5日ぶんのデータの間に、27件増えた。
同じ時期に確かめたこと
当サイトでは、解説記事を書き直しながら、公開を増やしている。毎朝の点検では、公開中の解説記事が、Googleに登録済みかどうかを1本ずつ確かめている。2026年10月18日の点検では、解説記事181本のうち、登録済みと確かめられたのは53本だった。
ここで注意が要る。115件という数字はSearch Consoleの10月9日のデータで、53本という数字は10月18日の点検の結果である。日付が9日違うので、2つの数字を引き算して「未登録は何本」とは言えない。「検出」の件数には、解説記事以外のURLも含まれうるが、内訳は今回確かめていない。
件数が増えた理由として、言えることと言えないこと
言えるのは、公開の本数を増やした時期と、件数が増えた時期が重なっていることまでである。公開が増えれば、Googleが知るURLが増える。だが、増えた分が「取りに行く量の上限に当たった」のか、「単にまだ順番が来ていない」のかは、レポートの画面からは分からない。ヘルプの言うとおり、理由はURLごとには出ない。
サーバーの返事については、記録がある。当サイトでは、記事ページの表示が1〜4秒かかっていた時期があり、9月30日に0.1〜0.27秒に直した(警告1,440件の中に、本物は2件だけだった ── 「報告は大げさ」は正しかったのに、記事ページは本当に遅かった)。クロールバジェットの文書は、サイトの応答が速く安定していれば、取りに行く量の上限が上がると書く。だが、この修正が、10月9日の件数に影響したかは確かめていない。順序だけを書き、因果は書かない。
実務のヒント
件数が増えたとき、理由を推測で1つに決めると、次の手を外す。手順1から5で分けた塊ごとに、件数の変化を並べるほうが、原因に近づく。当サイトの記録は、まだその塊ごとの内訳を持っていない。
確かめていないこと
- 115件の内訳(解説記事・ブログ・ツールなどの種類別)。種類別には数えていない
- 115件のURLの、URL検査での「最終クロール」の状態。10件の見本も、今回は開いていない
- 解説記事の登録が増えたことと、「検出」の件数が増えたことの関係。2つは別の日付の数字である
- ほかのサイトでの結果。数字は、当サイトの1サイトの記録である
08 このテーマは、ここまで
2025年12月〜2026年2月 — 引用した文書の更新日
「ウェブサイトの再クロールをGoogleにリクエストする」と「robots.txtの概要とガイド」は2025年12月10日、「Google検索のしくみの詳しい解説」は2025年12月18日、「HTTPステータスコードがGoogleのクローラーに与える影響」は2026年2月4日が、それぞれ更新日(UTC)として表示されている。リクエストが登録を保証しないという文は「再クロールをGoogleにリクエストする」に、見つけたURLをすべて取りに行くわけではないという文は「Google検索のしくみの詳しい解説」にある。
2026年7月22日 — クロールバジェットの文書の更新日
「クロールバジェットの管理」は、更新日が2026年7月22日(UTC)と表示されている。「検出」の多いサイトを対象に挙げる項目は、この版にある。
この記事の確認日
この記事の内容は、2026年10月19日に各ページを開いて確かめた。Search Consoleのヘルプには、更新日の表示が見つからなかった。記述が変わったときは、01章に日付つきで追記する。
現在の貴方のIPアドレス
このサイトで書いている人