WEBサイト
GoogleのURL構造の指針が挙げるURLが増える例を、筆者は6つに分けた。10月23日の更新はハイフンとアンダースコアの書き方だけ ── 担当サイトで増える形を確認する13項目(2026年10月時点)
GoogleのURL構造の指針が挙げるURLが増える例を、筆者は6つに分けた。10月23日の更新はハイフンとアンダースコアの書き方だけ ── 担当サイトで増える形を確認する13項目(2026年10月時点)
目次
- 01 何が書いてあるか — 更新履歴は「単語の区切り」の明確化、ページ本体はURLが増える例を挙げる(筆者は6つに分けた)
- 02 なぜ・背景 — URLが増えると、Googleは似た内容に時間を使い、新しいページの発見が遅れうる
- 03 用語 — URLの増え方の話で出てくる言葉を、先にそろえる
- 04 型別 — 増える形ごとに、見つけ方と、公式が書く止め方を並べる
- 05 明日、自社のサイトで確認できることチェックリスト
- 06 代替・他の選択肢 — 止め方は複数ある。公式が先に書くのは、取らせない方法
- 07 当サイトで確かめたこと — 公開しているURL19本とrobots.txt・サイトマップを開いた結果と、確かめていないこと
- 08 このテーマは、ここまで
- 09 この記事のまとめ
01 何が書いてあるか — 更新履歴は「単語の区切り」の明確化、ページ本体はURLが増える例を挙げる(筆者は6つに分けた)
引用について
この記事の「" "」で囲んだ英語の文は、Google検索セントラルの文書からの引用で、日本語訳は記事の筆者が付けたものである。日本語で囲んだ文は、日本語版のページの原文をそのまま写した。各ページは2026年10月26日に開いて、本文を取り直して確かめた。
Google検索セントラルに、「URL構造のベストプラクティス」のページがある。このページの更新が、2026年10月23日の日付で、検索セントラルの更新履歴に載った。この記事は、更新の中身そのものよりも、ページが今書いている「URLが不必要に増える形」を、担当サイトで確かめる方法に絞る。読みやすいURLの付け方(ハイフン、日本語、パーセントエンコード)は公式文書が勧めるURLは、読める言葉・ハイフン区切り・リンク内のパーセントエンコード。キーワードの順位への効果は小さく、変えるかは手間と並べて決める ── 自社のURLの付け方を確認する13項目(2026年10月時点)に書いたので、ここでは繰り返さない。
更新履歴の10月23日の項目は、小さな更新だった
更新履歴の2026年10月23日の項目は、見出しが「Updated guidance on crawlable URL structures」(訳: クロールできるURL構造の指針を更新した)で、中身は次の2行である。
"What: Updated the URL structure best practices to clarify word separation guidelines using hyphens versus underscores."
(訳: 内容: 単語を区切る指針について、ハイフンとアンダースコアのどちらを使うかを明確にするため、URL構造のベストプラクティスを更新した。)
"Why: To synchronize the documentation with the episodes of "The Non-Canonical Cabinet" video series."
(訳: 理由: ドキュメントを、「The Non-Canonical Cabinet」というビデオシリーズの各回に合わせるため。)
項目の内容は、ハイフンとアンダースコアの書き方の明確化で、URLが増える形には触れていない。だから、10月23日の更新で「URLが増える形の指針が変わった」とは読めない。理由の欄にあるビデオシリーズの中身は、この記事では確かめていない。
ページの日付は3つあり、どれもずれている
同じ内容のページの日付を読むと、3つの日付が出た。
- 英語版のページの末尾: 「Last updated 2026-10-21 UTC.」
- 日本語版のページの末尾: 「最終更新日 2026-10-25 UTC。」
- 更新履歴の項目: 2026年10月23日
どれかに丸めると、どの変更がいつ入ったかが分からなくなるので、3つを並べて書く。日本語版が英語版より新しい理由は、ページに書かれていない。
ページが挙げる、URLが増える例を、筆者は6つに分けた
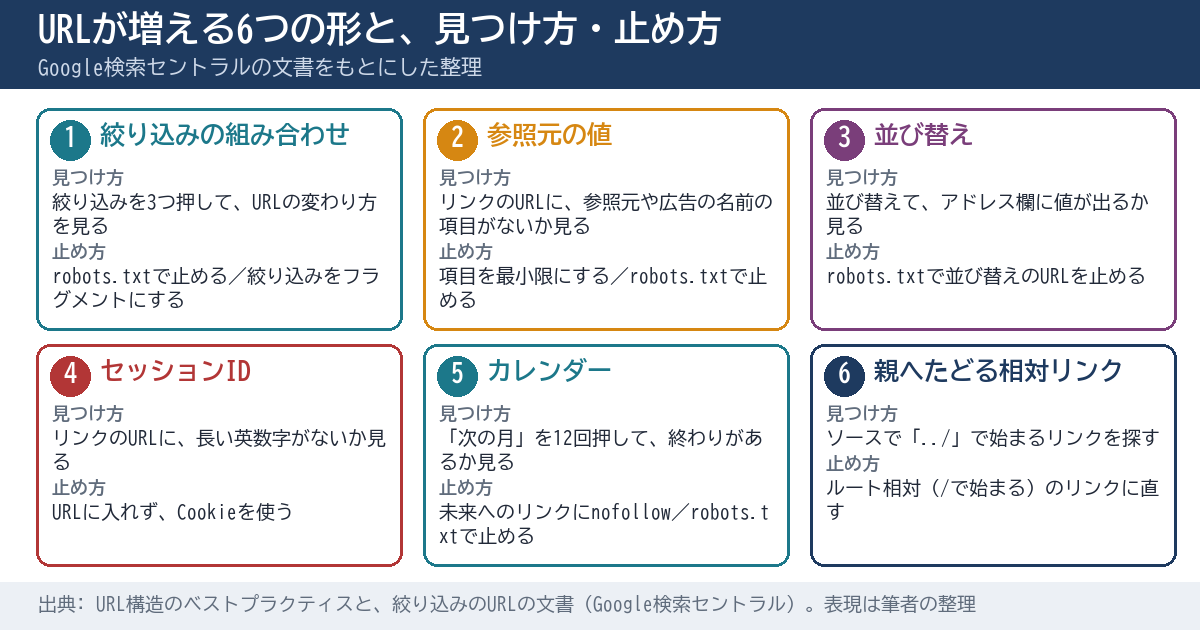
ページの「Avoid common issues related to URLs」(日本語版の見出しは「URL に関する一般的な問題を回避する」)は、URLが不必要に増える原因を挙げる。ページの見出しは4つ(絞り込みの組み合わせ、不必要なパラメータ、カレンダー、破損した相対リンク)で、この記事では、筆者が6つの形に分けた。6という数は、筆者の分け方である。
- 複数の絞り込みの組み合わせ
- 参照元の値を付けるパラメータ
- 並び替えのパラメータ
- セッションID
- カレンダー
- 親ディレクトリへの相対リンク(日本語版の見出し: 「破損した相対リンク」)
2〜4番目は、ページの中では「不必要なパラメータ」という1つの見出しの下にまとまっている。ページは、これらの問題を、次のようにまとめて書く。
"Overly complex URLs, especially those containing multiple parameters, can cause problems for crawlers by creating unnecessarily high numbers of URLs that point to identical or similar content on your site."
(訳: 過度に複雑なURL、とくに複数のパラメータを含むものは、サイトの中で同じ、または似た内容を指すURLを、必要以上に多く作ることで、クローラーに問題を起こしうる。)
既存の記事との分担
URLパラメータの基本はURLパラメータとは? SEOへの影響と、重複コンテンツを防ぐ設定の基本(2026年8月時点)、リンクをクロールできる形にする話はリンクをクロール可能にする ── href属性が無ければ、Googleには読まれない13項目(2026年9月時点)、転送の話は301リダイレクトは被リンクの評価を引き継ぐか? チェーンと着地点の落とし穴(2026年8月時点)で扱った。この記事は、それらに無い、URLが際限なく増える形の見つけ方と、止め方の順番だけを書く。
02 なぜ・背景 — URLが増えると、Googleは似た内容に時間を使い、新しいページの発見が遅れうる
公式が挙げる2つの害
Googleは、絞り込みのURLの害を、2つに分けて書く。1つ目は、似たURLを取りすぎること(Overcrawling)。2つ目は、新しいURLの発見が遅れることである。
"Slower discovery crawls: Stemming from the previous point, if crawling is spent on useless URLs, the crawlers have less time to spend on new, useful URLs."
(訳: 発見のためのクロールが遅くなる。前の点から続く話で、役に立たないURLにクロールが使われると、新しい、役に立つURLに使える時間が減る。)
組み合わせは、掛け算で増える
ページは、絞り込みを重ねられる場合の増え方を、次のように書く。
"When filters can be combined in an additive manner (for example: hotels on the beach and with a fitness center), the number of URLs (views of data) in the sites explodes."
(訳: 絞り込みを、足し合わせる形で組み合わせられると(たとえば、ビーチ沿いで、フィットネスセンターのあるホテル)、サイトのURL(データの見え方)の数は爆発する。)
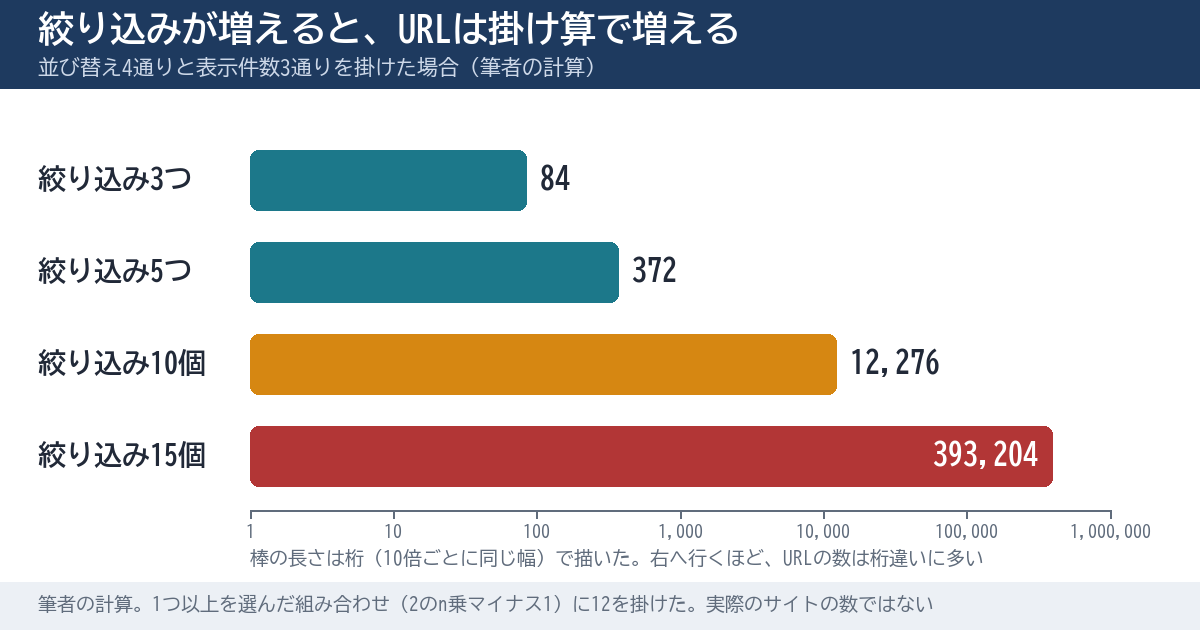
「爆発する」がどのくらいか、数えてみる。絞り込みのオン・オフだけを考えると、n個の絞り込みを同時に使える一覧ページには、1つ以上を選んだ組み合わせが2のn乗マイナス1通りある。そこに、並び替え4通りと表示件数3通りが掛かるとすると、次の表になる(筆者の計算で、実際のサイトの数ではない)。
| 同時に使える絞り込みの数 | 1つ以上を選んだ組み合わせ | 並び替えと表示件数を掛けた数 |
|---|---|---|
| 3つ | 7通り | 84 |
| 5つ | 31通り | 372 |
| 10個 | 1,023通り | 12,276 |
| 15個 | 32,767通り | 393,204 |
絞り込みが10個ある一覧ページが1つあるだけで、数字の上では1万2千通りを超える。商品や記事の数は変わらないのに、URLだけが増える。
「小さなサイトは気にしなくてよい」とも読めるが、書かれている文書が別である
Googleには、クロールの量の話を、大きなサイト向けに書いた文書もある。「クロールバジェットを最適化する」のページの冒頭は、こう書く。
"If your site doesn't have a large number of pages that change rapidly, or if your pages seem to be crawled the same day that they are published, you don't need to read this guide."
(訳: 素早く変わるページが大量にあるサイトでなかったり、ページが公開された当日にクロールされているように見えたりするなら、このガイドを読む必要はない。)
一方、URL構造のページ(日本語版)は、基準を満たさないURLについて、サイトの大きさを条件にせずに、こう書く。
「URL が以下の基準を満たしていない場合、Google 検索によるサイトのクロール効率が低下する可能性があります(クロール頻度が極端に高くなったり、まったくクロールされなかったりなど)。」
2つの文書は、目的が違う。確認は5分以内のものだけで組んだので、大きなサイトでなくても、一度、増える形が無いかを見ておく価値はある。
自分で変えられるのは、Googleが知っているURLの数
クロールバジェットは、Googleがクロールできて、クロールしたいと考えるURLの集合のことである(ガイドの定義)。ガイドは、クロールしたい量を決める要素のうち、サイト側で変えられるものを、次のように書く。
"Perceived inventory: Without guidance from you, Google tries to crawl all or most of the URLs that it knows about on your site."
(訳: 認識している在庫。あなたからの案内が無ければ、Googleは、サイトの中で知っているURLの全部、またはほとんどをクロールしようとする。)
文書は、この要素が、サイト側でいちばん変えやすいものだと書く。手が届くのは、Googleに知られているURLの数を減らすことである。
実務のヒント
URLが増える形を見つけたら、先に「そのURLを検索に出したいか」を決める。出したいURLと、出さなくてよいURLで、止め方が変わるからである(06章で比べる)。
03 用語 — URLの増え方の話で出てくる言葉を、先にそろえる
クエリ文字列とURLパラメータ
URLの「?」より後ろが、クエリ文字列である。?color=red&size=sのように、「名前=値」の組みを「&」でつなぎ、1組みがURLパラメータである。
ファセットナビゲーション
用語
ファセットナビゲーションは、商品・記事・イベントなどの一覧を、色・価格・種類のような切り口で絞り込む仕組みである。Googleの文書は、これを、訪問者が項目の表示のしかたを変えられる機能と説明し、URLパラメータで作る実装がいちばん多いと書く。
ルート相対リンクと、親ディレクトリへの相対リンク
用語
ルート相対リンクは、/category/stuffのように、スラッシュで始まるリンクで、どのページに置いても同じ場所を指す。親ディレクトリへの相対リンクは、../../category/stuffのように「../」を使うリンクで、置いたページの場所によって指す先が変わる。
URLフラグメント
URLの「#」より後ろの部分である。Googleの文書は、Google検索は通常フラグメントをサポートしないと書く。つまり、フラグメントで切り替えた内容は、別のURLとして取られない。JavaScriptで内容を切り替えるときは、フラグメントの代わりにHistory APIを使うよう、URL構造のページとJavaScriptのSEOの基本のページの両方が書いている。この性質が、06章で止め方の1つとして出てくる。
04 型別 — 増える形ごとに、見つけ方と、公式が書く止め方を並べる
🅰 適用範囲 — どんなサイトに当てはまるか
絞り込みや並び替えのある一覧、広告や分析のパラメータを足したリンク、日付ごとに作る予定表、「../」で書いたリンクのいずれかがあるサイトに当てはまる。数十ページの会社案内のサイトで、絞り込みも予定表も無ければ、当たる形は少ない。ただし、広告や分析のパラメータと相対リンクは、小さなサイトにもある。
🅱 この記事が測っていないこと
- Googleが、担当サイトの増えたURLを、実際にどのくらい取っているか(ログと、Search Consoleの数字を見るまで分からない)
- 各手段(robots.txtやcanonical)を入れたあとの、取得量の変化
この記事が書くのは、公式の文書の内容と、増える形があるかを5分で確かめる動作である。影響の大きさは、確認のあとで、数字を見て決める。
🅲 手順 — 6つの形を、6つの手順で見つける
次の表は、6つの形と、担当サイトでの見つけ方、公式の文書が書く止め方を並べたものである。
| 増える形 | 担当サイトでの見つけ方 | 公式の文書が書く止め方 |
|---|---|---|
| 絞り込みの組み合わせ | 一覧で絞り込みを3つ押し、アドレス欄のURLの変わり方を見る | robots.txtで取得を止める。絞り込みをURLのフラグメントにする |
| 参照元の値 | リンクのURLに、参照元や広告の名前の項目が付いていないか見る | robots.txtで取得を止める。パラメータを最小限にする |
| 並び替え | 並び替えを切り替えて、アドレス欄に値が出るか見る | robots.txtで並び替えのURLを止める |
| セッションID | リンクのURLに、長い英数字の値が入っていないか見る | URLに入れず、Cookieを使う |
| カレンダー | 「次の月」を何回押せるか数える | 未来のカレンダーへのリンクにnofollowを付ける。robots.txtで止める |
| 相対リンク | ページのソースで「../」で始まるリンクを探す | ルート相対のリンクに直す |
手順1: 一覧ページで、絞り込みを3つ続けて押す
一覧ページ(商品、記事、施設など)を開き、絞り込みを3つ続けて押し、1つ押すたびにアドレス欄のURLを書き写す。「?」のあとに項目が足されていくなら、1番目の形に当たる。アドレスが変わらない、または「#」より後ろだけが変わるなら、増える形ではない。
手順2: 項目名を書き出し、参照元・並び替え・セッションIDにあたるものを分ける
手順1で見つけた「名前=値」の名前を、すべて書き出す。公式のページは、参照元・並び替え・セッションIDを、「不必要なパラメータ」の例に挙げる。該当する名前は、止める候補の最上位である。
手順3: 存在しない組み合わせと、存在しないURLの返事を見る
該当の商品が無い絞り込みの組み合わせと、でたらめなURLを、1つずつ開く。どちらも、404が返るのが正しい(いまのページのURLに単語を足した形は、元のURLへの301でもよい。05章の9番目)。公式の文書は、絞り込みの組み合わせに結果が無いときの返し方を、次のように書く。
"Return an HTTP 404 status code when a filter combination doesn't return results."
(訳: 絞り込みの組み合わせが結果を返さないときは、HTTPの404ステータスコードを返す。)
200で空の一覧や共通のエラー画面が返ると、存在しない組み合わせが、無数のURLとして残る。HTTPステータスの文書は、429以外の4xxについて、新しく見つけた404のページは処理されず、クロールの頻度は徐々に下がる、と書く。
手順4: カレンダーを12回めくる
予定表のあるページで「次の月」を12回押す。最後まで押せるなら、未来のページへのリンクに終わりが無い。公式の文書は、無限のカレンダーについて、次のように書く。
"If your site has an infinite calendar, add a nofollow attribute to links to dynamically created future calendar pages."
(訳: サイトに無限のカレンダーがあるなら、動的に作られる未来のカレンダーページへのリンクに、nofollow属性を付ける。)
1日ごとのページが続くカレンダーなら、1年で365ページ、100年で約3万6,500ページになる(筆者の計算)。
手順5: ソースで「../」で始まるリンクを探す
階層の深いページを3つ選び、ページのソースを開いて、href="../で始まるリンクを探す。見つけたら、そのリンクが、置いたページの場所によって、どこを指すかを計算する。
文書は、https://example.com/category/community/070413/html/FAQ.htm のページに<a href="../../category/stuff">を置くと、https://example.com/category/community/category/stuff のような、存在しないURLが作られうる、と書く。この例を計算で追うと、偽のページから同じリンクをたどるたびに階層が減り、3回で止まる。一方、category/stuffのように、先頭にスラッシュも「../」も無い相対リンクは、たどるたびに階層が1つ深くなる(筆者の計算)。
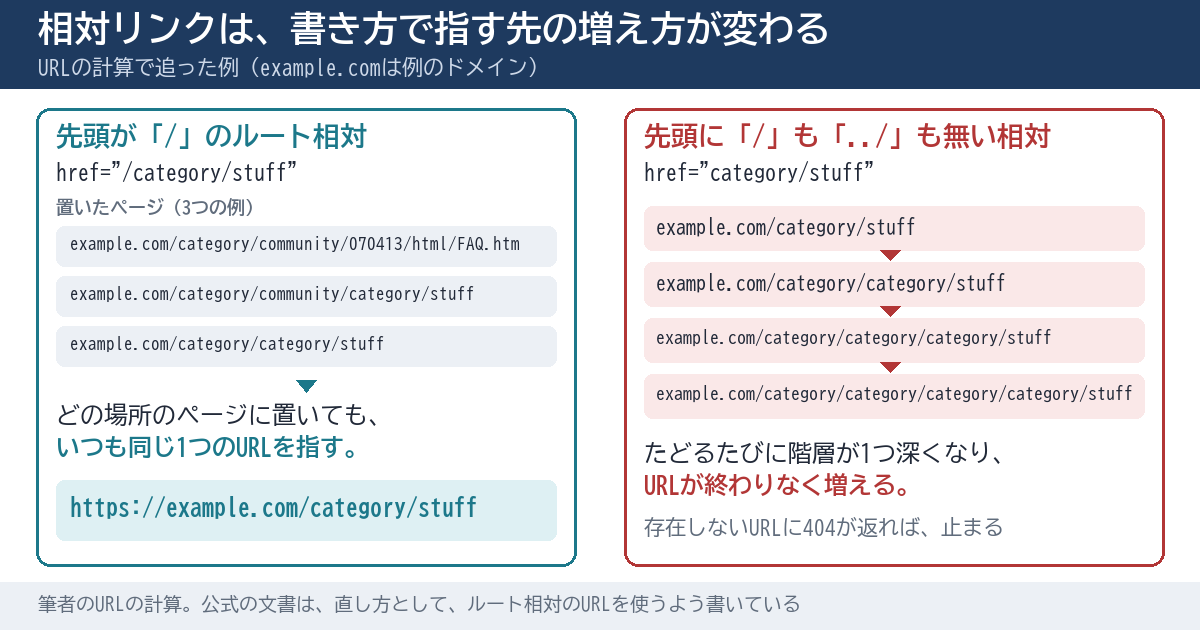
公式の文書は、直し方を次のように書く。
"To fix, use root-relative URLs in your links (instead of parent-relative)."
(訳: 直すには、リンクに、親ディレクトリへの相対ではなく、ルート相対のURLを使う。)
手順6: Search Console・ログ・robots.txtで、実際の取得を見る
最後に、Googleが増えたURLを実際に取っているかを、3か所で見る。
- Search Consoleのクロールの統計情報: 設定の「クロールの統計情報」から開く。ヘルプのページでは、「Crawl purpose」(クロールの目的)の項目に、「Discovery: The URL requested was never crawled by Google before.」(訳: 発見。要求されたURLは、Googleがそれまでクロールしたことが無かった)と「Refresh」(既知のページの再クロール)がある。発見の件数が増え、例のURLに「?」の付いたものが多いなら、増えた形を取られている目安になる。詳しい見方はSearch Console クロールの統計情報レポート ── 90日分のGooglebotの動きから読める8指標を確認する14項目(2026年9月時点)に書いた。
- アクセスログ: Googlebotの名乗りの行のうち、リクエストのURLに「?」が入る行を数える。
grep 'Googlebot' access.log | grep -c '"GET [^ ]*?'で数えられる(grep -c 'Googlebot' access.logの件数と並べて、割合を見る)。名乗りは偽装されうるので、数字は目安である。 - robots.txt: 担当サイトの
/robots.txtを開き、検索結果・並び替え・絞り込みのURLを止める行があるかを見る。
Search Consoleから書き出したURLの一覧を、今のHTTPステータスやリンク元つきで調べるなら、🔧 Search Consoleのエクスポートを読み込んで詳しく見るツールが使える。
05 明日、自社のサイトで確認できることチェックリスト
以下は、担当サイトで、URLが際限なく増える形があるかを確かめる13項目である。1〜6番目は絞り込み・セッションID・返事のステータス、7〜9番目はカレンダー・相対リンク・でたらめな単語を足したURL、10〜13番目はフラグメント・robots.txt・クロールの統計・結果の整理である。1項目は5分以内でできる。チェックの状態はブラウザに保存され、サーバーには送られない。
- 担当サイトの一覧ページを1つ開き、絞り込みを3つ続けて押して、アドレス欄のURLが変わるたびに書き写す
- 同じ3つの絞り込みを、逆の順番で押して、アドレス欄のURLの並びが、1回目と同じ形になるかを比べる
- 並び替えと表示件数を1回ずつ切り替えて、アドレス欄の「?」のあとの項目名を、すべて書き出す
- 書き出した項目名のうち、参照元・並び替え・セッションIDにあたるものに印を付けて、数を数える
- 3つのページのソースを開き、リンクのURLに、長い英数字のセッションIDのような値が入っていないかを探す
- 結果が無い絞り込みの組み合わせのURLを1つ作って開き、返事のステータスが404かを、ブラウザの開発者ツールで確かめる
- 予定表のあるページで「次の月」を12回押して、最後まで押せるかを確かめ、未来へのリンクにnofollowが付いているかを見る
- 階層の深いページを3つ選び、ソースで
href="../で始まるリンクの数を数える - いまのページのアドレスの末尾に、でたらめな単語を足したURLを1つ開き、404か、元のURLへの301が返るか、200で同じページが出るかを確かめる
- 絞り込みで内容を切り替える仕組みが、アドレスの「#」より後ろを使っていないかを、1ページで確かめる
- robots.txtを開き、検索結果・並び替え・絞り込みのURLを止める行があるかを確認する
- Search Consoleのクロールの統計情報を開き、直近90日の「Crawl purpose」(クロールの目的)のうち、発見の例のURLを10本見て、「?」の付いたものを数える
- 見つけた「増える形」を1つずつ書き出し、形ごとに、直す担当者と確認する日を決める
06 代替・他の選択肢 — 止め方は複数ある。公式が先に書くのは、取らせない方法
止め方の比較
| 止め方 | 向く場面 | 公式の文書が書くこと・注意 |
|---|---|---|
| robots.txtで止める | そのURLを検索に出さなくてよいとき | 索引から外す道具ではない。ブロックされたURLが、説明の無い形で結果に出ることがある |
| フラグメントで絞り込む | 絞り込みを、検索に出す必要が無いとき | フラグメントは通常サポートされないので、取得にも索引にも影響しない |
| 404を返す | 結果が無い組み合わせや、でたらめなURL | 共通のエラー画面へ転送せず、そのURLで404を返す |
| canonicalを付ける | 絞り込みの正規の形を示したいとき | 長い目では、止める方法より効きにくいと書かれている |
| nofollowを付ける | 未来のカレンダーや、絞り込みへのリンク | そのURLを指すすべてのリンクに付けないと効かない |
いちばん先に決めるのは、そのURLを検索に出したいかどうか
絞り込みのページは、止め方を2つに分ける。検索に出さなくてよいなら、取得を止める。出したいなら、「&」で区切る、パスに入れるなら順番を固定する、結果の無い組み合わせに404を返す、という基準に合わせる。
robots.txtで止めるときの書き方
絞り込みのページには、パラメータの名前ごとに取得を止める例がある。robots.txtは、サイトの一番上(ルート)に置くファイルである。
user-agent: Googlebot
disallow: /*?*products=
disallow: /*?*color=
disallow: /*?*size=
allow: /*?products=all$
この例は公式の文書の例そのままで、項目名は例である。自分のサイトでは、手順2で書き出した名前に置き換え、止めたくないURLまで止めないか、少ない数のURLで試してから入れる。
robots.txtは、索引から外す道具ではない
止める方法の筆頭はrobots.txtだが、注意がある。robots.txtの入門のページは、次のように書く。
"it is not a mechanism for keeping a web page out of Google."
(訳: それは、ウェブページをGoogleに出さないための仕組みではない。)
同じ文書は、robots.txtでブロックしたページのURLが、検索結果に出ることがあり、そのときは説明文が付かない、とも書く。
注意
すでに検索に出ているURLを、robots.txtだけで消そうとしない。取得を止めても、URLが結果に残ることがある。消したいときは、そのURLで404を返す、または別の方法を選ぶ。robots.txtを書き換える前に、止めるURLの形を、小さい範囲で試す。
canonicalとnofollowは、公式が「長い目では効きにくい」と書く
絞り込みのページは、止める方法を挙げたあとに、canonicalとnofollowを挙げ、次のように書く。
"However, these methods are generally less effective in the long term than the previously mentioned methods."
(訳: ただし、これらの方法は、先に挙げた方法より、長い目では一般に効きにくい。)
canonicalは、補助として使い、止める方法の代わりにしない。
公式は順番を数字では書いていない。この記事の順番は筆者の整理
公式の文書は、優先順位を数字では書いていない。次の順番は、筆者の並べ方である。
- URLを作らない: フラグメント、Cookie、ルート相対リンクにする
- 取りに来させない: 検索に出さなくてよいURLは、robots.txtで止める
- 存在しないものは404: 結果の無い組み合わせ、でたらめなURL
- 補助の信号: canonicalとnofollow
変更のあとは、手順1〜6をもう一度回して確かめる。
07 当サイトで確かめたこと — 公開しているURL19本とrobots.txt・サイトマップを開いた結果と、確かめていないこと
2026年10月26日に、当サイトの公開URL19本と、robots.txt、サイトマップを、外から開いた。確かめたのは、外から見える返事(ステータス、robotsの指定、canonical)だけである。
サイトマップの422本に、「?」と「#」は無い
サイトマップのURLは422本で、「?」を含むものも、「#」を含むものも0本だった。robots.txtには、「Disallow: /*?*token=」の行がある。検索結果・並び替え・絞り込みを止める行は無い。
パラメータを足しても、canonicalは足した値の無い形になる
解説記事、ブログの記事、無料ツールのページに、適当なパラメータを足して開いた。どれも200で開き、canonicalはパラメータの無い形を指し、robotsの指定は「index,follow」だった。つまり、パラメータの付いた別のURLを、canonicalで1つにまとめている。ただし、canonicalは取得を止めない。Googleが実際に取りに来ているかは、ログで確かめていない。
一覧ページの末尾スラッシュは、同じ日に揃えた
確認した時点(2026年10月26日の朝)では、解説記事の一覧ページは、末尾にスラッシュの無い形も、ある形も、200で開き、canonicalは自分自身を指していた。同じ日の9時31分に、本番で、解説記事の一覧(/seo_article)、AI Ronのブログの一覧(/ai_ron)、ブログの一覧(/blog)の、スラッシュの無い形を、「?」以降を保ったまま、スラッシュ付きの形へ301で転送するようにした。
存在しないURLは404、記事の番号に文字を足したURLは、同じ日に301にした
一覧の9999ページ目と、大文字に変えた解説記事のURL(1本)は、404だった。一方、記事の番号のあとに余計な文字を足したURLは、404ではなかった。確認の時点では、200で開き、本文は番号だけのURLと同じで、canonicalは自分自身を指していた。05章の9番目を当サイトに当てたら、当たった。最初に404と書いたのは誤りだった。同じ日の9時53分に、本番で、番号のあとに余計な文字(例: 英字や「.html」)が付いたURLを、番号だけのURLへ301で転送するようにした。確かめたのは足した形の例だけである。
404ではなく301にしたのは、番号から元の記事が分かる形だったためである。元の記事が分かる形は、番号だけのURLへ寄せれば、同じ中身のURLが増えない。05章の9番目で確かめた結果は、404か、元のURLへの301なら、URLが増える形ではない。200で同じページが出るときが、URLが増える形である。
アンダースコアを含むURLは、サイトマップの398本
サイトマップの422本のうち、398本は、パスにアンダースコアを含む。2026年10月23日の更新履歴の項目は、ハイフンとアンダースコアの書き方の明確化だった。当サイトのURLは変えていない。変えるかは、この記事では決めない。
当サイトで確かめていないこと
- Googlebotが、パラメータ付きのURLを、実際にどれだけ取りに来ているか(ログとクロールの統計は、この記事の確認では見ていない)
- 当サイトの一覧に、絞り込みを重ねられる仕組みが、いくつあるか
- カレンダーやセッションIDが、当サイトのどこかに無いか(19本では見つからなかったが、全ページは調べていない)
08 このテーマは、ここまで
URLの形の話は、これまでにも書いてきた。
当サイトのURLの整合を、curl 3行で確かめた記事
サイトマップ・canonical・内部リンク・末尾スラッシュを、コマンドで揃えて確かめる手順は、Google が求める 4 層整合性 — sitemap・canonical・内部リンク・末尾スラッシュを curl 3 行で揃えるに書いた。
末尾スラッシュで、サイトマップのURLがGoogleから見えなかった日
sitemap に書いた URL が Google から見えていなかった日 — 末尾スラッシュの落とし穴と1分検証は、サイトマップに書いたURLが、末尾スラッシュの違いでGoogleから見えていなかった日の記録である。
リンクの確認は、3段目まである
「リンク切れ0本」も「200が返る」も、まだ2段目だった ── 番号が変わるサイトで見つけた、リンクの3段目のずれは、リンク切れが無いこと、200が返ること、の次に、飛び先が正しいかを確かめる3段目を書いた。相対リンクの確認(手順5)は、この3段目の入口になる。
2026年10月26日 — この記事の確認日
この記事の内容は、2026年10月26日に、公式のページ11本と、当サイトの公開URL19本を開いて確かめた時点のものである。新しい日付が出たときは、日付つきで追記する。
現在の貴方のIPアドレス
このサイトで書いている人