WEBサイト
Googleの番組は、PDFを内部でHTMLに変換して扱うと説明した ── PDFを載せている会社が、文字が取れるか・同じ中身の重複・置き場所を確かめる13項目(2026年10月時点)
Googleの番組は、PDFを内部でHTMLに変換して扱うと説明した ── PDFを載せている会社が、文字が取れるか・同じ中身の重複・置き場所を確かめる13項目(2026年10月時点)
目次
01 何が起きたか — Googleの番組が、PDFの扱いを内側から説明した
2026年10月13日に、PDFだけを取り上げる回が出た
Googleの検索の担当チームが配信する番組「Search Off the Record」に、2026年10月13日の日付で「PDFs in Search: Indexing, AI & Pitfalls」(訳: 検索の中のPDF。索引への登録、AI、落とし穴)という回が出た。番組の紹介ページには、話者としてMartin SplittとJohn Muellerの2人の名前がある。2026年10月16日に、紹介ページと、同じ回の書き起こし(PDFのファイルで配られている)を取り直して読んだ。
この回の主題は、PDFを載せている会社にとって、いちばん素朴な疑問である。PDFで出すか、ふつうのHTMLのページで出すか。そして、PDFはHTMLと違う扱いを受けるのか。紹介ページの冒頭は、こう問いかけている。
"Should you publish your content as a PDF or stick strictly to standard HTML?"
(訳: 内容をPDFで出すべきか、ふつうのHTMLだけにとどめるべきか。)
この記事は、番組で話された内容のうち、自分のサイトで今日確かめられることだけを拾う。聞いて面白い話と、手を動かせる話は別だからである。
PDFは、索引に入る前にHTMLの形へ直される
番組のいちばん大きな説明は、変換の部品の話である。書き起こしによると、Martin Splittは、検索の中に「converter」(変換する部品)があり、それは描画のすぐ後、索引に入る可能性があるすぐ前で働く、と話している。いくつもの形式にそれぞれ変換する部品があり、PDF用もその1つだという。その目的を、こう説明している。
"So we are taking that and producing an HTML version of it so that the processing in the rest of the pipeline pretty much only works with HTML."
(訳: だから私たちは、それを取って、HTMLの版を作る。以降の処理の流れが、ほぼHTMLだけで動くようにするためだ。)
つまり、Googleの中ではPDFが特別な道を通るのではなく、PDFをHTMLに直して、ふつうのウェブページと同じ道に乗せる。PDFの中のリンクがそのまま辿れるのも、同じ理由だと、John Muellerが確かめて、Martin Splittが同意している。
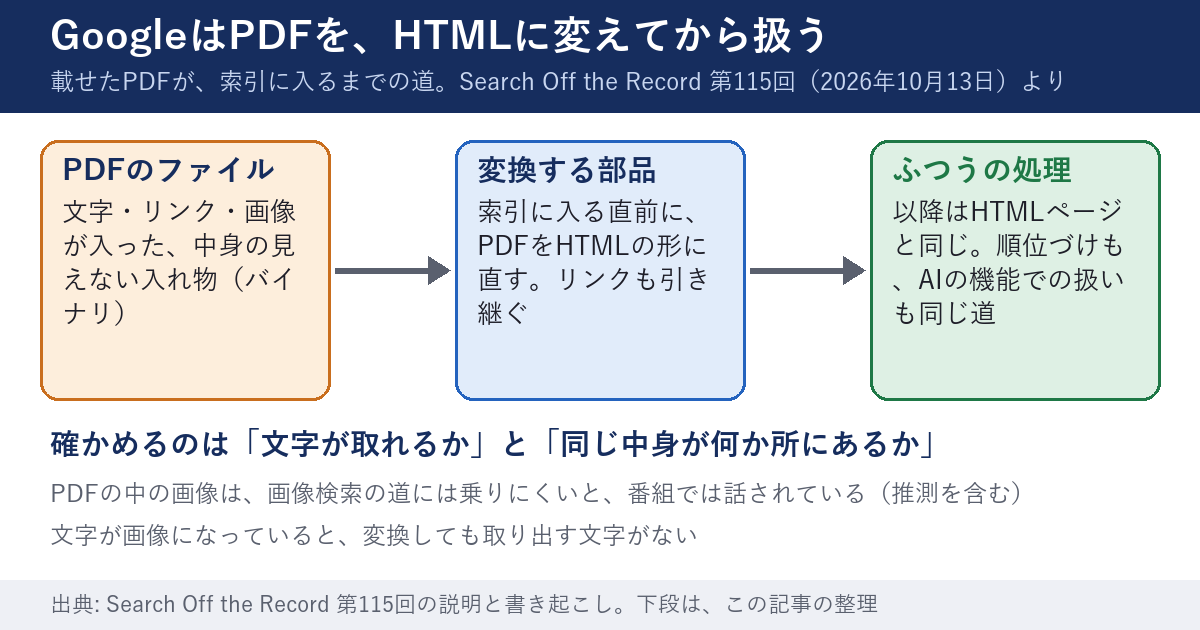
順位づけも、AIの機能も、通常の文書とほぼ同じ扱い
変換の後は、ふつうのページである。順位づけについて、Martin Splittはこう答えている。
"Yeah, indexing and ranking is pretty much the same as any other document."
(訳: そう、索引への登録も順位づけも、ほかの文書とほぼ同じだ。)
AIによる概要やAIモードに出るかを聞かれたときも、変換後は「ふつうのHTMLのページ」だから特別なことはない、という趣旨の答えをしている。書き起こしの終わり近くで、John Muellerは、少なくともGoogleでは、GEO(生成AIの検索への最適化)の面でもPDFは使える、ほかのAIの仕組みでも参照されているのを見たことがある、とも話している。ただし、これは本人の見聞であって、数字の裏づけはない。
この記事が読んだもの、読めなかったもの
読んだのは、番組の紹介ページ、書き起こし、Google検索セントラルの公式文書である。聞いていないのは、音声そのものである。書き起こしと紹介ページにある範囲だけを使う。また、番組の2人は「話の中身を、細部まで知っているわけではない」と、書き起こしの中で何度か断っている。公式の文書として確かめられたことと、番組での雑談を分けて書く。
02 なぜ・背景 — PDFは中身の見えない入れ物で、HTMLは最初から文字で書かれている
PDFはバイナリの入れ物である
HTMLやMarkdownは、テキストエディタで開けば、意味が追える文字で書かれている。PDFは違う。書き起こしでは、Martin Splittが、PDFをテキストエディタで開くと変な文字が並ぶこと、それは「binary container」(バイナリの入れ物)だからだと話している。本や論文のように、文字、リンク、画像、図が1つのファイルに入る。入れ物の中の文字を取り出せるかどうかが、PDFの確認の出発点になる。
Googleの公式文書は、PDFを索引に登録できる形式に挙げている
番組の話とは別に、公式の文書でも、PDFは対象に挙がっている。Google検索セントラルの「File Types Indexable by Google」(訳: Googleが索引に登録できるファイルの種類)は、2026年10月16日に開いたとき、最終更新が2026年2月3日だった。この文書は、形式を「Supported encoded file types」(訳: 対応する、符号化されたファイルの種類)の見出しの下に並べ、その中に次の1行がある。
"Adobe Portable Document Format (.pdf)"
(訳: Adobe Portable Document Format(.pdf))
同じ見出しの下には、WordやExcel、PowerPointの形式も並ぶ。PDFだけが特別に扱われているわけではない。登録できる形式の1つである。
ファイルの大きさの上限は、公式の数字が1つ、PDF専用の数字はない
大きなPDFで気になるのは、どこまで読まれるかである。Googleの「Google's crawlers and fetchers」の概要の文書(最終更新2026年6月12日)には、ファイルの大きさの上限の節があり、次のように書かれている。
"By default, Google's crawlers and fetchers only crawl the first 15MB of a file, and any content beyond this limit is ignored."
(訳: 既定では、Googleのクローラーと取得の仕組みは、ファイルの最初の15MBまでしか取り込まず、その上限を超えた内容は無視される。)
続く文は、個々のプロジェクトが、クローラーごと、ファイルの種類ごとに、別の上限を決めることがあると書いている。例として、Googlebotが2MBのような小さい上限を持つことも、PDFにはHTMLより大きな上限を指定することも、ありうると書く。PDF専用の数字は、この文書に書かれていない。
番組でも、Martin Splittは、PDFの取得の上限がHTMLと違うだろうとは推測しつつ、こう断っている。
"But I don't know the specific limit for PDF files."
(訳: ただし、PDFのファイルの具体的な上限は知らない。)
したがって、この記事は「PDFは何MBまで」という数字を書かない。大きなPDFは、上限に届かない大きさにするか、分けるか、HTMLにする、というのが安全側の考え方である。当サイトの記事「Googleのクロールは2MBで止まる ── 最新の公式解説と、自分のサイトで確認する13項目」は、HTMLの側の上限を扱っている。
HTMLのほうが向く場面は、画面の小さい端末で出る
書き起こしでは、2人が、HTMLの利点を具体的に挙げている。1つは、スマホではPDFを全部ダウンロードしてから表示するので、遅い回線や処理の遅い端末では、HTMLより待たされやすいこと。もう1つは、拡大したとき、PDFは印刷用のページの配置を保ったままで、文字が折り返されないことである。PDFが悪いのではなく、印刷された1枚の形を保つ道具だから、小さい画面と相性が悪い。
03 用語 — PDFの話で出てくる言葉を先にそろえる
変換する部品(converter)
用語
変換する部品(converter):PDFやWord、Excelなどの形式のファイルを、HTMLの形に直す、Googleの索引の仕組みの中の部品である。番組では、描画の後、索引に入る可能性がある前に働くと話されている。この部品があるので、PDFの文字やリンクが、HTMLのページと同じ処理に乗る。
画像だけのPDF(ラスタライズされたページ)
用語
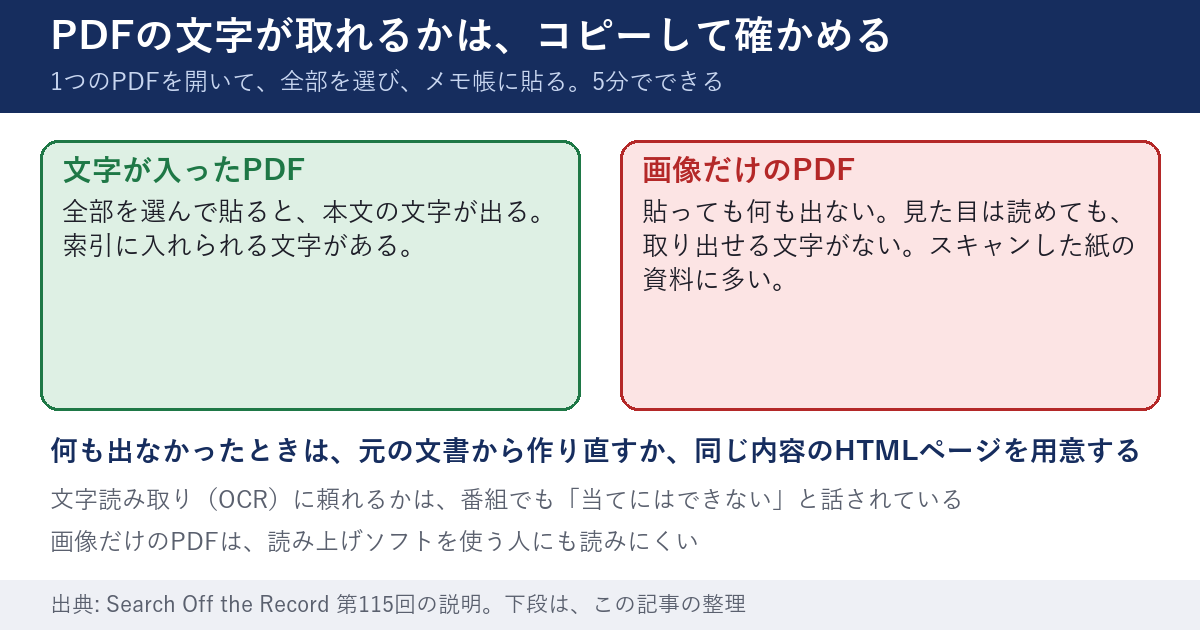
ラスタライズ(rasterized page):PDFのページが、文字ではなく、1枚の画像として入っている状態である。見た目は読めても、文字を選んでコピーできない。紙の資料をスキャンしたPDFに多い。取り出せる文字がないので、変換しても、索引に入れる本文がない。
rel="canonical"のHTTPヘッダー
用語
rel="canonical"のHTTPヘッダー:ページの中身ではなく、サーバーの応答の頭の部分(ヘッダー)に、正とするURLを書く方法である。HTMLの中に書くタグが使えないPDFのようなファイルで使う。応答に「Link: <正のURL>; rel="canonical"」の形の1行を付ける。
この形式について、Googleの文書は「RFC5988」を挙げている。現在の規格は、その後継のRFC 8288「Web Linking」である。
X-Robots-Tag
用語
X-Robots-Tag:検索結果に出す・出さないなどの指示を、サーバーの応答のヘッダーに書く方法である。HTMLの中のmetaタグが書けない、PDFや画像のようなファイルに使う。「noindex」を書けば、そのファイルを検索結果に載せないよう頼める。
「検索に出さない」と「読ませない」は別の話
PDFの話で混ざりやすいのが、この2つである。robots.txtは、クローラーが取りに来るのを止める仕組みである。noindexは、取りに来た後で、検索結果に載せないよう頼む仕組みである。当サイトの記事「noindex・nofollow・robots.txtは、それぞれ何を止めているのか ── 混同しやすい3つの設定を確認する15項目」が、3つの設定の違いを整理している。06章でも、PDFの場合に何が起きるかを書く。
04 型別 — 自社がどの型に当たるかで、最初に確かめる場所が変わる
PDFを載せている会社と言っても、置き方は様々である。次の4つの型に分けると、確認の最初の一手が決まる。
| 型 | よくある例 | 最初に確かめること |
|---|---|---|
| 型A 配布する資料 | カタログ、料金表、申込書、会社案内 | 文字がコピーできるか。同じ内容のHTMLのページがあるか |
| 型B 紙のスキャン | 古い資料、お知らせの紙、店のメニュー | 画像だけのPDFになっていないか |
| 型C 同じ内容の複数形式 | HTMLの記事と、そのPDF版を両方出している | どちらを正とするかを、示せているか |
| 型D 自動で作るPDF | CMSの「PDFで見る」「印刷用」の機能 | 古い版が検索に残り、新しいページと競合していないか |
型A — カタログ・料金表・申込書を配るサイト
番組では、細かな体裁が必要なもの、紙に刷って使うもの、フォームのように操作が要るものは、PDFで出す理由があるという話が出ている。Martin Splittは、宿泊施設が宿泊の申込書をPDFで出す例を挙げ、役に立つなら、そのままPDFで出してよいと話している。型Aで確かめるのは、PDFを出す理由があるかと、そのPDFの文字が取れるかである。理由があれば、無理にHTMLにしなくてよい。
型B — 紙をスキャンして載せているサイト
この型が、いちばん危ない。John Muellerは書き起こしの中で、スキャンした本のPDFは本質的に画像で、文字読み取り(OCR)ができるシステムもあるが、当てにはできない、と話している。見た目では区別がつかないので、コピーして確かめるしかない。飲食店のメニューについては、番組の最後に、実際的な答えが出ている。
"If the option is have a menu as a PDF or don't have a menu at all, then yes, I would prefer to have a menu."
(訳: 選べるのが、メニューをPDFで出すか、メニューをまったく出さないかなら、メニューを出すほうがよい。)
続けてJohn Muellerは、ふつうのウェブページとPDFを選べるなら、ふつうのページのほうが操作しやすく、拡大もしやすく、スマホで折り返され、少し速く表示される、とも話している。小さな店の手間を考えて、PDFのままにする選択も認めている。画像だけのPDFは読み上げソフトを使う人にも読みにくいが、PDFの中の画像に代替テキストを付ける方法は、W3Cの技術文書「PDF1」にある。
型C — HTMLとPDFの両方を出しているサイト
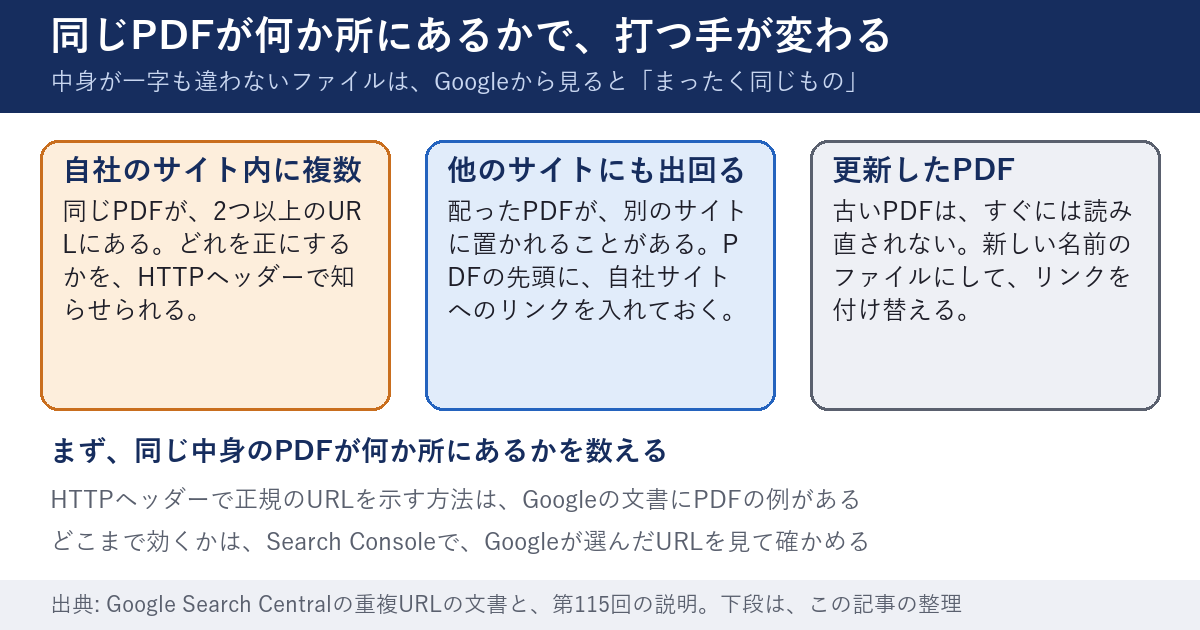
同じ内容が2つのURLにある。どちらを検索に出したいかは、サイトが決める。Googleの重複URLの文書は、PDFやWordのように複数の形式でそれぞれ別のURLに出している場合に、正のURLをHTTPヘッダーで知らせられると書いている(06章で引用する)。型Cは、示せているかを確かめる。
型D — CMSがPDFを自動で作るサイト
書き起こしでは、John Muellerが、昔のCMSにあったと、「ページをPDFで見る」ボタンの話をしている。ページを印刷用に自動でPDFにする機能で、Googleはこの手のPDFをあまり頻繁に取り直さないので、古い内容がPDFとして残り、新しい内容がHTMLのページとして出る、食い違った状態になりうるという。型Dで確かめるのは、そのPDFが検索に出る状態になっていないかである。
確かめる順番
どの型でも、順番は同じである。まず、自社のPDFを全部数える。次に、型に分ける。そのうえで、文字が取れるか、同じ中身が何か所にあるか、置き場所と更新の仕方、の順に見る。数える前に直し始めると、直す対象を取りこぼす。
05 自分のサイトで確認するチェックリスト
下の13項目は、1項目5分ほどでできる作業である。チェックの状態はブラウザの中にだけ保存され、サーバーには送られない。
- 自社サイトにあるPDFを、サイトマップ、サイト内検索、検索で「site:自社ドメイン filetype:pdf」を使って探し、URLを1本ずつ書き出して数える
- 項目1のPDFを、型A(配布する資料)、型B(紙のスキャン)、型C(同じ内容の複数形式)、型D(自動で作るPDF)のどれかに分けて、型ごとの本数を書く
- 項目1のうち閲覧数が多い上位5本を開き、全部を選んでテキストエディタに貼り、文字が出たか、出なかったかを、1本ずつ書く
- 項目3で文字が出なかったPDFについて、元のWordや印刷用データが手元にあるかを、「ある」「ない」で書く
- 項目3の5本それぞれに、同じ内容のHTMLのページがあるかを探し、あれば、そのURLを書く
- PDFの置き場所のURLを3本開き、ファイルの名前に日付や版が入っているか、更新のとき名前を変える決まりがあるかを書く
- PDFのプロパティを3本開き、作成者と説明の欄が空でないかを書く
- PDFの1ページ目の上のほうに、自社のサイトの名前やURLが書かれ、リンクとして押せるかを、3本で確かめる
- HTMLとPDFで同じ内容を出しているものがあれば、検索の「URL検査」で、Googleが選んだ正規のURLがどちらかを書く
- 同じPDFが、サイト内の複数のURLに置かれていないかを、ファイル名の一覧を並べて確かめる
- PDFのURLを3本、ブラウザの開発者ツールのネットワークの画面で開き、応答のヘッダーにLinkやX-Robots-Tagが付いているかを書く
- 検索に出したくないPDFがあれば、robots.txtで止めているのか、noindexを付けているのかを、1本ずつ書く(robots.txtで止めているだけなら、その旨を書く)
- 項目1から12の結果から、「文字が取れない」「同じ中身が重複」「置き場所が不明」のどれが多いかを選び、日付を付けて1枚にまとめて保存する
時間が限られているときは、項目1・3・5・12の4つだけでも、PDFが検索に役立つ状態かの見当は付く。
06 代替・他の選択肢 — PDFの置き方を選ぶ
選択肢は5つある
PDFの置き方は、HTMLと比べて、次の5つに分けられる。どれが正しいではなく、サイトの事情で選ぶ。
| 置き方 | 向く場面 | 注意すること |
|---|---|---|
| PDFだけを置く | 申込書、印刷して使う資料 | 文字が取れるか。更新の手間 |
| HTMLだけを置く | 読ませたい記事、手順、料金の説明 | 印刷用の体裁が必要なら、別に用意する |
| HTMLとPDFの両方 | 読むページと、配る資料を分けたいとき | どちらを正とするかを示す |
| PDFにnoindexを付ける | 配布はするが、検索には出したくないとき | robots.txtで止めると、noindexが読まれない |
| PDFをrobots.txtで止める | 取りに来る回数を減らしたいとき | 隠す手段ではない(下で引用する) |
HTMLとPDFを両方出すなら、正のURLをヘッダーで示せる
Google検索セントラルの「Consolidate duplicate URLs」(訳: 重複したURLをまとめる)の文書は、2026年10月16日に開いたとき、最終更新が2026年7月10日だった。HTMLの中に書くタグが使えないPDFのようなファイルについて、こう書いている。
"If you publish content in many file formats, such as PDF or Microsoft Word, each on their own URL, you can return a rel="canonical" HTTP header to tell Googlebot what is the canonical URL for the non-HTML files."
(訳: PDFやMicrosoft Wordのように、内容を多くのファイル形式で、それぞれ別のURLに出しているなら、HTML以外のファイルの正のURLを、Googlebotに伝えるために、rel="canonical"のHTTPヘッダーを返せる。)
文書には、WordのファイルのヘッダーにPDFのURLを指す「Link」の行を付ける例も載っている。番組では、John Muellerが、このヘッダーは面倒なので使う人は多くないだろうが、できると話している。当サイトの記事「canonicalタグは『ヒント』であって『命令』ではない ── Search Consoleで、Googleが選んだ正規URLを自分のサイトで確認する15項目(2026年9月時点)」は、canonicalが「ヒント」であって命令ではないことを扱っている。ヘッダーで示しても、Googleが従うとは限らない。
PDFの先頭に、自社サイトへのリンクを入れる
番組で出た、もう1つの手がかりがある。同じ中身のPDFが、別のサイトに置かれたとき、検索はそれを「まったく同じもの」と見る、とJohn Muellerは説明している。そこで、PDFの上のほうに自社のトップページへのリンクを入れておく。PDFをHTMLに変えるとき、リンクもそのまま残る。人がそこから辿れるし、索引に入った形でも、元のサイトへのリンクが付いてくる。
PDFを更新するときは、新しいファイル名にする
PDFはHTMLより、何度も取り直されにくい。John Muellerは、画像に似ていて、頻繁には変わらないと見られているので、数分おきには取り直されないと話している。そのうえで、こう勧めている。
"That also means that if you do want to make changes to a PDF file, it can make sense to just use a new file name."
(訳: それはつまり、PDFのファイルに変更を加えたいなら、新しいファイル名にするのが筋が通る、ということでもある。)
Martin Splittは、サーバーの設定を触れる人には、変わる頻度に合わせて、HTTPのキャッシュの設定をすることも勧めている。Googleの概要の文書も、Cache-Controlのmax-ageに、内容が変わらないと見込む秒数を入れておくと、再取得の目安になると書く。HTTPのキャッシュの規格はRFC 9111である。四半期ごとに変わるカタログなら、数か月分を指定する考え方である。
検索に出したくないPDFには、noindexか、パスワードか
検索に出したくないPDFの扱いは、Googleの文書で確かめられる。robots metaタグの文書(最終更新2026年3月24日)は、こう書く。
"To block indexing of non-HTML resources, such as PDF files, video files, or image files, use the X-Robots-Tag response header instead."
(訳: PDF、動画、画像のようなHTML以外のものの索引への登録を止めるには、代わりにX-Robots-Tagの応答ヘッダーを使う。)
番組でMartin Splittは、PDFにパスワードを付ければ検索には読めない、robots.txtで止める手もある、と話している。ここに、注意が要る。Googleのrobots.txtの導入の文書(最終更新2025年12月10日)は、はっきり書いている。
注意
"Don't use a robots.txt file as a means to hide your web pages (including PDFs and other text-based formats supported by Google) from Google Search results."(訳: ウェブページ(PDFやGoogleが対応するほかの文字ベースの形式を含む)を、Google検索の結果から隠す手段として、robots.txtを使ってはならない。)
さらに、「Block Search Indexing with noindex」(最終更新2025年12月10日)は、noindexが効くには、そのページやファイルがrobots.txtで止められておらず、クローラーが読める状態でなければならないと書く。止めたつもりのPDFが、止めているせいでnoindexを読まれず、リンク経由で検索に出るという順序になりうる。
llms.txtをPDFにするのは、番組では勧められなかった
この回の最初の話題は、llms.txtをPDFで保存することだった。書き起こしでは、Martin Splittが、まず「なぜこの話が出続けるのか」と返し、そのうえで答えは「No」だと話す。llms.txtの狙いは、LLMが読みやすい最も単純な形で内容を出すことだ、PDFは単純な形ではない、というのが理由である。当サイトの記事「llms.txt に 59 本 積んでいた ── ただし『読まなくていい』と書いてある棚に」や、「llms.txt を置いて51日、正直に答え合わせ第2弾 ── Google が『効かない』と言った以上に、他の AI も読みに来ていなかった」で、llms.txtを実際に置いて測った結果を書いている。
07 当サイトで確かめたこと
当サイトのPDFを数えた
当サイトにPDFがあるかを、数えた。2026年10月16日に、サイトマップに載っている382件のURLを、1本ずつ開き、ページの中の「.pdf」で終わるリンクを数えた。
| 数えたもの | 件数 |
|---|---|
| サイトマップのURL | 382 |
| うち「.pdf」のURL | 0 |
| PDFへのリンクを含むページ | 15 |
| PDFへのリンクの合計 | 30 |
| うち当サイトの中のPDF | 0 |
30本のリンクは、すべて外部のサイトのPDFを指していた。Googleの資料、官公庁の文書、ICANNやOWASPなどの団体の文書、今回の番組の書き起こしなどである。当サイトが置いているPDFは、見つけた範囲では0本だった。ただし、これは、サイトマップのURLと、そのページの中のリンクを見ただけである。サイトマップに載らないページや、ログインしないと見えない会員画面、入力しないと出ない画面までは、開いていない。開いたときの応答の番号も、記録していない。
言えるのは、公開されている範囲の入口から辿れるPDFは、外へのリンクだけだったということである。項目1の、サイトマップと検索で自社のPDFを数える作業は、当サイトでは、これで終わった。リンクの確認を段階に分けて見る話は、当サイトの記事「「リンク切れ0本」も「200が返る」も、まだ2段目だった ── 番号が変わるサイトで見つけた、リンクの3段目のずれ」にある。
公式の書き起こしは、PDFで配られていた
この回の書き起こしは、PDFのファイルである。9ページあった。文字を取り出す道具で試すと、文字は取れた。ただし、PDFの中の語が、1語ずつ別々の行になって出てきた。取れることと、読める形で取れることは別だった。この点は、ブラウザのコピーでも、使う道具でも違うので、自分のPDFで試すしかない。
この回は、PDFの文字が取れるかをコピーで確かめる方法を、そのまま勧めている。5分で試せて、費用はかからない。当サイトの🔧 WEBサイト内のリンク漏れ・チェックツールは、サイト内のリンクの切れを確かめる道具である。サイトマップの載せ方を見直すなら、🔧 WEBサイトのsitemap.xml作成ツールも使える。
Search Consoleで、PDFのURLを検査できる
Googleが選んだ正のURLを確かめるのは、Search ConsoleのURL検査である。Search Consoleから書き出したデータを詳しく見たいときは、当サイトの🔧 Search Consoleのエクスポートを読み込んで詳しく見るツールが使える。当サイトの記事「canonicalタグは『ヒント』であって『命令』ではない ── Search Consoleで、Googleが選んだ正規URLを自分のサイトで確認する15項目(2026年9月時点)」の15項目も、PDFのURLにそのまま使える。
08 このテーマの、これまで
日付つきの記録
- 2025年12月10日: Googleのrobots.txtの導入の文書と、noindexの文書の最終更新。robots.txtはPDFを検索から隠す手段ではない、と書かれている。
- 2026年2月3日: 「File Types Indexable by Google」の最終更新。PDFは、対応する符号化された形式に挙がっている。
- 2026年3月24日: robots metaタグとX-Robots-Tagの文書の最終更新。HTML以外のものにはX-Robots-Tagを使う、と書かれている。
- 2026年6月12日: Googleのクローラーの概要の文書の最終更新。既定の15MBと、ファイルの種類ごとに上限が変わりうることが書かれている。
- 2026年7月10日: 重複URLの文書の最終更新。PDFのような形式の正のURLを、HTTPヘッダーで示す方法が書かれている。
- 2026年10月13日: Search Off the Recordが、PDFを扱う回を公開した。
- 2026年10月16日: この記事の確認の日。
番組のPDFの扱いが、いつからそうなっているかは、番組では語られていない。この記事で読んだ6つの公式文書の中には、「PDFを変換してHTMLにする」という書き方は、見つからなかった。この話は、番組での説明という位置づけで読む。
当サイトの、関連する過去の記事
同じ「数えてから直す」の考え方を、当サイトはこれまでも書いてきた。当サイトの記事「「自分のサイトに、同じ記事が2本ないか」を5分で確かめる ── タイトルで探すと45組、元記事で探すと139組。3倍 違った」は、同じ内容の記事を探す方法を書いている。PDFの重複を探すときも、見つける手順は似ている。当サイトの記事「外から取った画面は、目当ての画面とは限らない ── 遮断の画面を404と読み、引用符の違いでnoindexを「無い」と読みかけた」は、外から取った画面が目当てのものか確かめる話で、PDFのURLをブラウザで開いて確かめるときの注意に通じる。
当サイトの記事「AIクローラーは1つではない ── robots.txt・llms.txtで「通す」「止める」を切り分ける(2026年9月時点)」と「robots meta タグ・X-Robots-Tagのディレクティブ ── nosnippet・max-snippetなど12種類を確認する14項目(2026年9月時点)」は、robots.txtやX-Robots-Tagなどの指示の違いを扱っている。当サイトの記事「AIは331回来たと書いた。実際は11,024回だった ── HTTPのログだけを52日間 見ていた」は、自社のログを、見落としのない範囲で数える話である。PDFへのアクセスを数えるときにも、アクセスの記録の見方は同じである。
現在の貴方のIPアドレス
このサイトで書いている人