WEBサイト
Googleの「役に立つコンテンツ」のページに、著者情報の偽装を戒める文がある。戒められているのは、AIで書くことではなく、作り物の著者を載せること ── 自社の著者表記が実在と一致しているかを確かめる13項目(2026年10月時点)
Googleの「役に立つコンテンツ」のページに、著者情報の偽装を戒める文がある。戒められているのは、AIで書くことではなく、作り物の著者を載せること ── 自社の著者表記が実在と一致しているかを確かめる13項目(2026年10月時点)
目次
01 何が起きたか — 2026年10月5日更新のページに、著者情報の偽装を戒める文がある
「役に立つコンテンツ」のページの、Whoの節
Google検索セントラルの「Creating helpful, reliable, people-first content」(訳: 役に立ち、信頼でき、人を第一にしたコンテンツを作る)というページを、2026年10月11日に開いた。末尾の最終更新は「2026-10-05 UTC」である。ページの中の「Who (created the content)」(訳: 誰がコンテンツを作ったか)の節に、著者の情報についての文が並んでいる。まず、署名を付けることを勧める文がある。
"We strongly encourage adding accurate authorship information, such as bylines to content where readers might expect it."
(訳: 読む人が期待しそうな内容には、署名などの、正確な著者の情報を加えることを、強く勧める。)
この文のすぐあとに、偽装を戒める文が続く。
"However, avoid using deceptive authorship information."
(訳: ただし、人をあざむく著者の情報を使うことは避けること。)
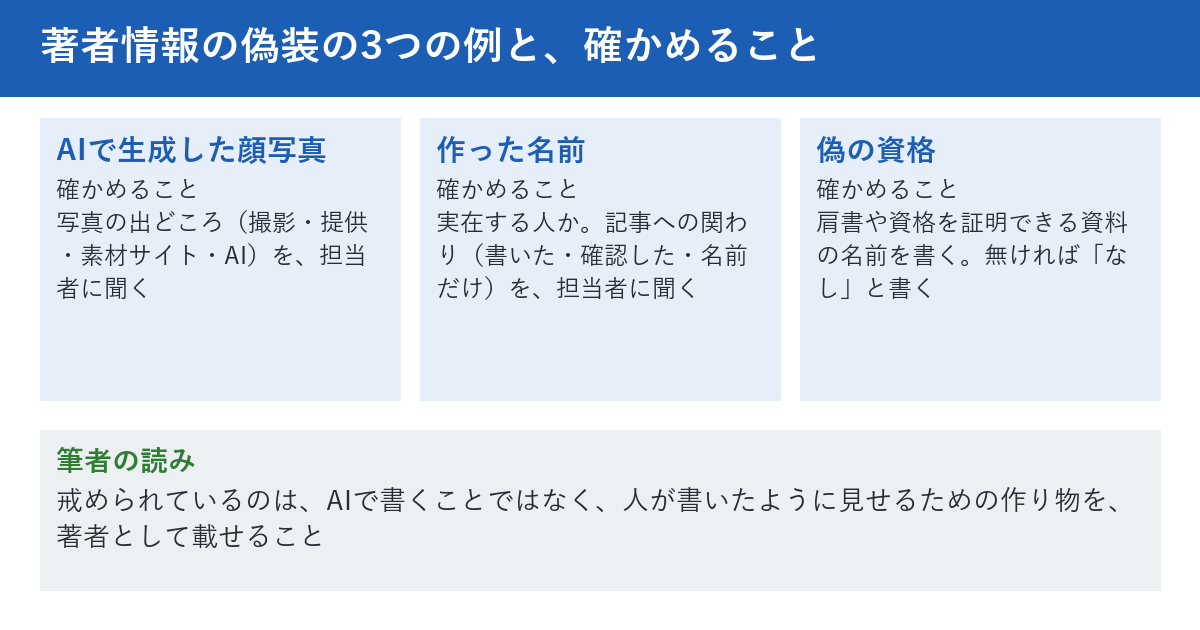
"Fabricating creator profiles (such as by using AI-generated headshots, made-up names, or false credentials to make content appear as if it was written by human experts) is a form of deception."
(訳: 作り手のプロフィールをでっち上げること(たとえば、内容が人間の専門家に書かれたように見せるために、AIで生成した顔写真、作った名前、偽の資格を使うこと)は、あざむきの一種である。)
あざむきの結果として書かれていること
続く文は、あざむきを見つけられたページの扱いを、利用者と自動の仕組みの両方について書いている。
"Any form of deception makes a page untrustworthy to both users and our automated quality systems, and is a signal of a low-quality page."
(訳: どんな形のあざむきも、利用者にとっても、Googleの自動の品質の仕組みにとっても、そのページを信頼できないものにし、質の低いページのしるしになる。)
この文が「いつ足されたか」は、確かめられなかった
2026年10月5日更新のページに、この文がある、というところまでは確かめた。文が10月5日に追加されたかどうかは、確かめていない。文書の更新履歴(最終更新2026年10月8日 UTC)を開くと、10月の項目は、8日のUGC Fresh Data Programの追加と、1日の「生成AIのコンテンツの指針」の更新だけで、10月5日の項目は無かった。この記事は、「いつ加わったか」ではなく、「いまページにある文を、自社に当てる」ことを扱う。
この記事の問いと、先に書く答え
問いは1つで、自社の記事の著者の表記は、実在と一致しているかである。偽装の例に挙がった3つ(AIで作った顔写真・作った名前・偽の資格)を、05章の13項目で、自社の記事に1つずつ当てる。先に答えを書くと、文が戒めているのは、AIで書くことではなく、人が書いたように見せるための作り物を、著者として載せることだと読める。この読み方は、次の章で、別の公式文書と照らす。
出典
ページの末尾には「Last updated 2026-10-05 UTC.」(訳: 最終更新 2026年10月5日 UTC)とある。この章で引用した4つの文は、この日付のページから、取り直して書き写した。
02 なぜ・背景 — 「誰が書いたか」は、Googleが勧める3つの問いの、最初の1つ
Who・How・Whyの、3つの問い
同じページは、コンテンツを見直す方法として、「Who(誰が作ったか)」「How(どう作ったか)」「Why(なぜ作ったか)」の3つを挙げている。Whoの節には、確かめる問いが並ぶ。
"Is it self-evident to your visitors who authored your content? Do pages carry a byline, where one might be expected?"
(訳: 訪れた人に、誰がコンテンツを書いたかが、自明か。署名があって当然のところに、ページは署名を載せているか。)
偽装を戒める文は、この問いの延長にある。署名を載せることを勧めたうえで、載せるなら正確に、という順番である。
Howの節は、AIの関わりの説明を勧めている
Howの節は、AIや自動化で内容を作った場合の問いを、次のように書いている。
"Is the use of automation, including AI-generation, self-evident to visitors through disclosures or in other ways?"
(訳: AIによる生成を含む自動化を使ったことが、訪れた人に、説明などの形で、自明になっているか。)
Whoの節の「人が書いたように見せる」偽装と、Howの節の「AIの関わりを説明する」は、正直に書くという同じ向きの話である。
AIで書くこと自体は、禁止ではない
Googleは、生成AIの文書で、使い方の位置づけを次のように書いている。
"Generative AI can be particularly useful when researching a topic, and to add structure to original content."
(訳: 生成AIは、ある話題を調べるときや、独自の内容に構成を加えるときに、特に役立ちうる。)
2023年のGoogle検索セントラルのブログ記事は、よくある質問に答える形で、さらにはっきり書いている。
"Appropriate use of AI or automation is not against our guidelines."
(訳: AIや自動化を適切に使うことは、Googleのガイドラインに反しない。)
ただし、条件がある。検索順位を操作することが主な目的の使い方は、スパムの方針に反する、と同じ記事は書く。「AIを使った」ことが問題になるのではなく、「どう使い、どう見せたか」が問われる、と読める。
03 用語 — 署名・著者・構造化データの「author」を、先に分けておく
署名(byline)と著者ページ
署名は、記事の画面に出る、書いた人の名前の表記である。公式のページは、署名から、著者の背景を伝えるページにつながっているか、を問いにしている。この記事では、署名の先にある、著者を紹介するページを著者ページと呼ぶ。
構造化データのauthorは、Personか、Organization
構造化データのauthorは、記事の著者を、機械に伝える項目である。schema.orgは、この項目に入れられる型を、OrganizationかPersonの2つと書いている。Googleの記事の構造化データの文書は、使い分けを、次のように書く。
"Use the Person type for people, and the Organization type for organizations."
(訳: 人にはPersonの型を、組織にはOrganizationの型を使うこと。)
構造化データは、画面に見えることと合わせる
構造化データの一般的なガイドラインは、画面との対応を、次のように書いている。
"Don't mark up content that is not visible to readers of the page."
(訳: ページを読む人に見えない内容を、マークアップしないこと。)
同じ文の続きに「JSON-LDが演奏者を書いているなら、HTMLの本文も、その同じ演奏者について書いていなければならない」という例がある。著者に当てはめると、構造化データに書いた著者が、画面にも見えていることが、望ましい形になる。
用語
E-E-A-Tは、経験・専門性・権威性・信頼性の頭文字である。同じページは、このうち信頼が最も重要で、ほかはそれに寄与する、と書いている。署名や著者ページは、「この人が書いた」と伝える手がかりで、信頼に関わる。
04 型別 — 偽装の3つの例を、自社の記事で1つずつ確かめる
🅰 適用範囲 — 署名や著者の紹介を出しているサイトが対象
署名も著者の紹介も出していないサイトは、この文の「偽装」には当たりにくい。ただし、公式のページは、署名を読む人が期待する場所には付けるよう勧めている。出していないサイトも、「出さない」と決めた理由を、05章の項目2で書き出せる。
| 公式の例 | 自社で確かめること | 確かめ方 |
|---|---|---|
| AIで生成した顔写真 | 著者として載せている顔写真が、実在する本人のものか | 写真の出どころ(撮影・提供・素材サイト・AI)を担当者に聞く |
| 作った名前 | 署名の名前が、実在する人か。記事に実際に関わったか | 担当者に聞く。関わりを「書いた」「確認した」「名前だけ」に分ける |
| 偽の資格 | 肩書や資格が、証明できるか | 認定証・所属先の名簿など、証明できる資料の名前を書く |
3つとも、公式の文の例(such as)であり、ほかの形が当てはまらない、とは書かれていない。表の3行は、文に挙がった例を、確かめる作業に置き換えた筆者の整理である。
🅱 この記事が確かめていないこと
注意
この記事は、Googleがどう偽装を見つけ、どう判定するかを確かめていない。公式のページにも、判定の方法は書かれていない。画像がAIで作られたかを機械で見分ける精度も、確かめていない。ペンネームの可否にも、公式の文は触れていない。公式の文が書くのは、「人間の専門家が書いたように見せるための、作った名前」である。
🅲 手順1 — 著者名が出る場所を、洗い出す
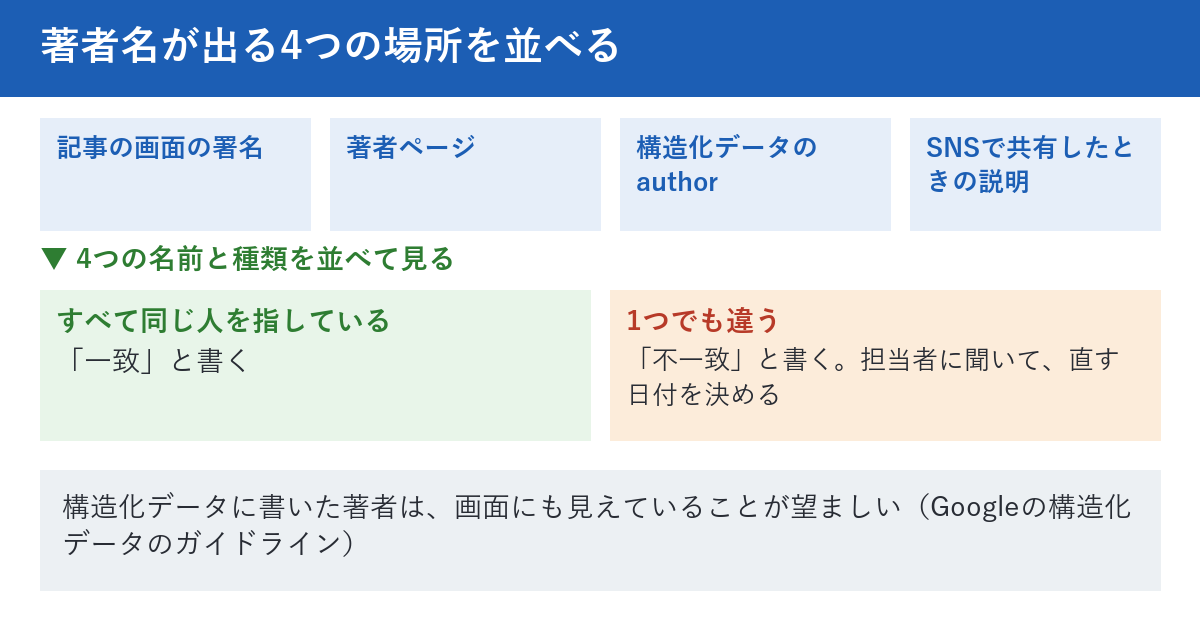
著者の名前は、記事の署名のほかにも出る。著者ページ、構造化データのauthor、SNSで共有したときの説明、メールマガジンの署名などである。場所ごとに名前の表記が違っていないかを見る前に、まず、出る場所を全部書き出す。
🅲 手順2 — 顔写真の出どころを聞く
著者の顔写真が出ている記事を、3本数える。写真の出どころは、本人が撮影・提供したもの、素材サイトのもの、AIで生成したもの、のどれかに分けて、担当者に聞く。「分からない」と返ってきた写真は、確かめ終わるまで、著者の顔として載せるのを止める選択肢がある。
🅲 手順3 — 名前が実在するかと、関わりを聞く
署名の名前ごとに、実在するか、記事にどう関わったかを聞く。関わりは、「その人が書いた」「その人が確認した」「名前を借りただけ」の3つに分けると、答えが揃う。「名前を借りただけ」が1本でもあれば、公式の文の「作った名前」に近づく。
🅲 手順4 — 肩書や資格を、資料で裏づける
記事や著者の紹介に書いた肩書・資格(「◯◯協会認定」「◯年の経験」など)を、3つ書き出す。それぞれ、証明できる資料の名前を書く。資料が無いものは、「なし」と書く。「なし」のものを、そのまま載せ続けるかを、決める日付を書いておく。
🅲 手順5 — 構造化データのauthorを、画面の署名と並べる
記事のHTMLを開いて、authorの語を探す。種類(PersonかOrganization)と、名前を書き写す。Googleの記事の構造化データの文書は、名前の欄に入れるものを、次のように限っている。
"In the author.name property, only specify the name of the author. Don't add any other piece of information."
(訳: author.nameの項目には、著者の名前だけを書くこと。ほかの情報を加えないこと。)
同じ文書は、画面に出ている著者を、構造化データに全員書くことも求めている。
"Make sure that all the authors that are presented as authors on the web page are also included in markup."
(訳: ウェブページに著者として示されている人が、全員、マークアップにも含まれているようにすること。)
実務のヒント
ブラウザで記事を開いて「ページのソースを表示」を選び、検索欄にauthorと入れると、構造化データの著者の部分に飛べる。種類と名前だけを書き写すと、5分で終わる。
書き写した名前と、画面の署名を並べて、一致か、不一致かを書く。Googleの文書は、構造化データの検査にRich Results Testを使うよう書いている。アドレスを入れると、読み取られた構造化データを確かめられる。
🅲 手順6 — 構造化データから、著者を紹介するページへ道をつなぐ
著者の名前だけでは、同じ名前の別人と区別できない。Googleの記事の構造化データの文書は、author.urlの役割を、次のように書いている。
"A link to a web page that uniquely identifies the author of the article."
(訳: その記事の著者を、ほかと区別して特定するウェブページへのリンク。)
例として挙がるのは、著者のSNSのページ、「私について」のページ、経歴のページである。代わりにsameAsを使ってもよく、Googleは、著者を見分けるときに、sameAsとurlの両方を読める、と書いている。つなぎ先が、実在する本人のページかを、項目9で一緒に見る。つなぎ先が自社内の著者ページなら、そのページには、プロフィールページ(ProfilePage)の構造化データを付けることを、Googleの文書は勧めている。ProfilePageの文書も、記事の著者から、そのページにつながることがある、と書いている。
🅲 手順7 — AIを使った記事に、説明があるかを見る
AIを使って作った記事が自社にあるなら、その記事に、AIが関わったことが分かる説明があるかを、3本で見る。2023年のGoogleのブログ記事は、署名の欄にAIを書くことについて、次のように書いている。
"Giving AI an author byline is probably not the best way to follow our recommendation to make clear to readers when AI is part of the content creation process."
(訳: AIに著者の署名を付けることは、AIがコンテンツを作る工程の一部であると読む人に分かりやすく示す、というGoogleの勧めに従う方法としては、おそらく最善ではない。)
つまり、著者の署名の欄とは別に、AIの関わりの説明を置く形が、文脈に合う。
🅲 手順8 — 外注のライターがいるなら、名前と実際の関わりを対応づける
外注のライターに書いてもらった記事は、署名の名前と、実際に書いた人、確認した人が、一致しているかを、一覧にする。公式の文は、外注そのものには触れていない。署名に出す名前を、実際に責任を持つ人にすることは、筆者の整理である。
05 自分のサイトで確認するチェックリスト
下の13項目は、1項目5分ほどでできる作業である。著者を出していないサイトは、項目1・2だけでも、「出さないと決めた理由」を残せる。AIを使った記事があるなら、項目12も、ほかの項目の結果を待たずにできる。チェックの状態は、ブラウザの中にだけ保存され、サーバーには送られない。
- 公式の「Creating helpful, reliable, people-first content」を開き、末尾の「Last updated」の日付(2026-10-05 UTC)と、Whoの節に挙がった偽装の3つの例(AIで生成した顔写真・作った名前・偽の資格)を、メモに書き写す
- 自社の著者名が出る場所を、「記事の署名」「著者ページ」「構造化データ」「SNSで共有したときの説明」「メールの署名」から、該当するものすべてに丸を付けて書き出す(署名を出していないなら「出していない」と、その理由を書く)
- 直近の公開記事を3本開き、署名に出ている著者名を書き写し、「3本中◯本が同じ名前」の形で書く
- 項目3の著者名ごとに、その人が実在するかを担当者に聞き、「実在」「確認中」「不明」のどれかで書く
- 項目3の著者名ごとに、記事への関わりを「書いた」「確認した」「名前だけ」のどれかで書く
- 著者の顔写真が出ている記事を3本数え、写真の出どころ(本人が撮影・提供、素材サイト、AIで生成、不明)を担当者に聞いて書く
- 項目6で「AIで生成」か「不明」の写真が出てきたら、その写真を使っている記事の本数を数え、差し替えるかを決める日付を書く
- 著者の肩書・資格を、記事から3つ書き出し、それぞれ証明できる資料の名前を書く(資料が無いものは「なし」と書く)
- 記事のHTMLを開いて「author」の語を探し、構造化データのauthorの種類(PersonかOrganization)と名前、urlかsameAsがあるかを書く
- 項目9の名前と、項目3の署名を並べ、「一致」か「不一致」かを書く
- 構造化データのauthor.nameに、肩書や「posted by」など、名前以外の語が混ざっていないかを見て、「あり」か「なし」で書く
- AIを使って作った記事を3本選び、AIの関わりが分かる説明が画面にあるかを、「3本中◯本」の形で書く(AIを使った記事が無ければ「なし」と書く)
- 項目4・5・6・8・10・12の結果から、直す必要があるものを3つまで選び、担当者の名前と、直す日付を書く
06 代替・他の選択肢 — 個人の署名のほかに、取れる形がある
組織の名前で署名する
構造化データのauthorには、Organizationも入れられる(schema.orgと、Googleの記事の構造化データの文書)。個人の署名を出せない事情があるサイトは、組織の名前で、正直に署名する選択肢がある。Googleの組織の構造化データの文書は、トップページに組織の情報を足すと、組織の詳細を、検索結果の中でほかの組織と区別しやすくなる、と書いている。書いた人を名乗らないことと、作った人を名乗ることは、別の話である。
書いた人と、確認した人を、分けて書く
AIに下書きを任せ、人が確認して公開する形なら、「AIが書き、◯◯が確認した」と、役割ごとに書く形がある。これは公式の文が挙げた形ではなく、手順6の公式の文脈から導いた筆者の整理である。確認した人は、実在し、実際に確認した人でなければならない。
署名を出さずに、記事の中で「どう作ったか」を書く
署名を出さない記事は、公式のページが言う「Howの節」を、記事の中に書く手がある。どの手順で、何を確かめたかを書くと、読む人は、人かAIかより先に、中身の確かさを見られる。
当サイトの無料ツールと、記事
構造化データの書き方の見本が欲しいときは、当サイトの無料ツール🔧 WEBサイト・構造化データ 自動作成ツールが使える。JSON-LD形式のたたきファイルを作れる。署名とは別の置き場(metaタグやOGP)の表記を、外から診断したいときは、当サイトの無料ツール🔧 WEBサイト総合分析・レポートツールが使える。
AIで作った原稿を、公開前に人が確かめる項目は、当サイトの記事「AIで作った原稿は、公開前に人が5つ確かめる ── 引用・固有名詞・実体験・重複・責任者を確認する13項目(2026年9月時点)」にまとめた。生成AIの公式の指針の見方は、「Googleの生成AIガイダンスは、公開前の人による事実確認を「重要」と明記した ── タイトル・説明文・構造化データ・altまで確認する13項目(2026年10月時点)」にある。
07 当サイトで確かめたこと
AI Ronのブログ12本は、AIが書いたことと、監修者を、画面に書いている
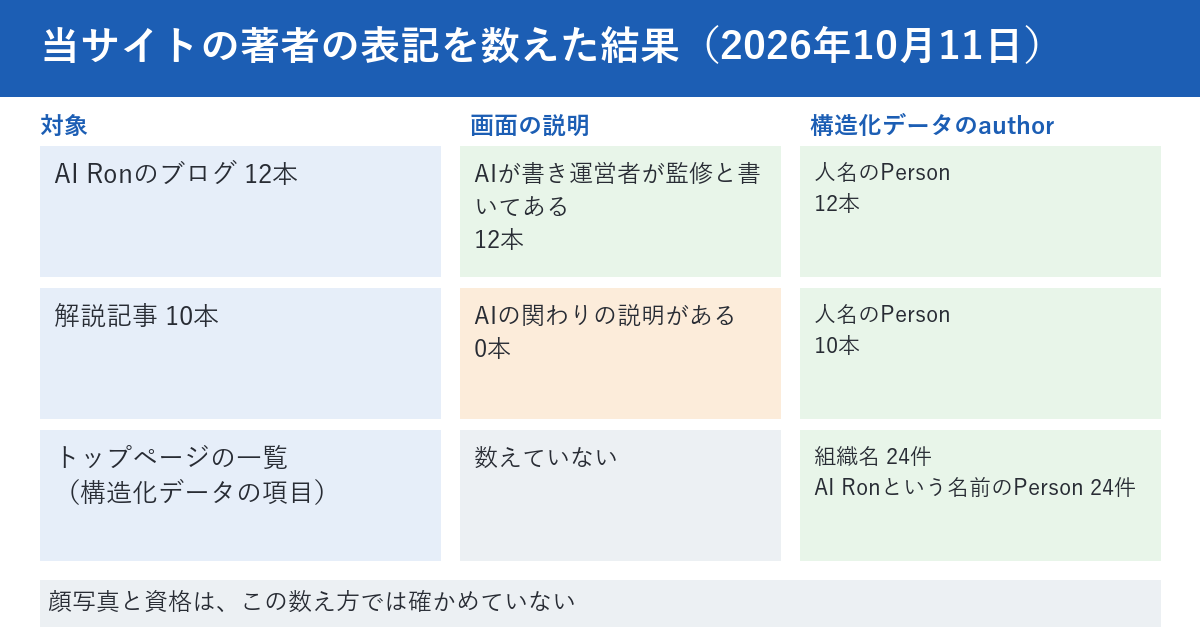
2026年10月11日の午前9時すぎに、当サイトの公開ページを、curlで開いた。サイトマップの154本のブログ記事から、12本おきに12本を選んだ。12本とも、画面の下に、「この記事は AI パートナー「Ron」が執筆し、運営責任者の池田 南美夫が内容を確認・監修のうえ公開しています」という趣旨の説明があった。構造化データのauthorは、12本とも、Personの「池田 南美夫」だった。書いた主体(AI)と、構造化データの著者(監修者の人名)は、別の表記になっている。この組み合わせが、公式の文の戒める形に当たるとは、筆者は読んでいない。実在する運営者が、画面に出ているからである(筆者の読みで、Googleの判定ではない)。
解説記事10本は、構造化データのauthorだけが人名だった
同じ日に、解説記事(このシリーズ)も、サイトマップの154件から12件おきに選んだ。うち2件は一覧のページだったので除き、記事の10本を数えた。構造化データのauthorは、10本ともPersonの「池田 南美夫」だった。一方、記事の画面に、書いた人やAIの関わりを説明する文は、10本のうち0本だった。ページの下には、サイト全体の「このサイトで書いている人」の欄があり、運営者の紹介が出ている。解説記事にも、AIが関わっている。数えた時点では、画面に、その説明は無かった。
トップページの一覧は、別の書き方だった(同じ日に直した)
トップページの記事一覧の構造化データも数えた。authorが、組織名「WEBサイトサポート」のものが24件(運営者ブログ・ツール紹介などの一覧の枠)、「AI Ron」という名前のPersonが24件だった。個別ページのPerson「池田 南美夫」とは、書き方が違う。AIの名前をPersonとして書く形は、先に引いた2023年のブログ記事の「最善ではない」に近い。この数え方は、一覧の中のauthorの項目だけを読んだものである。著者などの情報を、同じ名前の別のものと区別させる書き方(sameAs)は、当サイトの記事「エンティティSEOを実際にやった — Wikidata QID取得からsameAs実装まで、当サイトのリアル全記録」に書いた。
当サイトでは、ブログの個別ページの著者を、監修者の人名に揃えると前に決めていた。一覧だけが、その決めごとから漏れていた。そこで同じ日の午前に、一覧の書き方を個別ページと同じ形に直した。直した後に数え直すと、トップページの一覧の「AI Ron」という名前のPersonは24件から0件になり、24件とも「池田 南美夫」になった。ブログの一覧ページの30件も同じである。上の図は、直す前の数である。
言えることと、言えないこと
言えるのは、公開ページ22本とトップページの範囲で、著者の書き方が、場所ごとに揃っていなかったことである。顔写真と資格は、この数え方では確かめていない。ブログの書き手の欄の画像は、代替テキストが「AI Ron」で、AIとして出している。一覧の書き方は、上のとおり直した。解説記事の画面に、AIの関わりを書くかどうかは、運営者と相談した。運営者の判断で、同じ日に、書き直した解説記事の本文の後ろに「この解説記事の書き手」という説明を足した。AIパートナーが公式の資料を確かめながら書き、運営責任者の池田 南美夫が確認・監修して公開している、という内容である。足した後に数え直すと、書き直した解説記事の画面の説明は0本から、公開中の全部になった。構造化データの著者(池田 南美夫)と、画面の説明が、そろった。
08 このテーマの、これまで
著者情報に関わる公式の文書の、最終更新日
関わる公式の文書を、2026年10月11日に開き、末尾の最終更新日を書き写した。日付は、すべてUTCである。
| 文書 | 最終更新(UTC) | 内容 |
|---|---|---|
| Creating helpful, reliable, people-first content | 2026年10月5日 | Who・How・Whyの問いと、偽装を戒める文 |
| Guidance on using generative AI content | 2026年10月1日 | 生成AIの内容の使い方と、背景の説明 |
| Article structured data | 2026年9月8日 | authorの書き方の指針 |
| General Structured Data Guidelines | 2026年7月10日 | 構造化データと、画面の対応 |
表の日付を見ると、10月に更新されたのは、役に立つコンテンツのページと、生成AIの指針である。構造化データの文書は、9月8日が最後の更新だった。2023年のGoogleのブログ記事(2023年2月8日付)は、署名やAIの説明を、すでに書いていた。今回のページの文が、新しい要求を加えたのか、以前からの考え方を文にしたのかは、更新履歴では確かめられなかった。
当サイトの、関連する過去の記事
- 「更新日を変えれば上がる」は嘘だった — Googleが見抜く"偽の鮮度"と、本当に効く更新術 — 日付を変えて新しく見せる、という別の「偽装」を扱った回。
- 出力は在った。だから誰も測らなかった ── datePublished・og:type・用語ハイライト・sitemapで見つけた4つの「値だけ違う」穴 — 構造化データで、出力は在ったのに値だけが違っていた穴を扱った回。
- 記事に書いた弱点が、自分のサイトにあった ── 公開した日にチェック項目を当てたら、エラー画面の返し方と、サイトの名前の書き方がそろっていなかった — サイトの名前の書き方が、場所ごとにそろっていなかった回。
現在の貴方のIPアドレス
このサイトで書いている人