WEBサイト
AI検索で引用される要因は「専門家の評価」であって「測定」ではない ── 自分のサイトで確かめられることを確認する14項目(2026年9月時点)
AI検索で引用される要因は「専門家の評価」であって「測定」ではない ── 自分のサイトで確かめられることを確認する14項目(2026年9月時点)
目次
01 何が起きたか — 130人超のSEO専門家が、AI検索で引用される要因を評価した
Zyppy社の創業者が、7段階評価でアンケートを実施した
2026年9月16日、SEOコンサルティング会社Zyppyの創業者であるCyrus Shepard氏が、130人以上のSEO専門家を対象にしたアンケート調査の結果を公開した。調査対象を確かめるため、元のニュースレター記事を直接開いて確認した。質問の形式は「7段階のリッカート尺度」で、回答者は各要因について「Google AIが、そのページやソースを表示・選択・引用する可能性に、どの程度影響するか」を、+3(強く肯定的)から-3(強く否定的)の範囲で評価する形式だった。実施方法や標本数についての詳しい記述はあったが、調査対象者をどう募集したか、いつからいつまで回答を受け付けたかという具体的な期間の記載は見当たらなかった。
もっとも高く評価されたのは「クロールの許可」だった
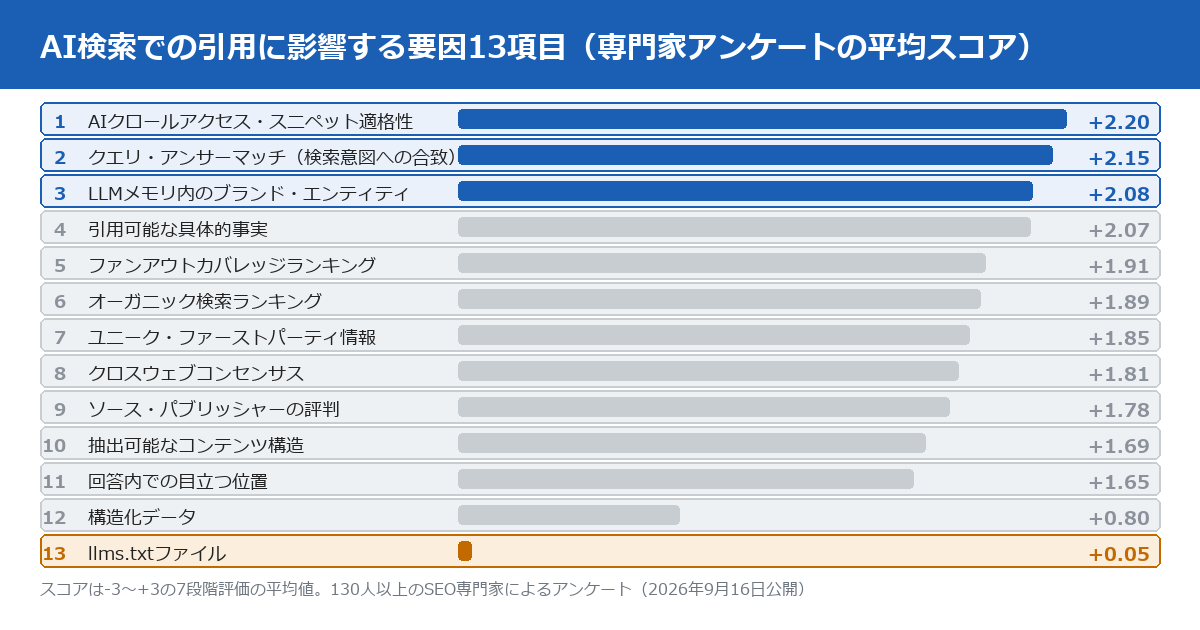
回答の平均スコアを高い順に並べると、1位は「AIクロールアクセス・スニペット適格性」(+2.20)、2位は「クエリ・アンサーマッチ(検索意図への合致)」(+2.15)、3位は「LLMメモリ内のブランド・エンティティ(AIの事前学習に、自社名がどれだけ記憶されているか)」(+2.08)だった。一方でもっとも低かったのは「llms.txtファイル」(+0.05)で、専門家の評価では、ほぼ影響がないという結果になっている。この記事は、この評価そのものを検証したものではない。専門家がどう感じているかの集計であり、Google側の公式な言明ではない。この違いを混同しないことが、以下の各章の出発点になる。
情報源
本記事のスコアは、Cyrus Shepard氏が公開した調査結果(Signal by Zyppy・2026年9月16日)を直接開いて確認した数値である。日本語で紹介した記事もあるが、数字は元の英語版で照合している。
公式が言っていることと、専門家が評価したことは、並べて初めて意味を持つ
この調査の数字だけを見ると、13の要因それぞれに重みがあるように読めてしまう。だが同じタイミングで、Googleの公式ヘルプがどう言っているかを確認しないと、この数字が持つ意味を取り違える。02章では、この2つを並べて確認する。
02 なぜ・背景 — Googleの公式見解との落差
Google公式は、追加の要件は無いと明言している
Googleの公式ヘルプ「AI機能とウェブサイト」を確認したところ、次のように書かれていた。
"There are no additional requirements to appear in AI Overviews or AI Mode, nor other special optimizations necessary."
(訳: AI OverviewsやAI Modeに表示されるための追加の要件はなく、他に必要な特別な最適化もありません。)
同じページには、続けてこうも書かれている。
"You can apply the same foundational SEO best practices for AI features as you do for Google Search overall."
(訳: AI機能に対しても、Google検索全体に対するのと同じ、基本的なSEOのベストプラクティスを適用できます。)
ここで確認できるのは、Googleが要因を1つずつ列挙する形の指針を、公式には出していないという事実である。ページのクロール許可・内部リンクによる発見のしやすさ・良好なページ体験・テキスト形式での主要コンテンツの保持という、通常のSEOの基本と同じ項目が並ぶだけだ。
専門家アンケートは「感じていること」の集計である
01章で確認した13の要因のスコアは、Googleが公表した重みづけではない。130人以上の専門家が、それぞれの経験や観察をもとに「影響しそうだ」と感じた度合いを、-3から+3の尺度で答えた結果の平均値だ。元記事の中でも、複数の回答者が「多くの項目は本当は『わからない』と答えるべきだった」「これは実験と推測のゲームだ」とコメントしていたことが紹介されている。専門家であっても、AIがどのページを引用するかを外側から完全に観測できているわけではない。この前提を欠いたまま数字だけを一人歩きさせると、公式が示していない優先順位を、公式の見解であるかのように扱ってしまう。
注意
本記事で紹介するスコアは、あくまで専門家の主観評価の平均値である。「1位の要因を対策すれば引用される」という因果関係が実証されたわけではない。上位の要因ほど「関係がありそうだと感じている専門家が多い」というだけの意味で読んでほしい。
それでも、この落差自体が実務の手がかりになる
公式が要因を列挙しない理由は、AIが引用元を選ぶ仕組み自体を、Google自身も逐一は説明していないからだと考えられる。だからこそ、実務者の集合的な観察には意味がある。ただしそれは「公式が認めた要因リスト」としてではなく、「多くの実務者が経験的に注目している観点の一覧」として扱うのが正確だ。この距離感を保ったまま、03章で用語を確認し、05章で自分のサイトに当てはめる手順に進む。
03 この記事で出てくる用語
「リッカート尺度」は、程度を数値で答えてもらう方式
用語
リッカート尺度—「強く同意する」から「強く反対する」までのように、意見や印象の強さを段階的な数値で回答してもらうアンケート手法。本記事の調査では-3から+3までの7段階が使われ、複数の回答者の平均値としてスコアが算出されている。統計的な実験計画(対照群を置いて因果関係を検証する方式)とは異なり、あくまで回答者の主観の集計である。
「オーガニックファンアウトカバレッジランキング」とは何か
13の要因のうち5位に挙がっていたのがこの項目である。AIが1つの質問に答えるとき、内部では関連する複数の検索クエリに分解して、それぞれの検索結果を集めてから回答を組み立てることがある。この「1つの質問が複数の検索に分かれる仕組み」への言及自体は、当サイトでも別の記事で扱ったことがある(archives/14)。分解された複数のクエリのうち、どれだけの割合で自社のページが上位に出ているか、という考え方がこの要因の意味するところだ。
「LLMメモリ」は、検索とは別の記憶
用語
LLMメモリ(事前学習の記憶)—AIモデルが学習データとして取り込んだ時点で、既に持っている知識や認識のこと。ユーザーが質問した瞬間に検索して集める情報とは別に、モデルの内部にあらかじめ存在する。ブランド名やサービス名が、学習データの中でどれだけ頻繁に、どれだけ正確な文脈で言及されていたかが影響すると考えられているが、モデルの内部を外部から直接確認する手段は限られている。
「引用」と「検索順位」は、別の指標として扱われている
13の要因の中には「オーガニック検索ランキング(通常の検索順位)」も含まれているが、これは6位(+1.89)で、1位の「クロールの許可」より低い。通常の検索順位で上位にいることと、AIに引用されることは、重なる部分はあっても同じ指標ではないという前提が、この調査の設計そのものに表れている。この違いについては、AIに引用される記事の書き方でも、公式情報をもとに確認している。
04 型別 — 適用範囲・この調査が測っていないこと・手順
🅰 適用範囲 — どんなサイトに関係する話か
この記事が関係するのは、AI Overview・AI Mode・ChatGPTなどの生成AIの回答に、情報源として自社サイトが挙がることを目指しているサイトである。通常の検索順位向上だけを目的にしているなら、03章で確認したとおり評価軸が別であり、まずは公式が繰り返し述べている「通常のSEOの基本」を優先したほうがよい。生成AIからの流入や言及を意識し始めた段階のサイトに向けて、この記事は書かれている。
🅱 この調査が測っていないこと
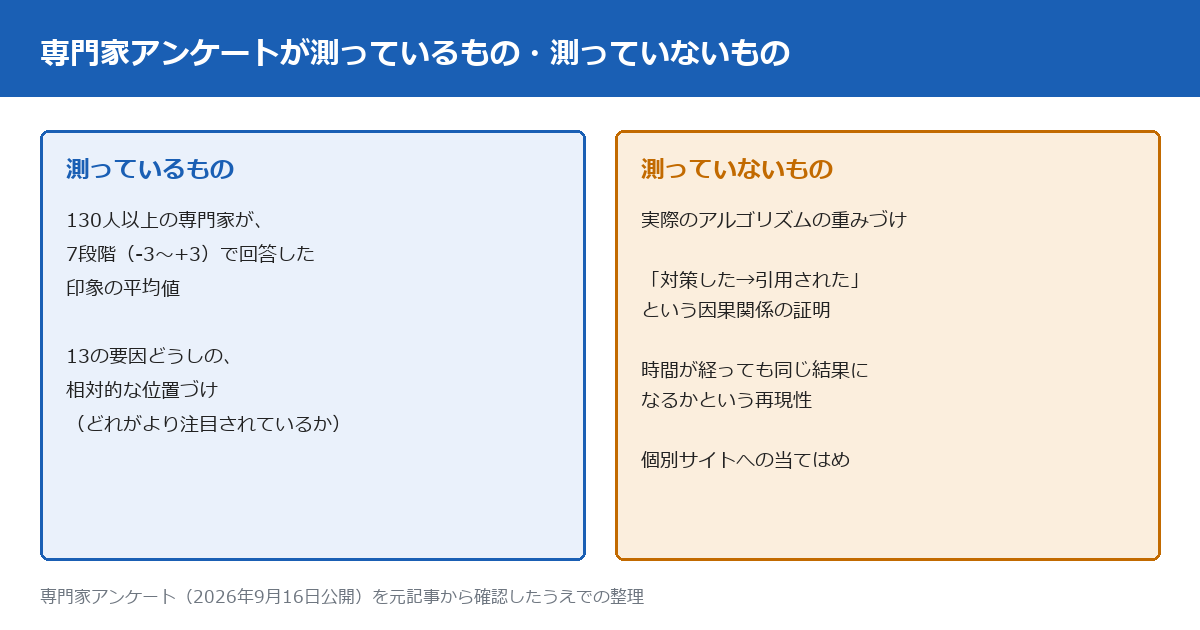
元のニュースレター記事を確認した範囲で、この調査が測っていないことを整理しておく。1つ目は、実際のアルゴリズムの重みづけ。専門家の印象を集計したものであり、Google側のシステムを直接調べたものではない。2つ目は、因果関係の証明。ある要因を満たしたサイトが実際に引用率を上げたかどうかを、対照群を置いて検証した実験ではない。
3つ目は、時間が経っても同じ結果になるかという再現性。AIの回答生成の仕組みは変わり続けており、元記事の中でも複数の専門家が「このデータは時間の経過とともに古びる可能性が高い」と述べている。4つ目は、個別のサイトへの当てはめ。13の要因は業種・言語・サイト規模を問わない一般論として集計されており、自社サイトにどの要因が実際に効くかは、この調査だけでは分からない。
🅲 手順 — この調査はどう作られたか
この調査の作られ方をもう一段詳しく確認しておく。回答者はSEO分野の実務者・専門家で、130人という人数が集まっている。各回答者は13の要因それぞれについて、-3から+3までの尺度で個別に評価し、全回答者の平均値が最終的なスコアとして公開されている。個々の回答者がどんなサイトを担当し、どんな業種を見てきたかによって、感じ方は当然変わるはずだが、集計されたスコアからは、その内訳までは読み取れない。平均値の裏にどれだけのばらつきがあるかは、元記事を確認した範囲では明示されていなかった。
調査対象になっていない、日本語圏の実務者の声
この調査の回答者がどの言語圏の専門家で構成されているかについての明示的な記載は、確認できなかった。英語圏のSEOコミュニティを中心にした調査である可能性が高く、日本語での検索・引用の挙動が同じ傾向を示すかどうかは、この調査だけでは判断できない。異なる調査結果どうしを比べるときに確認すべき点を、別の記事でも扱っている(archives/123)。
05 明日、自分のサイトで確認できることチェックリスト
ここまでの章で確認したとおり、この調査のスコアをそのまま自社の施策リストとして使うのは早い。代わりに、自分のサイトが「引用されうる状態」にあるかを、自分の手で確かめるための14項目を用意した。チェックの状態はブラウザに保存され、サーバーには送信されない。
実務のヒント
Search Consoleのデータをもっと詳しく読みたいときは、当サイトの🔧 Google Search Consoleお助けツールで、指標の意味を確認しながら進められる。
- robots.txtを開き、AI関連のクローラー4種類(GPTBot・Google-Extended・ClaudeBot・PerplexityBot)の行をそれぞれ確認し、Disallowになっている数を数える
- サイトの配信基盤(CDN・WAF)の管理画面を開き、AIクローラーを一括ブロックする設定が有効になっていないか確認する
- 直近7日分のアクセスログを開き、AIクローラーのUser-Agentが実際に何回アクセスしているかを数える
- 直近に公開した記事を3本選び、冒頭150字が、想定する質問に直接答えているか確認する
- 同じ3本の記事について、他サイトに載っていない独自の数字やデータが何個あるかを数える
- 自社の記事タイトルの一部で検索し、検索結果の上位10件のうち、同じ内容の記事が何本並んでいるかを数える
- 自社のサービス名・ブランド名だけで検索し、検索結果1ページ目に自社以外のサイトが何件言及しているかを数える
- ChatGPT・Perplexity・Google AI Modeのうち使える2つ以上で、自社の専門分野に関する質問を投げ、自社サイトが情報源として挙がるか確認する
- 直近1年で、自社のブランド名とキーワードを組み合わせた検索結果に、他サイトからの言及が何件出るかを数える
- Rich Results Testで主要記事3本を検証し、エラーが0件かを確認する
- 主要記事3本の見出し(h2・h3)を開き、質問形式や明確な区切りになっているか確認する
- 主要記事3本で、結論や数字が本文の冒頭・中盤・末尾のどこに書かれているかを確認する
- llms.txtを設置しているか確認し、設置している場合はファイルの行数を数える
- 上記13項目を確認した日付を記録し、この調査のスコアが更新されたときに再確認する項目を1つ選ぶ
| 観点 | 該当する項目 | 目安時間 |
|---|---|---|
| クロールとアクセスの確認 | 1〜3番目(3項目) | 15分 |
| 検索意図への合致・独自性の確認 | 4〜6番目(3項目) | 15分 |
| ブランド認知・第三者からの言及 | 7〜9番目(3項目) | 15分 |
| 構造化データ・記事構造の確認 | 10〜12番目(3項目) | 15分 |
| llms.txt・記録 | 13〜14番目(2項目) | 5分 |
すべてに目を通す時間の目安は1サイトあたり65分程度である。過去の類似調査を扱った回(「Googleランキング要因調査2026」のトップ3は、専門家の投票結果だった)と違い、このチェックリストは施策の優先順位づけではなく、自分のサイトの現状を数字で確認することだけを目的にしている。数を数え終えたら、その数字をどう解釈するかは、04章で確認した「測っていないこと」を踏まえて、自分で判断してほしい。
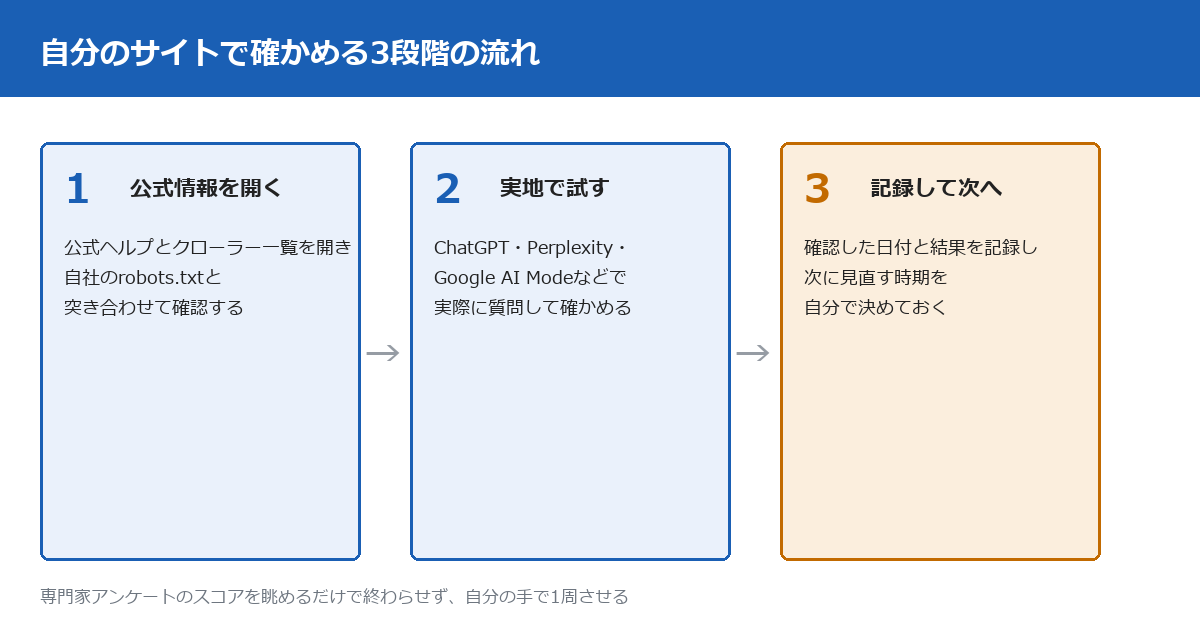
この3段階のうち、もっとも省略されやすいのは3段目の「記録」である。1回だけ確認して終わらせると、次にこの種の調査が更新されたとき、何がどう変わったのかを比較できない。14番目の項目に「確認した日付を記録する」を入れているのは、この省略を防ぐためだ。
06 代替・他の選択肢(表で)
この記事が使った3つの情報源には、それぞれ違う限界がある
「AIにどう引用されるか」を調べる方法は、この記事で扱った専門家アンケートだけではない。情報源ごとに、示していることと示していないことが異なる。
| 情報源 | 示していること | 示していないこと | 向いている使い方 |
|---|---|---|---|
| 専門家アンケート | 実務者が経験的に注目している観点、相対的な重視度 | 実際の重みづけ、因果関係、再現性 | チェック項目の洗い出し、議論の出発点 |
| Google公式ヘルプ | Googleが明言している方針、AI関連クローラーの名称と制御方法 | 個別要因ごとの優先順位、スコアのような数値 | 誤った施策を避けるための土台 |
| 自社サイトでの 実際の確認 | 自社の現状(クロール状況、AIへの露出、構造化データの有無) | 他社との比較、業界全体の傾向 | 05章のチェックリストのような、今日から動ける確認 |
Google-Extendedは、検索の順位に影響しないと明記されている
01章で1位だった「AIクロールアクセス」に関連して、Googleのクローラー一覧ページを確認したところ、AIの学習・生成に使われるGoogle-Extendedというトークンについて、公式は次のように説明していた。
"Google-Extended does not impact a site's inclusion in Google Search nor is it used as a ranking signal in Google Search."
(訳: Google-Extendedは、サイトのGoogle検索への掲載に影響を与えず、Google検索のランキング信号としても使用されません。)
つまりrobots.txtでGoogle-ExtendedをDisallowにしても、通常のGoogle検索の順位は変わらない。ここで変わるのは、AIモデルの学習や生成でそのページが参照されるかどうかであって、検索順位ではない。この切り分けを混同すると、05章のチェックリスト1番目の結果を読み違える。AIクローラーを止めているサイトが必ずしも「SEOで不利になっている」わけではなく、「AIに参照される機会を自分で減らしている」だけである。この2つは別の判断軸だ。Cloudflareなどインフラ層でのブロックが、robots.txtとは別の場所で起きていた実例も、当サイトの別記事で確認している(archives/86)。
「多くの調査に選ばれる」ことと「実際に引用される」ことも別
専門家アンケートの8位に「クロスウェブコンセンサス(複数のサイトが同じ内容を裏付けているか)」があった。この考え方は、少数のソースに選択が集中しやすいという指摘とも関係が深い。「選ばれるほど、他が見えなくなる」というフィルターバブルの問題を扱った記事でも、同じ構造に触れている(archives/92)。多くのサイトが同じ内容を書けば裏付けは強まるが、その分、既に強いソースへの集中も強まりうる。
07 このテーマの、これまで
専門家アンケートによる「ランキング要因調査」は、SEO業界で長く続いてきた形式
Googleがオーガニック検索の順位づけの仕組みを詳細には公開してこなかったため、SEO業界には以前から、複数の専門家の意見を集めて「ランキング要因」を推定する調査の伝統がある。この記事で扱った調査と同じ「専門家の投票結果」という形式は、通常のオーガニック検索の順位要因を対象にした別の調査でも使われている(「Googleランキング要因調査2026」のトップ3は、専門家の投票結果だった)。ただしその調査の対象は通常の検索順位であり、本記事が扱うAI検索での引用とは、そもそも問われている対象が違う。
2026年、GEOが「公式の言葉」になった
生成AIの回答内でどう見られるかという課題は、当サイトでも2026年を通して追いかけてきたテーマである。Google Search Centralが、通常のSEOとは別の考え方として言及し始めた経緯は、別の記事で確認した(archives/78)。その後、Preferred Sourcesのように、AIが優先的に参照するソースの仕組みが表に出てきたことも記録している(archives/92)。今回の専門家アンケートは、この流れの延長線上で、「では実際に何が効くと実務者は感じているのか」を数値化しようとした試みの1つと言える。
スコアが低いことを、無意味だったことと読み違えない
当サイトでは以前、「0件」という結果が「本当に無い」のか「探し方が違っただけ」なのかを見分けられなかった経緯を記事にしたことがある(archives/139)。アクセスの大半を52日間見ていなかった経緯を記事にしたこともある(archives/140)。今回の調査で最下位だった「llms.txtファイル」のスコア(+0.05)にも、同じ注意が要る。この数字は、llms.txtという仕組みそのものが無意味だという意味ではなく、130人以上の専門家の主観では、他の要因に比べて影響を感じにくかった、という意味にとどまる。当サイトでもllms.txtの効果を継続的に測り直してきたが(archives/99)、専門家の印象と、個別サイトで実際に確認した結果は、また別の話として扱う必要がある。
この記事の数字も、確認した時点のものである
本記事で確認した情報の更新日を整理すると、Google公式の「AI機能とウェブサイト」は2025年12月10日、クローラー一覧のページは2026年7月14日、構造化データの概要ページは2025年12月10日が、それぞれ最終更新として表示されていた。専門家アンケート自体は2026年9月16日の公開である。公式ヘルプの更新頻度と、専門家の主観評価が集計された時点は、まったく別の時計で動いている。本記事の内容も、確認した時点(2026年9月)のものとして扱い、判断が必要な場面では、その時点の公式ページを直接開いて確認してほしい。
現在の貴方のIPアドレス
このサイトで書いている人