WEBサイト
Googleは利用者が作るスパムを防ぐガイドを10月26日に更新し、共有用のページは既定でnoindexにする助言を加えた ── 共有リンクのページと見張りの担当を確かめる13項目(2026年10月時点)
Googleは利用者が作るスパムを防ぐガイドを10月26日に更新し、共有用のページは既定でnoindexにする助言を加えた ── 共有リンクのページと見張りの担当を確かめる13項目(2026年10月時点)
目次
01 何が足されたか — 10月26日に、共有されるページを既定で検索に出さない助言と、Search Consoleでの見張り方が加わった
引用について
この記事の「" "」で囲んだ英語の文は、Google検索セントラルの文書からの引用で、日本語訳は記事の筆者が付けた。各ページは2026年10月28日に開いて、本文を取り直し、1文字ずつ照らした。照らせなかった文は引用の形にせず、要旨として書いた。Search Consoleの画面の項目名は、公式の文書に書かれた名前で書く。
Google検索セントラルに、「Prevent user-generated spam on your site and platform」(訳: 自分のサイトとプラットフォームで、利用者が作るスパムを防ぐ)というページがある。ページの末尾には「Last updated 2026-10-26 UTC.」(訳: 最終更新 2026-10-26 UTC)と出ていた。この記事は、このページの2026年10月26日の更新を受けて、共有用のページを検索に出さない既定値と、悪用の見張り方を、担当サイトで確かめる方法だけを書く。コメント欄のスパムへの対策や、リンクのrelの付け方は、これまでの記事に書いたので、ここでは繰り返さない。
更新履歴の10月26日の項目
検索セントラルの更新履歴の2026年10月26日の項目は、見出しが「Updated guidance on preventing user-generated spam」(訳: 利用者が作るスパムを防ぐ指針を更新した)で、中身は次の2行である。
"What: Updated the user-generated spam prevention guide with guidance on blocking indexing of link-shared content and monitoring abuse in Search Console."
(訳: 内容: 利用者が作るスパムを防ぐガイドに、リンクで共有される内容の索引登録を止める指針と、Search Consoleで悪用を見張る指針を加えた。)
"Why: To help platforms keep user-created pages that aren't meant for Search out of the index and detect spam earlier."
(訳: 理由: プラットフォームが、検索向けではない利用者の作ったページを索引に入れず、スパムをより早く見つけられるようにするため。)
足されたのは2つ、索引に入れない指針(既定値)と、Search Consoleでの見張り方である。以下の02章と03章で、それぞれページの本文を読む。
この更新が当てはまる相手
ページは、主に「利用者がページやサイトを作れるプラットフォーム」と「コメント欄などの入力欄を持つサイト」に向けて書かれている。冒頭の文は、こう始まる。
"Spammers often take advantage of open comment forms and other user generated content inputs and generate spammy content on an unsuspecting victim site."
(訳: スパムを書く者は、開かれたコメントのフォームや、利用者が作る内容の入力欄を悪用して、気づいていない被害側のサイトに、スパムの内容を作ることが多い。)
だから、自社が「利用者がページを作れるサービス」を持たないサイトは、この更新のほとんどが当てはまらない。ただし、問い合わせ後の完了画面、見積もりのプレビュー、会員の公開プロフィール、診断結果の共有リンクのように、「担当者は気づいていないが、利用者の操作でページが生まれる」仕組みは、小さなサイトにも意外にある。05章の最初の2項目で、それを数える。
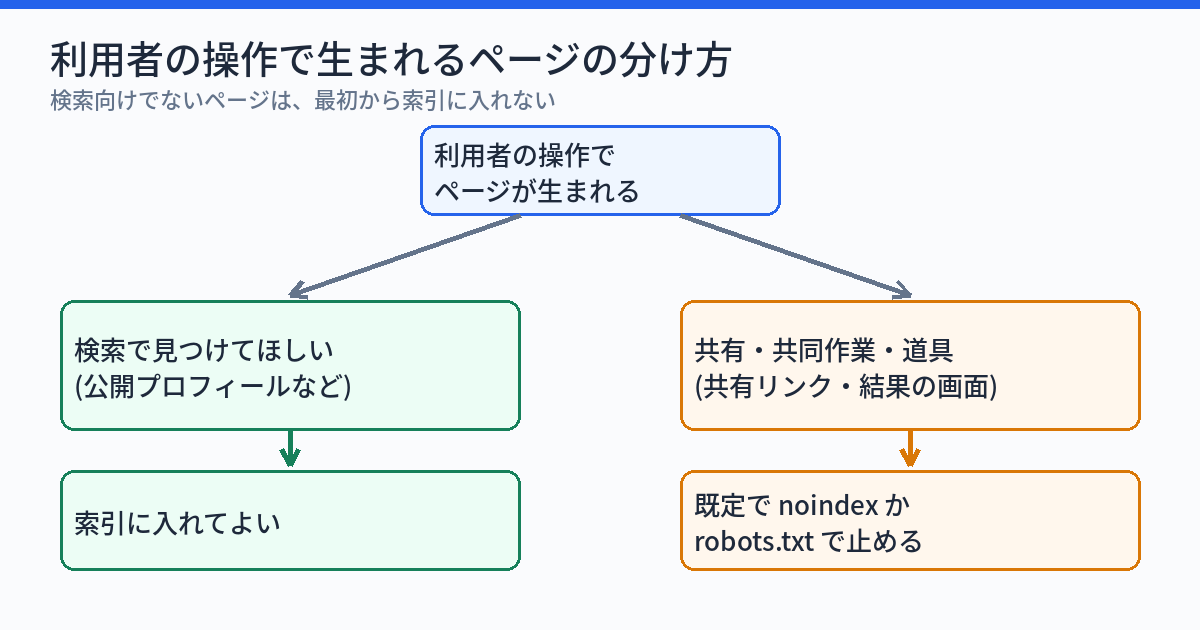
02 既定値の話 — 共有・共同作業・道具のためのページは、最初から検索に出さない
ページの本文が書いたこと
「Only index content meant for Search」(訳: 検索向けの内容だけを索引に入れる)という見出しの下に、ページはこう書く。
"If your service lets users create shareable pages, generated outputs, or interactive tools, consider whether that content is meant to be found through search engines or only accessed directly by people with a link."
(訳: あなたのサービスが、利用者に、共有できるページ、生成された出力、対話型の道具を作らせるなら、その内容が、検索エンジンで見つけてもらうためのものか、リンクを知る人が直接開くだけのものかを考える。)
"When pages are created for direct sharing, collaboration, or utility rather than public search discovery, apply the noindex rule (using a robots meta tag or X-Robots-Tag HTTP response header) or block crawling in robots.txt by default."
(訳: ページが、公開の検索での発見ではなく、直接の共有、共同作業、または実用のために作られるときは、既定で、noindexの規則(robots metaタグまたはX-Robots-TagのHTTPレスポンスヘッダーを使う)を適用するか、robots.txtでクロールを止める。)
読み取れるのは3点である。対象は、共有・共同作業・実用のために作られるページであること。手段は、noindex(metaタグまたはヘッダー)か、robots.txtでの取得の停止であること。そして「既定で」、つまり、1枚ずつ判断して止めるのではなく、作られた時点から止まっている状態を基本にすること、である。
「既定で」の意味 — 後から止めるのは遅い
共有リンクのページは、利用者の操作で、毎日増える。1枚ずつ人が見て「これは出さない」と決める運用は、増える速さに追いつかない。ページの文は、作られた時点の値を決める書き方になっている。ここは筆者の読みで、ページが理由を書いているわけではない。
用語: noindexとX-Robots-Tag
noindexは「このページを検索結果に出さない」という指定で、ページのheadに書くrobots metaタグか、応答のヘッダーのX-Robots-Tagで伝える。Googleの文書は、この2つで同じ規則が使えると書く。
noindexは、2つの書き方がある
robots metaタグとX-Robots-Tagの書き方は、Googleの別の文書に載っている。metaタグは、ページのheadに次の形で置く。
<meta name="robots" content="noindex">ヘッダーでは、次の形で返す。
X-Robots-Tag: noindex同じ文書は、PDFや画像のようなHTMLではないファイルの索引登録を止めるには、X-Robots-Tagのヘッダーを使う、とも書く。共有ページが、HTMLの画面なのか、ダウンロードされるファイルなのかで、使う手段が変わる。
robots.txtで止めると、noindexは読まれない
ここに落とし穴がある。robots metaタグの文書は、robots.txtとの組み合わせを、こう書く。
"robots meta tags and X-Robots-Tag HTTP headers are discovered when a URL is crawled."
(訳: robots metaタグとX-Robots-TagのHTTPヘッダーは、URLがクロールされるときに見つかる。)
"If a page is disallowed from crawling through the robots.txt file, then any information about indexing or serving rules will not be found and will therefore be ignored."
(訳: ページがrobots.txtファイルでクロールを禁止されていると、索引登録や配信の規則についての情報は見つからず、そのため無視される。)
つまり、noindexを付けたページを、同じ時に、robots.txtでも止めると、noindexは読まれない。「二重に止めたから安全」とは言えない。どちらを主にするかを決める必要がある。noindexとrobots.txtの違いはnoindex・nofollow・robots.txtは、それぞれ何を止めているのか ── 混同しやすい3つの設定を確認する15項目に書いた。metaタグとヘッダーで使える規則の種類はrobots meta タグ・X-Robots-Tagのディレクティブ ── nosnippet・max-snippetなど12種類を確認する14項目(2026年9月時点)に書いた。
注意
2つの手段のどちらが「既定」にふさわしいかは、ページの文では決まらない。ページは「または」でつないでいる。索引に入れたくないページが、すでに他のサイトからリンクされている場合などは、状況で変わる。迷ったら、noindexを選び、robots.txtの禁止と重ねない形から試す。これは筆者の整理で、公式の推奨ではない。
03 見張りの話 — Search Consoleで見る所は、公式の文書が挙げるもの
出典
見張り方の本文は、「Monitor your service for abuse」の項目にある。画面の項目名は、ページと、Search Consoleヘルプの題名に書かれた名前(Page indexing report、Performance reportなど)を使う。日本語の画面の表示名との対応は、この記事では確かめていない。
ページが挙げた、Search Consoleでの見張り方
「Monitor your service for abuse」(訳: サービスの悪用を見張る)の項目で、ページはSearch Consoleに関する部分を、こう書く。
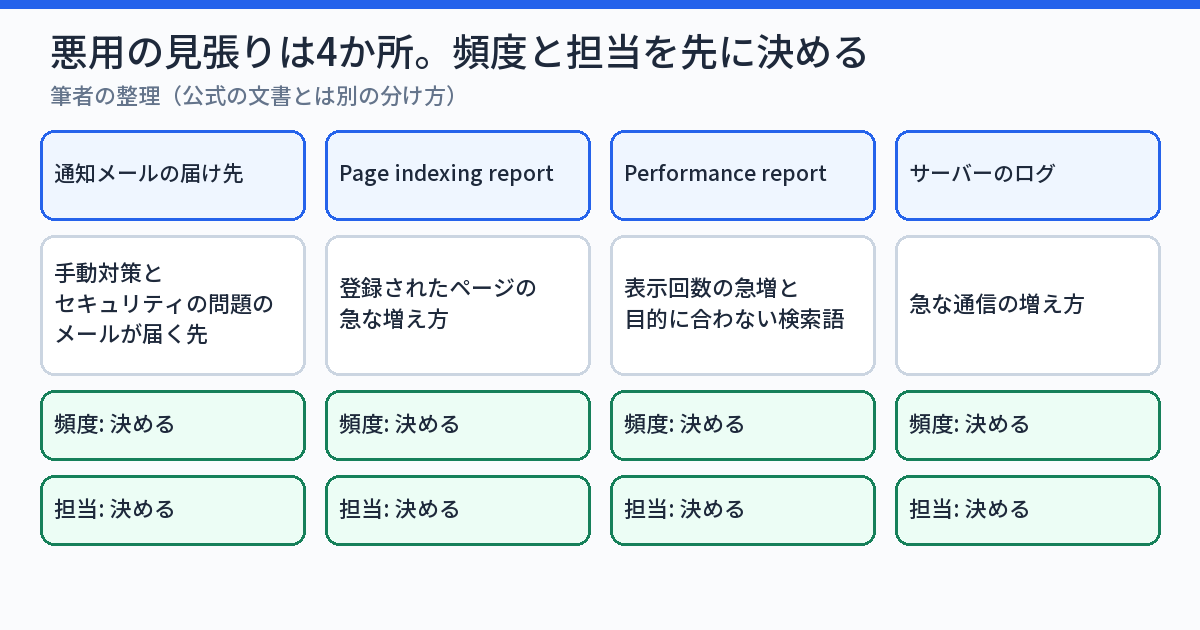
"Verify your site or subdomain in Search Console so you receive email alerts if Google issues a manual action against your site or detects security issues."
(訳: Search Consoleで、サイトまたはサブドメインの所有を確認し、Googleがサイトに手動対策を出したり、セキュリティの問題を検出したりしたときに、メールの通知を受け取れるようにする。)
"Also check the Page Indexing report and Search performance report regularly for unexpected spikes in indexed pages, impressions, or queries that don't match your platform's purpose."
(訳: また、Page Indexingレポートと、Search performanceレポートを、定期的に見て、索引登録されたページ、表示回数、またはプラットフォームの目的に合わない検索語に、予想外の急増が無いかを確かめる。)
公式の文書が挙げる見る所は、2つの文に分かれている。1つ目の文は、所有の確認(サイトまたはサブドメイン)と、通知メール(手動対策とセキュリティの問題)。2つ目の文は、2つのレポート、つまりPage Indexingレポート(索引登録の急増)と、Search performanceレポート(表示回数の急増と、目的に合わない検索語)である。画面の見た目は変わりうるので、この記事は、画面の絵を描かない。名前は、上の公式の文書の名前をそのまま使う。
プラットフォーム側の数字も見る
ページは、Search Consoleの外の数字も挙げる。
"Track platform-level creation and indexing metrics, and set up alerts for anomalies such as spikes in newly published public pages or a small number of users generating a large share of indexable URLs."
(訳: プラットフォーム全体の、ページが作られる数と索引登録される数の指標を追い、新しく公開されたページの急増や、少数の利用者が索引登録できるURLの大部分を作っていることのような異常に、警報を設定する。)
この項目は、自社で「ページが1日に何枚作られたか」「1人の利用者が何枚作ったか」を数えられる仕組みを持つ場合の話である。持たないなら、まず、数えられるようにするところから始める。
ログとサイト検索の見方
ページは、同じ項目で、サーバーのログの急な増え方を見ること、リダイレクトや広告枠の多さのような迷惑の兆候を見ること、site:検索や通知サービスを使うことも挙げる。ログを見る手順は、この記事の範囲を超えるので、書かない。
実務のヒント
見張りは、急増に気づく数字を、先に1つ決める。たとえば「Page Indexingレポートの登録済みの数が、前の週の1.5倍を超えた」のように、数と比べる相手を決めておくと、気づいた人が迷わない。1.5倍は筆者の例で、公式の数字ではない。
通知メールの届け先を確かめる
通知メールは、Search Consoleに登録した所有者や利用者のメールアドレスに届く。担当者が退職したあとも、古いアドレスにだけ届いている、という状況は、確かめない限り見えない。05章の10番目で、届け先を開いて確かめる。
04 型別 — 適用範囲・測られていないこと・手順
🅰 どんなサイトに当てはまるか
ページは、プラットフォームを例に書くが、利用者の操作でURLが生まれるサイトなら、規模を問わず当てはまりうる。次の5つの形が、典型である。
- 共有リンク(見積もりや診断結果を、リンクで人に渡す機能)
- 利用者のプロフィールや投稿のページ
- 対話型の道具の結果の画面(検索結果、計算結果、プレビュー)
- フォームの送信後の完了画面
- 利用者がアップロードしたファイルの置き場
運営者が1枚ずつ作るページ(会社案内、記事、商品ページ)は、この更新の対象ではない。
🅰 当てはまらないと判断してよい基準
次の3つがすべて「いいえ」なら、担当サイトは、この更新の主な対象ではない、と書いてよい。
- 利用者の操作で、検索エンジンが見つけられるURLが新しく生まれるか
- 入力欄から入った内容が、ページとして公開されるか
- 利用者がアップロードしたファイルに、固有のURLが付くか
判断した日と、誰が確かめたかを、台帳に残す。後から、機能が増えたときに、見直せる。
🅱 ページが測っていないこと
- 「既定でnoindex」にしたときの、検索流入への影響の大きさ。ページは数字を挙げない
- noindexとrobots.txtのどちらが、スパムの抑止に強いか。ページは優劣を書かない
- Search Consoleの「急増」が、どのくらいの倍率か。ページは、閾値を書かない
- 日本語の画面での、項目名の対応
🅲 手順 — 作る・止める・見張るの順
- 数える: 利用者の操作でURLが生まれる機能を、一覧にする
- 分ける: それぞれを、検索に出したいか、出さないかに分ける
- 止める: 出さないものに、noindexを付ける。HTMLの画面はmetaタグかヘッダー、ファイルはヘッダー
- 確かめる: 実際の応答に、noindexが付いているかを、metaとヘッダーの両方で見る
- 見張る: Search Consoleの通知先、Page Indexingレポート、Search performanceレポートを、見る頻度と担当を決めて回す
次の図は、筆者の数え方である。通知メール・ページのインデックス登録・検索のパフォーマンス・サーバーのログの4つに分けた。公式の文書が挙げる見る所の書き方とは、別の分け方である。
実際の応答で確かめる、というのが肝
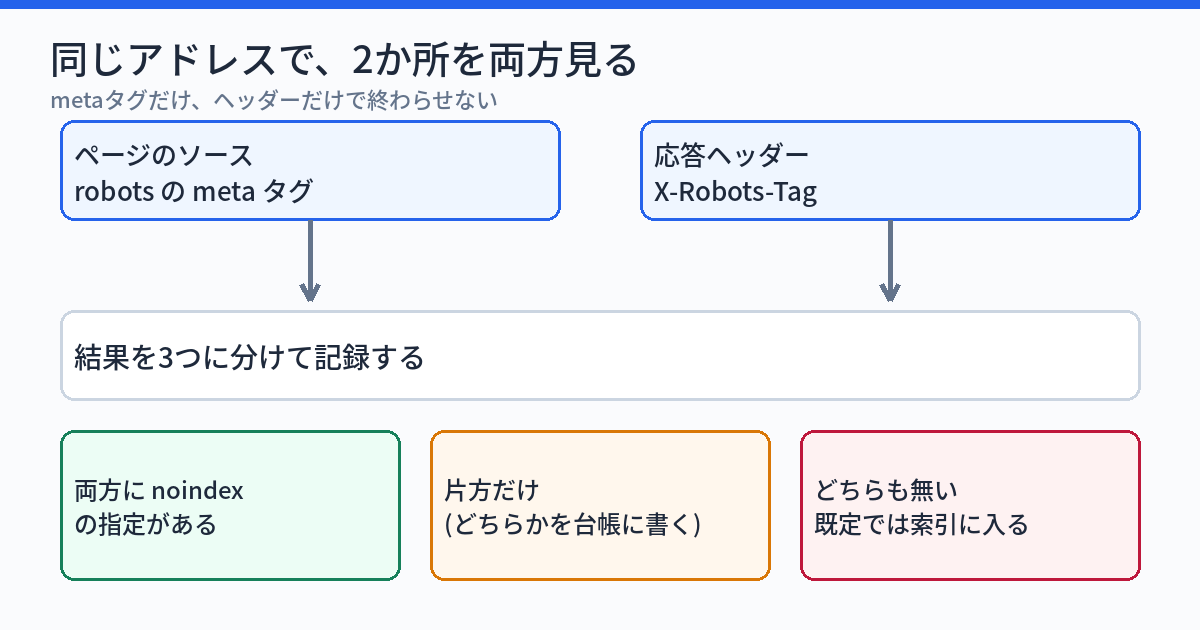
設定を書いたことと、配信されている応答にnoindexが出ていることは、別である。管理画面で「noindexにする」を選んでも、実際に配信される応答に出ているかは、別に確かめる必要がある。外から取った画面は、目当ての画面とは限らない ── 遮断の画面を404と読み、引用符の違いでnoindexを「無い」と読みかけたは、外から取った画面が目当ての画面ではなかったり、引用符の違いでnoindexを見落としかけたりした記録である。確かめるときは、引用符が「"」と「'」のどちらでもmetaタグを探すことと、取った画面の題名を先に見て、目当ての画面かを確かめることを守る。
05 明日、自社のサイトで確認できることチェックリスト
以下は、担当サイトで、共有用のページを検索に出さない既定値と、悪用の見張りを確かめる13項目である。1〜2番目は共有されるページを数える、3〜7番目はnoindexの確認、8〜9番目は投稿とリンクの扱い、10〜12番目はSearch Consoleでの見張り、13番目は頻度と担当である。1項目は5分以内でできる。チェックの状態はブラウザに保存され、サーバーには送られない。
- 担当サイトの機能の一覧を開き、利用者の操作でURLが生まれる機能(共有リンク・公開プロフィール・結果の画面・完了画面・アップロード)を数えて、数を書く
- 数えた機能のうち、検索に出したいものと、出さないものを分けて、出さないものの数を書く
- 出さない機能から共有リンクを1つ作り、サインインしていないブラウザで開いて、誰でも見られるかを確かめる
- そのページのソースを開き、robotsのmetaタグを、引用符が「"」と「'」の両方で探して、noindexの有無を書く
- 同じアドレスの応答ヘッダーを取り、X-Robots-Tagの有無を見て、metaタグの結果と並べて書く
- robots.txtを開き、共有リンクの置き場がDisallowになっていないかを見る。止まっていれば、noindexが読まれない可能性を台帳に書く
- アップロードされたファイル(PDFや画像)の置き場から1つ選び、応答ヘッダーにX-Robots-Tagがあるかを確かめる
- 登録して間もない試験の利用者で投稿を1件作り、その投稿のページが、すぐ索引に入る形か、noindexで止まる形かを確かめる
- 投稿の中のリンクを3本開き、relにnofollowまたはugcが付いているかを確かめる
- Search Consoleのプロパティの一覧を開き、共有ページを置くドメインとサブドメインが入っているかを数え、通知メールの届け先が今も読まれているかを確かめる
- Page Indexingレポートを開き、直近3か月の登録済みの推移で、急に増えた日があるかを探し、あれば日付を書く
- Search performanceレポートを開き、検索語を表示回数順に上位20件並べて、サイトの目的に合わない語の数を書く
- 見る頻度(例: 毎週の月曜)と、担当者の名前と、急増に気づく数字を1つ決めて、カレンダーに入れる
応答ヘッダーを取る例を示す(アドレスは自分のものに変える)。
curl -s -D - -o /dev/null https://example.com/share/abc123応答に「X-Robots-Tag: noindex」の行があれば、ヘッダーでの指定が効いている。無ければ、metaタグを探す。どちらも無ければ、そのページは、既定では索引に入れてよい状態である。
Search Consoleから書き出したURLの一覧を、今のHTTPステータスやリンク元つきで調べるなら、🔧 Search Consoleのエクスポートを読み込んで詳しく見るツールが使える。
06 代替・他の選択肢 — 手段は4つ。状況で選ぶ
止め方の比較
| 手段 | 向く場面 | 文書が書くこと・注意 |
|---|---|---|
| robots metaタグ(noindex) | HTMLの画面。テンプレートで一括して付けられるとき | クロールされたときに読まれる。robots.txtで止めたページでは読まれない |
| X-Robots-Tag(noindex) | PDF・画像など、HTMLではないファイル。サーバーの設定で一括して付けたいとき | metaタグと同じ規則が使える。ヘッダーの設定は、実際の応答で確かめる |
| robots.txtで取得を止める | そもそも取りに来てほしくない置き場 | ページが挙げる手段の1つ。止めたページでは、noindexの情報が読まれない |
| 新しい利用者の投稿だけnoindex | コメントや投稿を、評判のある利用者のものだけ索引に入れたいとき | 同じページの別の項目が挙げる手。評判が付いたら、索引を許す |
当てはまらないサイトの判断
04章の🅰の3つの質問がすべて「いいえ」なら、対象外と判断してよい。ただし、対象外と判断したサイトでも、外部リンクのrelは3つ。広告・対価のあるリンクにはsponsored、利用者の投稿にはugc、推薦したくない相手にはnofollow ── 自社の外部リンクを棚卸しして確認する13項目(2026年10月時点)で書いたように、外部へのリンクのrelや、通知メールの届け先の確認は、別に意味がある。
UGC Fresh Data Programとは別の話
名前の似た「UGC」の話に、UGC Fresh Data Programは、投稿が主役のプラットフォームだけが対象 ── 自社が6つの条件に当てはまるかを判定する13項目(2026年10月時点)がある。あちらは、投稿が主役のプラットフォームが対象のプログラムの条件を確かめる記事で、この記事の「悪用を防ぐ」とは目的が違う。
見張りの外側の手
ページは、見張りのほかに、人が承認する仕組み、繰り返しの悪意のある利用者を禁止する一覧、自動の登録を防ぐ確認の仕組みも挙げる。この記事は、検索に出さない既定値と見張りだけを扱った。
07 当サイトで確かめたこと — 外から見える応答と、確かめていないこと
2026年10月28日に、当サイトの公開URLを、外から開いた。確かめたのは、外から見える返事(ステータス、robotsの指定、ヘッダー)だけである。
利用者が作って共有するページは、確かめた範囲では見つからなかった
サイトマップのURLは428本で、会員の画面のURLを含むものは0本だった。会員の画面(サインイン、新規登録)は、200で開き、robots metaタグがnoindexで、X-Robots-Tagのヘッダーは返っていなかった。存在しないURLは、404で、noindexだった。サインインが要るMyページは、サインインの画面へ302で転送された。
noindexとrobots.txtが、同じ画面に重なっている例
会員の画面は、metaタグでnoindexを書き、robots.txtでも取得を止めている。02章の通り、取得を止めたページでは、noindexの情報が読まれない。この画面は、サインインが要るだけで、検索に出したいページではないので、問題にならないが、重ねた形になっていることは事実である。重ねを外すかは、この記事では決めない。
当サイトで確かめていないこと
- 利用者の操作でURLが生まれる機能が、全部で、いくつあるか(外から開けた範囲だけを見た)
- Search Consoleの通知メールの届け先と、Page Indexingレポートの急増(この記事の確認では、画面を開いていない)
- 会員の画面以外の、サインイン後のページのrobotsの指定
08 このテーマは、ここまで
noindexと、利用者が作る内容の扱いは、これまでにも書いてきた。
noindexの3つの書き方の違い
noindex・nofollow・robots.txtは、それぞれ何を止めているのか ── 混同しやすい3つの設定を確認する15項目は、noindex・nofollow・robots.txtが、それぞれ何を止めているのかを、混同しやすい3つの設定として書いた。今回の02章の落とし穴は、この記事の続きとして読める。
metaタグとヘッダーの規則の一覧
robots meta タグ・X-Robots-Tagのディレクティブ ── nosnippet・max-snippetなど12種類を確認する14項目(2026年9月時点)は、robots metaタグとX-Robots-Tagで使える規則を12種類並べた。今回使ったのは、そのうちのnoindexだけである。
外部リンクのrelと、投稿のリンク
外部リンクのrelは3つ。広告・対価のあるリンクにはsponsored、利用者の投稿にはugc、推薦したくない相手にはnofollow ── 自社の外部リンクを棚卸しして確認する13項目(2026年10月時点)は、広告や有料のリンクにsponsored、利用者の投稿にugc、推薦したくない相手にnofollowを付ける、という使い分けを書いた。05章の9番目は、その確認の入口になる。
noindexを一括で解いた記録と、静かなnoindexの記録
1,000件の宿題を6日間で畳んだ ── noindex一括解除、「あとで完全にする」の答え合わせは、noindexを一括で解除した記録、1,238記事の8割が「土俵に上がっていない」ことに気づいた日 — addview.html未生成という静かなnoindex地獄、一夜での脱出は、本文のファイルが無いために、気づかないうちにnoindexになっていた記録である。どちらも、「付ける」より前に、「付いている状態を数える」ことの大事さを書いた。
robots.txtの変更が効く速さ
同じ条件で測っていなかった ── robots.txtは「24時間キャッシュ」のはずが、測ったら1日13.9件と152.3件。3サイトの数字を並べる前に確認すべきだったことは、robots.txtが1日に何回読まれているかを3つのサイトで測り、測る条件が揃っていなかったと気づいた記録である。robots.txtで止める手を選ぶときは、読まれる回数も、同じ条件で測ってから判断する。
外から取った画面を、目当ての画面と取り違えない
外から取った画面は、目当ての画面とは限らない ── 遮断の画面を404と読み、引用符の違いでnoindexを「無い」と読みかけたと、「リンク切れ0本」を確認して、安心しかけた ── 自社ブログの内部リンク、59.2%はnoindexへの飛び先だったは、安心しかけた数字を、別の見方で測り直した記録である。noindexの確認でも、外から取った画面の題名と、引用符の両方を見る。
2026年10月28日 — この記事の確認日
この記事の内容は、2026年10月28日に、公式のページ3本と、当サイトの公開URLを開いて確かめた時点のものである。新しい日付が出たときは、日付つきで追記する。
現在の貴方のIPアドレス
このサイトで書いている人