WEBサイト
Cloudflare AI Searchが一般提供になり、11月1日から従量課金が始まる ── サイト内検索をAIに任せる前に、載せる範囲と誤りの直し場所を決める14項目(2026年10月時点)
Cloudflare AI Searchが一般提供になり、11月1日から従量課金が始まる ── サイト内検索をAIに任せる前に、載せる範囲と誤りの直し場所を決める14項目(2026年10月時点)
目次
01 何が起きたか — Cloudflare AI Searchが一般提供になり、従量課金は2026年11月1日から始まる
2026年10月1日に公開された変更履歴
Cloudflareの開発者向けの変更履歴に、「AI Search is generally available」(訳: AI Searchが一般提供になった)という投稿が、2026年10月1日の日付で載っている。2026年10月5日に、この投稿と、そこからリンクされている公式ページを開いて読んだ。AI Searchは、自分のサイトや文書を「自然な文章で検索できる状態」にして、アプリやAIエージェントから使うための仕組みである。投稿の最初の2文は、次のとおりである。
"AI Search is now generally available. Usage-based billing begins on November 1, 2026, with included monthly ingestion, storage, semantic query, and full-text query usage."
(訳: AI Searchが一般提供になった。従量課金は2026年11月1日に始まり、毎月の取り込み、保存、意味検索、全文検索の利用量には、含まれる分がある。)
投稿は、請求が始まる前の週に、Cloudflareから知らせのメールが送られるとも書いている。
投稿に書かれた、そのほかの変更
料金のほかにも、同じ投稿に、サイトの運営に関わる変更が並んでいる。
"New AI Search instances use hybrid search by default."
(訳: 新しいAI Searchのインスタンスは、既定でハイブリッド検索を使う。)
- ハイブリッド検索は、意味によるベクトル検索と、全文での一致を組み合わせる。作るときに、別の方式を選ぶこともできる。
- AI Searchが使うWorkers AIの埋め込みと再順位づけの呼び出しは、AI Searchの料金に含まれる。Workers AIの請求やAI Gatewayのログには出なくなる。文章の生成、質問の言い換え、外部のサービスの利用は、これまでどおり自分のアカウントとゲートウェイに記録される。
- 画像を含む検索に対応する埋め込みのモデルが使える。
- スキャンしたPDFの文字を読み取るOCRが、すべてのアカウントで使える。
- ファイルの上限は、文章とコードのファイルとOCRを有効にしたPDFが10 MiB、OCRなしのPDFとほかの形式が4 MiBである。
- インスタンスを作るときの「type」の指定は任意になり、HTTPまたはHTTPSのURLからはウェブサイトの取り込みが、既存のバケットの名前からはR2の取り込みが、自動で選ばれる。
OCRについての1文
"Optical character recognition (OCR) is available on every account for scanned PDFs."
(訳: 光学式文字認識(OCR)は、スキャンしたPDFに対して、すべてのアカウントで使える。)
データソースのページは、OCRは既定では無効で、有効にすると全体の再取り込みが走る、とも書いている。古いPDFが多いサイトでは、この設定が、費用と検索の中身の両方に関わる。
02 なぜ・背景 — 無料の試用から、費用の計算が必要な運用へ
料金の仕組み
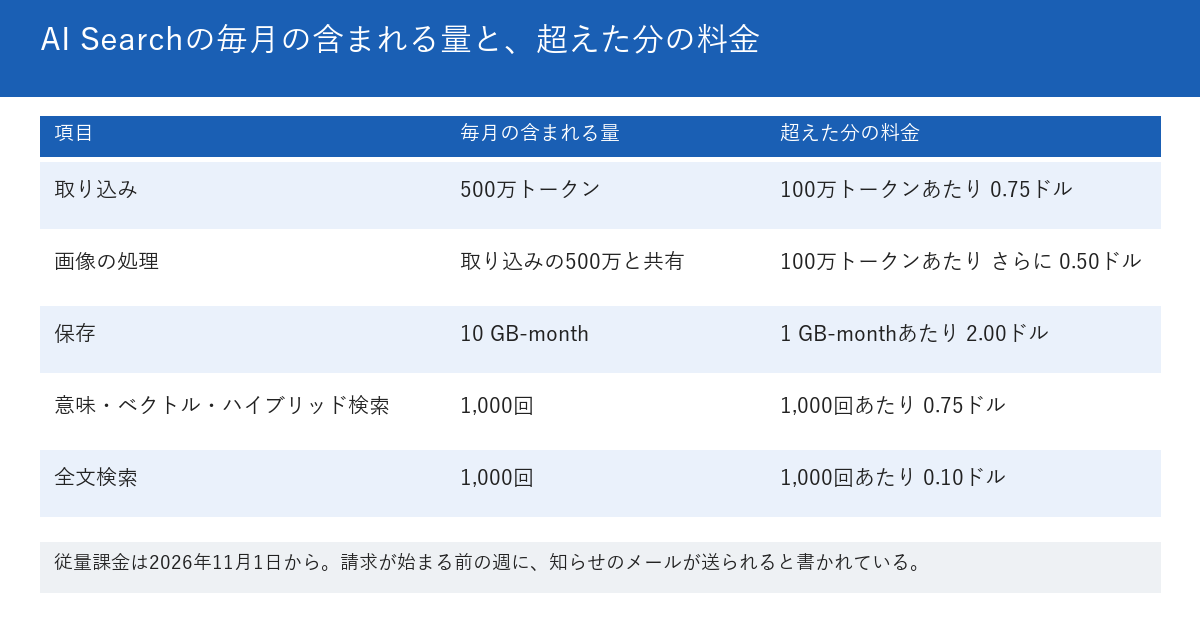
料金は、Limits & pricingのページ(2026年10月1日更新)に書かれている。毎月、すべてのアカウントに「含まれる量」があり、超えた分が従量課金になる。
| 項目 | 毎月の含まれる量 | 超えた分の料金 |
|---|---|---|
| 取り込み | 500万トークン | 100万トークンあたり0.75ドル |
| 画像の処理 | 取り込みの500万トークンと共有 | 100万トークンあたり、さらに0.50ドル |
| 保存 | 10 GB-month | 1 GB-monthあたり2.00ドル |
| 意味・ベクトル・ハイブリッドの検索 | 1,000回 | 1,000回あたり0.75ドル |
| 全文検索 | 1,000回 | 1,000回あたり0.10ドル |
ページは、請求の開始日を2026年11月1日と書いている。表の数字から、計算例を2つ作れる。意味検索だけを月に5,000回使った月は、含まれる1,000回を引いた4,000回が超過で、4,000 ÷ 1,000 × 0.75ドル=3.00ドルになる。全文検索だけを5,000回使った月は、4,000 ÷ 1,000 × 0.10ドル=0.40ドルになる。取り込みと保存の料金は、この計算に入っていない。
取り込みトークンの数え方
取り込みの料金は、トークンで数える。ページは、チャンクに分けたあとの文章を、cl100k_baseというトークナイザーで数えると書いている。隣り合うチャンクの重なりは、現れたチャンクごとに数えられる。画像やスキャンした文書のOCRは、読み取った文字も、画像の処理のトークンとして数える。
無料のプランにも、上限がある
同じページの上限の表には、Workers FreeとWorkers Paidの違いが載っている。たとえば、1つのアカウントのインスタンスの数は100と5,000、1つのインスタンスのファイルの数は100,000と100万(ハイブリッド検索なら50万)、1日に巡回できるページの数は500と無制限である。ウェブサイトの巡回は、これらの上限のいちばん小さい値で止まると、ページは説明している。
「検索」と「AIの回答」は別の仕事
引用の作り方のページは、AI Searchが、答えを作る前に、材料にする文章の断片(チャンク)を探して、答えと一緒に返すと書いている。検索の段階で外したページは、答えの材料にならない。逆に、検索の段階で載せたページは、答えの材料になりうる。何を載せるかを決めることが、答えの質と安全の両方に関わる。この記事の軸は、そこにある。
03 用語 — 取り込み、検索、回答の言葉を分けて読む
インスタンスとデータソース
用語
インスタンス:AI Searchで作る、1つの検索の単位である。データソース:インスタンスに読み込ませる元のデータで、公式のページは、直接アップロードする保存場所(built-in storage)、ウェブサイト、R2のバケットの3つを挙げている。
意味検索・全文検索・ハイブリッド検索
用語
意味検索:言い回しが違っても、意味が近い文章を見つける方式である。全文検索:検索語が文章の中にあるかで見つける方式である。ハイブリッド検索:その2つを並べて動かして、結果を合わせる方式で、公式のページは、既定で有効だと書いている。型番や固有名詞は全文検索が、言い換えは意味検索が見つけやすい、と一般には考えられている。
取り込みトークン
用語
取り込みトークン:取り込んだ文章を、チャンクに分けたあとで数えた単位である。文章が長いほど、チャンクが重なるほど、増える。公式のページは、自分の文章で見積もるには、cl100k_baseを扱えるツール(tiktokenなど)が使えると書いている。
OCR
用語
OCR:画像として保存された文字を、文字のデータに読み取る技術である。スキャンしたPDFは、文字を選べない画像になっていることが多いので、OCRなしでは、中身を検索の対象にできない。OCRの利用は、画像処理のトークンとして料金に数えられる。
公開エンドポイント
公式のページは、公開エンドポイントについて、次のように書いている。
"Configure public endpoints to expose your AI Search instance directly to users without requiring authentication."
(訳: 公開エンドポイントを設定すると、AI Searchのインスタンスを、認証を求めずに、利用者へ直接公開できる。)
この設定を有効にすると、インスタンスに取り込んだ内容は、誰でも検索できる状態になる。取り込む前に範囲を決める理由は、ここにある。
04 型別 — 自分のサイトがどれに当たり、何を、どの順で確かめるか
🅰 適用範囲 — ウェブサイトの取り込みは、Cloudflareにドメインを載せているサイトが対象になる
ウェブサイトのデータソースのページには、次の1文がある。
"You can only crawl domains that you have onboarded onto the same Cloudflare account."
(訳: 巡回できるのは、同じCloudflareのアカウントに登録したドメインだけである。)
Cloudflareにドメインを載せていないサイトは、ウェブサイトの取り込みを使えない。公式のページが挙げる残りの方法は、ファイルを直接アップロードする保存場所と、R2のバケットである。自社のサイトがどれに当たるかで、手順が変わる。
🅱 公式文書が書いていないこと
次のことは、確かめた範囲の公式文書には書かれていない。この記事も、断定しない。
- noindexを付けたページを、ウェブサイトの取り込みが、どう扱うか。
- ハイブリッド検索の1回が、意味検索の1回として数えられるのか、全文検索の1回も数えられるのか。
- 答えの正しさや、誤った答えが出る割合。
- 無料の含まれる量で、一般的なサイトの運用が、どこまで収まるか。
この記事が確かめていないこと
筆者はAI Searchのインスタンスを、この記事のために作っていない。当サイトのドメインを、Cloudflareに載せていないためである。画面の操作や、実際の取り込みの結果は確かめていない。書いたのは、公式のページの記載と、当サイトで確かめた内容である。
🅲 手順1 — 載せる範囲を、ページの種類で決める
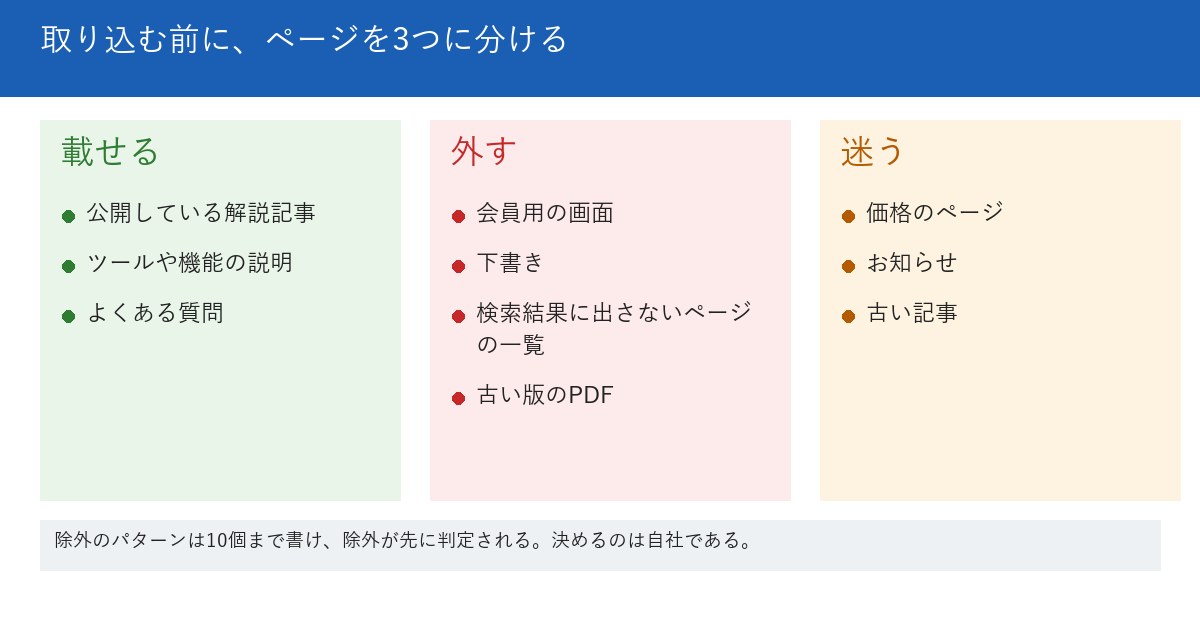
最初に、サイトのページを、種類ごとに分けて書き出す。公開の解説記事、ツールの説明、よくある質問、会員用の画面、下書き、検索結果に出さないページの一覧、PDFなどである。種類ごとに、「載せる」「外す」「迷う」のどれかを決める。公式のページは、除外と含めるのパターンを、それぞれ10個まで書けて、除外が先に判定されると説明している。
"Exclude rules take precedence over include rules."
(訳: 除外のルールは、含めるルールより優先される。)
パターンは、スキームとホスト名を含むURL全体に対して照らされる。公式のページの例では、**/blog/**のように、先頭に**を付ける形である。
🅲 手順2 — 載せてはいけないページが、入り込まないかを確かめる
会員用の画面や下書きなど、外すと決めたページのURLの共通部分を、除外のパターンとして書く。公式のページは、認証の見出しを送って、ログインの内側のページに巡回を通す設定(最大5つ)があると書いている。この設定を使わなければ、ログインの内側は取り込まれない前提で考えられる。使う場合は、そこに入ったページが、公開エンドポイントで誰にでも検索される可能性を、先に確かめる。公開エンドポイントでは、「許可する送信元」の設定は、ブラウザの制御であって、アクセスの制御ではないと、公式のページが注意している。
"Allowed origins are a browser control, not an access control."
(訳: 許可する送信元は、ブラウザの制御であって、アクセスの制御ではない。)
🅲 手順3 — PDFとファイルの上限を確かめる
PDFの本数と、サイズを書き出す。OCRなしのPDFとほかの形式は4 MiB、文章とコードのファイル、OCRを有効にしたPDFは10 MiBが上限である。上限を超えたファイルの扱いは、データソースのページが、次のように書いている。
"Files that exceed these limits are not indexed."
(訳: これらの上限を超えるファイルは、取り込まれない。)
取り込まれなかったファイルは、エラーログに出る、とも書かれている。つまり、検索の画面では、取り込まれなかったことが見えない。上限を超えるPDFが何本あるかを、先に数えておく。
🅲 手順4 — 答えの出典を、どう見せるかを決める
引用のページは、返ってきた断片に、元のファイルまたはURL(item.key)と、関連度の点数が付くと書いている。出典を画面に出すかどうかは、検索を組み込む側が作る部分である。出すと決めたら、出典のURLが、読者に見せてよいページか、今の内容かを、答えの検査の対象にする。
🅲 手順5 — 誤った答えが出たときの直し場所を決める
誤った答えは、どこかのページの内容が原因であることが多い。直し場所を、症状ごとに決めておく。
- 古い内容が答えに出る:元のページを直し、再取り込み(同期)を待つか、手で実行する。
- 外したいページが出る:除外のパターンを足し、再取り込みを行う。
- メニューや定型の文章が混じる:コンテンツセレクターで、本文の部分だけに絞る。公式のページは、設定がなければ、header・footer・headを除いて取り込むと書いている。
再取り込みの間隔は、初期値が6時間で、15分から24時間の範囲で選べる。同期の実行は、30秒に1回までと書かれている。更新が多いサイトは、間隔を短くする。
"Jobs run automatically on a schedule, every 6 hours by default, and process new, modified, or deleted files to keep your search index up to date."
(訳: ジョブは、既定で6時間ごとの予定で自動的に実行され、検索の索引を最新に保つために、新しいファイル、変更されたファイル、削除されたファイルを処理する。)
🅲 手順6 — 費用の見張り方を決める
02章の表で、月の検索回数の見込みから、金額を計算する。生成や質問の言い換え、外部のモデルの利用は、AI Searchの料金に含まれず、自分のアカウントとゲートウェイに記録される、と投稿に書かれている。AI Searchの料金だけを見て、全体の費用を決めない。
05 自分のサイトで確認するチェックリスト
下の14項目は、1項目5分ほどでできる作業である。項目6は、手順に入る前の🅰「適用範囲」にあたり、自社のサイトが、ウェブサイトの取り込みを使えるかを決める作業である。項目1〜5が手順1と2、項目7と8が手順3、項目9が手順6、項目10が手順4、項目13と14が手順5に対応している。項目11と12は、手順1で「載せる」の範囲を決めたあとに行う作業で、今のサイト内検索の検索語を、その範囲と照らす。サイト内検索の導入を決めていない人も、項目1〜5は、今日から使える。チェックの状態はブラウザの中にだけ保存され、サーバーには送られない。
- サイトのページを種類ごとに5種類以内に分けて書き出し、種類ごとのページ数を数字で書く
- サイトマップを開き、URLの数と、lastmodが付いていないURLの数を数えて書く
- 検索結果に出したくないページ(会員用、下書き、noindexの一覧)のURLの共通部分を、3つまで書き出す
- 項目3の共通部分を、
**/名前/**の形の除外のパターンに書き直し、10個以内に収まるかを数えて書く - robots.txtを開き、巡回を止めている道筋を書き出して、項目3の共通部分との食い違いがあるものを、1つずつ照らして書く
- 自社のドメインをCloudflareに載せているかを、「はい」か「いいえ」で書き、「いいえ」なら、ウェブサイトの取り込みは使えないと書き足す
- サイトのPDFの本数を数え、そのうち4 MiBを超えるものと、10 MiBを超えるものの本数を、それぞれ書く
- PDFのうち、文字を選べないもの(スキャンしたもの)を3本まで開いて確かめ、その本数を書く
- 検索の回数の見込みを、月の数字で1つ書き、含まれる1,000回を引いた回数に、1,000回あたり0.75ドルをかけた金額を書く
- 答えの出典を、ページの題名で示すか、アドレスで示すかを決めて、「題名」か「アドレス」で書く
- サイト内検索で、いま多く使われている検索語を10件書き出し、それぞれに、答えるべきページのURLを1つずつ書く
- 項目11の10件のうち、答えるべきページが、項目1で決めた「載せる」の範囲に入っていないものの数を、数えて書く
- 誤った答えが見つかったときに、元のページを直す担当者と、再取り込みを実行する担当者の名前を、それぞれ書く
- 再取り込みの間隔を、ページの更新の頻度に照らして、6時間・12時間・24時間のどれにするかを決めて書く
チェックリストの使い方
時間が限られているときは、項目2・3・11・12の4つだけでも、「サイトマップは整っているか」「載せないページは何か」「実際の検索語に答えられるか」が分かる。サイト内検索をすぐに導入しない場合も、項目11と12は、今のサイト内検索の改善にそのまま使える。
06 代替・他の選択肢 — AI Search以外にも、サイトの検索を良くする道がある
取り込みの方法を、比べる
| 方法 | 何を使うか | 向く場面 | 注意する点 |
|---|---|---|---|
| 今のサイト内検索を直す | 既存の検索と、検索語の記録 | 導入の費用や運用を、増やしたくないとき | 言い換えへの強さは、検索の仕組みによる |
| ウェブサイトの取り込み | サイトマップまたは巡回 | Cloudflareにドメインを載せているとき | 同じアカウントのドメインだけが対象 |
| ファイルのアップロード | built-in storage | Cloudflareに載せていないサイトの文書を使うとき | 更新のたびに、自分でアップロードする |
| R2のバケット | 保存した文書 | 文書をR2に置いているとき | サービスのトークンを保つ必要がある |
サイトマップで取り込むか、リンクをたどるか
ウェブサイトの取り込みには、2つの方式がある。サイトマップ方式は、サイトマップに書かれたURLだけを読み、リンクはたどらない。lastmodが変わったページを、次の同期で取り直すと、公式のページは書いている。リンクをたどる方式(discover)は、サイトマップとページのリンクの両方を使い、lastmodは使わない。サイトマップが整っているなら、公式のページは、サイトマップ方式のほうが確実だと勧めている。
実務のヒント
導入の前に、今のサイト内検索で、検索語の上位10件に答えられているかを確かめる。答えられない原因が、ページの不足なのか、載せ方なのかが分かれば、AIに任せる前に直せるものがある。
注意
公開エンドポイントは、認証なしで公開される。取り込んだ内容は、誰でも検索できると考えて、範囲を決める。限定した相手にだけ見せたい場合は、公式のページが挙げるCloudflare Accessなど、アクセスの制御を別に用意する。
自社のサイトの状態を、先に確かめるツール
サイトマップを作り直したいときは、当サイトの無料ツール🔧 WEBサイトの sitemap.xml 作成ツールが使える。取り込みの元になるページが、リンク切れになっていないかは、🔧 WEBサイト内のリンク漏れ・チェックツールで確かめられる。どちらも、AI Searchを使うためのツールではなく、取り込みの前に整えておくための道具である。
noindexとrobots.txtの違いは、noindex・nofollow・robots.txtは、それぞれ何を止めているのか ── 混同しやすい3つの設定を確認する15項目で扱い、AIのクローラーごとの通し方は、AIクローラーは1つではない ── robots.txt・llms.txtで「通す」「止める」を切り分ける(2026年9月時点)で扱った。サイトマップの上限は、サイトマップには「50,000 URL・50MB」という上限がある ── 分割とインデックス化を確認する13項目(2026年9月時点)で扱っている。この記事は、それらの内容を繰り返さない。
07 当サイトで確かめたこと
当サイトは、Cloudflareの背後にない
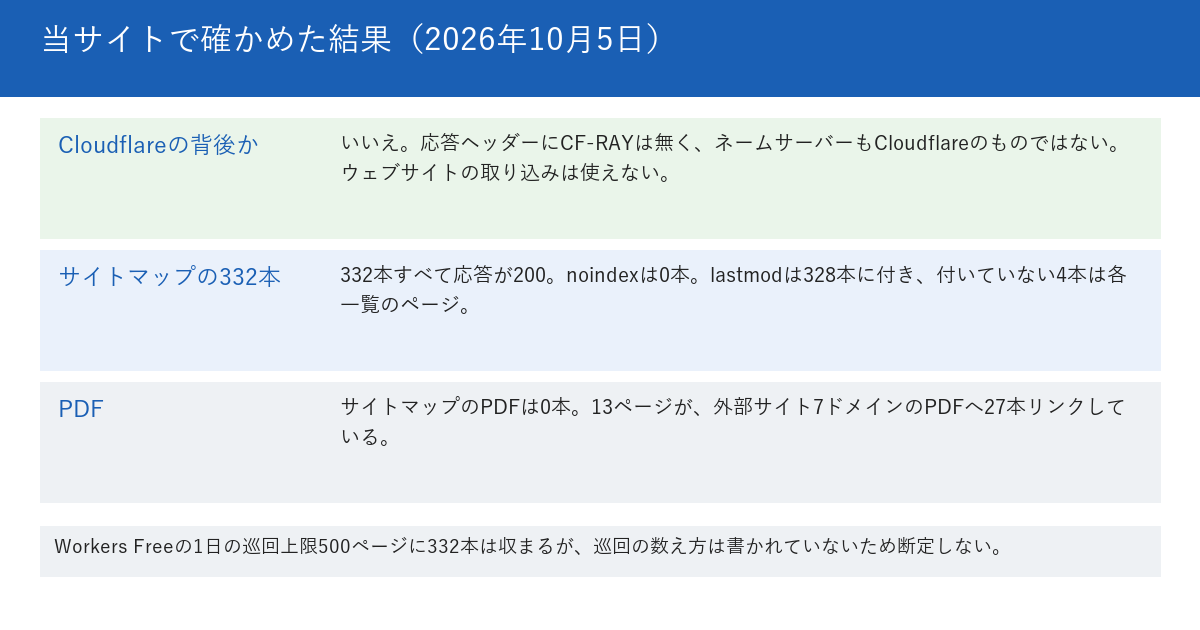
2026年10月5日に、当サイトのホームページの応答ヘッダーを取得した。Cloudflare経由の応答に付くはずの識別の見出し(CF-RAY)は付いていなかった。ドメインのネームサーバーも、Cloudflareのものではなかった。当サイトは、ウェブサイトの取り込みを使えない。この記事のインスタンスを作らなかった理由も、そこにある。
そこで、仮にサイトマップから取り込むなら、どんな状態かを、当サイトのサイトマップで確かめた。
サイトマップの332本を、全部取得した
サイトマップには、332本のURLがあった。332本すべてを取得して調べた結果は、次のとおりである。
- 応答は、332本すべてが200だった。
- robotsのmetaタグまたはX-Robots-Tagにnoindexがあるページは、0本だった。
- lastmodが付いているURLは328本で、付いていないのは4本だった。4本は、ツール・ブログ2種類・解説記事の、各一覧のページである。
- priorityとchangefreqは、332本すべてに付いていた。
noindexのページは、サイトマップには含めていない。タグの一覧のページを2つ開いて、2つともnoindex,followであること、サイトマップに無いことを確かめた。サイトマップ方式なら、これらは取り込まれない。一方、リンクをたどる方式は、ページのリンクもたどるので、タグの一覧のページに届きうる。noindexのページを、取り込みが避けるかどうかは、書かれていないので、方式の選び方が、取り込む範囲を変えうる。
PDFと、robots.txt
サイトマップのURLのうち、PDFのものは0本だった。ページの中のリンクを調べると、332ページのうち13ページが、PDFへのリンクを合計27本含んでいた。27本はすべて、外部のサイトのPDF(7つのドメイン)で、当サイトが配っているPDFは、確かめた範囲では見つからなかった。robots.txtには、管理用や会員用の道筋などを巡回の対象から外す行が、13行ある。
無料のプランの1日の上限と、332ページ
02章の上限の表では、Workers Freeの「1日に巡回できるページ」は500である。当サイトのサイトマップの332本は、この数字の範囲に収まる。ただし、巡回の数え方(ページが読み込む別のファイルを数えるかなど)は、確かめた範囲の文書に書かれていないので、収まると断定はしない。
この結果から言えることと、言えないこと
言えるのは、当サイトのサイトマップが、noindexのページを含まず、ほぼすべてにlastmodが付いていること、PDFを自分では配っていないことである。言えないのは、AI Searchが、当サイトを取り込んだときの結果である。インスタンスを作っていないためである。載せる範囲を決める材料が、すでに手元にあるかは、サイトマップとrobots.txtを開けば、数分で分かる。
08 このテーマの、これまで
AI Searchをめぐる、日付つきの記録
| 日付 | 出来事 |
|---|---|
| 2026年8月6日 | ウェブサイトのデータソースのページと、公開エンドポイントのページが、この日付で最終更新 |
| 2026年9月17日 | ウェブサイトの巡回の方式(parse types)とコンテンツセレクターのページが、この日付で最終更新 |
| 2026年10月1日 | AI Searchが一般提供になった。同日、Limits & pricing・データソース・ハイブリッド検索・同期のページが更新された |
| 2026年11月1日 | 従量課金が始まる予定(変更履歴の記載)。請求が始まる前の週に、知らせのメールが送られると書かれている |
| 2026年10月5日 | この記事のために、変更履歴と公式ページを開き、当サイトのサイトマップとrobots.txtを確かめた |
導入の費用が実際にいくらになるかは、この表のどの行にも含まれていない。含まれる量と単価が分かっても、検索の回数は、サイトごとに違うためである。
当サイトの、関連する過去の記事
- 「リンク切れ0本」を確認して、安心しかけた ── 自社ブログの内部リンク、59.2%はnoindexへの飛び先だった — リンク切れを確かめたら、飛び先の多くがnoindexだった記録。
- 外から取った画面は、目当ての画面とは限らない ── 遮断の画面を404と読み、引用符の違いでnoindexを「無い」と読みかけた — 外から取った画面が、目当ての画面とは限らなかった話。
- llms.txt が v2 になった日 ── 200 が返ることと、対応していることは別だった — 応答が200でも、対応しているとは限らなかった記録。
- Googleが「やるな」と言ったGEO施策 — chunking・llms.txt量産・FAQスパムが非推奨になった公式情報の整理 — Googleが「やるな」と言った、AI向けの施策の整理。
- なぜあなたの記事はAIに"見えない"のか — 1つの検索が12に分裂するFan-Outの衝撃 — 記事がAIの検索から見えなくなる理由を、1つの検索が複数に分かれる仕組みから整理した記録。
現在の貴方のIPアドレス
このサイトで書いている人