WEBサイト
JSON-LDのHTMLエスケープは、1回しか解除されなくなった ── 自分のサイトに二重エスケープが残っていないか確認する13項目(2026年9月時点)
JSON-LDのHTMLエスケープは、1回しか解除されなくなった ── 自分のサイトに二重エスケープが残っていないか確認する13項目(2026年9月時点)
目次
01 何が起きたか/いま最新版は何か
Google Search Centralが「HTMLのエスケープ解除は1回だけ」と投稿した
2026年8月21日、Google Search Centralの公式LinkedInアカウントが、構造化データ(JSON-LD)の取り出し方を変えたと投稿した。投稿日は、Search Engine RoundtableのBarry Schwartz氏の記事に書かれた日付に従っている。筆者が開いたLinkedInのページには「1か月前」としか表示されておらず、日付そのものは確かめられなかった。投稿の一文は次のとおりだ。
"To bring our parser up to JSON and other standards, we changed our JSON-LD extraction and are now only applying a single pass of HTML unescaping."
(訳: 私たちのパーサーをJSONなどの標準に合わせるため、JSON-LDの取り出し方を変更し、現在はHTMLのエスケープ解除を1回だけ行っている。)
ここでいう「HTMLのエスケープ解除」とは、&や<のように、文字を別の書き方で表したものを元の文字に戻す処理のことだ。変更後は、この「戻す」処理が1回しか行われない。何回戻していたのかという細部は、投稿の文面には書かれていない。
報じられている影響 ── 二重に変換された文字が、そのまま残る
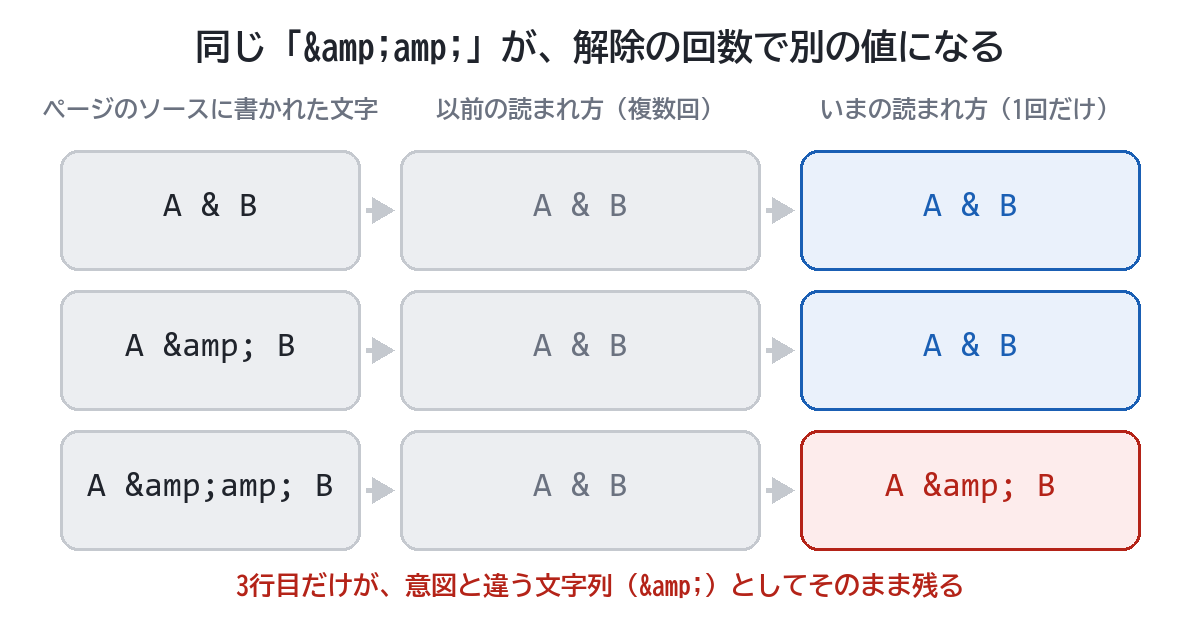
報道によれば、以前のGoogleは、二重に変換された文字も結果的に元へ戻して読んでいた。たとえばページのソースに&amp;と書かれていても、最終的には「&」として扱われていた。変更後は戻す処理が1回で止まるため、&amp;は&という文字列のまま残る。意図した値は「&」なのに、読まれる値は「&」になる。同じ報道は、数字を使った書き方を二重にした形(&#10004;のような形)も、元の文字に戻らずそのまま残ると伝えている。
公式ドキュメントには、この変更の記載が見つからなかった
2026年9月29日に、Googleの構造化データの入門ページ(最終更新2025年12月10日)と、構造化データの一般ガイドライン(最終更新2026年7月10日)の2ページを開いて確認した。どちらにも、JSON-LDのエスケープの扱いを説明した記述は見つからなかった。筆者が確認できた公式の情報は、上のLinkedInの投稿1件だけだ。
報道は、投稿に続けてGoogleが「標準のJSONエスケープか、Unicodeの16進数エスケープ(\u0026のような形)に更新してほしい」と案内したと伝えている。また、Googleのゲイリー・イリーズ氏がJSONの仕様(RFC 8259)の第7節を参照したとも報じられている。筆者が開けたLinkedInの表示では最初の一文しか確認できなかったため、この案内は「報じられている内容」として扱う。
注意
「この変更で順位が下がる」「リッチリザルトが一斉に消える」と断言する解説を見かけることがある。公式の投稿が述べているのは、取り出し方を変えた、という点だけだ。影響を受けたサイトの数や、実際に表示が変わった機能の一覧は、筆者が確認した範囲では公表されていない。
出典
本記事の引用文は、2026年9月29日にGoogle Search CentralのLinkedIn投稿、Search Engine Roundtableの記事、Googleの公式ドキュメント、RFC 8259、MDN、PHPマニュアルの該当ページを開いて確認したものです。ページは今後更新される可能性があるため、実際に使う際は最新のページを直接開いてください。
02 なぜ・背景
JSON-LDは、HTMLの中に置かれた「データの塊」だ
Googleの公式ドキュメントは、JSON-LDを次のように説明している。
"A JavaScript notation embedded in a <script> tag in the <head> and <body> elements of an HTML page."
(訳: HTMLページの<head>要素と<body>要素の中の、<script>タグに埋め込まれたJavaScriptの記法。)
ブラウザの側から見ると、この<script>は実行される命令ではなく、ただのデータだ。MDNは、JavaScript以外の種類を指定した<script>について「埋め込まれた内容はデータのブロックとして扱われ、ブラウザは処理しない」と説明している(原文: "The embedded content is treated as a data block, and won't be processed by the browser.")。画面には何も表示されないので、中身に誤りがあっても、ページを見ているだけでは気づけない。
「HTMLのエスケープ」と「JSONのエスケープ」は、別の仕組みだ
JSON-LDのブロックには、2つの言語の決まりが同居している。1つはHTMLの決まりで、「&」を&と書く形がこれにあたる。もう1つはJSONの決まりで、バックスラッシュから始まる書き方がこれにあたる。JSONの仕様であるRFC 8259の第7節は、エスケープが必須の文字を次のように定めている。
"All Unicode characters may be placed within the quotation marks, except for the characters that MUST be escaped: quotation mark, reverse solidus, and the control characters (U+0000 through U+001F)."
(訳: すべてのUnicode文字は引用符の中に置いてよい。ただし、必ずエスケープしなければならない文字は除く。引用符、バックスラッシュ、制御文字(U+0000からU+001F)である。)
この一覧に、「&」は入っていない。JSONとしては、「&」はそのまま書いてよい文字だ。一方で、どの文字も\u0026のような形で書き表すことはできる。HTMLの&は、JSONの側から見れば、ただの文字の並びにすぎない。
二重エスケープは、担当の部品が2つあるときに起きる
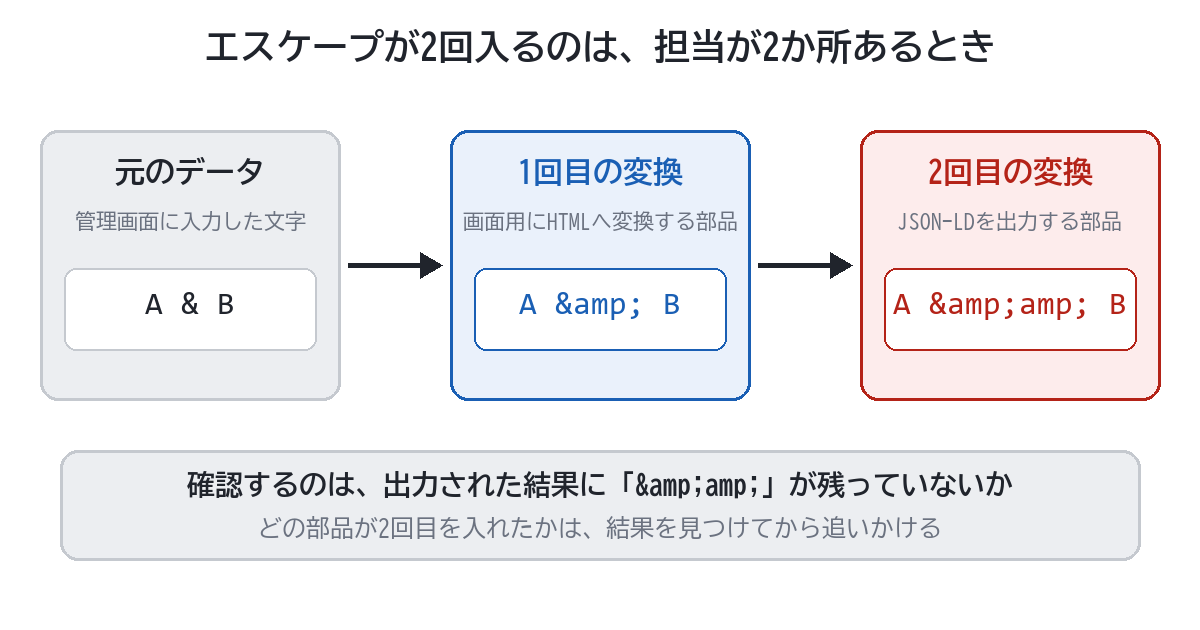
ここから先は、筆者が測った事実ではなく、一般的な仕組みの説明だ。管理画面で「A & B」と入力した文字は、保存されるときか、画面に出るときに、HTML用に変換されることが多い。その変換済みの値を、JSON-LDを出力する部品が受け取ってさらに変換すると、変換が2回かかる。
以前は見逃されていた、と報じられている
報道が伝える「以前の読まれ方」が正しいなら、二重になっていても、Googleが元の文字に戻してくれていた。ページを見ている人にも、検索結果にも、目に見える不具合は出ない。誤りが在っても、誰も気づく機会がなかったことになる。
順位が下がる、とは書けない。書けるのは「値が違って読まれる」まで
この変更で確かに言えるのは、二重に変換された文字が、意図と違う文字列として読まれうる、という点までだ。たとえば会社名が「A & B」のはずが、構造化データの上では「A & B」になる、という形になる。順位にどう響くかは、公式の投稿には書かれていない。リッチリザルトの名前欄や説明欄に、意図しない文字列が出る可能性は考えられるが、それが起きたサイトの数は公表されていない。
実務のヒント
JSON-LDの中で、閉じタグを表す文字列が途中に混ざることを避けたい場合、「<」を<ではなく\u003Cと書くのがJSON側のやり方だ。PHPのjson_encode関数には、そのためのJSON_HEX_TAGという指定がある。HTMLの書き方で解決しようとしないことが、二重を避ける近道になる。
03 この記事に出てくる用語
この記事で使う3つの言葉
用語
HTMLエスケープ(文字参照):「&」「<」「>」「"」のような、HTMLの中で特別な意味を持つ文字を、別の書き方で表す決まり。「&」なら&と書く。数字を使って表す書き方もある。ブラウザは、HTMLの本文に書かれたこの形を元の文字に戻して表示する。
用語
JSONのエスケープ:JSONの文字列の中で、引用符やバックスラッシュなどを表すための決まり。バックスラッシュから始める。\"は引用符、\\はバックスラッシュ、\nは改行、\u0026は「&」を表す。決まりはRFC 8259の第7節にある。
用語
二重エスケープ:すでに変換された文字を、もう一度変換してしまい、&amp;のような形になった状態。1回だけ元に戻す読み方では、最後まで戻りきらず、途中の形が残る。
似ている言葉の区別
本記事では、&の形はHTMLエスケープ、バックスラッシュから始まる形はJSONエスケープと呼び分ける。同じ「&」を表す書き方が2種類あり、どちらの決まりで書くかを取り違えると、二重になる。
04 型別に見る、確認すべき範囲と手順
適用範囲 ── どのサイトが対象になりうるか
JSON-LDを出しているサイトは、原則として対象になりうる。中でも確認の優先度が高いのは、次の3つの形だ。管理画面から会社名や記事タイトルを入力し、それをテンプレートがJSON-LDに組み込むサイト。テーマやプラグインがJSON-LDを自動で出力しているサイト。複数の部品がそれぞれ値を加工してから渡しているサイト。「自分は手書きしていない」というサイトほど、どの部品が変換しているかを知らないので、確認する意味が大きい。
対象になりにくいケース
Googleが対応する構造化データの形式は、JSON-LD・Microdata・RDFaの3つだ(公式ドキュメントの原文: "In order to be eligible for rich results, mark up your site's pages using one of three supported formats:"。この後に「JSON-LD (recommended)」「Microdata」「RDFa」が並ぶ。訳: リッチリザルトの対象になるには、サイトのページを、次の3つの対応形式のうち1つでマークアップする。JSON-LD(推奨)、Microdata、RDFa)。今回の投稿が述べているのはJSON-LDの取り出し方であり、Microdata・RDFaへの言及は、筆者が確認した範囲では見当たらなかった。また、JSON-LDの中に「&」や引用符を含む文字がひとつもなければ、二重エスケープの入り込む余地は小さい。
この報道が測っていないこと
今回の変更について、報道や公式の投稿から分からないことがある。
- 影響を受けたサイトの数や割合
- どのリッチリザルトの機能で、実際に表示が変わったのか
- Google以外の検索エンジンや、AI検索の取り出し方がどうなっているのか
- Googleの内部で、どの段階で解除が行われているのか
本記事の後半で、当サイトのページを数えた結果を載せる。その数え方は、公式が説明した「1回だけ解除する」を手元で真似た簡易版であり、Googleの内部処理そのものを再現したものではない。
手順1 ── ページのソースで数える
最初にやるのは、自分のページのソースの中で、二重の形が何件あるかを数えることだ。ブラウザでページを開き、ページのソースを表示して(Windowsなら Ctrl+U)、検索欄にapplication/ld+jsonと入れると、JSON-LDのブロックの位置が分かる。その中を&amp;で検索して件数を控える。0件なら、この種類の二重エスケープは見つからなかったことになる。
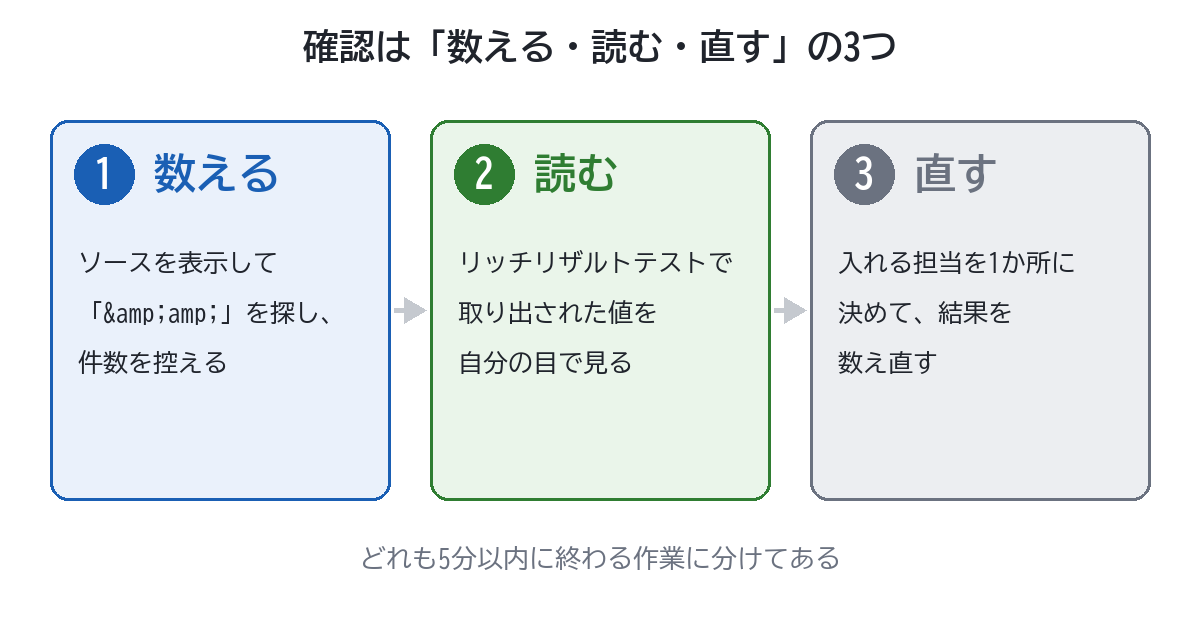
検索する形は「&amp;」の1つでは足りない。数字を使った書き方の二重(&#で始まる形)や、引用符・不等号の二重(&quot;、&lt;、&gt;)も同じ仕組みで起きる。ソースの検索では、この4種類を、JSON-LDのブロックの中に限って数える。ブロックの外の本文にHTMLエスケープが在るのは、正しい書き方だからだ。
手順2 ── リッチリザルトテストで、取り出された値を目で見る
ソースを数えただけでは、Googleがどう読んだかは分からない。そこで、リッチリザルトテストで同じページを開く。Googleの公式ドキュメントは、テストの役割を次のように書いている。
"You can test compliance with technical guidelines using the Rich Results Test and the URL Inspection tool, which catch most technical errors."
(訳: 技術ガイドラインへの適合は、リッチリザルトテストとURL検査ツールで確認できる。これらはほとんどの技術的エラーを見つける。)
この2つは、エラーの有無を見つけるための道具だ。今回のように、エラーにはならず値だけが違う場合は、検出された項目の名前欄や説明欄の文字を、画面に見えている表記と自分の目で比べる必要がある。エラーが0件でも、値が違って読まれている可能性は消えない。
手順3 ── 文字ごとの書き方を決める
JSON-LDに書く文字を、どのエスケープで書くかを整理すると、次の表のようになる。右端の列は、二重になってしまう典型的な形だ。
| 表したい文字 | 必ずエスケープが要るか(RFC 8259) | 安全な書き方 | 二重になった形 |
|---|---|---|---|
| 引用符(") | 要る | \" | &quot; |
| バックスラッシュ(\) | 要る | \\ | — |
| 改行などの制御文字 | 要る | \n など | — |
| アンパサンド(&) | 要らない(そのまま書いてよい) | & または \u0026 | &amp; |
| 小なり(<) | 要らない(閉じタグ対策で\u003Cも使える) | < または \u003C | &lt; |
PHPのjson_encode関数には、この書き分けのための指定がある。PHPマニュアルは、JSON_HEX_AMPを「All & are converted to \u0026.(すべての&が\u0026に変換される)」、JSON_HEX_TAGを「All < and > are converted to \u003C and \u003E.(すべての<と>が\u003Cと\u003Eに変換される)」と説明している。JSONの側の変換はJSONの道具に任せ、HTMLの変換をJSONの値にかけない、というのが基本の形だ。
たとえば次のように書く。元の文字のまま渡し、HTML用の変換をかけずにJSONへ書き出す例だ(筆者のサーバーのPHPで出力を確かめた)。
$data = ['name' => 'A & B <b>'];
echo json_encode($data, JSON_HEX_TAG | JSON_HEX_AMP | JSON_UNESCAPED_UNICODE);
// 出力: {"name":"A \u0026 B \u003Cb\u003E"}
出力の「&」は\u0026に、「<」「>」は\u003Cと\u003Eに書き換わっている。1回解除したあとの値は「A & B <b>」に戻る。HTMLの&をここで自分の手で足さないことが、二重を避ける書き方になる。
直し方は「変換を入れる担当を1か所にする」が基本
これは公式が示した手順ではなく、一般的な考え方だ。二重の原因は、変換を入れる担当が2か所以上あることだ。JSON-LDを出力する部品が値を受け取るとき、その値がすでにHTML用に変換済みかどうかを確かめる。変換済みなら、JSON側でもう一度HTML用に変換する処理を外す。担当を決めたあとは、必ずソースを数え直す。直したつもりの部品と別の部品が、同じ値をまた変換していることがあるからだ。
05 明日確認できるチェックリスト
チェックリストの狙い
以下は、01章から04章の内容を、実際に手を動かして確認するための13項目だ。前半は自分のページのソースと、Googleが取り出した値の確認、後半は原因の部品を特定して直し、結果を記録する内容になっている。チェックの状態はブラウザ内にのみ保存され、サーバーには送信されない。
- トップページを開いてページのソースを表示し、「application/ld+json」で検索して、JSON-LDのブロックが何個あるか数える
- JSON-LDのブロックの中を、&amp;で検索して、何件あるか数える
- JSON-LDのブロックの中を、&#で検索して、何件あるか数える
- JSON-LDのブロックの中を、&quot;・&lt;・&gt;で検索して、3つの件数を足す
- 会社名や商品名の中に「&」を含むページを1つ選び、その名前がJSON-LDの中でどう書かれているか目で確認する
- そのページをリッチリザルトテストで開き、検出された項目の名前欄が、画面に見えている表記と同じか確認する
- 同じページの説明欄でも、名前欄と同じ確認をして、文字化けや余計な記号が混ざっていないか確認する
- 記事ページ・商品またはサービスのページ・トップページから1つずつ選び、1番目から4番目を繰り返す
- JSON-LDの中に\u0026が何件あるか数え、1件を選んで、表示されるべき文字と合っているか確認する
- JSON-LDを出している部品を、CMS本体・テーマ・プラグインのうち、管理画面の名前で3つ以内に絞って書き出す
- 書き出した部品ごとに、管理画面で「エスケープ」または「サニタイズ」に関する設定があるか、設定画面を検索して確認する
- 見つかった件数と、疑わしい部品の名前を、1枚のメモに書き出す
- 直したあとで、同じ3ページについて1番目から4番目をもう一度数え、件数が0になったか確認する
項目の内訳と、かかる時間の目安
- 1〜4番目(4項目):ソースで二重の形を数える。目安は8分
- 5〜7番目(3項目):取り出された値を目で確認する。目安は7分
- 8〜9番目(2項目):ページの種類を広げて確認する。目安は6分
- 10〜11番目(2項目):原因の部品を絞る。目安は8分
- 12〜13番目(2項目):記録して、直したあとに数え直す。目安は10分
13項目すべてに目を通した場合の時間の目安は合計39分程度だ。1番目と2番目だけなら、1分もかからない。
何から手を付けるか
JSON-LDを自分で書いておらず、どの部品が出しているかも分からない場合は、1番目から4番目を先に済ませる。件数が0なら、まず安心してよい。1件でも見つかった場合は、5番目から7番目で、その値がGoogleにどう読まれているかを確認し、それから10番目以降の原因の絞り込みに進むとよい。0件だったサイトでも、ページの種類を変えて8番目を1回は行う。
06 代替・他の選択肢の比較
確認する手段は1つではない
二重エスケープを見つける方法は、1つの道具に限らない。ソースを直接数える方法、Googleが取り出した値を見る方法、公開後のURLをGoogleがどう見たかを確認する方法で、分かることが違う。
| 手段 | わかること | 費用 | 備考 |
|---|---|---|---|
| ページのソース表示と検索 | 出力されたJSON-LDに、二重の形が何件あるか | 無料 | Googleが取り出した値までは分からない |
| Rich Results Test | Googleが検出した項目と、その値 | 無料 | URLを入れる方法と、コードを貼る方法がある |
| URL検査ツール(Search Console) | 公開済みのURLを、Googleがどう見たか | 無料 | 所有権の確認が済んだサイトで使う |
| Schema Markup Validator | schema.orgの文法として正しいか | 無料 | Googleの表示可否とは別の確認になる |
| 🔧 コウゾウ(構造化データ自動作成ツール) | JSON-LDのたたき台を作成できる | 無料 | 出力後のエスケープの確認は、上の手段で行う |
| 🔧 WEBサイト総合分析・レポートツール | ページ全体の状態をまとめて確認できる | 無料 | 二重エスケープの確認そのものは、上の手段で行う |
6つの使い分け
この表が示すのは、ソースを数える方法と、Googleの取り出し結果を見る方法は、どちらも代わりにならないという点だ。ソースには二重の形があるのに、Googleの表示は正常に見えることもある。逆に、ソースが正しくても、別の部品が後から書き換えていることもある。05章のチェックリストの1〜4番目は表の1行目、5〜7番目は2行目と3行目を使うように組んである。
JSON-LDの代わりに、MicrodataやRDFaで書く場合
二重エスケープの話を読むと、JSON-LDをやめてMicrodataやRDFaにすれば済むのでは、という疑問が出る。Googleの構造化データの入門ページは、3つの形式の位置づけを次のように書いている。
"all 3 formats are equally fine for Google, as long as the markup is valid and properly implemented per the feature's documentation."
(訳: マークアップが有効で、機能のドキュメントに従って正しく実装されている限り、3つの形式はどれもGoogleにとって同じように問題ない。)
同じページは続けて、「サイトの構成が許すなら、JSON-LDの使用を推奨する。ウェブサイトの所有者にとって、大規模でも実装・保守しやすい方法だからだ(言い換えると、利用者のミスが起きにくい)」と説明している(原文: "Google recommends using JSON-LD for structured data if your site's setup allows it, as it's the easiest solution for website owners to implement and maintain at scale")。
3つの形式を比べる
| 観点 | JSON-LD | Microdata | RDFa |
|---|---|---|---|
| Googleの扱い | 推奨。3形式とも対応 | 対応 | 対応 |
| どこに書くか | headとbodyの中の、scriptタグの中 | HTMLのタグの属性。主にbodyで使い、headでも使える | HTMLのタグの属性。headとbodyの両方でよく使われる |
| 今回の二重エスケープの影響 | 受ける。JSONの中の文字列として、HTMLエスケープの解除が1回だけ行われて読まれる | 今回の投稿にMicrodataへの言及は見つからなかった。属性値なので、HTMLの通常のエスケープの規則で書く | Microdataと同じ。言及は見つからなかった |
| 保守のしやすさ | Googleは、最も実装・保守しやすい形式と説明している。画面に見える文章とは絡み合わない | 画面に見える文章のタグに属性を付けるため、文章とマークアップが同じ場所にある | Microdataと同じ。見える内容に対応する属性を付ける |
メリットとデメリット、そして形式を変えれば解決とは言えない理由
JSON-LDのメリットは、Googleの説明どおり、見える文章とマークアップが絡み合わず、入れ子のデータも書きやすいことだ。後から挿入されたJSON-LDも読めると書かれている。デメリットは、今回のように取り出し方が変わると、影響を受ける形式だという点だ。MicrodataとRDFaは見える内容と同じ場所に属性を付けるので、文章を書き換えるたびに、属性の側も見直す必要がある。
ただし、形式を変えれば解決する、という話ではない。今回の変更が述べているのはJSON-LDの取り出し方であり、確認すべきなのは、JSON-LDの中の文字列を標準の書き方で正しく出力できているかどうかだ。筆者はMicrodataとRDFaの読み取りが実際にどう動くかまでは確かめていないので、形式の乗り換えは、この記事の確認項目の代わりにならない。
07 当サイトの状況
何を、どうやって数えたか
当サイトのJSON-LDに、二重の形が残っていないかを2回に分けて数えた。1回目は2026年9月29日12時51分に、トップ・ブログ一覧・記事一覧・ツール一覧・ブログ記事6本・SEO記事6本・ツール3本の合計19ページを対象にした。それぞれのページのソースからJSON-LDのブロックを取り出し、HTMLのエスケープを1回だけ解除してからJSONとして読み、中の文字列の値を1つずつ確かめた。アクセスには、当サイト自身であることが分かる名前を付けている。2回目は同じ日の13時台に、サイトマップに載っている全297URLを取得して、同じ考え方で数えた。
数えた結果
1回目の19ページでは、ブロックが55個、中の文字列が2,588個あり、JSONとして読めなかったブロックは0個だった。2回目のサイトマップ全297URLでは、ブロックが881個あり、881個すべてがJSONとして読み込めた。取得のエラーは0件だった。
肝心の二重の形は、どちらの回も0件だ。ブロックの中の&amp;は0件で、引用符や不等号などの二重の形も0件だった。2回目では、HTMLエスケープの形(&や"、<、数字を使った形)そのものが、ブロックの中に1件もなかった。数え方が壊れていないことを確かめるため、どちらの回も先に、二重の形を入れたダミーの文字列で試し、見つかることを確認している(1回目は二重の形が2つ入ったダミーで2件、2回目は1つ入れたダミーで1件が検出された)。
一方で、JSON側の書き方である\u0026は、1回目の19ページのうち、ツール一覧とFAQ作成ツールの2ページに合計11件あった。「FAQ(Q&A)」のように「&」を含む名前で、1回解除したあとの値は意図どおりの「&」だった。当サイトのブログでは、本番公開のあとの確認でも、ページ内に&amp;が0件かを毎回数えている。
この結果から言えないこと
今回の数え方には限界がある。2回目に数えたのはサイトマップに載っている297ページだけで、noindexにしているページと会員ページは数えていない。管理画面の中も含まれない。また、手元で再現したのは公式が説明した「1回だけ解除する」の簡易版で、Googleが実際にどう読んでいるかは確かめていない。297ページで0件だったことは、数えていないページでも0件であることを保証しない。
08 このテーマの、これまで
「0件」の書き方は、以前も問題になった
今回の確認で「0件だった」と書けるのは、探した範囲の中での話だ。この点は、以前の記事で繰り返し扱ってきた。探した数を書かずに「0件」と書いた反省は「0件」に、探した数を書いていなかった ── 9種類で確かめた5日後、73種類で確かめ直したに、「0件」が安心を意味するとは限らないことは「0件」は安心ではない、「N件」は危険ではない ── 同じ1日に、サイトを調べる針が両方向に倒れたにまとめてある。
「出力は在るのに、値だけが違う」形は、他でも見た
ページの出力そのものは在るのに、値だけが意図と違っていた例は、出力は在った。だから誰も測らなかった ── datePublished・og:type・用語ハイライト・sitemapで見つけた4つの「値だけ違う」穴で扱った。二重エスケープも、出力は在るのに値が違って読まれるという点で、同じ形をしている。
合計や見た目だけで安心しなかった記録
毎朝の警告を種類別に数え直し、合計だけでは見えなかった中身を確かめた記録は毎朝の「警告1,415件」を、初めて種類別に数えた ── 96.7%は見なくていいもので、唯一の「本物」は自分で叩くまで分からなかったにある。リンク切れ0本という確認の、その先の段階を扱ったのは「リンク切れ0本」も「200が返る」も、まだ2段目だった ── 番号が変わるサイトで見つけた、リンクの3段目のずれだ。ログを行全体で探すと、正反対の2つが混ざる点は「AIからの流入60件」を数え直したら、60件ともAIが自分の名前を名乗った文字列だった ── ログを行全体で探すと、正反対の2つが混ざるで書いた。いずれも、1つの数字や1つの見た目だけで判断せず、中身の値を確かめるという点で、今回の確認とつながっている。
構造化データの記事との関係
構造化データは、書いただけでは表示が保証されないことを、FAQとHow-toのリッチリザルト廃止は、同じ時期の話ではなかった ── 自分のサイトの構造化データを確認する13項目(2026年9月時点)や構造化データは、構文が正しくても消えることがある ── 手動による対策の条件を確認する14項目で扱った。今回の二重エスケープは、そのさらに手前、値が意図どおりに読まれているかという段階の確認にあたる。
現在の貴方のIPアドレス
このサイトで書いている人