WEBサイト
URL検査ツールの「参照元ページ」は何を意味しているのか ── Googleがそのページを見つけた経路を確認する13項目(2026年9月時点)
URL検査ツールの「参照元ページ」は何を意味しているのか ── Googleがそのページを見つけた経路を確認する13項目(2026年9月時点)
目次
01 何が起きたか — URL検査ツールの「参照元ページ」欄が指しているもの
「参照元ページ」の公式な説明
Search Consoleの「URL検査ツール」には、検査したURLについて「参照元ページ」という項目が表示されることがある。この項目について、Search Console公式ヘルプは次のように説明している。「Google が検索対象の URL を見つけるのに使用した可能性のあるページの URL が表示されます。参照元ページは、このページに直接リンクしているページや、この URL にリンクしているページの 2 つまたは 3 つ上の階層にある親ページである場合があります」。つまり「参照元ページ」は、そのURLへ直接リンクしているページとは限らず、リンクをたどった先にある、さらに上の階層のページが表示されることもある。
表示のされ方が変わった、というブログの観察
本記事のきっかけになったブログ記事は、URL検査ツールの「参照元ページ」に関して、「以前は『検出されませんでした』という表示だったものが、最近は『情報を取得できませんでした』という表示に変わった」という趣旨の観察を記している。そのうえで、この変化はサイトのrobots.txtファイルの取得エラーと関係しているのではないか、という推測を示していた。この推測は、当サイトが確認した公式ヘルプのどのページにも裏付けとなる記述が見当たらなかった。表示文言の変遷は、URL検査ツールの画面そのものを継続的に観察しない限り検証できないため、本記事では「Yahoo SEO Googleというブログの観察・推測」として扱い、公式の確定情報とは区別する。
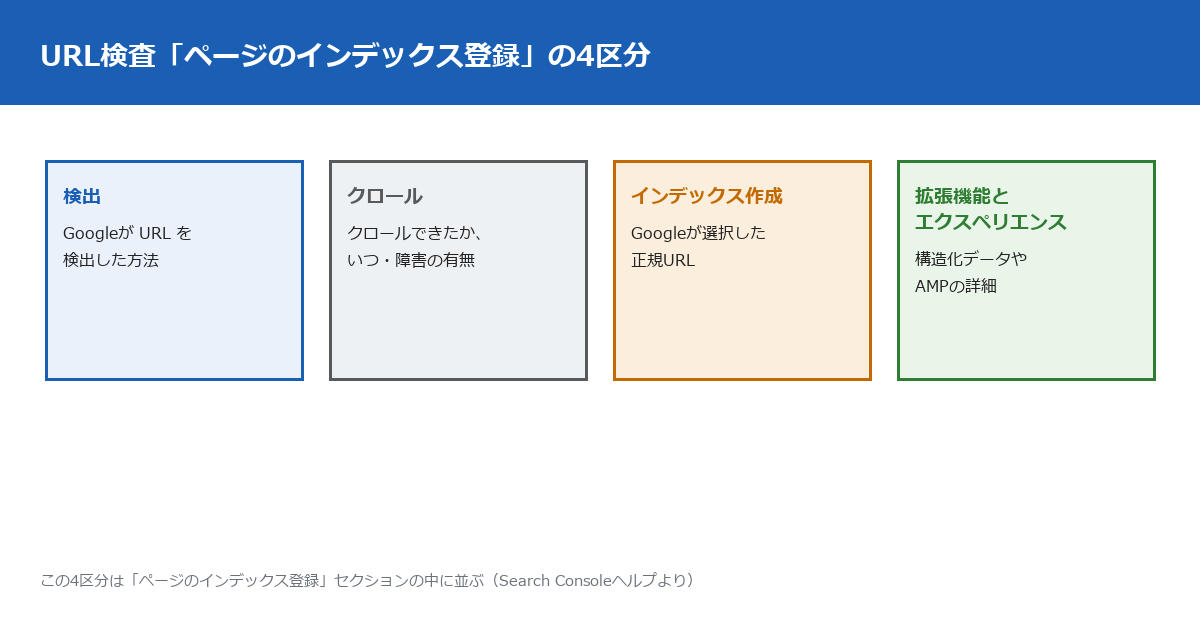
「参照元ページ」は「ページのインデックス登録」セクションの一部
「参照元ページ」は独立した機能ではなく、URL検査結果の中の「ページのインデックス登録」というセクションに、「サイトマップ」「前回のクロール」「ユーザー エージェント」「クロールを許可?」などと並んで表示される項目の1つである。単体で語られることが多いが、実際にはこの大きなセクションの一部分として位置づけられている。ブログ記事やSNSの投稿で「参照元ページ」だけを切り出して紹介されると、この位置づけが見えにくくなる。
02 なぜ・背景 — 発見経路を教えてくれる理由と、3つの分岐
「表示されない」ことは「参照元がない」ことを意味しない
公式ヘルプが最も注意深く書いているのが、この項目が空欄になった場合の解釈だ。「この値が表示されていない場合は、参照元ページがないわけではなく、現時点で URL 検査ツールがその情報を把握していない可能性があります」と明記されている。空欄という結果だけを見て「このページには参照元が存在しない」と早合点しないよう、公式が先回りして注意している形だ。
「他のソースから認識されている」という第3のケース
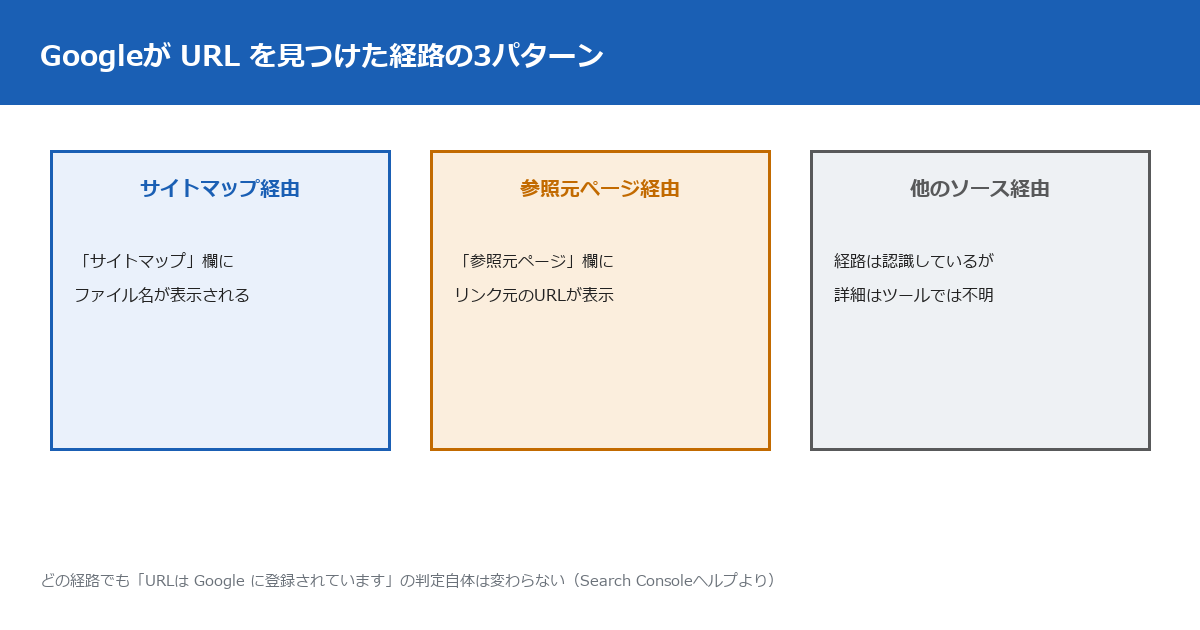
「参照元ページ」欄に表示されうる情報は、実は2択ではない。公式ヘルプは続けて「「URL は、現時点でレポートされていない他のソースから認識されている可能性があります」と表示される場合は、Google がこの URL をサイトマップと参照元ページ以外の場所から検出しているものの、その参照情報は現時点でこのツールでは利用できないことを示しています」とも書いている。つまり「サイトマップ経由」「参照元ページ経由」「発見はしているが経路の詳細はツールに出せない」という、少なくとも3つの状態が存在する。
ライブテストでは、この情報を確認できない
もう1つ知っておくべき制約がある。公式ヘルプは「ライブテストでは、サイトマップや参照元ページに URL が含まれていることを確認するわけではありません」と明記している。「公開URLをテスト」ボタンで実行できるライブテストは、あくまで今この瞬間にページへアクセスできるかを確認する機能であり、過去にどう発見されたかという履歴情報は、インデックス登録済みのデータからしか見られない。
注意
「参照元ページ」を確認したいのに空欄しか出ない場合、ライブテストを何度実行しても情報は増えない。確認できるのは、あくまで前回インデックスに登録された時点のデータである。
「既知の問題」として、Google自身が認めていることもある
「参照元ページ」や「サイトマップ」の表示を疑う前に、確認しておきたい記述がもう1つある。公式ヘルプの「既知の問題」という節には、「サイトマップに送信されたページがサイトマップにレポートに表示されないことがあります。Google では現在、この問題の解決に取り組んでいます」という一文がある。つまり、サイトマップに正しく載せていて、実際にGoogleへ送信していても、レポート上の表示だけがずれることが、公式自身によって認められている。自社の設定を疑う前に、この既知の問題に該当していないかを一度確認しておくと、無駄な調査を避けられる。
03 この記事で出てくる用語
用語
検出—URL検査結果の「ページのインデックス登録」セクションにある項目の1つ。公式ヘルプの定義は「Google が URL を検出した方法」。この「検出」の詳細情報として、「サイトマップ」欄と「参照元ページ」欄が表示される。
「サイトマップ」欄に出るのは、送信済みのものだけ
URL検査結果の「サイトマップ」欄について、公式ヘルプは「サイトマップ レポートを使用して送信されたサイトマップ、またはこのサイトの robots.txt ファイルに記載されているサイトマップ(この URL を指しているもの)が表示されます。他の方法で検出されたサイトマップは表示されません」と説明している。ここでいう「サイトマップ レポート」とは、Search Console内の別の独立したレポートを指す。
「サイトマップ レポート」と、URL検査の「サイトマップ」欄は、対象の範囲が違う
紛らわしいのは、同じ「サイトマップ」という言葉を使った機能が2つ存在する点だ。Search Consoleの「サイトマップ レポート」自体のヘルプを確認すると、「このレポートには、このレポートまたは API で送信したサイトマップのみが表示されます」と明記されており、robots.txtに記載されているだけのサイトマップは、この独立したレポートには載らないと書かれている。一方、URL検査ツールの「サイトマップ」欄は、送信済みのものと robots.txt 記載のもの両方を対象にしている。同じ「サイトマップ」という言葉が指す範囲が、機能によって違うということになる。「サイトマップ レポートに出てこないから、robots.txt経由の発見も無視されている」と考えるのは早計であり、確認する場所を間違えているだけの可能性がある。
「参照元サイトマップなし」と「一時的な処理エラー」は別の表示
「サイトマップ」欄が空に見える場合にも、公式ヘルプは2つの既知の表示を挙げている。「一時的な処理エラー: レポート システムでサイトマップ データの取得に関する一時的な問題が発生しました。検査を再実行すると、問題が解決する場合があります」と、「参照元サイトマップなし: このページを参照しているサイトマップを特定できませんでした」の2つだ。前者は一時的な不具合、後者は「そのURLを含むサイトマップが実際に存在しない」という状態を示しており、対処の仕方が異なる。
「ユーザー エージェント」と「ページの取得」も、あわせて見ておきたい項目
「参照元ページ」の隣には「ユーザー エージェント」と「ページの取得」という項目も並んでいる。公式ヘルプによれば「ユーザー エージェント」は「クロールに使用されたユーザー エージェント タイプ(パソコンまたはモバイル)」を示す。「ページの取得」は「成功」か「失敗」のいずれかで、失敗の場合はさらに「DNS サーバーが応答しません」「サーバー接続エラー」「サーバーの SSL 証明書が無効です」「robots.txt にアクセスできません」といった具体的な理由に分かれる。参照元ページが空欄になっている裏側で、そもそもページの取得自体が失敗していた、というケースもありうるため、この2項目もあわせて確認しておくと原因の切り分けがしやすい。
04 型別 — 適用範囲・この記事が測っていないこと・手順
🅰 適用範囲 — どんなときにこの項目を見る価値があるか
「参照元ページ」を確認する価値が高いのは、新しく公開したページがなかなかインデックスに登録されないときや、サイトマップに載せていないページがどう発見されているかを知りたいときである。逆に、サイトマップにきちんと載っていて、かつ問題なくインデックスに登録されているページについては、優先して確認する項目ではない。ページ数が少ない立ち上げ直後のサイトほど、サイトマップ以外の経路に頼る場面が多くなるため、確認する優先度は相対的に高くなる。
🅱 この記事が測っていないこと・分からないこと
公式ヘルプを確認しても分からないことがある。第一に、「情報を取得できませんでした」という表示文言が実際にいつから使われているか、過去の表示文言から変化したのかは、公式ヘルプのどのページにも記載がなく確認できなかった。第二に、「参照元ページ」に表示される親ページが「2つ上」か「3つ上」かをGoogleがどう判定しているかという具体的な基準は、「2 つまたは 3 つ上の階層にある」という記述以上には公開されていなかった。第三に、参照元サイトマップとして表示される候補が複数ある場合に、どのサイトマップが優先して表示されるのかについても、確認した範囲の公式資料には記載がなかった。分からないことを、分かるふりで埋めていない。
🅲 手順 — URL検査から、必要ならインデックス登録リクエストまで
公式ヘルプが案内する一連の流れは、次の3段階に整理できる。まずURL検査ツールを開いて対象のURLを入力する。次に「ページのインデックス登録」セクションを開き、「検出」「サイトマップ」「参照元ページ」の表示を確認する。そして問題があれば「公開URLをテスト」でライブテストを行い、修正済みと判断されたら「修正を検証」をクリックする、という流れだ。
もう1つ、公式ヘルプが独立した項目として案内しているのが「正規ページの確認」である。「インデックス登録されたバージョンのページを調べて、[ページのインデックス登録] > [Google が選択した正規 URL] を確認します。正規バージョンは、インデックス登録されたデータからのみ確認できます」とされ、続けて「ライブテストでは、テスト対象のバージョンが正規バージョンになるかどうかを予測することはできません」とも書かれている。参照元ページの確認と同じく、これもライブテストでは代替できない、インデックス登録済みデータ側でしか見られない情報である。
実務のヒント
検査した結果、参照元ページとして想定外のURLが表示された場合は、当サイトの🔧 リンクチェックツールで、サイト内のリンク構造をあわせて確認すると、その参照元ページが実際にどこへリンクしているかを把握しやすい。
05 明日、自分のサイトで確認できることチェックリスト
まず何を数えるか
ここまでの内容を、実際に手を動かせる作業に翻訳した。観点は、URL検査結果の基本の見方、自社データとの突き合わせ、詳細項目の確認、インデックス登録リクエストの実務の4つに分かれる。1件のURLを検査するところから始めて、徐々に確認範囲を広げていく構成にしてある。最初にサイトマップに載っている安定したページを1件、次に最近公開した新しいページを1件、というように性質の違うURLを選ぶと、経路の違いが比較しやすい。
実務のヒント
検査対象のURL一覧をまだサイトマップとして整理していない場合は、当サイトの🔧 sitemap.xml作成ツールで、URLの入力だけでGoogle・Bing両対応のsitemapを用意できる。
- Search Consoleで任意のURLを1件選び、URL検査ツールで検査する
- 結果画面の「ページのインデックス登録」セクションで、「サイトマップ」欄の表示内容を確認する
- 同じ結果画面で「参照元ページ」欄の表示内容を確認する
- 「参照元ページ」が空欄なら、「他のソースから認識されている可能性があります」という文言が出ているか確認する
- 検査したURLが、自社のsitemap.xmlに含まれているか確認する
- 自社のrobots.txtに「Sitemap:」の行が記載されているか確認する
- 検査したページへリンクしている社内ページを3件書き出す
- 書き出した3件と、参照元ページの表示が一致するか突き合わせる
- 「前回のクロール」の日時を確認し、今日から何日前かを計算する
- 「クロールを許可?」の項目が許可されている表示になっているか確認する
- 「Google が選択した正規URL」が、意図したURLと一致しているか確認する
- 新しく公開したページを1件選び、URL検査でインデックス登録の状況を確認する
- その日にインデックス登録をリクエストした回数を数え、上限に近づいていないか確認する
| 観点 | 該当する項目 | 目安時間 |
|---|---|---|
| URL検査結果の基本の見方 | 1〜4番目(4項目) | 10分 |
| 自社データとの突き合わせ | 5〜8番目(4項目) | 15分 |
| 詳細項目の確認 | 9〜11番目(3項目) | 10分 |
| インデックス登録の実務 | 12〜13番目(2項目) | 5分 |
すべてに目を通す時間の目安はURL1件あたり40分程度である。複数のURLを続けて確認する場合、5〜6番目の自社のsitemap.xml・robots.txtの確認は最初の1回だけで済むため、2件目以降はより短時間で終わる。
06 代替・他の選択肢(表で)
発見経路の3パターンを、表で整理する
02章で触れた3つの状態を、表で見比べるとそれぞれの対処が分かりやすくなる。
| 経路 | 表示される内容 | 何が分かるか |
|---|---|---|
| サイトマップ経由 | 「サイトマップ」欄にファイル名が表示 | どのサイトマップでこのURLを知ったか |
| 参照元ページ経由 | 「参照元ページ」欄にURLが表示 | どのページのリンクから見つけたか(2〜3階層上の親ページのこともある) |
| 他のソース経由 | 「他のソースから認識されている可能性」という文言 | 発見はしているが、経路の詳細はツールでは分からない |
個別リクエストと、サイトマップ送信の使い分け
参照元やサイトマップの確認とあわせて、多くの担当者が知りたいのが「インデックス登録を早めるにはどうすればよいか」という点だろう。公式ドキュメント「URLの再クロールをGoogleにリクエストする」は、方法を明確に2つに分けている。「個々の URL のクロールをリクエストするには、URL 検査ツールを使用します」「多数の URL が存在する場合は、サイトマップを送信します」というのがそれだ。
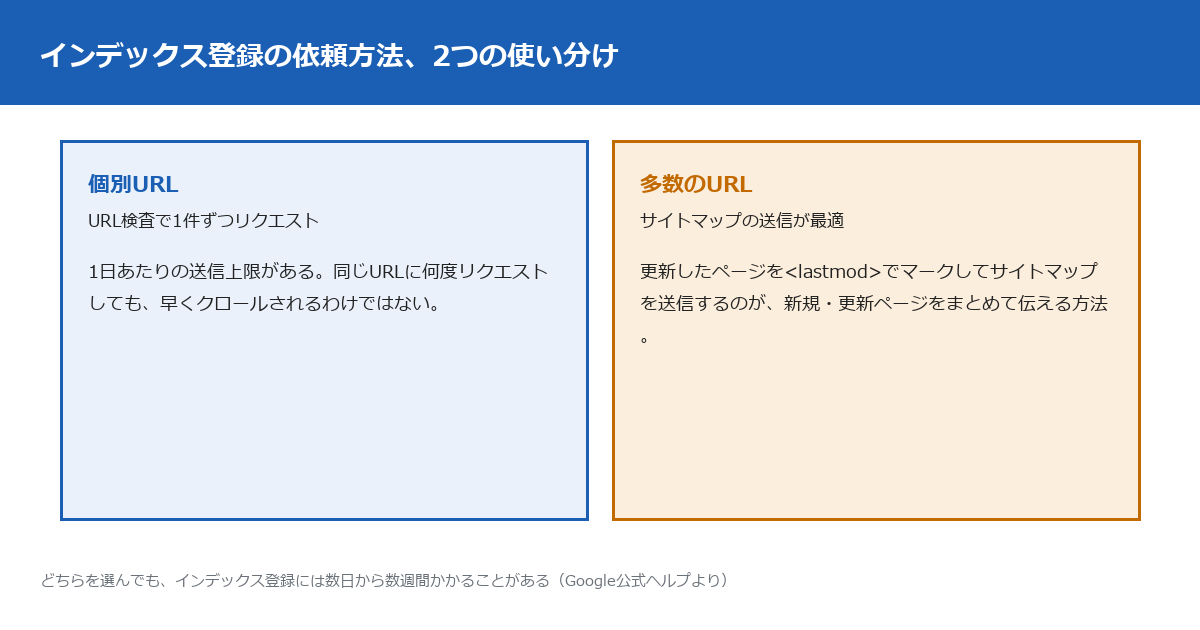
個別リクエストには制約もある。同じ公式ドキュメントは「個々の URL の送信には上限があり、同じ URL に対して再クロールを何度もリクエストしても、早くクロールされることはありません」と明記している。これは、Search ConsoleのURL検査ツールについての公式ヘルプにある「送信できるインデックス登録リクエストの数には、1 日あたりの上限が設定されています。インデックス登録したいページが多数ある場合は、サイトマップを Google に送信してみてください」という記述とも一致する。この使い分けについては、当サイトの「Search ConsoleのURL検査『インデックス登録をリクエスト』は何をしているのか」(Search ConsoleのURL検査「インデックス登録をリクエスト」は何をしているのか)で、リクエストそのものの仕組みをさらに詳しく確認している。
URL検査そのものが、テストしていない項目もある
参照元ページやサイトマップの表示ばかりに注目していると見落としがちだが、URL検査ツールのテスト結果には、そもそも確認対象に含まれていない項目がある。公式ヘルプは次の項目を「テストされない項目」として明示している。
| 項目 | 公式ヘルプの記述 |
|---|---|
| 品質・セキュリティ | 品質とセキュリティに関するガイドラインへの準拠 |
| 手動による対策 | 手動による対策やセキュリティの問題の有無 |
| コンテンツ削除 | 法律上の理由などによる削除対象になっていないか |
| 一時的なブロック | Search ConsoleでURLが一時的にブロックされていないか |
| 動画のインデックス登録(ライブテスト) | 検出されたかどうかのみで、登録されたかどうかは対象外 |
「URL は Google に登録されています」という表示が出ても、これらの項目まで保証されているわけではない。公式ヘルプ自身が「その URL が Google に表示されているかどうかを最終確認するには、Google 検索でその URL を検索します」と案内している点も、あわせて押さえておきたい。
07 自社サイトで確認したこと — robots.txtとsitemap.xmlの現状
robots.txtにSitemapの行が記載されていた
当サイトのrobots.txtを実際に開いて確認したところ、「Sitemap: https://website.usersupports.com/sitemap.xml」という行が記載されていた。この記載があることで、URL検査ツールの「サイトマップ」欄には、サイトマップ レポートで送信していないURLについても、robots.txt経由で表示される可能性がある。
sitemap.xmlには273件のURLが含まれていた
同じくsitemap.xmlを開いて数えたところ、含まれるURLは273件だった。この273件に含まれるURLであれば、URL検査の「サイトマップ」欄にファイル名が表示される可能性が高い一方、この一覧に含まれていない新しいページについては、内部リンクなど「参照元ページ」の経路、またはサイトマップ・参照元ページ以外の「他のソース」経由で発見されることになる。サイトマップに載っているか載っていないかで、この記事の使い方そのものが変わるということが、自社の数字を数えて初めて具体的に分かった。
載っているURLの中身も、記事を書く前に数えておく
273件の内訳をさらに数えると、URLのパスに「seo_article」を含むものが84件、「ai_ron」を含むものが144件だった。どちらもサイトマップには載っているが、新しく公開した直後のページはこの数にまだ含まれていない。新規記事を公開した当日にURL検査を行うと、サイトマップへの反映タイミング次第では「参照元サイトマップなし」の表示に出会うことがある、という想定ができる。
08 このテーマの、これまで — 「見つけてもらう」ための積み重ね
「リンクが在る」ことと「参照元として認識される」ことは、また別の話
当サイトはこれまで、「リンクがあること」と「正しく機能していること」は別だと繰り返し確認してきた。sitemapに書いたURLがGoogleから見えていなかった経験(archives/38)や、sitemap・canonical・内部リンク・末尾スラッシュの4層整合性を確認した記録(archives/39)は、いずれも「載せているつもり」と「実際に機能しているか」のズレを扱っている。本記事の「参照元ページ」も同じ構造を持つ。リンクを張ったことと、そのリンクが「参照元」として認識されることは、確認するまで分からない。
内部リンクの質そのものを疑う視点
当サイトが「『リンク切れ0本』を確認して、安心しかけた」(archives/134)で扱ったように、内部リンクは「切れていないか」だけでなく「どこへ飛んでいるか」まで見る必要がある。参照元ページとして表示されたリンクが、実はnoindexのページや意図しないページであった場合、リンクの存在自体は問題なくても、SEOの観点では見直しが必要になる。
再クロール待ち行列と、発見経路は別の問題
当サイトが「再クロール待ち行列547件」(archives/108)で確認した「最長2週間」という公式の目安は、URLがすでに発見された後、インデックス登録の順番待ちにかかる時間の話である。一方、本記事で扱った「参照元ページ」は、その手前の「そもそもどうやって見つかったか」という話であり、2つは別の段階を扱っている。「発見」「クロール」「インデックス登録」という3つの段階を分けて考えないと、遅れの原因をどこで確認すればよいのかが分からなくなる。出力の値そのものに見つけた小さな穴を確認した回(archives/128)も含め、当サイトはこれまで「表示されている値の意味を、公式の説明に照らして確かめる」という作業を積み重ねてきた。本記事もその延長線上にある。
現在の貴方のIPアドレス
このサイトで書いている人