WEBサイト
「クロール済み」と「検出」、インデックス未登録の違い ── Search Console「ページのインデックス登録」レポートの読み方(2026年8月時点)
「クロール済み」と「検出」、インデックス未登録の違い ── Search Console「ページのインデックス登録」レポートの読み方(2026年8月時点)
01 「ページのインデックス登録」レポートの現行ステータス
全15ステータスの分類
Search Consoleの「ページのインデックス登録」レポートには、「除外」カテゴリだけで15種類のステータスが存在します。Google公式のヘルプページ「ページのインデックス登録レポート」を確認すると、これらは大きくエラー系・除外系・未登録系・重複系の4分類に整理できます。この記事の主題である「クロール済み — インデックス未登録」と「検出 — インデックス未登録」は、いずれも未登録系に属し、名前が似ているために混同されやすいステータスです。レポートの一覧画面ではどちらも同じ「除外」タブの中に並んで表示されるため、件数だけをざっと眺めていると、この2つを同一の問題として扱ってしまいがちです。
| 分類 | ステータス名 |
|---|---|
| エラー系 | サーバーエラー(5xx) |
| エラー系 | 見つかりません(404) |
| エラー系 | 未承認のリクエスト(401)が原因でブロック |
| エラー系 | アクセス禁止(403)が原因でブロック |
| エラー系 | リダイレクトエラー |
| 除外系 | URLがrobots.txtによってブロック |
| 除外系 | URLにnoindexが指定されている |
| 除外系 | ソフト404 |
| 除外系 | 他の4xxの問題が原因でURLがブロック |
| 未登録系 | クロール済み — インデックス未登録 |
| 未登録系 | 検出 — インデックス未登録 |
| 重複・その他 | 重複しています(正規ページとして未選択) |
| 重複・その他 | 重複しています(Googleが別ページを正規化) |
| 重複・その他 | 代替ページ(適切なcanonicalタグあり) |
| 重複・その他 | ページにリダイレクトがある |
この一覧は「ページのインデックス登録レポート」の除外カテゴリに表示される全15ステータスです。名称だけでは判断が難しいものも多いため、迷ったときはこの表に戻って分類を確認してください。以降の章では、このうち未登録系の2つに絞って詳しく扱います。

「クロール済み」と「検出」の定義(原文)
Google公式ヘルプは、この2つのステータスをそれぞれ次のように定義しています。原文の言い回しをそのまま引用します。
出典
クロール済み — インデックス未登録:「ページは Google によりクロールされましたが、インデックスには登録されていません。今後、インデックスに登録される可能性がありますが、登録されない可能性もあります」
検出 — インデックス未登録:「ページは Google により検出されましたが、まだクロールされていません。これは通常、Google が URL をクロールしようとしたものの、サイトへの過負荷が予想されたため、クロールの再スケジュールが必要となった場合です」
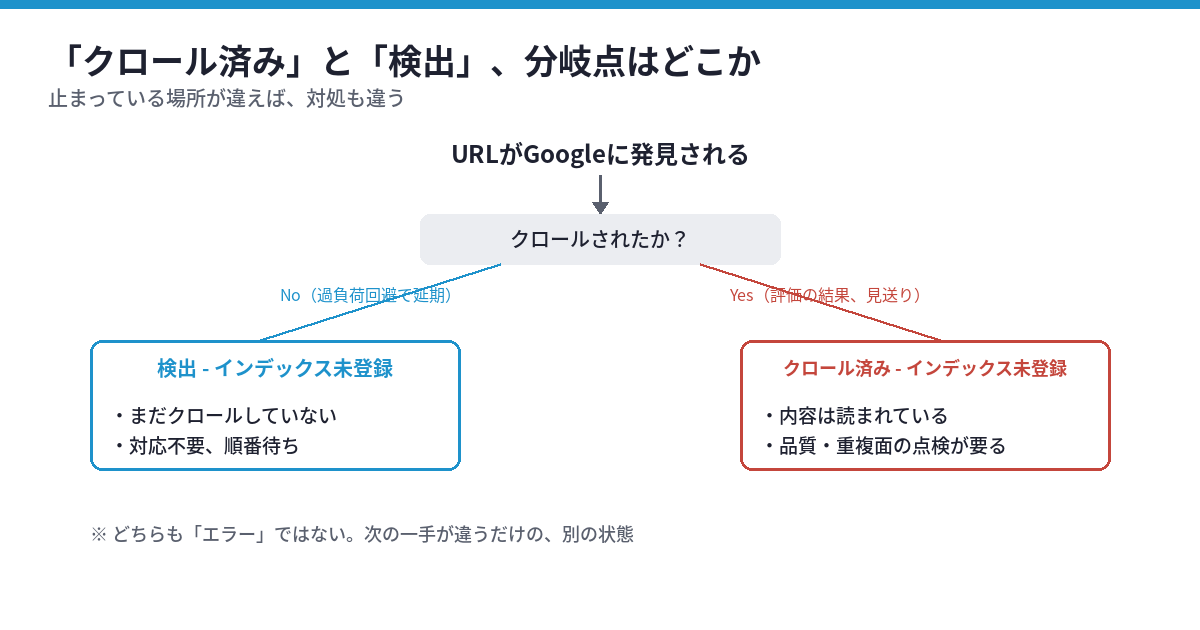
この2つの定義を並べると、違いはクロールされたかどうかの一点にあることが分かります。「検出」はまだ中身を読まれていない状態、「クロール済み」は中身を読まれた上でインデックスが見送られている状態です。止まっている場所がまったく違うため、対処の方向性も変わります。この違いを踏まえずに両方を同じ対処法でまとめて扱おうとすると、片方には効いてももう片方には効かない、という結果になりがちです。
公式ヘルプに「対応不要」と明記されているのは「検出」だけ
もうひとつ見落とされやすい違いがあります。Google公式ヘルプは「検出 — インデックス未登録」について明確に対応不要としている一方、「クロール済み — インデックス未登録」に対しては、そうした断定を避けています。読み方を変えると、Googleは「検出」をサイト側の問題ではなくGoogle側の順番待ちと位置づけ、「クロール済み」についてはサイト側で改善できる余地があるという含みを残しているとも取れます。この非対称性が、次の02章で扱う「なぜ混同されやすいか」にもつながっています。
02 なぜ、この2つは混同されやすいのか — 背景
名前が似ている、意味は違う
「クロール済み — インデックス未登録」と「検出 — インデックス未登録」は、どちらも末尾に「インデックス未登録」と付くため、レポート上でざっと見た印象では同じ種類の問題に見えます。しかし01章の原文が示す通り、片方はクロールという工程を通過済み、もう片方はクロールという工程にまだ到達していないという、工程上まったく別の位置にいます。名前の後半だけを読んで判断してしまうと、この工程上の違いが見えなくなります。この違いを分岐図にすると、次のようになります。
どちらも「エラー」ではないという誤解されやすさ
もうひとつの混同要因は、この2つが「未登録」という否定的な響きの名前を持ちながら、実際にはエラーではないという点です。「検出」は対応不要で順番待ちの状態であり、サイト側に落ち度があるわけではありません。「クロール済み」も、リダイレクトエラーやサーバーエラーのような明確な技術的故障ではなく、Googleが内容を評価した上で「今回は見送る」と判断した結果です。どちらも、赤い警告アイコンが付いていることが多いため、直感的には「壊れている」ように見えてしまいます。
件数が多いこと自体は、悪い兆候とは限らない
特に「クロール済み — インデックス未登録」の件数がある程度まとまっている状態は、見方を変えれば「Googlebotがそのページ群をきちんと読みに来ている」ことの裏返しでもあります。件数の多寡だけを見て一喜一憂するのではなく、どちらの系統の未登録が多いのかを先に切り分けることが、次の一手を決める材料になります。逆に「検出」の件数だけが突出して多い場合は、Googlebotがそもそもそのページ群にまだ十分に到達できていないという、また別の課題を示していることになります。
レポート上の表示順が、優先度の誤解を生むこともある
Search Consoleの「ページのインデックス登録」レポートは、各ステータスを件数の多い順に並べて表示します。この並び順は件数の大小を反映しているだけで、対処の緊急度を示すものではありません。件数が多いステータスから順に手をつけるのが自然な流れに見えますが、02章前半で見た通り「検出」は対応不要のケースを多く含むため、単純に上から順番に潰していくと、実際には優先度の低い作業に時間を使ってしまうことがあります。04章の切り分けを先に済ませてから、どちらから着手するかを決めるほうが手戻りが少なくなります。
このレポートの有用な点と、限界
実務でこのレポートを使ってきた立場から、有用な点と限界を分けて書いておきます。有用な点は、サイト全体の未登録URLを一覧で俯瞰でき、個別にURLを1件ずつ調べなくても傾向がつかめることです。一方の限界は、ステータスの名称だけでは工程上の違いが伝わりにくいこと(本記事の主題そのものです)、そして表示順が優先度を意味しないため、レポートを開いただけでは「次に何をすべきか」までは分からないことです。レポートは現状を映す鏡であって、対処の順序まで指示してくれるものではない、という前提で使うのが実態に近い付き合い方です。
注意
「クロール済み — インデックス未登録」は、公式定義に「今後インデックスに登録される可能性がある」と明記されている通り、恒久的な除外ではありません。ページの内容や周辺のシグナルを改善すれば、次回以降のクロールで再評価される余地があります。焦って大量のページを一度に作り直す前に、後述の04章・05章で原因の傾向を確認するほうが、遠回りになりにくい進め方です。
03 この記事で出てくる用語
用語
インデックス登録(インデックス) — Googleがクロールしたページの内容を解析し、検索結果に表示できる状態としてデータベースに保存すること。クロールされてもインデックス登録されるとは限らない。
用語
URL検査ツール — Search Console内の機能で、個別URLの現在のインデックス状況・最終クロール日時を確認できる。「インデックス登録をリクエスト」機能から、Googleに再クロールの優先度を上げるよう申請できる。
用語
ソフト404 — サーバーはHTTP 200(正常)を返しているにもかかわらず、ページの内容が「見つかりません」に類する空・エラー相当の中身になっている状態。Googleはこれを実質的な404として扱い、インデックスから除外する。
用語
正規URL(canonical) — 同一または類似の内容を持つ複数URLの中から、Googleが検索結果に表示する代表として選ぶ1つのURL。rel="canonical"タグ・リダイレクト・サイトマップ掲載などのシグナルから総合的に決定される。
04 型別に見る、原因の切り分け
「検出」止まりの主因 — クロール需要とサーバー側の余力
「検出 — インデックス未登録」に留まる主な理由は、Google側のクロール優先度の問題です。公式定義にある通り「サイトへの過負荷が予想された」場合にクロールが延期されますが、これはサイト全体のクロールバジェット(大規模サイト向けのクロールバジェット管理ガイド参照)や、そのURLへの内部リンクの少なさが影響することがあります。新規公開直後のページや、サイト内で参照される機会の少ない深い階層のページに多く見られる傾向です。中小規模のサイトであれば、クロールバジェットそのものが不足するケースはまれで、むしろサイト内のどこからもリンクされていない孤立したページになっていないか、という点検のほうが実務上は当たりやすい原因です。
クロールバジェットという概念自体は、クロールレート制限とクロール需要という2つの要素の組み合わせで決まります。公式ガイドによれば、クロールレート制限はGooglebotが「サーバーに負荷をかけすぎずにクロールしたい」という考えに基づき、接続数や取得間隔を調整する仕組みです。クロール需要は、サイトの規模・更新頻度・ページ品質・関連性といった要因から決まる、Googlebot側の「どれだけクロールしたいか」という欲求を指します。中小規模サイトで「検出」が増える場合、多くはクロールレート制限ではなく、クロール需要側(更新頻度の低さ・内部リンクの少なさ)が影響しています。
「クロール済み」止まりの主因 — 品質と重複の2系統
「クロール済み — インデックス未登録」は、さらに2つの系統に分けられます。ひとつは品質面の見送りで、内容が薄い・独自性に乏しい・既存の他ページと似た情報しか含まないといった理由です。もうひとつは重複面の見送りで、内容として重複はしていないが正規URLの指定が曖昧なため、Googleが別のURLを優先している場合です。重複の解消方法は重複URLを統合する方法として公式が手順を示しており、リダイレクト・rel="canonical"・サイトマップ掲載の3つが正規化のシグナルとして挙げられています。品質面と重複面は原因としてまったく別物であるにもかかわらず、レポート上ではどちらも同じ「クロール済み — インデックス未登録」という1つのラベルにまとめられるため、対象ページを個別に開いて中身を確認するまでは、どちらが原因かを判別できません。
大量のURL変更の直後は、両方が一時的に増える
サイト全体で大量のURLを一度に変更・追加した直後は、「検出」「クロール済み」の両方が一時的に増える傾向があります。Googleが2026年7月10日に重複URLの統合に関するトラブルシューティングドキュメントに追加した説明では、コンテンツの問題を修正した後でも最長2週間、ページが重複クラスタの中に留められることがあると明記されています。この期間は「対応が効いていない」のではなく、「評価の反映を待っている」段階である可能性があります。同ドキュメントは、新しいコンテンツと既存のクラスタ内ページとの差異が明確かつ大きいほど、クラスタからの分離が速く進むとも補足しています。
canonicalタグを実際に書く・確認する
重複面の見送りを解消する際、実装で迷いやすいのがcanonicalタグの記述位置と、その確認方法です。rel="canonical"は、対象ページの<head>内に1行で記述します。
<link rel="canonical" href="https://example.com/正規URL/" />複数の類似ページがある場合、正規としたいURLのページには自分自身を指すcanonicalを、それ以外のページには正規URLを指すcanonicalを記述します。記述した後は、Search ConsoleのURL検査ツールを開き、「ユーザーが指定した正規URL」と「Googleが選択した正規URL」の2つの項目を確認してください。両者が一致していれば、指定は正しく認識されています。一致していない場合、Googleは別のシグナル(リダイレクトやサイトマップの記載など)を優先して、別のURLを正規として選んでいる可能性があります。
両方が同時に多い場合、優先すべきはどちらか
「検出」「クロール済み」の両方が同時にまとまった件数になっている場合、どちらから手をつけるべきかで迷うことがあります。目安としては、「検出」への対処(内部リンクの追加・サイトマップの整備)のほうが着手コストが低く、反映も比較的追いやすい傾向があります。一方「クロール済み」への対処は、個々のページの内容を読み直して品質や重複を判断する作業になるため、時間がかかります。両方が多い場合は、まず「検出」側の低コストな対処を先に実施し、その後「クロール済み」側の品質点検にまとまった時間を割く、という順序が現実的です。
| 状態 | 典型的な兆候 | 確認する場所 |
|---|---|---|
| 検出止まり | 公開直後、または内部リンクが少ない | クロール統計情報のリクエスト数推移 |
| クロール済み (品質面) | 本文が薄い、独自の情報が少ない | 対象ページの本文の文字数・情報量 |
| クロール済み (重複面) | 似た内容の複数URLが存在する | canonicalタグ・正規URLの指定状況 |
| 一時的な遅延 | 大量のURL変更・修正の直後 | 「再評価には時間がかかる」の公式説明 |
実務のヒント
「クロール済み」と「検出」の件数比を見ることが、切り分けの第一歩になります。「検出」の比率が高い場合は内部リンクの見直しやサイトマップの整備、「クロール済み」の比率が高い場合は個々のページの品質・重複の点検、というように優先すべき作業の方向性が変わります。件数だけを見て「まとめて何とかしよう」と動く前に、この比率を確認しておくと、後になって手戻りが生じる事態を減らせます。
05 自分のサイトで確認するチェックリスト
チェックリストの構成
ここまでの内容を、Search Consoleを開いている今日から確認できる動作に翻訳しました。前半は2つのステータスの件数と傾向の確認、中盤は個別URLでの原因切り分け、後半は対処と再確認のサイクルに対応しています。特別なツールを新たに用意する必要はなく、Search Consoleとサイト自身のページがあれば、すべての項目を確認できます。チェックの状態はブラウザ内にのみ保存され、サーバーには送信されません。
- Search Consoleの「ページのインデックス登録」レポートを開き、「検出 - インデックス未登録」の件数を書き出す
- 同じレポートで「クロール済み - インデックス未登録」の件数も書き出し、2つの数字を比較する
- 「クロール済み - インデックス未登録」に分類されたURLを3件選び、URL検査ツールでライブテストを実行する
- ライブテストの結果画面で、robots.txtによるブロックが表示されていないか確認する
- 選んだ3件について、canonicalタグが自ページを指しているか、それとも他ページを指しているかを確認する
- 「検出 - インデックス未登録」のURLを3件選び、サイト内から内部リンクが1本以上張られているか確認する
- 選んだURLについて、クロール統計情報レポートで直近90日間のリクエスト数の推移を確認する
- サイトマップに掲載しているURL数と、インデックス登録済みページ数の差を計算する
- 「クロール済み - インデックス未登録」の対象ページの本文の文字数を数え、同カテゴリの他ページと比べて明らかに少なくないか確認する
- 同じ内容のページが他に存在しないか、近いタイトルでサイト内検索する
- 直近でnoindexタグやrobots.txtの設定を変更していないか、変更履歴を振り返る
- URL検査ツールで「インデックス登録をリクエスト」を実行し、実行日をメモしておく
- 2週間後に同じURLを再度URL検査し、ステータスが変化したかを確認する
13項目の内訳と、優先して手をつける範囲
最初の2項目は全体の傾向把握、3番目から8番目は個別URLでの原因切り分け、9番目・10番目は品質と重複の実測、11番目から13番目は対処と再確認のサイクルに対応しています。特に2番目の「2つの数字を比較する」は、04章の切り分けにそのままつながる項目のため、最初にここから着手すると全体の見通しが立てやすくなります。13項目すべてに目を通す所要時間の目安は、20〜30分程度です(13番目の再確認は2週間後になるため、実作業としては12項目・20分程度と考えてください)。すべてのページを一度に確認する必要はなく、まずは代表的なページ群を1つ選んで、この13項目を通しで試してみることを想定した構成です。
06 対処法の比較 — どれを、いつ使うか
04章で原因を切り分けた後は、実際にどの手段を使って対処するかという段階に移ります。対処法は1つではなく、それぞれ効果の範囲・即効性・向き不向きが異なるため、原因に合わない手段を選ぶと時間をかけた割に効果が出ない、ということが起こります。以下では代表的な5つの手段を、適用範囲と限界の両面から整理します。
「とりあえずインデックス登録をリクエスト」で足りるとは限らない
対処法にはいくつかの選択肢があり、それぞれ適用範囲と限界が異なります。特に誤解されやすいのがIndexing APIです。名前から「一般のページのインデックスを早める手段」と思われがちですが、公式ドキュメントはIndexing APIの利用方法で対象を明確に限定しており、JobPosting(求人情報)またはBroadcastEvent(ライブ配信イベント)を含むページ以外には使用できません。一般的な記事ページやコーポレートサイトのページに対してこのAPIを使うことは、想定された使い方ではありません。
| 対処法 | 適用範囲 | 限界 |
|---|---|---|
| URL検査で 登録をリクエスト | 個別URL。再クロールの優先度を上げられる | 効果は保証されない、1日あたりの実行回数に上限がある |
| サイトマップの 再送信 | サイト全体。変更をまとめて伝えられる | 個別URLの優先度は直接上がらない |
| Indexing API | JobPosting・BroadcastEventのみ | 一般的なウェブページには使用できない |
| 内部リンクの 追加 | サイト内の発見経路・評価シグナルを強化 | 即効性はなく、反映まで時間がかかる |
| 統合・ 301リダイレクト | 重複・薄いページの整理 | 統合先の内容が十分であるかの見極めが要る |
「検出」には内部リンクとサイトマップ、「クロール済み」にはコンテンツの見直し
04章の切り分けと、この表を組み合わせると優先順位が見えてきます。「検出」止まりが多い場合は内部リンクの追加やサイトマップの整備がまず効く可能性が高く、「クロール済み」止まりが多い場合は個々のページの品質や正規URLの指定を見直すほうが的を射ています。どちらの場合も、URL検査での個別リクエストは「効くかもしれない一手」であって、原因そのものを取り除く対処ではない点は覚えておく必要があります。
「検出」が大量発生したときの、具体的な対処の流れ
「検出 — インデックス未登録」が短期間でまとまって発生した場合の、実務的な手順を段階で示します。まずサイトマップの再送信です。Search Consoleの「サイトマップ」メニューから、既存のサイトマップURLを再度送信すると、Googleに更新の存在を伝えられます。次に内部リンクの追加で、対象ページへのリンクをサイト内の主要ページ(トップページやカテゴリ一覧など、クロール頻度が高いと見込まれるページ)に設置します。この際、リンクのアンカーテキストは対象ページの内容が伝わる言葉にし、単なる「こちら」のような表記は避けたほうが、リンク元ページの評価が伝わりやすくなります。最後に、これらの対応から1〜2週間ほど空けてから、URL検査で状況を再確認します。即日で反映されることは期待せず、対応と確認の間に一定の期間を置くのが実務的な進め方です。
実務のヒント
サイトマップの再送信や新規URLの追加をこまめに行うには、当サイトの🔧 XMLサイトマップ作成ツールが使えます。既存のsitemap.xmlを解析し、追加・欠落しているURLを洗い出せます。
Search Console以外で、インデックス状況を確認する手段
ここまではSearch Consoleを前提に説明してきましたが、確認手段はこれだけではありません。もっとも手軽なのは、検索窓にsite:演算子と対象URLを入力して検索する方法です。結果が表示されれば、少なくともそのURLはGoogleのインデックスに存在することが分かります(ただし表示順や件数の精度は保証されていません)。Bingを使っている場合はBing Webmaster Toolsが同種のインデックス状況レポートを提供しています。サイト全体のクロール可能性を事前に洗い出したい場合は、Screaming FrogのようなクローラーツールでURLを一括診断し、内部リンク切れやリダイレクトチェーンを洗い出す方法もあります。いずれもSearch Consoleの代替というより、Search Consoleの情報を別の角度から補強する手段として使うのが実務的です。
統合・301リダイレクトを選ぶときの見極め
表の最後に挙げた「統合・301リダイレクト」は、似た内容の複数ページを1本にまとめてしまう対処法です。効果が大きい一方で、統合先のページが統合元の内容を十分にカバーしていない場合、統合によって読者の求めていた情報が結果的に失われることがあります。似たテーマのページが3本以上ある、それぞれの表示回数がいずれも小さい、といった条件が揃っている場合に検討する対処法であり、内容に明確な違いがあるページ同士を機械的に統合すると、かえって既存の評価を損なう可能性があります。
07 当サイトでの実測
「未登録」内訳の実数
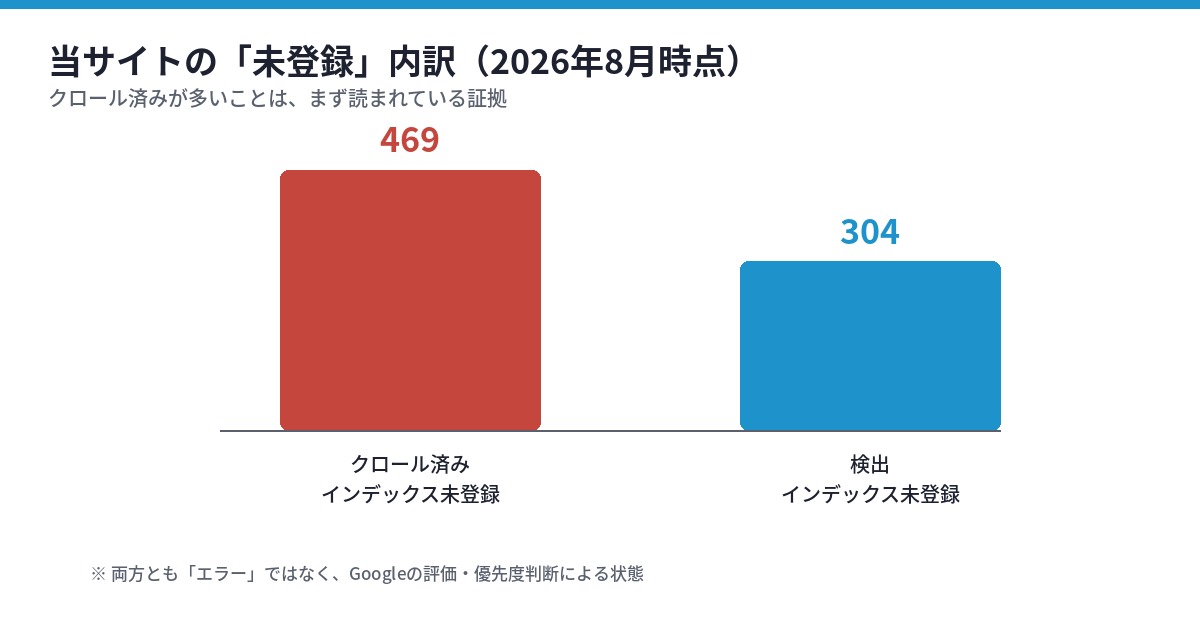
当サイトのSearch Consoleでは、2026年8月時点で「クロール済み — インデックス未登録」が469件、「検出 — インデックス未登録」が304件という実測が出ています。04章の切り分けに当てはめると、当サイトは「検出」よりも「クロール済み」のほうが多い状態で、内部リンクの不足よりも、個々のページの品質・重複面の点検を優先すべき局面にあります。
自分のサイトでも同じように未登録の内訳を確認したい場合は、当サイトの🔧 Google Search Console 解説ツールで、レポートの読み方を確認できます。
過去の一括対応との関係
この469件・304件という数字は、当サイトが過去に経験した大規模なnoindex対応と無関係ではありません。以前、公開記事の8割を超える1,028件が「addview.html未生成」という条件によって静かにnoindex扱いになっていたことに気づき(archives/98)、973件を一括でnoindex解除した記録があります(archives/105)。sitemap.xmlのURL数も361件から1,356件へと急増しました。04章で触れた「大量のURL変更の直後は、両方が一時的に増える」という傾向は、当サイト自身のこの経験とも重なります。
件数の目安について、正直に書いておくこと
「未登録の件数はどれくらいなら正常か」という目安を探している読者もいると思いますが、ここは正直に書きます。サイト規模別の一般的な目安を示す、統制された公開データは見つかっていません。公開記事数・サイトの年数・更新頻度によって差が大きく出る指標のため、他サイトの数字とそのまま比較しても、あまり意味のある結論にはなりません。実務上意味を持つのは、他サイトとの比較ではなく自サイトの過去の数字との比較です。05章のチェックリストで件数を書き出す作業を、月に1回程度続けて記録しておくと、増減の傾向という形で自分のサイトの目安が見えてきます。
「クロール済み」が多いことから読み取れること
04章の分類に当てはめると、当サイトは「検出」よりも「クロール済み」のほうが約1.5倍多い状態です。これは、Googlebotが当サイトのページ群にきちんと到達できているものの、到達した先の内容がインデックス登録の基準を満たしていない、あるいは既存の他ページと内容が近いと判断されているページが一定数残っていることを示しています。02章で触れた通り、この状態自体は「壊れている」わけではなく、品質・重複面の点検を優先すべき局面にあるという位置づけとして受け止めています。
実務のヒント
05章のチェックリストの1番目・2番目(2つのステータスの件数を書き出して比較する)は、当サイトで実際に使っている確認手順そのものです。当サイトの場合、「クロール済み」が「検出」の約1.5倍という比率になっており、この比率をもとに次に着手する作業(品質・重複面の点検)を決めています。noindex解除後のインデックス登録推移を時系列で追う作業は、当サイトでもまだ体系的な計測ができていない項目として残っています(archives/105で「次の宿題」として書いた内容です)。
08 このテーマの、これまで
「クロール済み」「検出」という2つのステータスは、今回初めて扱ったテーマではありません。当サイト自身が、大量のページのインデックス状況と何度も向き合ってきた経緯があります。ここでは、それぞれの記録が本記事のどの章とつながっているかを添えながら振り返ります。
静かなnoindex地獄に気づいた回
07章で触れた469件・304件という数字の背景には、当サイトが2026年7月に経験した大規模な事象があります。公開記事1,238件のうち8割を超える1,028件が、補足コンテンツファイルの有無という条件ひとつでnoindex扱いになっていたことに気づいた記録です(archives/98)。原因は個別の設定ミスではなく、「補足ファイルが存在しない記事は自動的にnoindexにする」という、正しく動いていたテンプレートの仕様そのものでした。
1,000件の宿題を6日間で畳んだ回
その後、973件を軽量版で一括生成してnoindexを一斉解除し、6日間でフル品質への昇格作業を約880件まで進めた記録です(archives/105)。「あとで完全にする」という判断を実際にどう畳んだか、そして残る147件がSQLの修正では直せないデータ汚染を抱えていたことも含め、数字を丸めずに正直に書いています。
再クロール待ちの「最長2週間」を扱った回
04章で触れた「再評価には時間がかかる」という公式説明について、実際にどれくらいの期間がかかったかを当サイト自身の事例で検証した記録があります(archives/108)。「待つ」という受け身の状態を、サイトマップの更新やインデックス登録リクエストを使って能動的な観測期間に変える方法を扱っています。
sitemapの末尾スラッシュが招いた未登録
04章・05章で扱ったcanonicalの不一致は、URLの末尾スラッシュの有無という小さな差から生まれることもあります。チームメイトが発見した実例をもとに、当サイトでも主要URLを検証した記録です(archives/38)。sitemapに載っているURLがリダイレクトされる構造になっていると、Googleは正規URLの宣言と実態が一致していないと判断し、インデックスを保留します。この事例は、原因が「重複面」に分類される典型例として、04章の表にもそのまま当てはまります。
これまでの記録が、この記事のチェックリストにつながっている
ここまで挙げた4本の記録は、いずれも当サイトが「なぜ検索結果に反映されないのか」を実際に調べた過程そのものです。addview.htmlの有無という条件、6日間で畳んだ昇格作業、再クロール待ちの期間、末尾スラッシュの不一致 — どれも05章のチェックリストの項目のどれかと直接対応しています。この記事のチェックリストは、当サイトが自分自身のつまずきを振り返って組み立てたものであり、外部の一般論だけをまとめたものではありません。
現在の貴方のIPアドレス
このサイトで書いている人