WEBサイト
情報利得(Information Gain)とは? Google特許が示す仕組みと、自分の記事で確認する13項目(2026年8月時点)
情報利得(Information Gain)とは? Google特許が示す仕組みと、自分の記事で確認する13項目(2026年8月時点)
目次
01 「情報利得(Information Gain)」とは何か
きっかけはAhrefsの解説記事だった
「情報利得(Information Gain)」という言葉を検索SEOの文脈で見かけることが増えています。きっかけの1つが、Ahrefsが2026年8月20日に公開した解説記事です(What Is Information Gain in SEO? (and How To Add It to Your Content)(訳: SEOにおける情報利得とは何か。そしてコンテンツへの加え方))。この記事は、コンテンツマーケターのLouise Linehan氏が18分の読了時間をかけて書いた長文で、Googleが2022年に取得した特許を出発点に、「AIが要約できてしまう記事」と「引用され続ける記事」の違いを整理しています。本記事では、この解説記事が紹介する特許の原文を実際に開いて確認したうえで、自分のサイトの記事にそのまま当てはめて確かめる方法をまとめます。
特許の言葉を、まず素直に読む
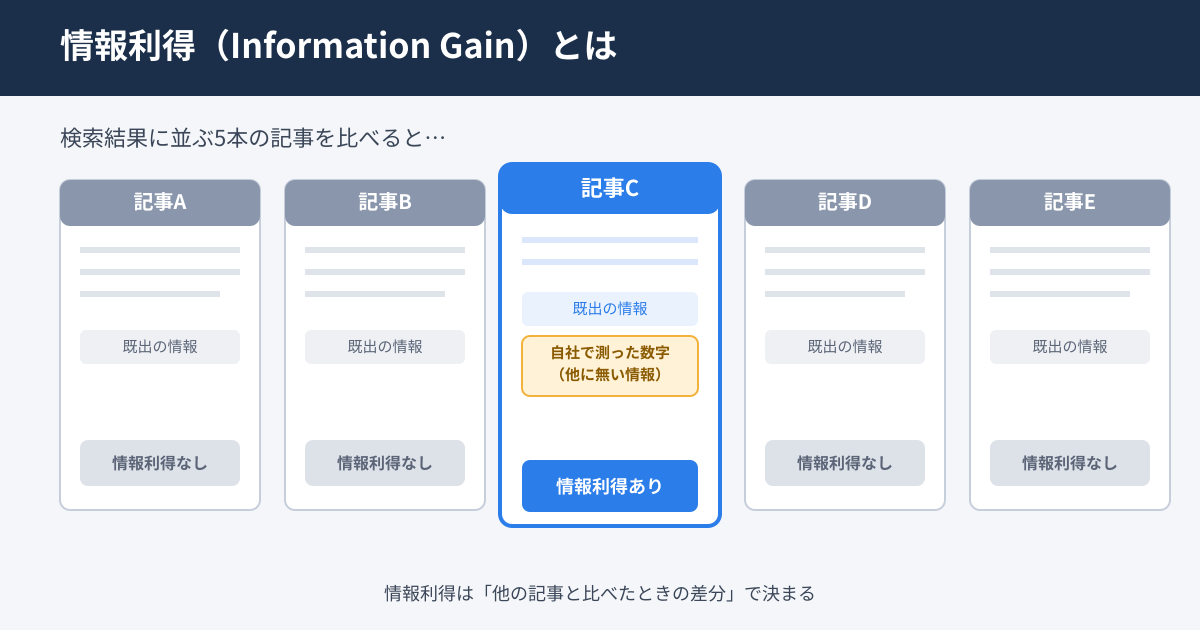
Ahrefsの記事は、Googleの特許文からこのような一文を引用しています。「an information gain score for a given document is indicative of additional information that is included in the given document beyond information contained in other documents that were already presented to the user(訳: あるドキュメントの情報利得スコアは、そのドキュメントに含まれる情報のうち、ユーザーにすでに提示済みの他のドキュメントに含まれる情報を超えた、追加情報の量を示すものである)」という記述です。かみ砕くと、「検索結果に並ぶ他の記事がすでに言っていることを、もう一度言っているだけの記事」には情報利得が無く、「他の記事には無い情報を足している記事」には情報利得がある、という考え方です。
用語
情報利得スコア(Information Gain Score):ある文書が、すでにユーザーへ提示された他の文書と比べて、どれだけ新しい情報を含んでいるかを示す指標のこと。Googleの特許文で使われている言葉で、検索結果の順位を決める公式な指標として現在も使われているという公表は、Google自身からは出ていません。
WEBディレクターが、この考え方を知っておく理由
「情報利得」は、コピーライティングやAIの技術者だけの話ではありません。サイト運営の現場で言えば、新しい記事を1本増やす前に「その記事は、既存の記事や競合サイトに無い何かを持っているか」を問うのと同じ話です。予算や人手が限られている運営ほど、量を増やすことよりも、他に無い情報を持つ記事を優先することが、結果的にコンテンツ全体の評価を底上げします。この考え方は特別なものではなく、良い編集者が昔からやってきた判断そのものです。ただし、AIが記事を要約して回答を組み立てる時代になったことで、この判断の重要度が以前より高くなったと言えます。
02 出典を確認する — 特許は何を、いつ、誰が取ったのか
特許そのものを開いて確認した
Ahrefsの記事が紹介する特許を、実際にGoogle Patentsで開いて確認しました(Contextual estimation of link information gain(訳: リンク情報利得の文脈依存的推定))。特許番号はUS11354342B2、発明者はVictor Carbune氏とPedro Gonnet Anders氏、出願は2018年10月18日、登録は2022年6月7日です。要約には、機械学習モデルを使って複数の文書データから情報利得スコアを算出し、ユーザーがまだ知らない情報の密度が高い文書を優先して提示する、という仕組みが書かれています。音声対話のように、一度に提示できる情報量が限られる場面での活用が想定されているようです。特許の本文には「redundant」(冗長な)という単語が繰り返し登場し、すでに提示済みの情報を重複して提示することを避けるのが、この技術の目的の中心にあることが読み取れます。
出願から登録まで3年半以上かかっている点も、特許の性質を理解するうえで参考になります。Googleは検索に関する特許を毎年数多く出願していますが、そのすべてが実際の検索アルゴリズムに採用されるわけではありません。特許は「将来使うかもしれない技術の権利を確保しておく」ための書類でもあるため、登録された特許の存在だけを根拠に、現在の検索順位の仕組みを断定することはできません。
| 項目 | 内容 |
|---|---|
| 特許番号 | US11354342B2 |
| 特許名 | Contextual estimation of link information gain |
| 発明者 | Victor Carbune / Pedro Gonnet Anders |
| 出願日 | 2018年10月18日 |
| 登録日 | 2022年6月7日 |
「特許を取った」と「検索で使っている」は別の話
注意
特許は、Googleがその技術を開発し権利を持っていることを示すものです。ただし、その技術が現在の検索順位を決める仕組みに、そのままの形で使われているかどうかは、特許の存在だけでは分かりません。Ahrefsの記事自身も、Googleが「情報利得スコア」という指標を検索で使っていると公式に認めた記録は無い、と明記しています。特許を根拠に「Googleはこう判定している」と断定しないことが、この話題を扱ううえでの最初の分かれ目になります。
とはいえ、特許が「Googleが何を重視して技術開発をしているか」を示す手がかりになることは事実です。Googleは検索品質評価ガイドラインの中でも、コンテンツの独自性や有用性を繰り返し重視しています(Search Quality Rater Guidelines(訳: 検索品質評価ガイドライン))。特許の考え方と、公式ガイドラインの考え方は、方向としては同じ場所を向いています。
Ahrefsの記事が伝えていること
Ahrefsの記事は、特許の技術的な仕組みそのものよりも、「特許が示す考え方を、自分の記事執筆にどう活かすか」に主眼を置いています。具体的には、質問キーワードの調査、競合記事とのカバレッジ比較、自社データの収集と公開、記事の定期的な更新という4つの実務施策を挙げています。記事の中では、Ahrefs自身が提供するキーワード調査ツールやコンテンツ分析ツールを使った具体的な操作手順も紹介されており、この分野のツールベンダーらしい実務寄りの構成になっています。本記事の05章のチェックリストと06章の手順は、この実務施策を、特定のツールに依存しない形で、当サイトの読者であるWEBディレクターの立場から翻訳したものです。
03 なぜ今、この考え方が重要になっているのか
AIが要約する時代に何が起きているか
ChatGPTやAI OverviewsのようなAIの回答機能は、複数の記事を読んで内容を要約し、1つの答えにまとめます。この仕組みの中で、同じ情報を書いている記事が10本あっても、AIが参照するのはそのうち数本です。「他の記事と同じことしか書いていない記事」は、AIにとって参照する優先度が低くなる、という単純な理屈がここにあります。逆に言えば、他の記事には無い情報を1つでも持っている記事は、AIが要約を組み立てる際の材料として選ばれやすくなります。
「同じことを言っている記事」が増えている
この状況は、AIが記事を大量に生成できるようになったことでさらに強まっています。同じキーワードを狙って書かれた記事が、似た構成・似た説明・似た結論で並ぶ光景は、多くのジャンルで見られるようになりました。Googleは検索品質評価ガイドラインの中で、こうした量産型のコンテンツへの評価を厳しくする方針を示しています。当サイトでも、AI生成コンテンツが検索でどう評価されるのかを、公式の記述に沿って確認したことがあります(AI生成コンテンツは検索でどう評価されるのか)。同じ結論に至る記事の本数が増えるほど、その1本1本の情報利得は相対的に下がっていくという点が、この状況の厄介なところです。自分の記事が薄まっていないかは、公開時ではなく、競合が増えた後にもう一度確かめる必要があります。
検索とAIの回答、両方に効く考え方
情報利得という考え方の便利な点は、通常の検索結果にもAIの回答機能にも、どちらにも効くことです。Googleの生成AI機能は、独自のランキングを持つのではなく、既存のコアとなる検索ランキング・品質システムの上で動いています(AI features and your website(訳: AI機能とあなたのサイト))。つまり、情報利得を意識して記事を書くことは、AI経由の露出だけを狙った特別な対策ではなく、通常の検索順位にもそのまま効く、遠回りのようで一番堅実な対策だといえます。
引用元として選ばれる記事とそうでない記事
ここまでの内容を整理すると、AIに引用されやすい記事の条件は、文章のうまさや文字数の多さではなく、「他の記事に無い情報を持っているかどうか」に集約されます。当サイトでは以前、AIに引用される記事の書き方を、Google公式ガイドの記述だけを土台に整理したことがあります(AIに引用される記事の書き方)。本記事はその続きとして、「他の記事に無い情報」を自分の記事が持っているかどうかを、実際に確認する方法に焦点を当てます。
実務のヒント
「他の記事と何が違うか」を言葉で説明できない記事は、たいてい情報利得が薄い記事です。公開前に「この記事だけが言えることは何か」を1文で書き出せるかどうかが、簡単な自己診断になります。
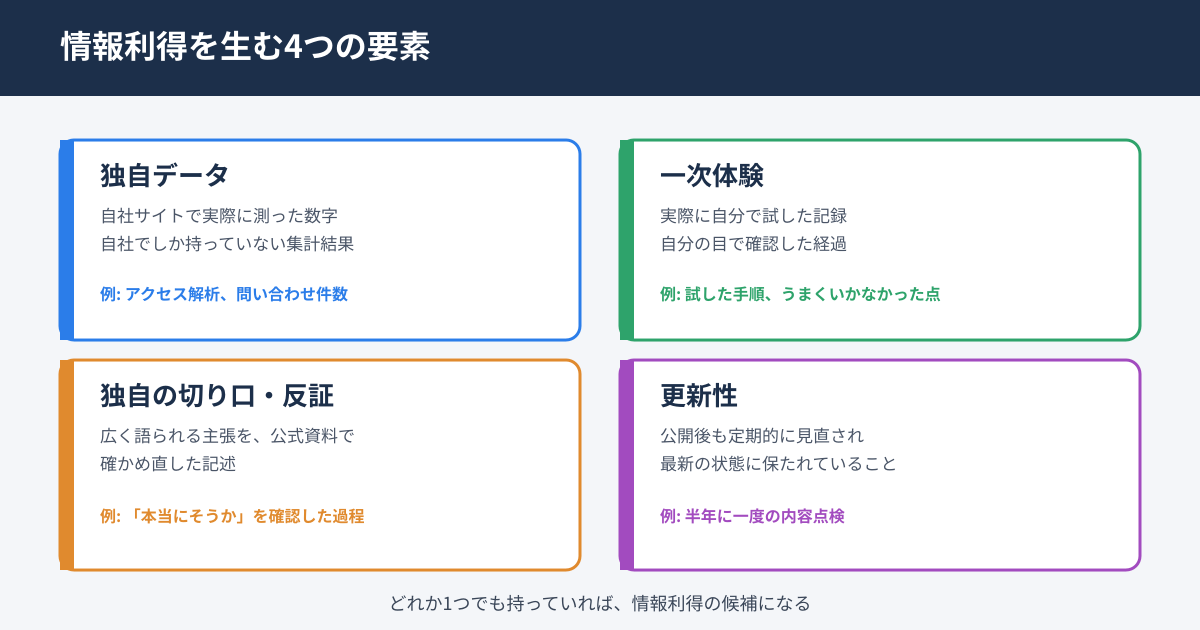
04 情報利得を生む4つの要素
要素1—独自データ
自分のサイトで実際に測った数字、自社でしか持っていない集計結果は、他の記事に置き換えの効かない情報です。当サイトでも、公開している記事のリンク切れの実態や、画像の運ばれ方といった、当サイト自身の記録から確かめた数字を記事にまとめたことがあります(archives/128)。他社の調査を引用するだけの記事と、自分の手元にあるデータを公開する記事は、AIにとっても読者にとっても価値が違います。アクセス解析の数値、問い合わせ件数の推移、社内で測った作業時間なども、立派な独自データになります。
要素2—一次体験
実際に自分で試した記録、自分の目で確認した経過も、他の記事が持っていない情報になります。Google公式のガイド「Creating Helpful, Reliable, People-First Content(訳: 役に立ち、信頼でき、人を第一に考えたコンテンツを作成する)」は、こうした体験にもとづく記述を、コンテンツの評価軸の1つとして明示しています(Creating Helpful, Reliable, People-First Content)。「調べたところ〜だった」と、他サイトの内容を並べ替えただけの記述には、この差がはっきり表れます。実際にツールを使ってみた手順や、うまくいかなかった箇所まで書くことで、要約では再現できない情報になります。
要素3—独自の切り口・反証
広く語られている数字や主張に対して、実際に確かめ直してみたら違う結果になった、という記述も情報利得を生みます。当サイトでは、「順位が落ちた」と話題になった週にGoogle公式が何を発表していたかを、公式の発表内容だけで確認したことがあります(archives/122)。世の中で語られている話をそのまま受け取るのではなく、公式の資料と照らし合わせて確認するという作業そのものが、他の記事に無い情報を生みます。反証になる場合もあれば、裏付けが取れて安心材料になる場合もあり、どちらの結果でも記事の価値は変わりません。
要素4—更新性
公開時点では最新だった記事も、時間が経てば古い情報になります。Googleは検索アルゴリズムの大きな更新を年に数回行っており(Google Search's core updates and your website(訳: Google検索のコアアップデートと、あなたのサイト))、公式ガイド類も定期的に更新されています。定期的に見直され、最新の状態に保たれている記事は、放置された記事に比べて情報利得を保ち続けやすいと言えます。更新性は、他の3要素と違って一度書けば終わりではなく、公開後の運用として継続する必要がある要素です。
| 要素 | 具体例 | 自分で確認する方法 |
|---|---|---|
| 独自データ | 自社サイトで実際に測った数値、自社の集計結果 | 公開している記事の中に、他社の数字ではなく自社の数字が1つでもあるか探す |
| 一次体験 | 実際に試した記録、確認した経過 | 「調べたところ」で始まる段落が、要約ではなく自分の作業の記述になっているか確認する |
| 独自の切り口 反証を含む | 広く語られる主張を、公式資料で確かめ直した記述 | 記事内の主張のうち、出典リンクが付いているものの割合を数える |
| 更新性 | 公開後も定期的に見直されている記事 | 公開日から半年以上経った記事の更新日を確認する |
05 自分の記事で確認するチェックリスト
チェックリストの使い方
ここまでの内容を、記事1本ごとに手を動かして確認できる項目に翻訳しました。観点は、自社データの有無、一次体験の記述、独自の切り口、更新性の4つに対応しています。チェックの状態はブラウザ内にのみ保存され、サーバーには送信されません。
実務のヒント
自社サイト全体の状況をまとめて確認したい場合は、当サイトの🔧 WEBサイト総合分析・レポートツールで、記事単体ではなくサイト全体の傾向を確認できます。
- 公開しようとしている記事に、自社が実際に測った数字が1つ以上あるか確認する
- 「調べたところ」で始まる段落が、実際に自分で確認した記述になっているか読み返す
- 他サイトの内容を言い換えただけの段落が無いか、記事を通しで読んで確認する
- 記事内の主要な主張について、公式の資料へのリンクが貼られているか確認する
- 同じキーワードで上位に表示されている記事を3本開き、見出しを並べて比較する
- 比較した3本の見出しと、自分の記事の見出しに重複が無いか確認する
- 比較した3本のどれにも書かれていない情報が、自分の記事に1つ以上あるか確認する
- 公開から半年以上経った記事を1本選び、内容が今も正しいか確認する
- 公開から半年以上経った記事の更新日が、実際の見直し日に合わせて更新されているか確認する
- アクセスが落ちている記事を1本選び、原因が情報の古さにあるかを確認する
- 記事のタイトルと結論が、他の記事のタイトル・結論と一字一句同じになっていないか確認する
- 読者から実際に受けた質問のうち、記事にまだ書いていないものが無いか思い出す
- 記事ページに著者情報(または監修者情報)が表示されているか確認する
13項目の目安の時間
すべてに目を通す時間の目安は1記事あたり15〜20分程度です。新規記事の執筆時に使うほか、公開から半年以上経った記事の棚卸しにもそのまま使えます。特に5〜7番目の項目(上位記事との見出し比較)は、次の06章で手順として詳しく扱います。すべての記事に毎回20分をかけるのは現実的ではないため、まずはアクセス数の多い記事、あるいは競合が明らかに増えている記事から順に適用していくのが、限られた時間の使い方としては合理的です。
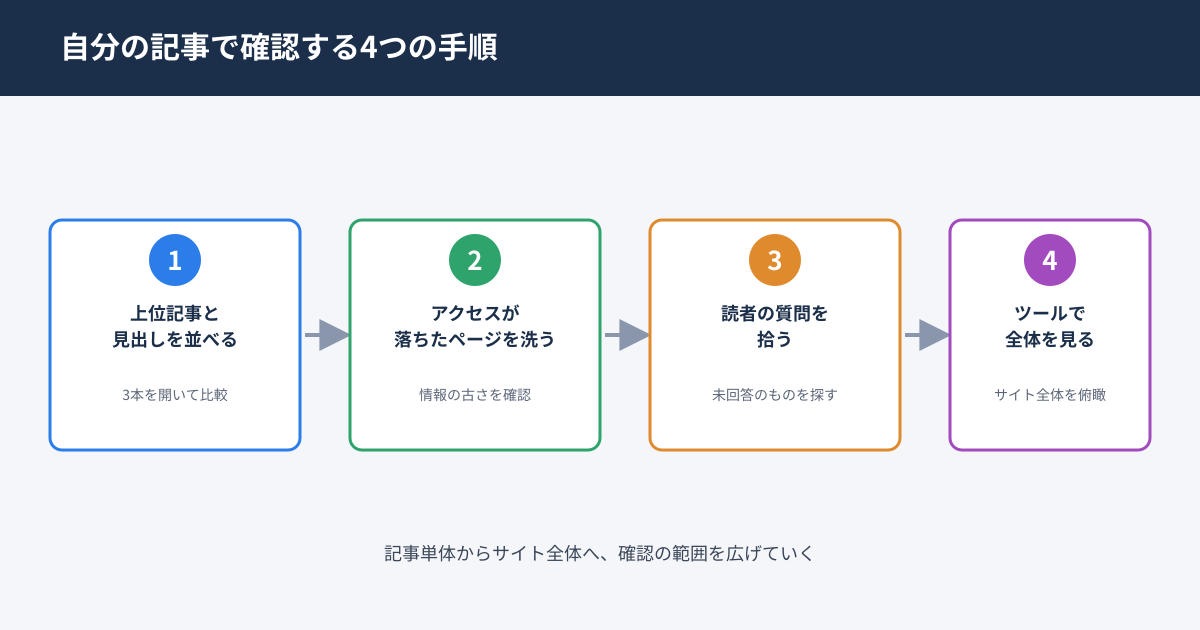
06 実際にやってみる — 4つの手順
手順1—上位表示記事と自分の記事の見出しを並べる
狙っているキーワードで検索し、上位に表示される記事を3本開きます。それぞれの見出し(h2・h3)だけを書き出し、自分の記事の見出しと横に並べます。同じ見出しが3本以上で繰り返されている場合、そのテーマはすでに広く書かれている情報だと分かります。逆に、自分の記事にしか無い見出しがあれば、それが情報利得を持つ候補です。この作業はテキストエディタと3本のタブを開くだけでできるので、専用ツールが無くても15分程度で1記事ぶんを終えられます。
手順2—アクセスが落ちているページを洗い出す
過去に公開した記事のうち、アクセスが下がっている記事を確認します。原因はいくつも考えられますが、公開時点では新しかった情報が、時間の経過で「他の記事にも書かれている当たり前の情報」に変わっているケースは珍しくありません。この場合、記事を書き直すよりも、その後に分かった新しい情報を追記するほうが早く情報利得を回復できます。すでに検索エンジンに評価されている実績のあるURLをそのまま活かせることも、追記のほうを優先する理由の1つです。
手順3—読者からの質問で、まだ書いていないものを拾う
問い合わせやコメントで実際に受けた質問は、記事にまだ書かれていない情報である可能性が高いものです。Ahrefsの記事も、まだ答えられていない質問を発掘する方法の1つとして、掲示板やコミュニティでのやり取りを確認することを挙げています。自社の場合は、問い合わせフォームやサポート窓口に届いた質問を見返すところから始められます。同じ質問が2回以上届いていれば、それは記事にする価値のある情報だと判断できます。
手順4—無料ツールで自社サイト全体を確認する
記事を1本ずつ手作業で確認するのが難しい場合は、ツールでサイト全体を先に見渡す方法があります。当サイトの🔧 Google Search Console お助けツールで、どの記事が検索結果でどう表示されているかを確認したうえで、アクセスが落ちている記事から優先的に手順1〜3を適用すると、限られた時間でも効率よく進められます。4つの手順は、記事1本ずつを丁寧に見る作業と、サイト全体を俯瞰する作業の両輪で、どちらか片方だけでは見落としが残ります。
07 よくある誤解
誤解1—数字を足せば情報利得になるわけではない
統計や数字を記事に足すこと自体は良いことですが、他の記事にも載っている同じ数字を並べるだけでは、情報利得は生まれません。信用スコアを例にすると分かりやすくなります。FICOスコアは、支払い履歴(35%)・負債額(30%)・クレジット履歴の長さ(15%)・クレジットミックス(10%)・新規クレジット(10%)という5つの要素の組み合わせで決まります(How are FICO Scores Calculated?(訳: FICOスコアはどう算出されるか))。情報利得も同じで、「情報の量」という単一の要素ではなく、04章で見た4つの要素の組み合わせで決まると考えるほうが実態に近いといえます。
誤解2—情報利得スコアが検索順位に直結するわけではない
注意
02章で確認したとおり、Googleが「情報利得スコア」という指標を検索順位の決定に使っていると公式に認めた記録はありません。この特許は数ある特許の1つであり、実際のランキングシステムでの採用状況は不明です。「情報利得スコアを上げれば必ず順位が上がる」という因果関係を断定するのは、特許の内容を超えた解釈になります。
誤解3—出典を明記すれば情報利得になるわけではない
公式資料へのリンクを貼ること自体は、記事の信頼性を支える大切な作業ですが、それだけで独自の情報が生まれるわけではありません。出典を明記したうえで、その情報を自分の言葉でどう解釈したか、自社の状況に当てはめるとどうなるかまで書いて初めて、情報利得のある記述になります。「公式ドキュメントによると〜」で終わる段落と、「公式ドキュメントによると〜。自社の場合は〜だった」まで書く段落では、後者にしか無い情報が残ります。この違いは、02章で確認した特許の「重複を避ける」という考え方とも一致します。
| よくある誤解 | 実際のところ |
|---|---|
| 数字や統計を足せば情報利得になる | 他の記事と同じ数字を並べるだけでは増えない。自社で測った数字が要る |
| 情報利得スコアが検索順位を直接決める | Googleはそのように公式に認めていない。特許は技術の存在を示すのみ |
| 出典リンクを増やせば情報利得になる | 信頼性は上がるが、情報利得は自分の解釈や体験の記述で生まれる |
08 このテーマの、これまで
AIに引用される記事の書き方を整理した回
03章で触れたとおり、AIに引用される記事の条件をGoogle公式ガイドの記述だけで整理したことがあります(AIに引用される記事の書き方)。本記事は、その「書き方」の話を、「他の記事と比べて何を足せているか」という情報利得の側面から補うものです。
Googleは検索をAIに置き換えたわけではない
情報利得の話をすると、「検索はもうAIに置き換わったのだから、通常のSEOは意味が無いのでは」という疑問が出ることがあります。当サイトでは以前、「デフォルトAI回答」といった報道の見出しを、Google公式の見解と照らし合わせて確認したことがあります(archives/104)。結論としては、検索の仕組みが丸ごとAIに置き換わったわけではなく、報道の見出しが実態より誇張されているケースがありました。情報利得も同じで、話題性のある言葉に振り回されず、公式の資料と自社の状況を照らし合わせて確認する姿勢が基本になります。
「埋めていい穴」と「埋めてはいけない穴」を整理した回
情報を足すといっても、無理に足してよい情報と、足すと事実に反する情報があります。当サイトでは以前、自社に実体験の無い項目を無理に埋めず、正直に据え置いた判断について書いたことがあります(archives/119)。情報利得を増やす作業も同じで、持っていない体験を捏造してまで情報を足すことは、この記事の趣旨とは正反対になります。
AI Overviewsとクリックの関係を追った回
AIの回答機能に記事が引用されても、それだけでアクセスが増えるとは限らないという指摘もあります。当サイトでは、AI Overviewsに表示された記事のクリックの質について検証した研究を確認したことがあります(archives/97)。引用されることと、実際に読まれることは、分けて考える必要があります。
この記事自体の情報利得は何か
05章のチェックリストの1番目には「自社が実際に測った数字が1つ以上あるか」という項目があります。本記事自身にこの項目を当てはめると、02章で特許原文を実際に開いて確認した点、07章でFICOスコアの算出方法を実際に調べて例に使った点が、他の解説記事には無い情報にあたります。一方で、情報利得スコアそのものが検索順位にどれだけ影響しているかという数字は、当サイトはまだ確かめられていません。確かめていないことを、確かめたように書かないことも、情報利得を扱う記事としては欠かせない姿勢だと考えています。
現在の貴方のIPアドレス
このサイトで書いている人